

Slik fikset vi minneoverskridelsene i Cloudflare Durable Objects
Explore with AI
Hver agenttråd i Polylane kjører inne i sitt eget Cloudflare Durable Object, alle instanser av én klasse. I august 2026 ble Durable Objects for trådene våre nullstilt omtrent 300 ganger om dagen for å ha overskredet minnegrensen. Vi hørte den samme historien fra flere team som kjører agentflytene sine på Cloudflare Durable Objects.
Har du fått exceededMemory på et Durable Object, er det vanlige rådet å se på hva forespørslene dine allokerer: en payload som er for stor, en chathistorikk som vokser uten grense, en cache som aldri kaster ut. Ingenting av det gjaldt for oss. Isolatet var over grensen før det hadde betjent en eneste forespørsel, så vekten måtte ligge i koden vi leverte, ikke i dataene vi serverte.
Dette innlegget handler om hva som faktisk lå i heapen, hvordan vi fant det på en plattform som ikke lar deg koble til en profiler, og de to endringene som tok minnet på modulnivå fra 218 MB til 82 MB og nullstillingene til null.
Cloudflare Durable Objects på ett minutt
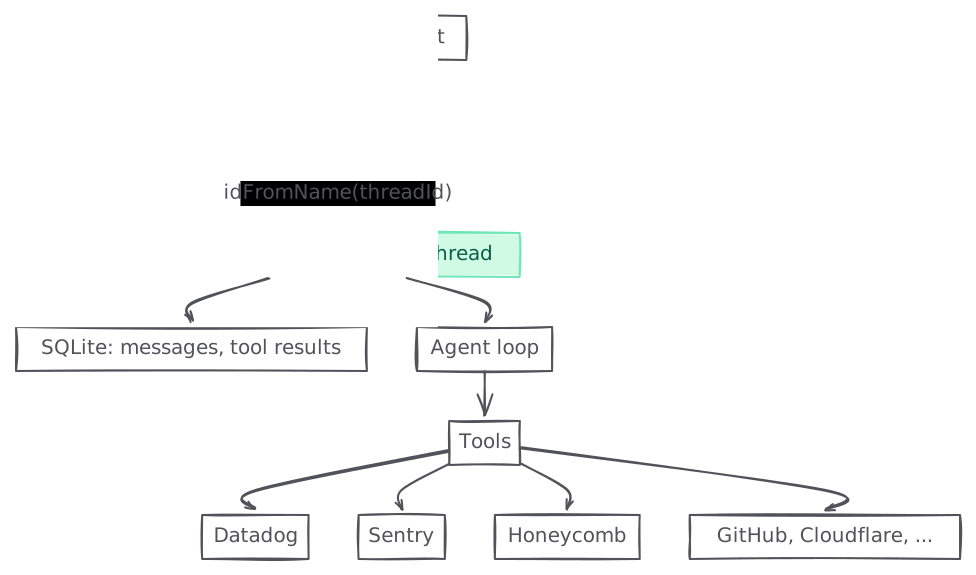
Hvis du ikke har brukt dem: et Durable Object er en liten, tilstandsfull, enkelttrådet server som Cloudflare garanterer er unik for en gitt ID. Kall idFromName() med den ID-en fra en Worker, og hver forespørsel til den, fra hvor som helst i verden, lander på samme instans, med sin egen SQLite-database, minnetilstand og alarmer. Den går i dvale når den er inaktiv og våkner der den slapp.
I Polylane oppretter vi en Durable Object-instans for hver tråd. Hver samtale med agenten, enten en person eller et varsel startet den, får sitt eget Durable Object. Objektets SQLite holder trådens meldinger og verktøyresultater, agentløkken kjører inne i det, og verktøyene dets kaller ut til de leverandørene tråden trenger: Datadog, Sentry, Honeycomb, GitHub, Cloudflare og resten. Når tråden blir stille, går objektet i dvale, og når neste melding kommer, fortsetter det nøyaktig der det stoppet.
Slik fungerer minne i Durable Objects
- Isolater og taket på 128 MB. Durable Objects kjører inne i V8-isolater, og et isolat har en hard minnegrense på 128 MB som er den samme på hver plan og ikke kan konfigureres.
- Samlokalisering. Ett enkelt isolat huser mange Durable Objects av samme klasse, sammen med Worker-koden rundt dem, og alle deler det isolatets minne. Grensen er per isolat, ikke per objekt.
- Støyende naboer. På grunn av samlokaliseringen er objektet som nullstilles når isolatet går tom for minne, ofte ikke objektet som brukte minnet. Hver minneprøve Cloudflare rapporterer, er hele isolatets, og det er hver nullstilling også.
Det finnes ingen måte å koble en minneprofiler til et Durable Object i produksjon: heap-snapshot-verktøyene Cloudflare dokumenterer, kjører mot en lokal utviklingssesjon. I Kubernetes ville du slått på profilering og koblet deg til frem til du fant problemet. I workerd er process.memoryUsage() en unenv-polyfill som returnerer nuller, og tallene for baseline-minne og CPU er ikke synlige for koden som kjører inne i det. Det du får, er Cloudflares GraphQL-analyse-API: minnepersentiler og krasjtall per navnerom, i etterkant.
Hva minnegrafen fortalte oss
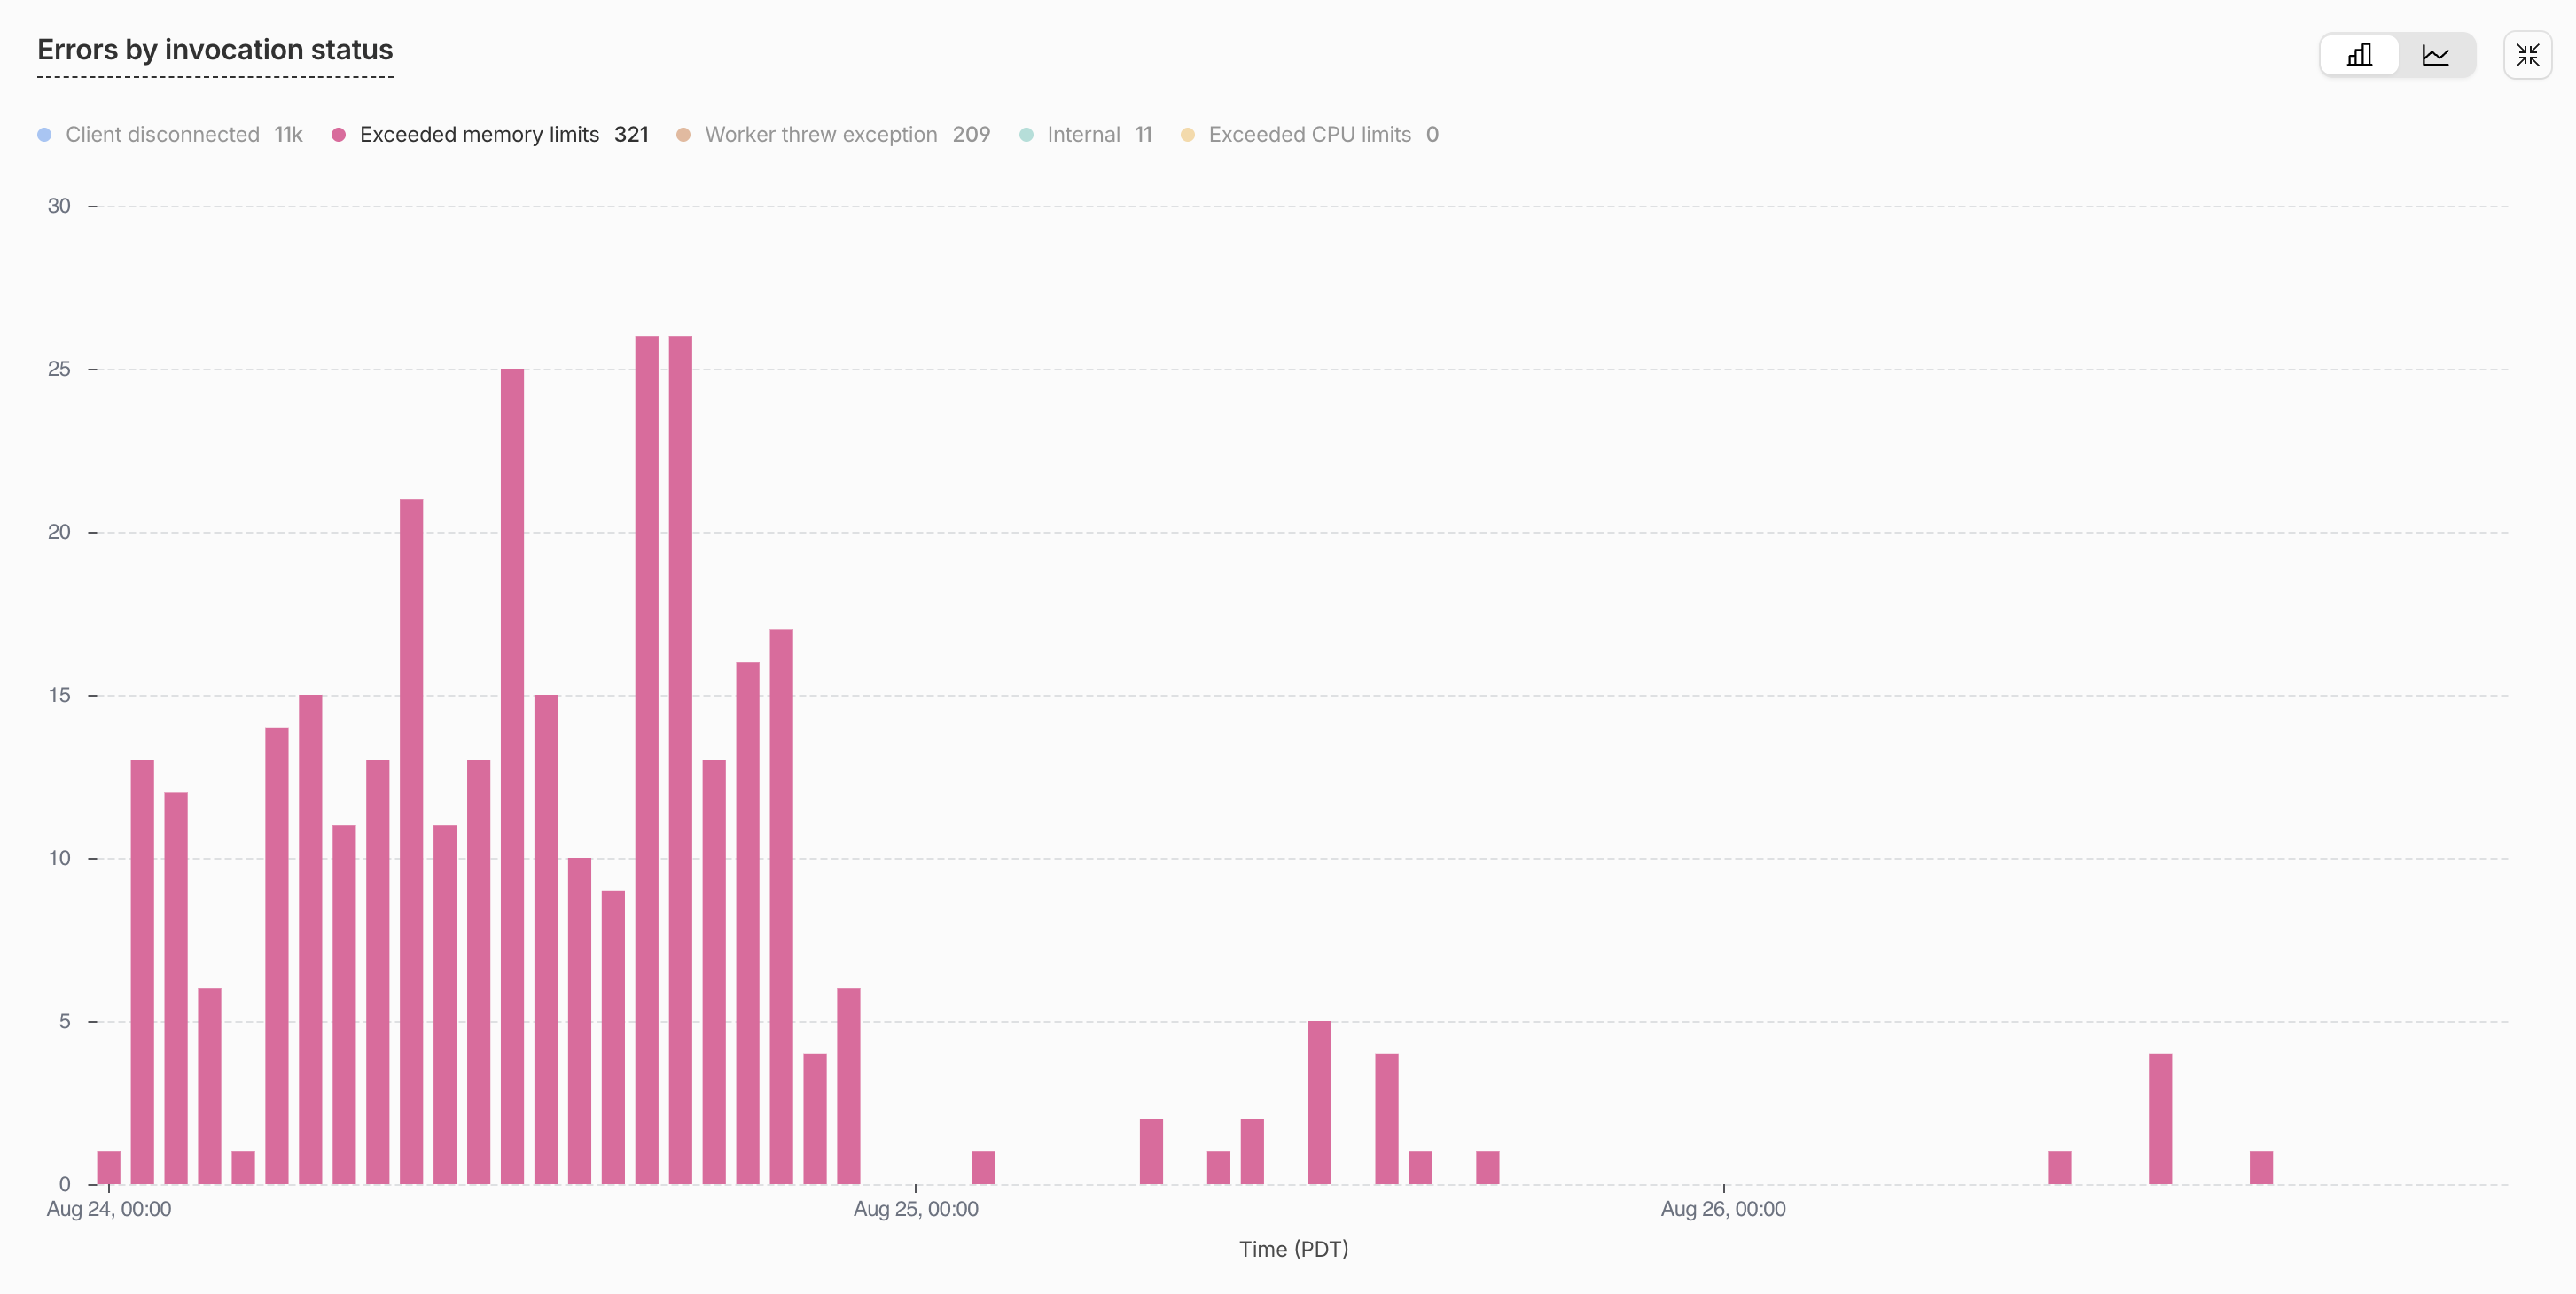
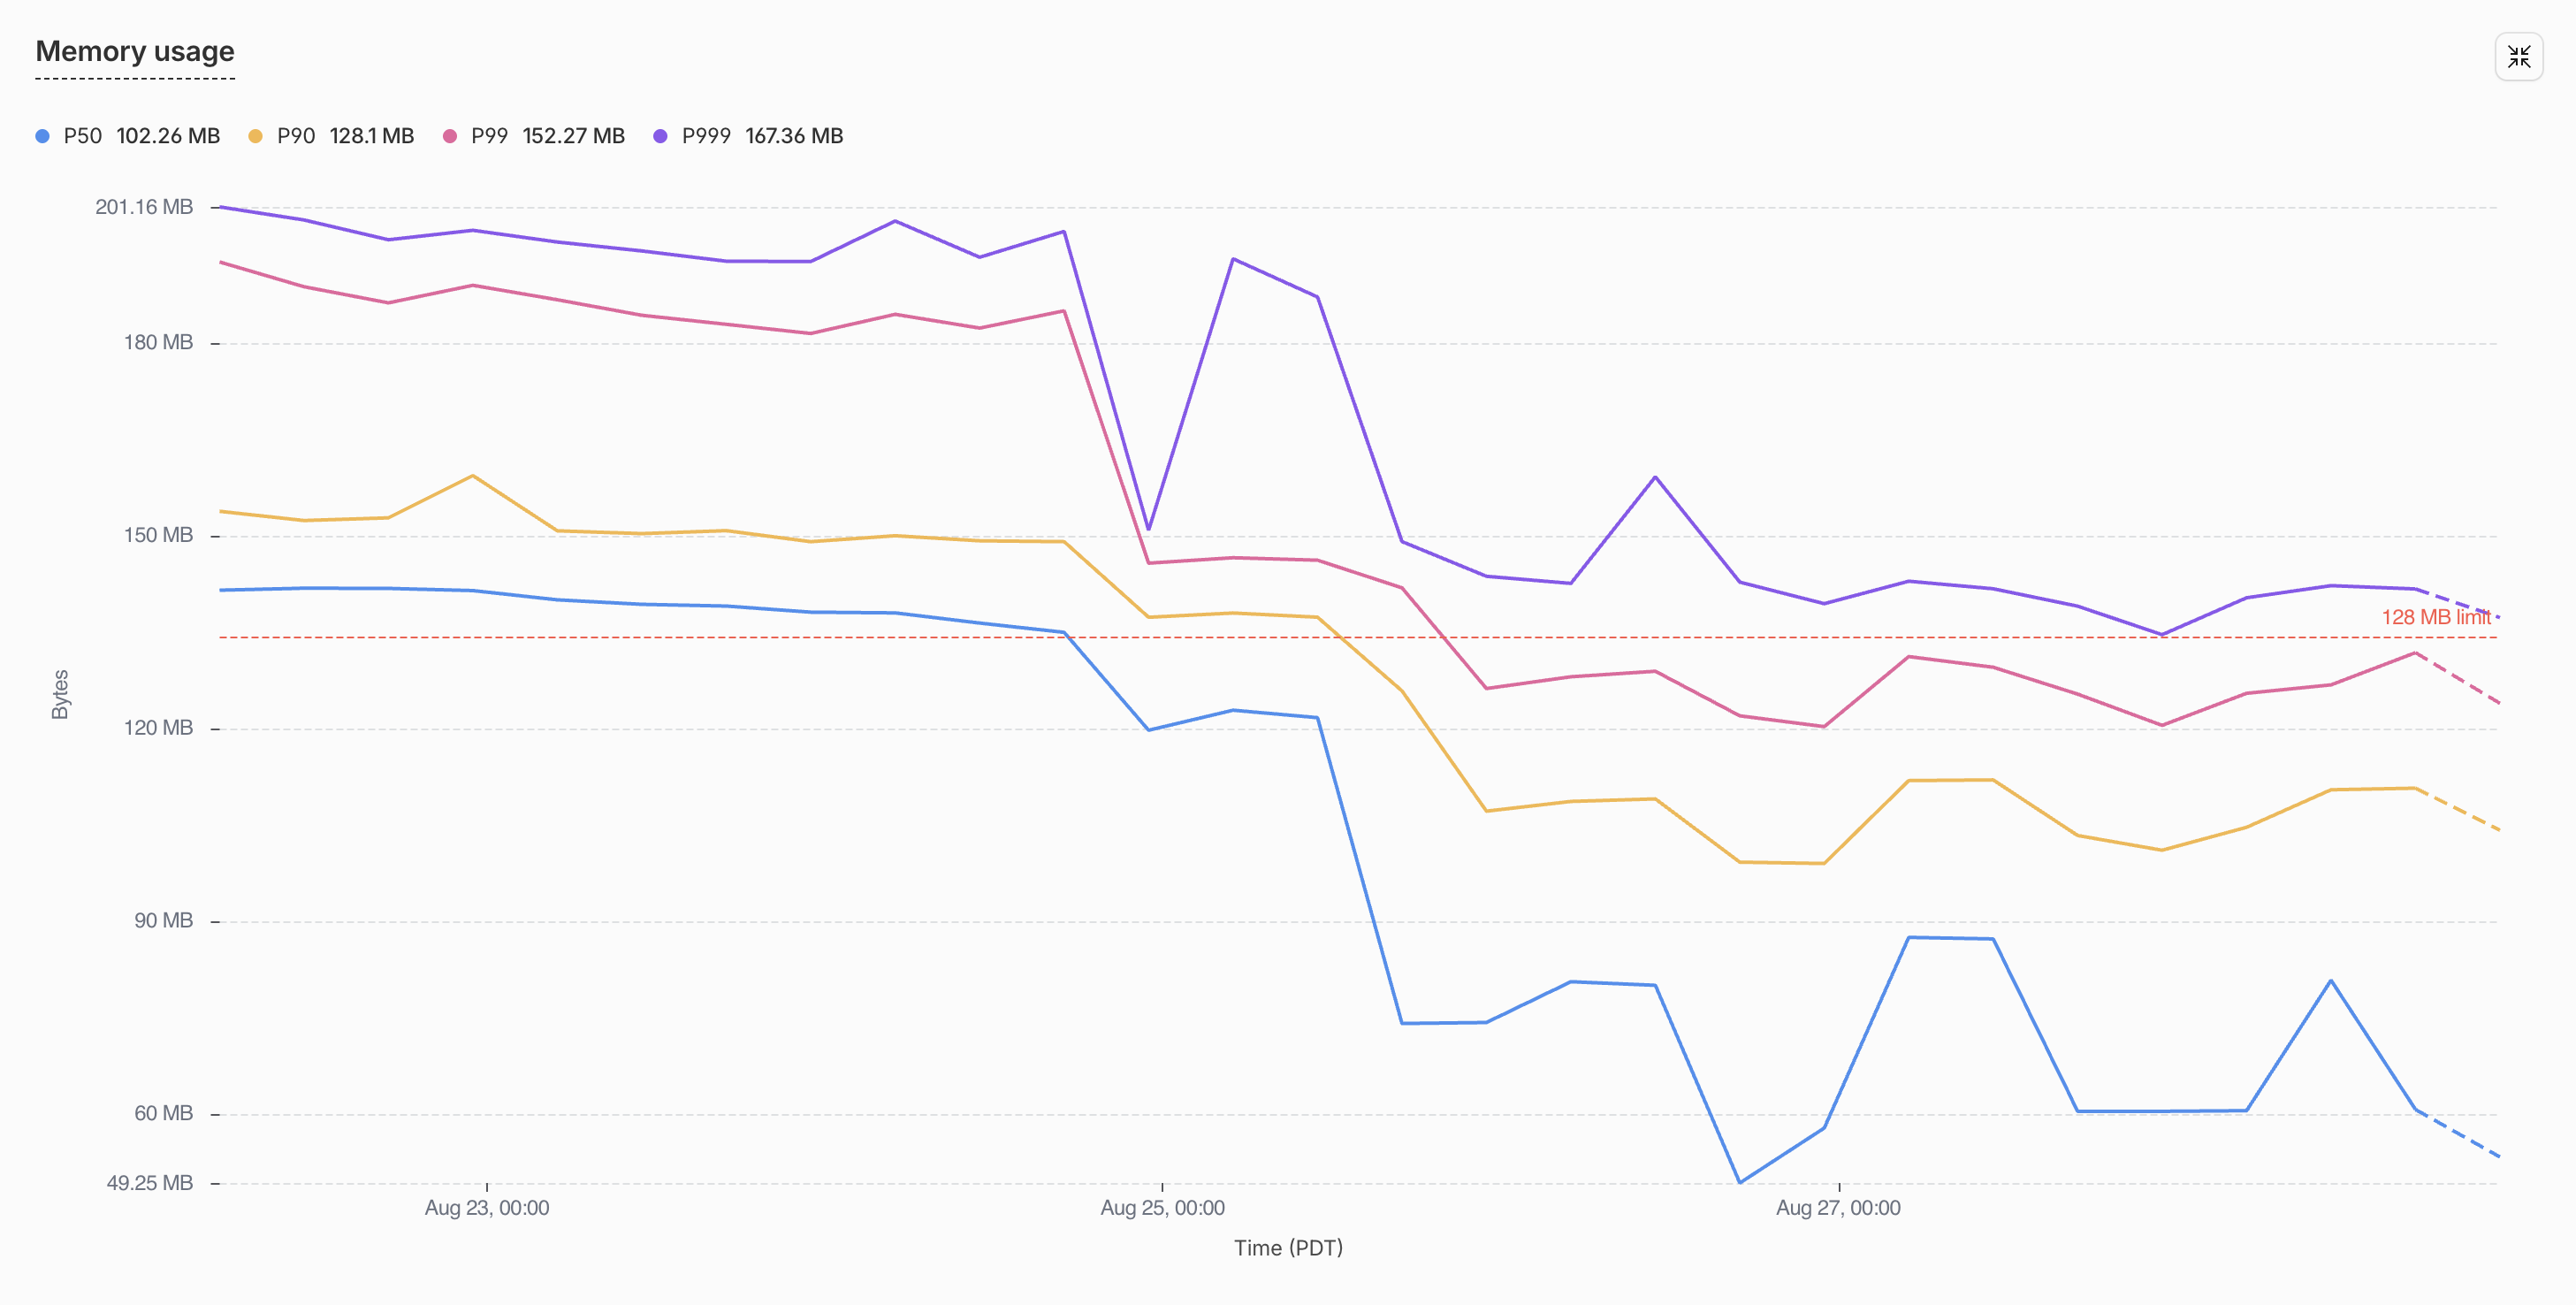
Cloudflares analyse-API rapporterer minne for et Durable Object-navnerom som persentiler på tvers av isolatene som kjører det, i bøtter på femten minutter, sammen med antallet minneoverskridelser i hver bøtte. Hver graf i dette innlegget kommer fra det API-et, filtrert til trådnavnerommet og sammenlignet på tvers av deploy-markører etter at vi begynte å levere fikser.
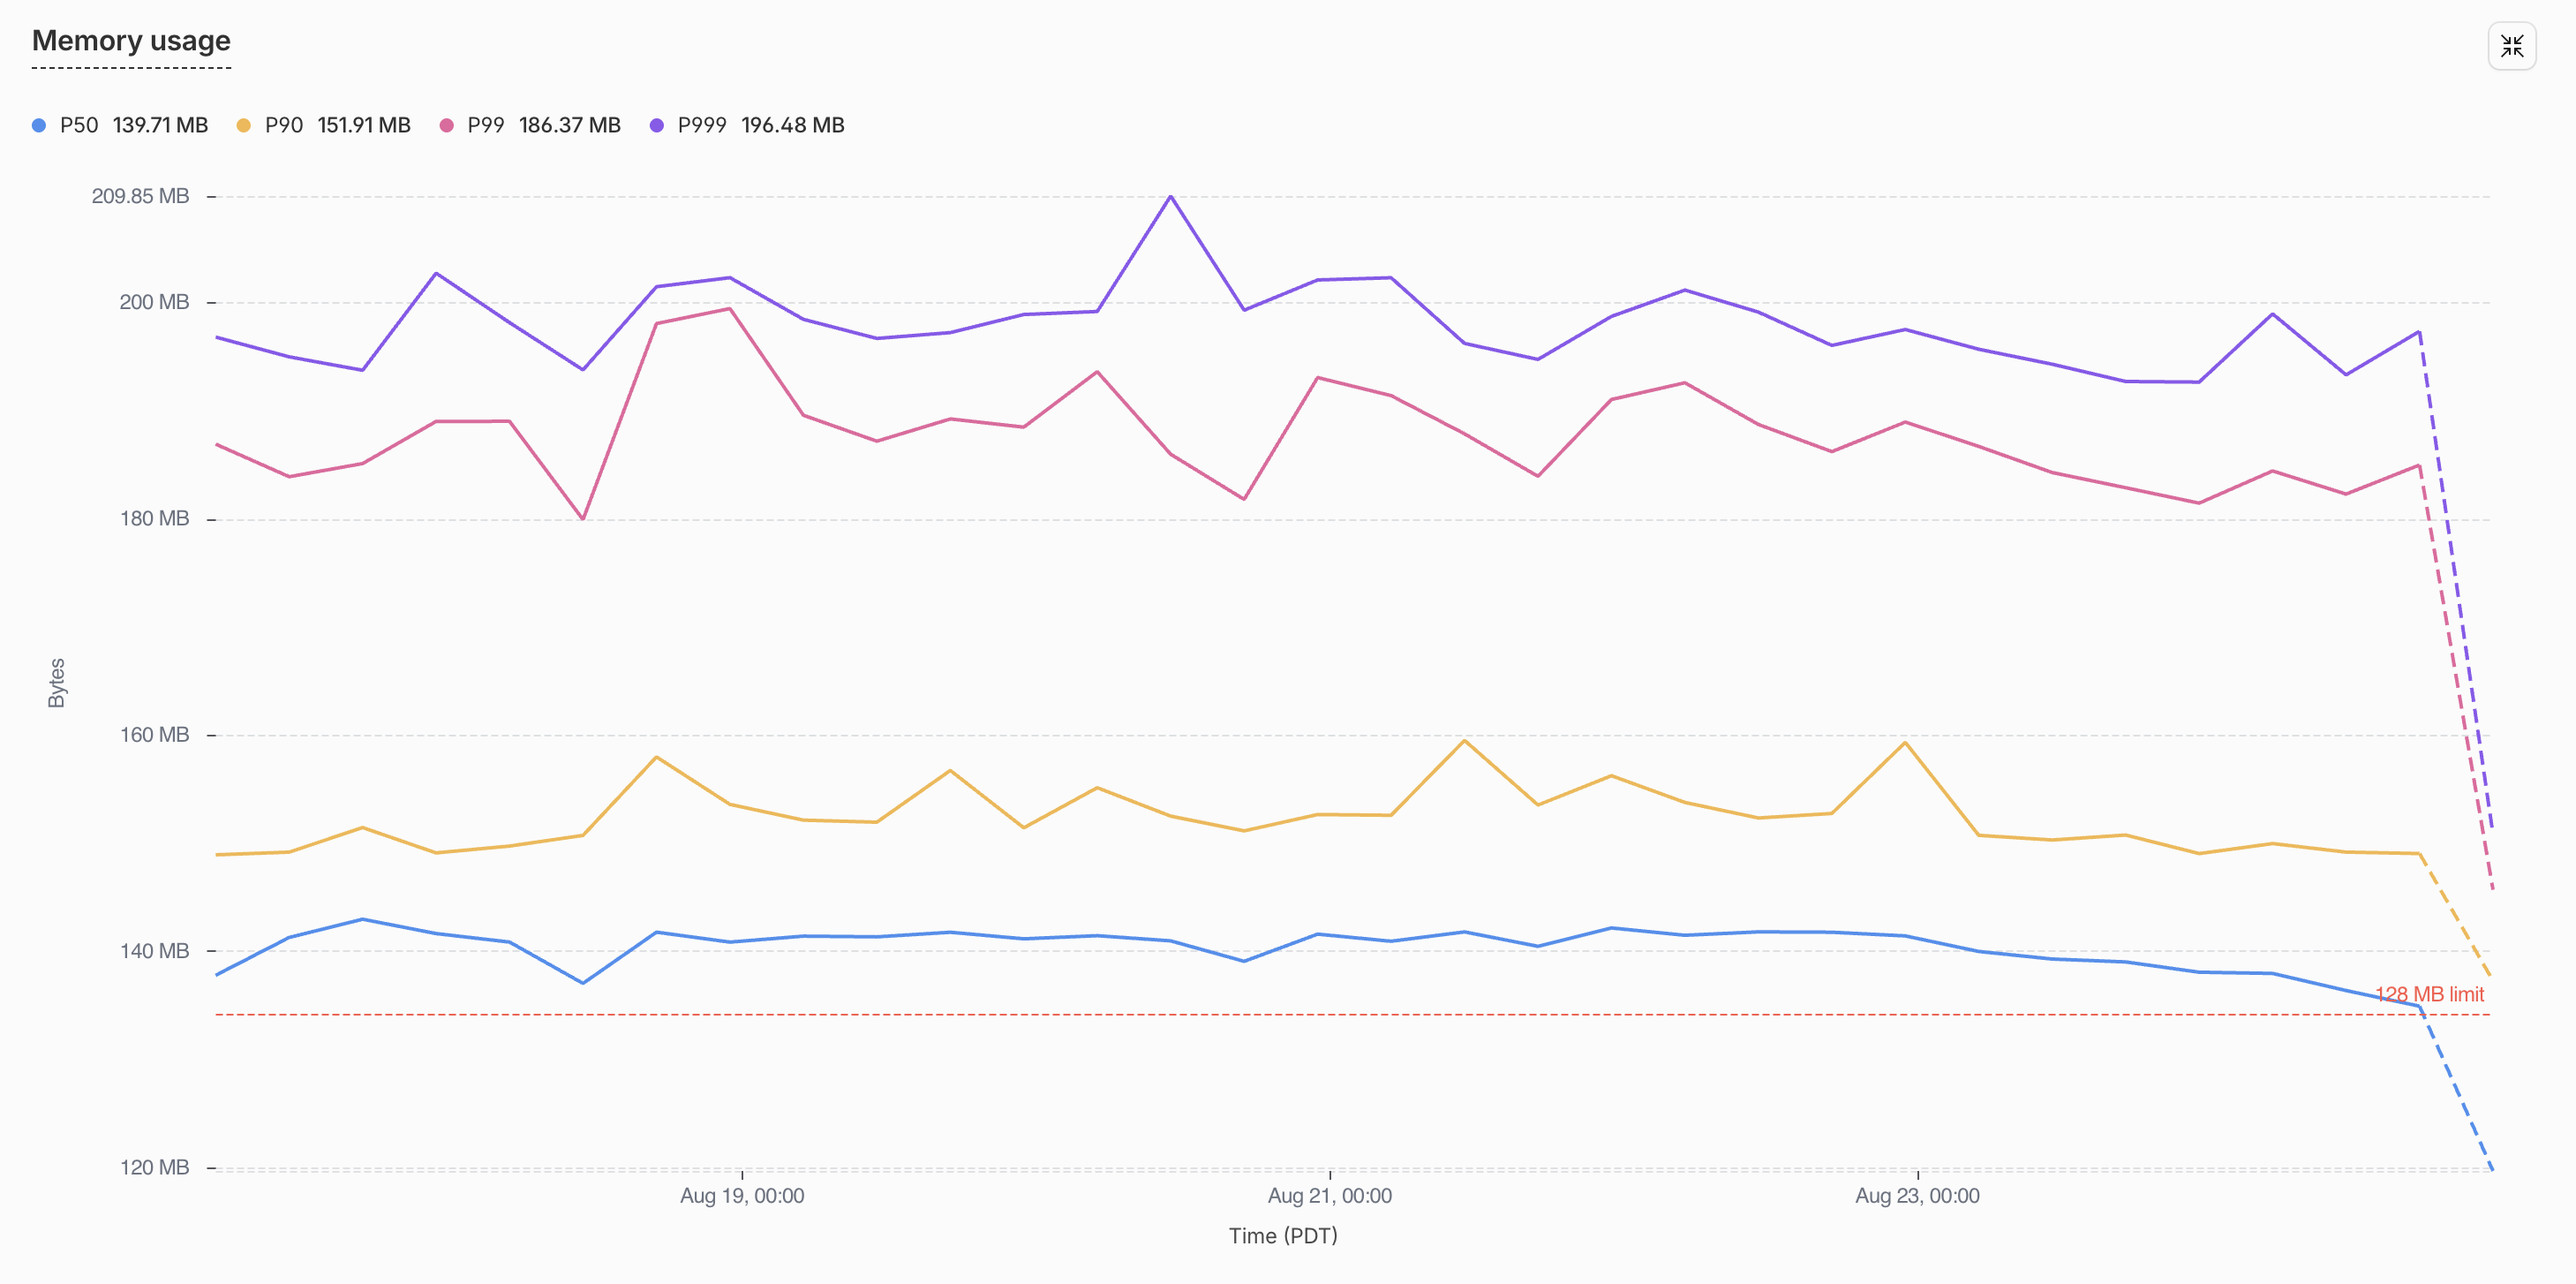
Medianisolatet, den blå linjen i figur 1, lå på omtrent 140 MB hele uken, og 99. persentil lå nær 190 MB. Begge linjene er over den stiplede grensen på 128 MB, som betyr at det typiske isolatet i navnerommet allerede var forbi punktet der Cloudflare har rett til å nullstille det, og bare ble spart til neste allokering tippet det over. Det grafen ikke viste, var noen sammenheng med trafikk. Linjen var like flat i de stille timene som i de travle, og ingen av de omtrent 300 nullstillingene om dagen kom med en stakksporing, fordi det aldri var vår kode som kastet feilen.
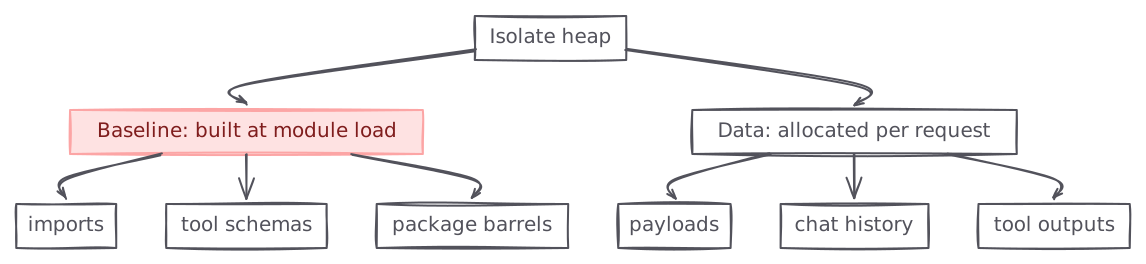
Vi så der du ville forvente å se først. Vi leste payload-størrelsene, vi sjekket hvordan chathistorikken ble avkortet, og vi lette i minnekurven etter et forespørselsmønster, og fant ingenting som flyttet linjen. Den flatheten viste seg å være den viktige ledetråden. Et isolats minne er én av to ting: det er data, altså forespørsels-payloads, chathistorikk, verktøyutdata og alt annet som allokeres mens trafikk betjenes, eller det er baseline, altså objektene koden selv oppretter når en modul lastes og holder i live så lenge isolatet lever, som imports, funksjoner og skjemaer. Data stiger og faller med forespørslene, mens baseline er der før den første forespørselen og aldri forsvinner, så en graf som er høy og flat i hvile, beskriver baseline. Problemet måtte ligge i det vi leverte, ikke i det vi serverte.
Hvorfor baseline-minne er så lett å overse
Baseline-minne skjuler seg på to steder du vanligvis ikke ser.
Det første er bundleren. Vi antar at tree shaking fjerner koden vi ikke bruker, og for det meste gjør den det, men esbuild har regler for når den kan beskjære, og de er ikke reglene du ville gjettet. En pakke uten "sideEffects": false i sin package.json beskjæres aldri i det hele tatt. En export * inne i en modul som evalueres lazily, beskjæres heller aldri. En dynamisk import() av en pakkerot markerer hver eksport som brukt. Vi kommer tilbake til hver av disse i fiksene, fordi de forklarer halvparten av de 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Det andre er skjemabiblioteket. Typer føles gratis fordi de forsvinner ved kompilering, men et zod-skjema er ikke en type, det er et tre av closures bygget i det øyeblikket modulen dens evalueres. Ett mellomstort zod 4-objektskjema, et dusin felter med beskrivelser og refinements, koster ~134 KB heap. En naken z.string() koster ~12 KB. Det tilsvarende rene JSON-skjemaobjektet koster noen hundre bytes. Ingenting av det står i README-en.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Vi hadde ikke gjort noe eksotisk
Hvert eneste av problemene våre kom fra en standard. Hvert agentverktøy erklærte inndataene sine med z.object() på modulnivå, fordi det er slik dokumentasjonen gjør det. Hver interne pakke hadde en barrel-index.ts med export * from "./zod", fordi det er ryddig. Noen få stier brukte await import("@scope/package") fordi lazy loading skal være billigere. Hvert valg er fornuftig for seg. Sammen var de 130 MB, i et isolat med 128 å bruke.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Hva det kostet oss
Agenten vår har over 250 verktøy, som den bruker gjennom code mode og dynamiske workers. Zod-definisjonene deres alene kostet 78 MB heap ved modullasting, mer enn halvparten av isolatets budsjett, brukt på beskrivelser av argumenter før noen av dem ble kalt. Hvert verktøy vi la til, kostet ytterligere ~134 KB, uansett om det verktøyet noen gang kjørte.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Nullstillingene var heller ikke gratis. Hver exceededMemory kaster bort en pågående agentrunde: et nytt forsøk, et nytt modellkall, en bruker som ser på en spinner. Ved ~300 om dagen slutter det å være en hendelse og blir en fast skatt, og på grunn av samlokaliseringen ble den betalt av det objektet som tilfeldigvis var i isolatet på det tidspunktet.
Error: Durable Object's isolate exceeded its memory limit and was reset.Slik fant vi det: en heap-profiler for produksjonsbundelen
Vi kunne ikke profilere produksjon, så vi bygde en liten profiler som kjører lokalt på nøyaktig den bundelen produksjon kjører. Den måler V8-heap-kostnaden ved å evaluere hver modul og skriver ut en rangert tabell. Vi kjørte den i løkke: profiler, fjern toppen av rangeringen, profiler igjen. Den siste sjekken for hver fiks var en produksjonsdeploy sammenlignet med Cloudflares minnemetrikker på hver side av deploy-markøren.
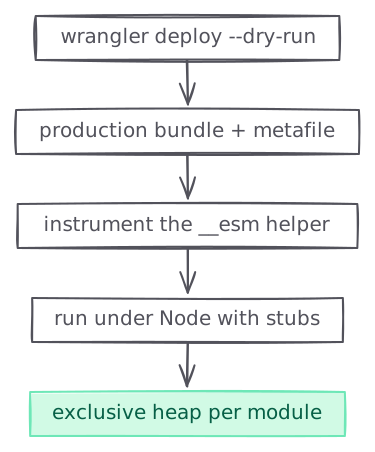
Tre ideer får det til å fungere:
- Samme bundel.
wrangler deploy --dry-run --outdir --metafilesender ut nøyaktig den esbuild-bundelen en deploy ville lastet opp, pluss modulgrafen dens. Alt måles på den bundelen. - Modulattribusjon. esbuild pakker moduler som evalueres lazily inn i
__esm(...)-initialiseringsclosures. Vi skriver om den ene hjelperen i den bygde bundelen slik at hver modulinitialisering registrererv8.getHeapStatistics().used_heap_sizefør og etter seg selv, med en initialiseringsstakk som skiller en moduls egen kostnad (eksklusiv) fra avhengighetenes (inklusiv). Resultatet er et datasett formet som en flammegraf. - Kontrollerte kjøringer. Den instrumenterte bundelen kjører under vanlig Node med et loader-shim som løser
cloudflare:*-imports til stubber.
Den komplette oppskriften, klar til å limes inn i en kodeagent, står på slutten av dette innlegget. Zod-enhetskostnadene sitert over kommer fra en mikrobenchmark kjørt gjennom det samme harnesset.
Hva den første profilen viste
| Kilde | Eksklusiv heap |
|---|---|
packages/tools (250+ agentverktøydefinisjoner, zod) | 78.0 MB |
| Pakke-barrels som re-eksporterer zod-skjemamoduler (radene under) | ~66 MB |
durable-workspaces (workspace-tilstand og tidsplaner) | 15.6 MB |
thread-core (trådens datalag) | 10.1 MB |
durable-automations (automatiseringsdefinisjoner) | 9.6 MB |
durable-threads (trådliste og direkteoppdateringer) | 7.3 MB |
durable-automation (én automatiseringskjøring) | 6.8 MB |
db (D1-klient og modeller) | 6.3 MB |
durable-skills (skill-definisjoner) | 5.7 MB |
durable-autofixes (autofiks-grener og sammenslåinger) | 4.9 MB |
| 12 mindre pakker | ~9 MB |
Den andre raden er den overraskende. Det er skjemaer som når bundelen bare gjennom export * from "./zod" i pakke-barrels. Koden vår brukte dem aldri, tree shakeren kunne ikke fjerne dem, og de kostet en tredjedel av minnegrensen, alt sammen i moduler ingenting noen gang kalte.
Fiks A: verktøydefinisjoner som data, ikke kode
Hver verktøydefinisjon erklærte inndataskjemaet sitt i zod og konverterte det til JSON-skjema ved kjøring, fordi JSON-skjema er det modellen får uansett. Vi bygde ~134 KB closures per verktøy for å produsere noen hundre bytes data, så vi skrev dataene direkte.
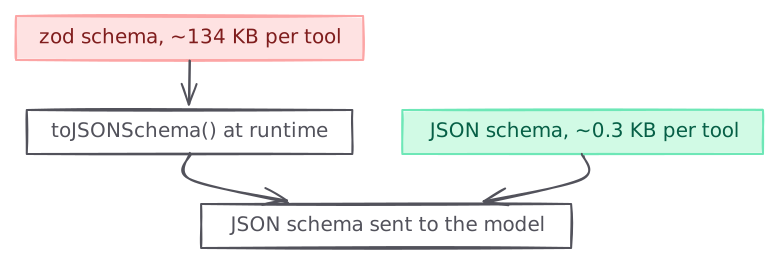
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters er en tynn innpakning over AI SDK-ens jsonSchema(). ParametersInput er json-schema-to-ts som gjør typeinferensen zod pleide å gjøre. Kjøretidsvalideringen flyttet til en validator på ~300 linjer som gjenskaper egenskapene agentløkken avhenger av: ukjente nøkler fjernes, standardverdier fylles inn, unioner løses etter diskriminator, og feilmeldinger formuleres slik at modellen kan reparere sitt eget verktøykall ved nytt forsøk.
Heapen ved modulevaluering gikk fra 218.6 til 154.0 MB lokalt, og packages/tools fra 78 MB til 0.7 MB. I produksjon falt nullstillingene fra 40-110 i timen til 0-6 i timen ved deploy-markøren, og medianisolatets minne fra ~140 MB til ~120 MB.
Fiks B: barrels som faktisk kan tree-shakes
De gjenværende ~66 MB var skjemaer isolatet aldri brukte. Tre oppførsler i bundleren forklarer det:
- Uten
"sideEffects": falsei en pakkespackage.jsonbeskjærer esbuild ingenting fra den. - Selv med flagget beskjæres
export * from "./zod"aldri inne i en modul som evalueres lazily, og alt som kan nås gjennom en dynamiskimport(), evalueres lazily. Navngitte re-eksporter (export { zFoo } from "./zod") beskjæres fint. await import("@scope/package")materialiserer pakkens hele navneromsobjekt og markerer hver eksport som brukt: skjemaer, klasser, alt.
Vi bekreftet hver av disse med en fixture på fem filer bygget med den esbuild-versjonen wrangler bygger inn: en entry, en pakke med en index.ts-barrel, en zod.ts med ett skjema der konstruktøren melder fra når den kjører, en do.ts-klasse som importerer det skjemaet, og et lazy mellomledd mellom dem. Tabellen registrerer om skjemaets konstruktør kjørte ved evaluering for hver kombinasjon.
| Entry importerer barrel via | Barrelens re-eksportform | sideEffects: false | Skjema inkludert |
|---|---|---|---|
| Statisk import | export * | Ja | Nei |
| Statisk import | export * | Nei | Ja |
Dynamisk import() av pakken | Hvilken som helst | Ja | Ja |
| Statisk import fra en modul lastet lazily | export * | Ja | Ja |
| Statisk import fra en modul lastet lazily | Navngitt liste | Ja | Nei |
| Hvilken som helst | Navngitt liste | Nei | Ja |
Rad 3 og 4 er de to som overrasker folk, og sammen sto de for de ~66 MB. Her er hva én barrel gjorde med oss:
Fiksen er mekanisk: "sideEffects": false i alle 110+ workspace-pakker, skriv om barrelenes export * til navngitte re-eksportlister, og erstatt await import("@scope/package") av pakkerøtter med statiske navngitte imports.
En ablasjon på den faktiske produksjonsbundelen viser at hver del er nødvendig.
| Konfigurasjon | Heap etter modulevaluering | Skjemamoduler i bundelen |
|---|---|---|
| Baseline (etter fiks A) | 154.0 MB | 77 |
sideEffects: false alene | 143.6 MB | 77 |
+ Statiske imports, barrels tilbake til export * (kontroll) | 98.6 MB | 29 |
| + Navngitte re-eksportlister (full fiks) | 82.1 MB | 0 |
Kontrollraden er den interessante: selv en fullt statisk importgraf beholder 29 skjemamoduler, så de navngitte listene er ikke valgfrie.
Sluttilstanden
| Heap på modulnivå (lokal probe) | Medianminne i produksjon | Nullstillinger i produksjon | |
|---|---|---|---|
| Før | 218.6 MB | ~140 MB | ~300/dag |
| Etter A | 154.0 MB | ~120 MB | ~10/dag |
| Etter A+B | 82.1 MB | ~70 MB | 0 |
Et Durable Object som lå over plattformens minnegrense i hvile, ligger nå på knapt halvparten av den, og de ~300 daglige nullstillingene er borte.
Dette er ikke et konfigurasjonsflagg
Å skrive om mer enn 250 verktøydefinisjoner fra zod til rått JSON-skjema, og skrive en validator på 300 linjer for å erstatte det zod gjorde for oss, tok noen dager, selv med kodeagenter. Å legge sideEffects: false til over 100 pakker og gjøre hver export * om til en generert navngitt liste er lite glamorøst arbeid, og du typesjekker hele repositoryet etterpå og fikser det som brekker. Det enkle alternativet er å legge til et nytt forsøk og leve med nullstillingene, og mange team gjør det. Hvis Durable Objectet ditt er i nærheten av grensen i hvile, vil jeg hevde at uken er verdt det, fordi grensen ikke flytter seg og antallet verktøy bare går opp.
De tre tingene jeg skulle ønske jeg visste fra dag én:
- Høyt og flatt i hvile betyr baseline. Profiler det du leverer, ikke det du serverer.
- Tree shaking har regler.
sideEffects: false, navngitte re-eksporter, statiske imports. Glem én, og hele pakken følger med. - Skjemaer er kode, ikke typer. Hvis konsumenten vil ha JSON-skjema, skriv JSON-skjema.
Gjør dette i dag for å fikse minnet i Durable Objectet ditt
Profileren er ~100 linjer uten andre avhengigheter enn Node og wrangler. Lim oppskriften nedenfor inn i kodeagenten din i roten av et hvilket som helst repository som deployer med wrangler, les de ti øverste radene i tabellen den skriver ut, og se hva som er der. Jobb deg deretter nedover listen: rent JSON-skjema for alt modellen uansett mottar som JSON-skjema, "sideEffects": false og navngitte re-eksporter for barrelene, statiske imports for pakkerøttene.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Vil du ha hele revisjonen gjort for deg, her er en skill for kodeagenten din:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Vi har også lagt denne skillen til i Polylane selv, så hver Polylane-bruker får denne dype undersøkelsen av minnet i sine Durable Objects rett ut av boksen, uten å lime inn noe.