

Come abbiamo risolto gli errori di memoria superata dei nostri Cloudflare Durable Objects
Explore with AI
Ogni thread degli agenti in Polylane gira dentro un proprio Cloudflare Durable Object, tutti istanze di un’unica classe. Nell’agosto 2026, i Durable Objects dei nostri thread venivano resettati circa 300 volte al giorno per aver superato il limite di memoria. Abbiamo sentito la stessa storia da più team che fanno girare i loro flussi agentici su Cloudflare Durable Objects.
Se hai incontrato exceededMemory su un Durable Object, il consiglio abituale è guardare cosa allocano le tue richieste: un payload troppo grande, una cronologia di chat che cresce senza limiti, una cache che non svuota mai. Niente di tutto questo valeva per noi. L’isolate era oltre il limite prima di aver servito una singola richiesta, quindi il peso doveva stare nel codice che rilasciavamo e non nei dati che servivamo.
Questo articolo racconta cosa c’era davvero nell’heap, come l’abbiamo trovato su una piattaforma che non ti lascia collegare un profiler, e le due modifiche che hanno portato la memoria a livello di modulo da 218 MB a 82 MB e i reset a zero.
I Cloudflare Durable Objects in un minuto
Se non li hai mai usati: un Durable Object è un piccolo server con stato, a thread singolo, che Cloudflare garantisce essere unico per un dato ID. Chiama idFromName() con quell’ID da un Worker e ogni richiesta per quell’ID, da qualsiasi parte del mondo, atterra sulla stessa istanza, con il proprio database SQLite, stato in memoria e allarmi. Va in ibernazione quando è inattivo e si risveglia da dove si era fermato.
In Polylane creiamo un’istanza di Durable Object per ogni thread. Ogni conversazione con l’agente, che l’abbia avviata una persona o un alert, riceve il proprio Durable Object. Lo SQLite dell’oggetto contiene i messaggi e i risultati degli strumenti del thread, il ciclo dell’agente gira al suo interno, e i suoi strumenti chiamano i provider di cui il thread ha bisogno: Datadog, Sentry, Honeycomb, GitHub, Cloudflare e gli altri. Quando il thread diventa silenzioso l’oggetto va in ibernazione, e quando arriva il messaggio successivo riprende esattamente da dove si era fermato.
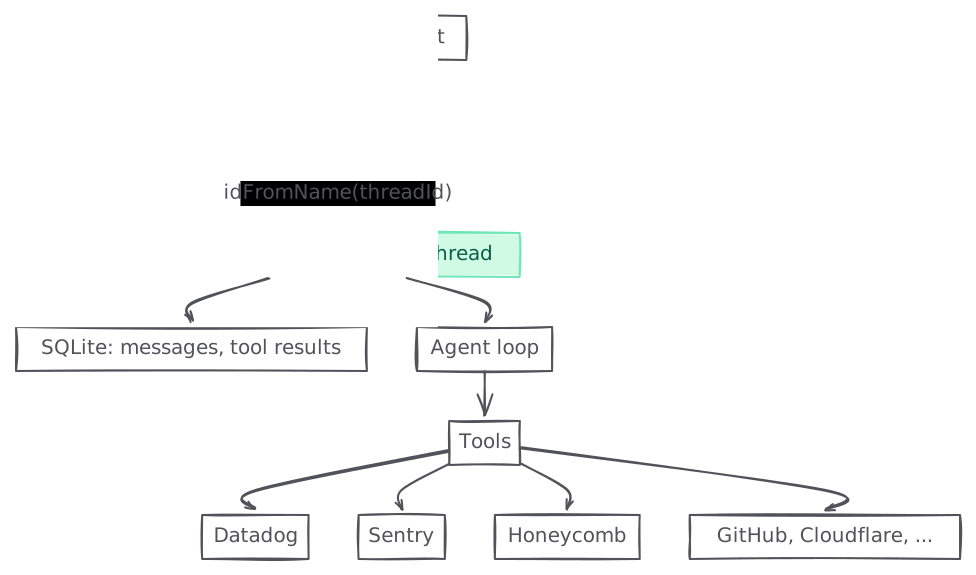
Come funziona la memoria dei Durable Objects
- Isolate e il tetto di 128 MB. I Durable Objects girano dentro isolate V8, e un isolate ha un limite rigido di memoria di 128 MB, uguale su ogni piano e non configurabile.
- Co-locazione. Un singolo isolate ospita molti Durable Objects della stessa classe, insieme al codice del Worker che li circonda, e tutti condividono la memoria di quell’isolate. Il limite è per isolate e non per oggetto.
- Vicini rumorosi. A causa della co-locazione, l’oggetto che viene resettato quando l’isolate esaurisce la memoria spesso non è l’oggetto che ha usato la memoria. Ogni campione di memoria riportato da Cloudflare riguarda l’intero isolate, e lo stesso vale per ogni reset.
Non c’è modo di collegare un profiler di memoria a un Durable Object in produzione: gli strumenti di heap snapshot documentati da Cloudflare girano su una sessione di sviluppo locale. In Kubernetes attiveresti il profiling e ti collegheresti finché non trovi il problema. In workerd, process.memoryUsage() è un polyfill di unenv che restituisce zeri, e i valori di base di memoria e CPU non sono visibili al codice che gira all’interno. Quello che ottieni è l’API GraphQL di analytics di Cloudflare: percentili di memoria e conteggi dei crash per namespace, a posteriori.
Cosa ci ha detto il grafico della memoria
L’API di analytics di Cloudflare riporta la memoria di un namespace di Durable Objects come percentili tra gli isolate che lo eseguono, in bucket di quindici minuti, insieme al conteggio degli errori di memoria superata in ogni bucket. Ogni grafico in questo articolo viene da quell’API, filtrata sul namespace dei thread e confrontata tra i marcatori di deploy una volta che abbiamo iniziato a rilasciare i fix.
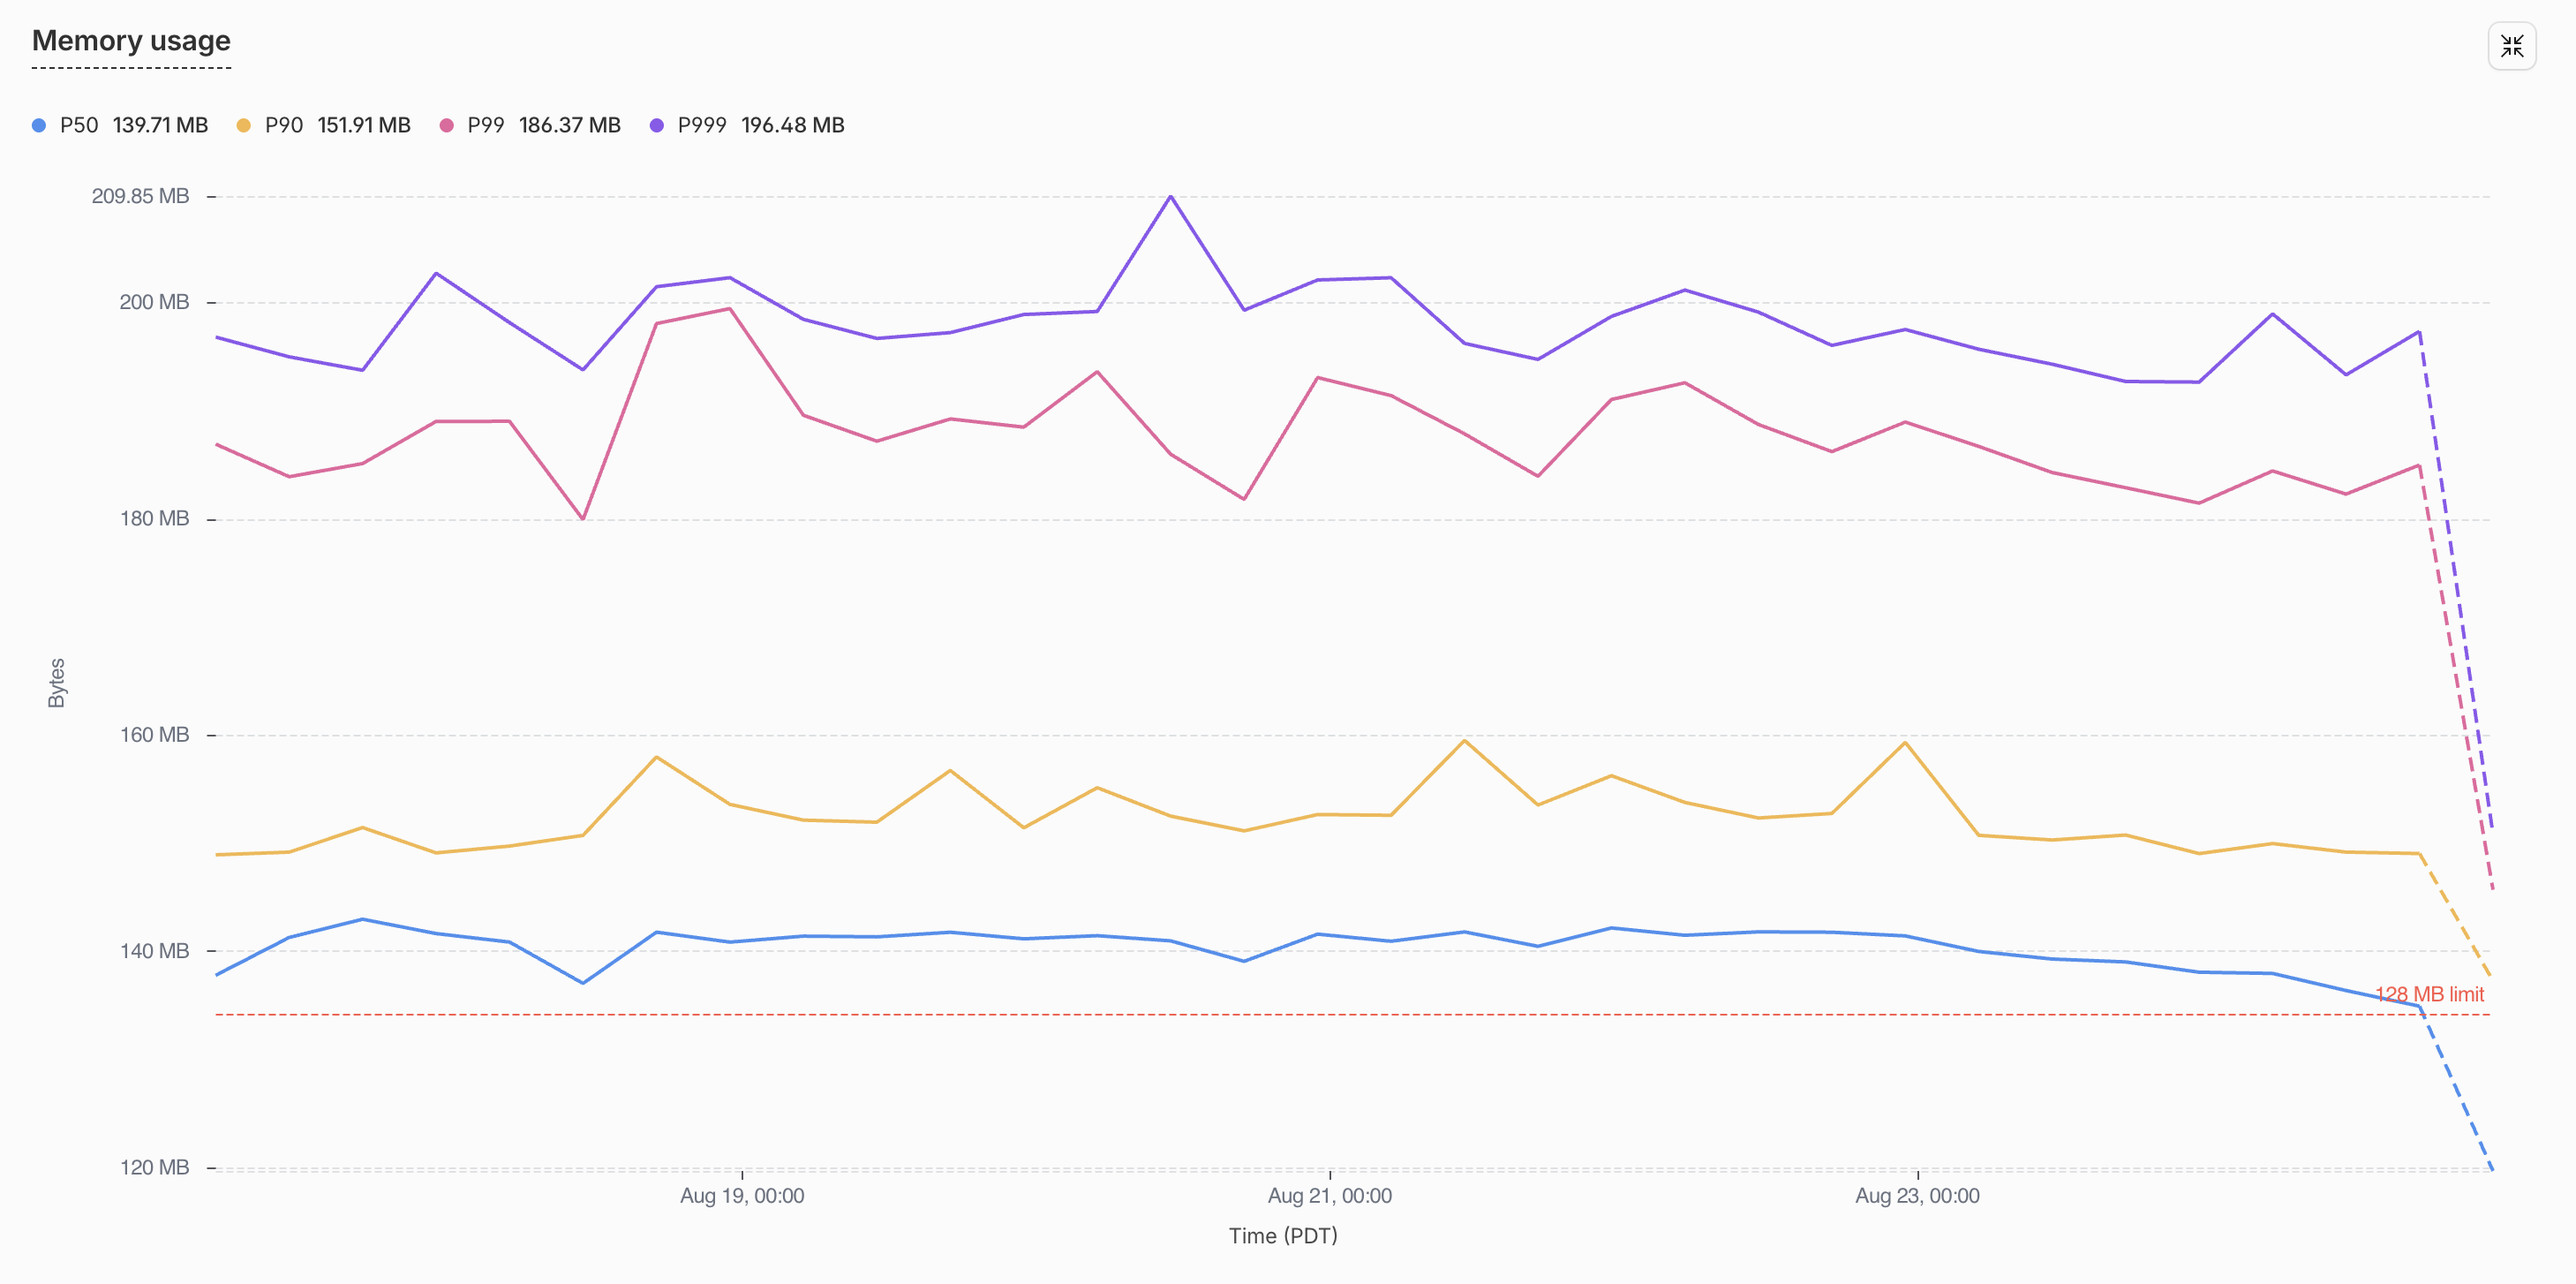
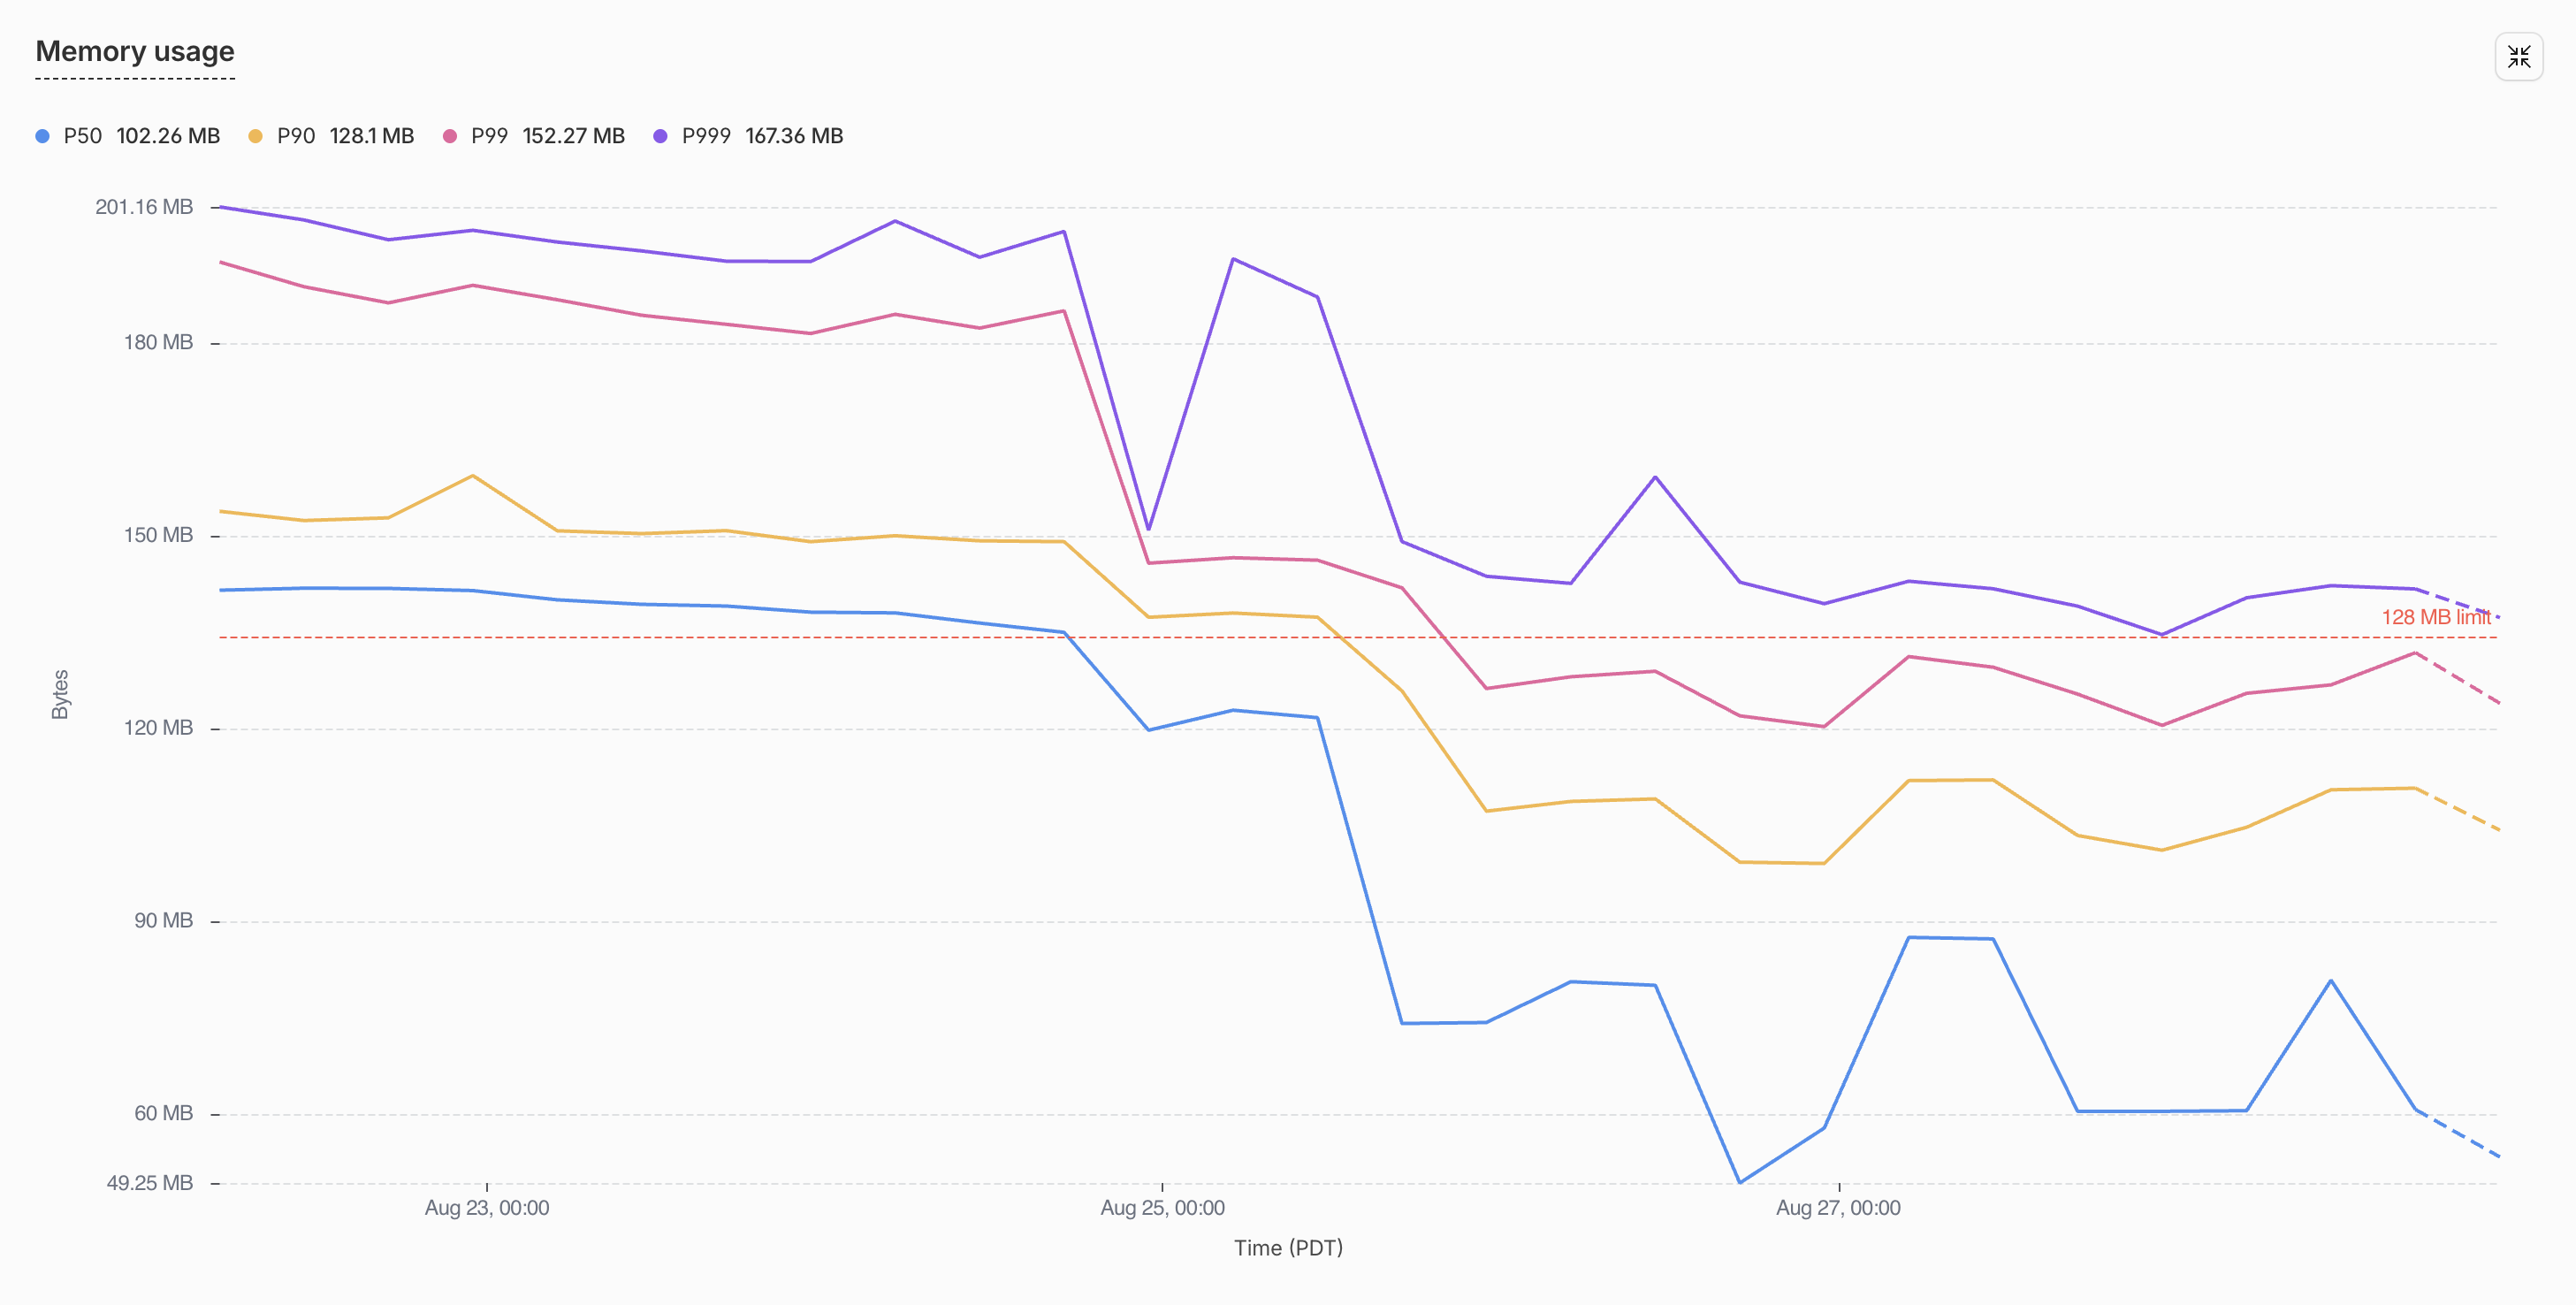
L’isolate mediano, la linea blu nella figura 1, è rimasto a circa 140 MB per l’intera settimana, e il 99° percentile è rimasto vicino a 190 MB. Entrambe le linee sono sopra il limite tratteggiato di 128 MB, il che significa che l’isolate tipico del namespace era già oltre il punto in cui Cloudflare ha il diritto di resettarlo, e veniva risparmiato solo finché l’allocazione successiva non lo faceva traboccare. Quello che il grafico non mostrava era una qualsiasi relazione con il traffico. La linea era piatta nelle ore tranquille quanto in quelle di punta, e nessuno dei circa 300 reset al giorno arrivava con uno stack trace, perché non era mai il nostro codice a lanciare l’errore.
Abbiamo guardato dove ti aspetteresti di guardare per primo. Abbiamo letto le dimensioni dei payload, controllato come veniva troncata la cronologia della chat e cercato nella curva della memoria un pattern legato alle richieste, senza trovare nulla che muovesse la linea. Quella piattezza si è rivelata l’indizio importante. La memoria di un isolate è una di due cose: o sono dati, cioè payload delle richieste, cronologia della chat, output degli strumenti e qualsiasi altra cosa allocata mentre si serve il traffico, oppure è baseline, cioè gli oggetti che il codice stesso crea quando un modulo viene caricato e tiene in vita per tutta la durata dell’isolate, come import, funzioni e schemi. I dati salgono e scendono con le richieste, mentre la baseline c’è prima della prima richiesta e non se ne va mai, quindi un grafico alto e piatto a riposo sta descrivendo la baseline. Il problema doveva stare in ciò che rilasciavamo e non in ciò che servivamo.
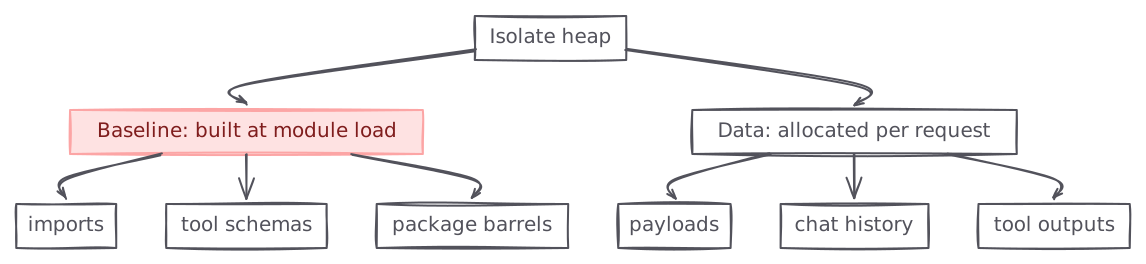
Perché la memoria di baseline è così facile da non vedere
La memoria di baseline si nasconde in due posti in cui normalmente non guardi.
Il primo è il bundler. Diamo per scontato che il tree shaking rimuova il codice che non usiamo, e per lo più lo fa, ma esbuild ha regole su quando può potare e non sono le regole che indovineresti. Un package senza "sideEffects": false nel suo package.json non viene mai potato. Nemmeno un export * dentro un modulo valutato in modo lazy viene mai potato. Un import() dinamico della radice di un package segna ogni export come usato. Torneremo su ciascuno di questi nei fix, perché spiegano metà dei 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Il secondo è la libreria di schemi. I tipi sembrano gratis perché svaniscono in fase di compilazione, ma uno schema zod non è un tipo, è un albero di closure costruito nel momento in cui il suo modulo viene valutato. Un singolo schema oggetto zod 4 di media grandezza, una dozzina di campi con descrizioni e refinement, costa ~134 KB di heap. Un semplice z.string() costa ~12 KB. L’oggetto JSON schema equivalente costa qualche centinaio di byte. Niente di tutto questo è nel README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Non avevamo fatto nulla di esotico
Ognuno dei nostri problemi veniva da un’impostazione predefinita. Ogni strumento dell’agente dichiarava il proprio input con z.object() a livello di modulo, perché è così che fa la documentazione. Ogni package interno aveva un barrel index.ts con export * from "./zod", perché è ordinato. Alcuni percorsi usavano await import("@scope/package") perché il caricamento lazy dovrebbe costare meno. Ognuna è una scelta ragionevole presa da sola. Insieme erano 130 MB, in un isolate con 128 da spendere.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Quanto ci stava costando
Il nostro agente ha oltre 250 strumenti, che usa tramite code mode e worker dinamici. Le loro sole definizioni zod costavano 78 MB di heap al caricamento dei moduli, più della metà del budget dell’isolate, spesi in descrizioni di argomenti prima che uno qualsiasi di essi venisse chiamato. Ogni strumento che aggiungevamo costava altri ~134 KB, che quello strumento venisse mai eseguito o no.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Nemmeno i reset erano gratis. Ogni exceededMemory butta via un turno dell’agente in corso: un retry, una seconda chiamata al modello, un utente che guarda uno spinner. A ~300 al giorno smette di essere un incidente e diventa una tassa permanente, e a causa della co-locazione la pagava qualsiasi oggetto si trovasse nell’isolate in quel momento.
Error: Durable Object's isolate exceeded its memory limit and was reset.Come l’abbiamo trovato: un profiler dell’heap per il bundle di produzione
Non potevamo profilare la produzione, quindi abbiamo costruito un piccolo profiler che gira in locale sull’esatto bundle che gira in produzione. Misura il costo in heap V8 della valutazione di ogni modulo e stampa una tabella ordinata. L’abbiamo eseguito in un ciclo: profila, rimuovi la cima della classifica, profila di nuovo. La verifica finale di ogni fix era un deploy in produzione confrontato con le metriche di memoria di Cloudflare ai due lati del marcatore di deploy.
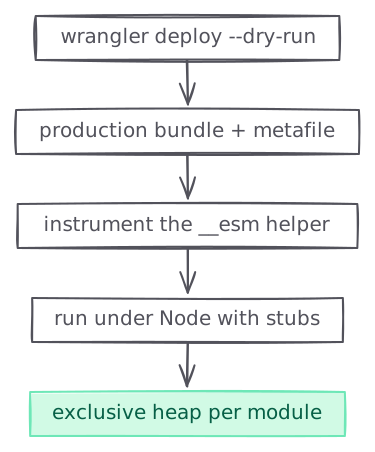
Tre idee lo fanno funzionare:
- Stesso bundle.
wrangler deploy --dry-run --outdir --metafileemette l’esatto bundle esbuild che un deploy caricherebbe, più il suo grafo dei moduli. Tutto viene misurato su quel bundle. - Attribuzione per modulo. esbuild avvolge i moduli valutati in modo lazy in closure di inizializzazione
__esm(...). Riscriviamo quell’unico helper nel bundle costruito così che ogni init di modulo registriv8.getHeapStatistics().used_heap_sizeprima e dopo di sé, con uno stack di init che separa il costo proprio di un modulo (esclusivo) da quello delle sue dipendenze (inclusivo). Il risultato è un dataset a forma di flamegraph. - Esecuzioni controllate. Il bundle strumentato gira sotto Node puro con uno shim del loader che risolve gli import
cloudflare:*in stub.
La ricetta completa, pronta da incollare in un agente di coding, è alla fine di questo articolo. I costi unitari di zod citati sopra vengono da un micro-benchmark eseguito con lo stesso harness.
Cosa ha mostrato il primo profilo
| Sorgente | Heap esclusivo |
|---|---|
packages/tools (250+ definizioni di strumenti dell’agente, zod) | 78.0 MB |
| Barrel dei package che riesportano moduli di schemi zod (righe sotto) | ~66 MB |
durable-workspaces (stato e pianificazioni del workspace) | 15.6 MB |
thread-core (livello dati dei thread) | 10.1 MB |
durable-automations (definizioni delle automazioni) | 9.6 MB |
durable-threads (elenco dei thread e aggiornamenti in tempo reale) | 7.3 MB |
durable-automation (un singolo run di automazione) | 6.8 MB |
db (client D1 e modelli) | 6.3 MB |
durable-skills (definizioni delle skill) | 5.7 MB |
durable-autofixes (branch e merge degli autofix) | 4.9 MB |
| 12 package più piccoli | ~9 MB |
La seconda riga è quella sorprendente. Sono schemi che raggiungono il bundle solo tramite export * from "./zod" nei barrel dei package. Il nostro codice non li usava mai, il tree shaker non poteva rimuoverli, e costavano un terzo del limite di memoria, tutto in moduli che nulla chiamava mai.
Fix A: definizioni degli strumenti come dati, non come codice
Ogni definizione di strumento dichiarava il proprio schema di input in zod e lo convertiva in JSON schema a runtime, perché il JSON schema è comunque ciò che viene inviato al modello. Stavamo costruendo ~134 KB di closure per strumento per produrre qualche centinaio di byte di dati, quindi abbiamo scritto direttamente i dati.
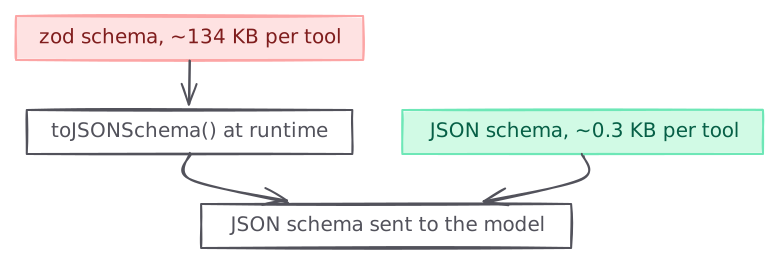
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters è un sottile wrapper sopra jsonSchema() dell’AI SDK. ParametersInput è json-schema-to-ts che fa l’inferenza dei tipi che prima faceva zod. La validazione a runtime è passata a un validatore di ~300 righe che riproduce le proprietà da cui dipende il ciclo dell’agente: chiavi sconosciute rimosse, valori predefiniti riempiti, union risolte per discriminatore e messaggi di errore formulati in modo che il modello possa riparare la propria chiamata allo strumento al tentativo successivo.
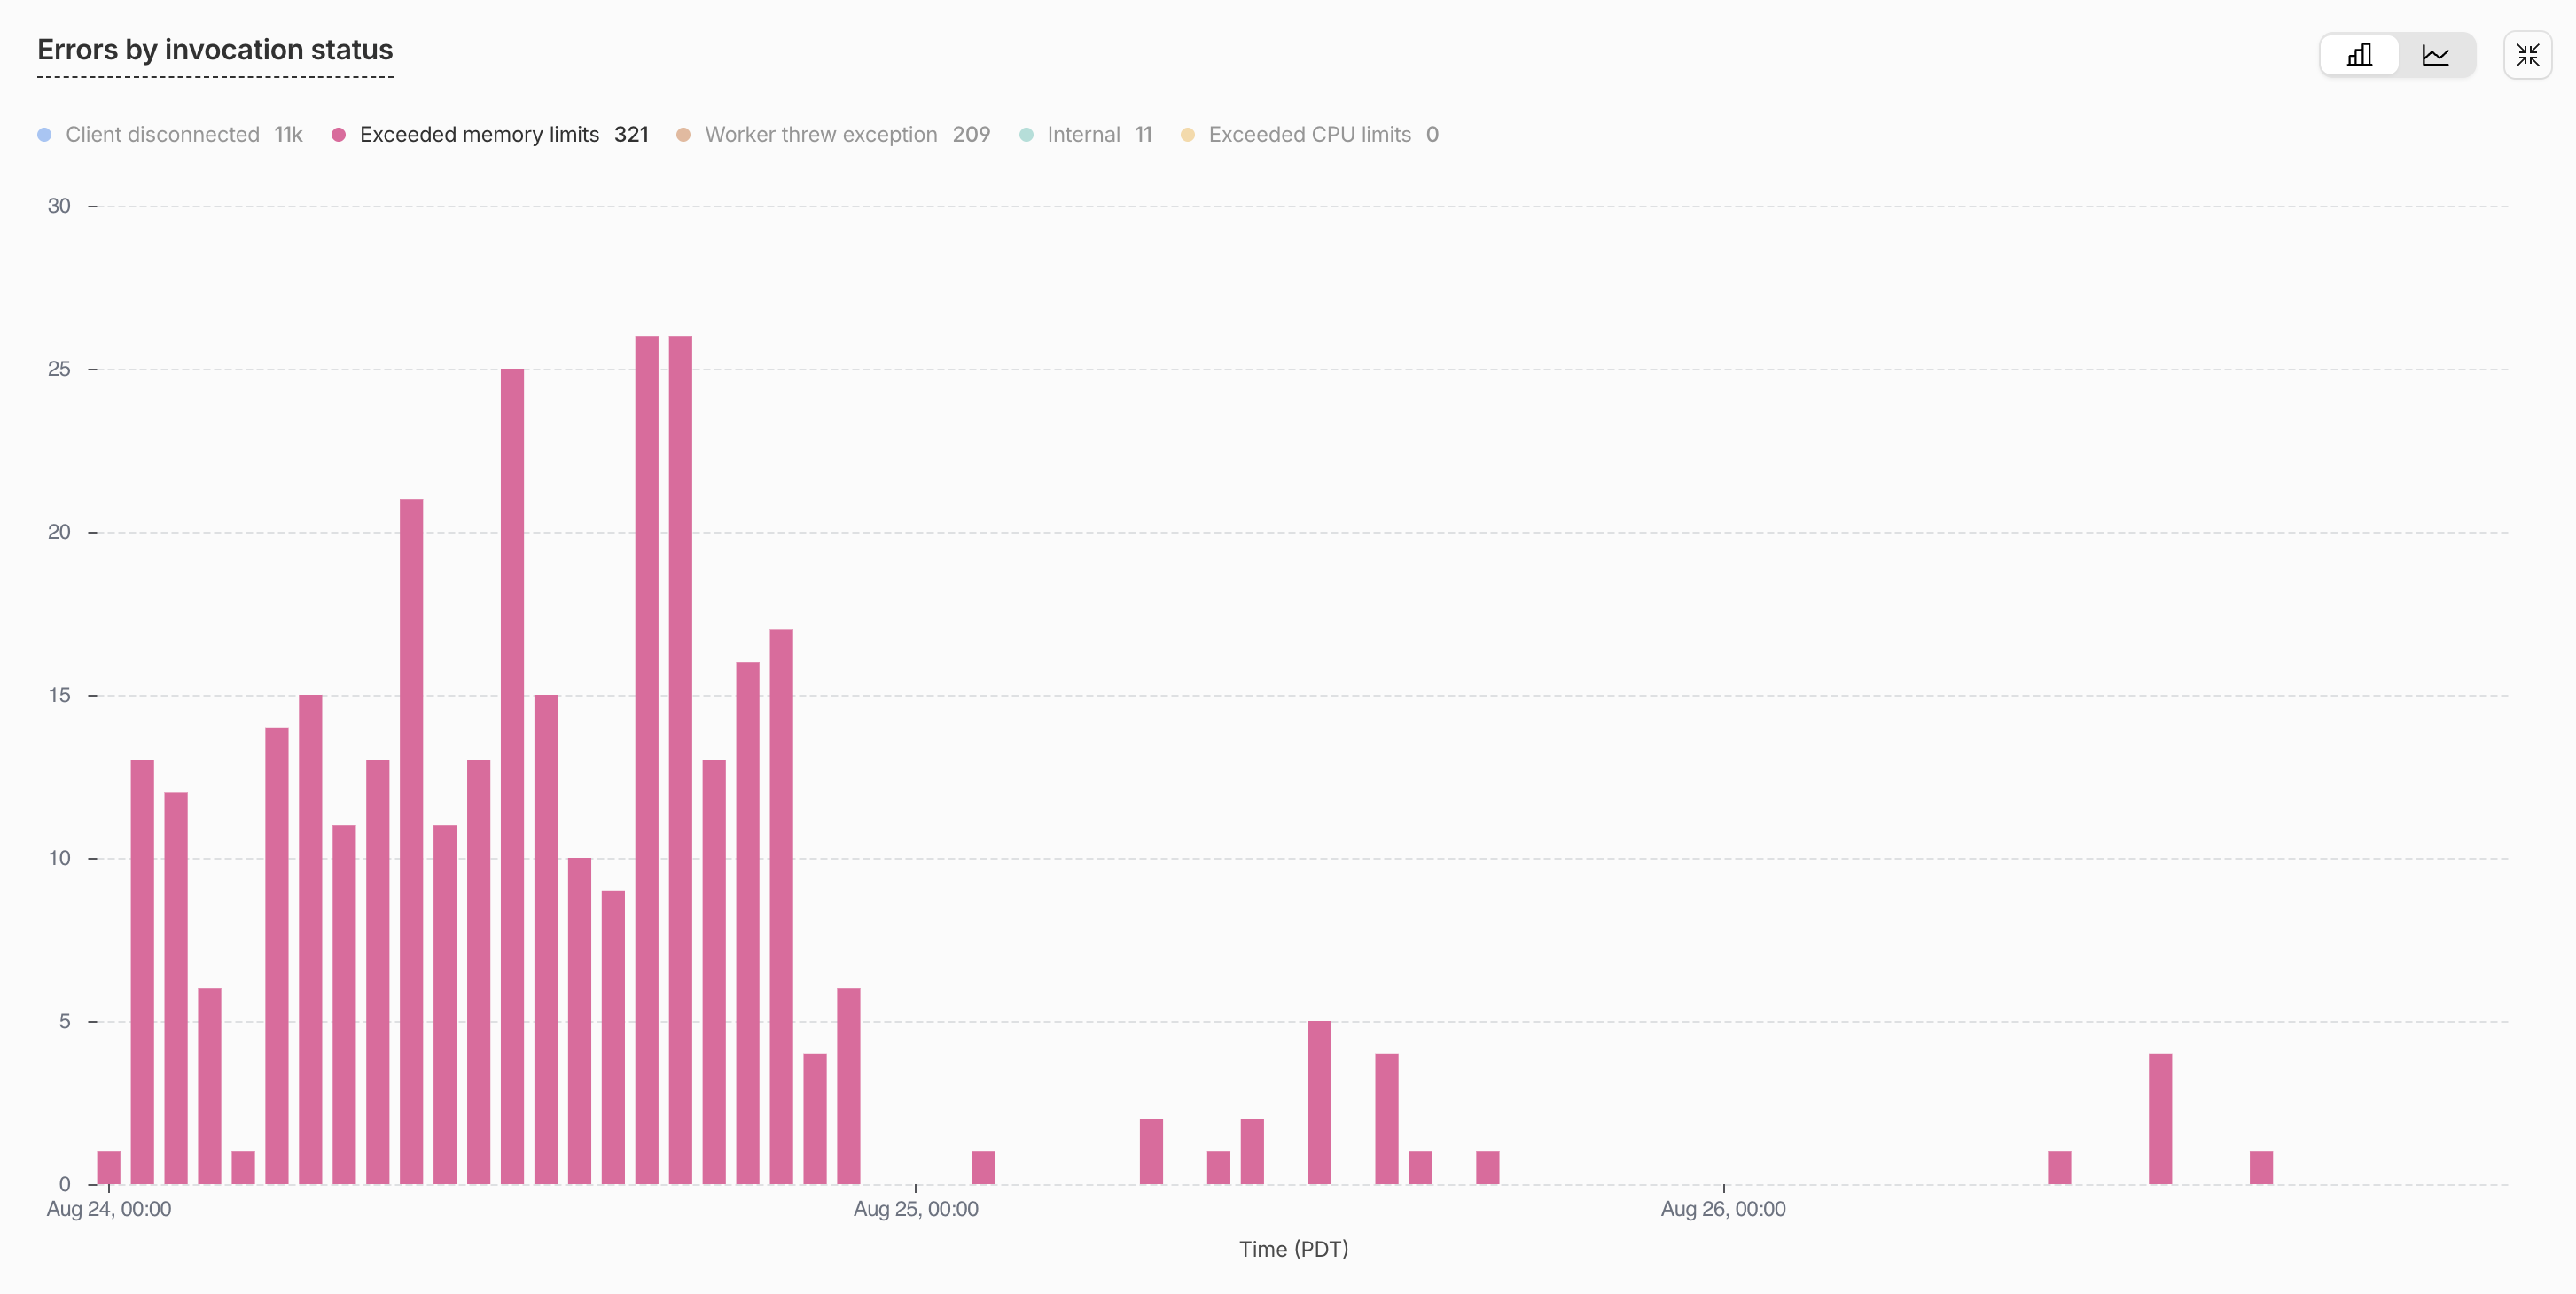
L’heap dopo la valutazione dei moduli è passato da 218.6 a 154.0 MB in locale, e packages/tools da 78 MB a 0.7 MB. In produzione, i reset sono scesi da 40-110 all’ora a 0-6 all’ora al marcatore di deploy, e la memoria dell’isolate mediano da ~140 MB a ~120 MB.
Fix B: barrel che si possono davvero potare
I restanti ~66 MB erano schemi che l’isolate non usava mai. Tre comportamenti del bundler lo spiegano:
- Senza
"sideEffects": falsenelpackage.jsondi un package, esbuild non ne pota nulla. - Anche con il flag,
export * from "./zod"non viene mai potato dentro un modulo valutato in modo lazy, e tutto ciò che è raggiungibile tramite unimport()dinamico viene valutato in modo lazy. Le riesportazioni con nome (export { zFoo } from "./zod") vengono potate senza problemi. await import("@scope/package")materializza l’intero oggetto namespace del package, segnando ogni export come usato: schemi, classi, tutto.
Abbiamo confermato ciascuno di questi con una fixture di cinque file costruita con la versione di esbuild che wrangler incorpora: un entry, un package con un barrel index.ts, uno zod.ts con un solo schema il cui costruttore annuncia quando viene eseguito, una classe do.ts che importa quello schema e un intermediario lazy tra i due. La tabella registra se il costruttore dello schema è stato eseguito alla valutazione per ogni combinazione.
| L’entry importa il barrel tramite | Forma della riesportazione nel barrel | sideEffects: false | Schema incluso |
|---|---|---|---|
| Import statico | export * | Sì | No |
| Import statico | export * | No | Sì |
import() dinamico del package | Qualsiasi | Sì | Sì |
| Import statico da un modulo caricato in modo lazy | export * | Sì | Sì |
| Import statico da un modulo caricato in modo lazy | Elenco con nome | Sì | No |
| Qualsiasi | Elenco con nome | No | Sì |
Le righe 3 e 4 sono le due che sorprendono, e insieme spiegavano i ~66 MB. Ecco cosa ci stava facendo un solo barrel:
Il fix è meccanico: "sideEffects": false in tutti i 110+ package del workspace, riscrivere gli export * dei barrel in elenchi di riesportazioni con nome, e sostituire gli await import("@scope/package") delle radici dei package con import statici con nome.
Un’ablazione sul vero bundle di produzione mostra che ogni pezzo è necessario.
| Configurazione | Heap dopo la valutazione dei moduli | Moduli di schemi nel bundle |
|---|---|---|
| Baseline (dopo il fix A) | 154.0 MB | 77 |
Solo sideEffects: false | 143.6 MB | 77 |
+ Import statici, barrel di nuovo con export * (controllo) | 98.6 MB | 29 |
| + Elenchi di riesportazioni con nome (fix completo) | 82.1 MB | 0 |
La riga di controllo è quella interessante: anche un grafo di import completamente statico mantiene 29 moduli di schemi, quindi gli elenchi con nome non sono facoltativi.
Lo stato finale
| Heap a livello di modulo (sonda locale) | Memoria mediana in produzione | Reset in produzione | |
|---|---|---|---|
| Prima | 218.6 MB | ~140 MB | ~300/giorno |
| Dopo A | 154.0 MB | ~120 MB | ~10/giorno |
| Dopo A+B | 82.1 MB | ~70 MB | 0 |
Un Durable Object che a riposo stava sopra il limite di memoria della piattaforma ora a riposo sta a poco più della metà, e i ~300 reset giornalieri sono spariti.
Non è un flag di configurazione
Riscrivere più di 250 definizioni di strumenti da zod a JSON schema puro, e scrivere un validatore di 300 righe per sostituire ciò che zod faceva per noi, ha richiesto qualche giorno, anche con gli agenti di coding. Aggiungere sideEffects: false a oltre 100 package e trasformare ogni export * in un elenco con nome generato è lavoro poco glamour, e dopo fai il typecheck dell’intero repository e sistemi ciò che si rompe. L’alternativa facile è aggiungere un retry e convivere con i reset, e molti team lo fanno. Se il tuo Durable Object è anche solo vicino al limite a riposo, direi che la settimana vale la pena, perché il limite non si muove e il numero dei tuoi strumenti può solo salire.
Le tre cose che avrei voluto sapere dal primo giorno:
- Alto e piatto a riposo significa baseline. Profila ciò che rilasci, non ciò che servi.
- Il tree shaking ha delle regole.
sideEffects: false, riesportazioni con nome, import statici. Saltane una e l’intero package viaggia insieme al resto. - Gli schemi sono codice, non tipi. Se il consumatore vuole JSON schema, scrivi JSON schema.
Fallo oggi per sistemare la memoria del tuo Durable Object
Il profiler è ~100 righe senza dipendenze oltre a Node e wrangler. Incolla la ricetta qui sotto nel tuo agente di coding alla radice di qualsiasi repository che fa il deploy con wrangler, leggi le prime dieci righe della tabella che stampa e guarda cosa c’è. Poi scendi lungo l’elenco: JSON schema puro per tutto ciò che il modello riceve comunque come JSON schema, "sideEffects": false e riesportazioni con nome per i barrel, import statici per le radici dei package.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Se vuoi che l’intero audit venga fatto per te, ecco una skill per il tuo agente di coding:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Abbiamo aggiunto questa skill anche a Polylane stesso, così ogni utente Polylane ottiene questa indagine approfondita sulla memoria dei propri Durable Objects senza alcuna configurazione, senza nulla da incollare.