

Wie wir die Memory-Exceeded-Fehler unserer Cloudflare Durable Objects behoben haben
Explore with AI
Jeder Agenten-Thread in Polylane läuft in seinem eigenen Cloudflare Durable Object, alle Instanzen einer einzigen Klasse. Im August 2026 wurden die Durable Objects unserer Threads etwa 300-mal am Tag zurückgesetzt, weil sie das Speicherlimit überschritten hatten. Dieselbe Geschichte hörten wir von mehreren Teams, die ihre agentischen Abläufe auf Cloudflare Durable Objects betreiben.
Wenn du exceededMemory auf einem Durable Object gesehen hast, lautet der übliche Rat, dir anzusehen, was deine Requests allozieren: ein zu großer Payload, eine Chat-Historie, die unbegrenzt wächst, ein Cache, der nie räumt. Nichts davon traf auf uns zu. Das Isolate war über dem Limit, bevor es einen einzigen Request bedient hatte, also musste das Gewicht im Code stecken, den wir auslieferten, nicht in den Daten, die wir bedienten.
Dieser Beitrag handelt davon, was tatsächlich im Heap lag, wie wir es auf einer Plattform gefunden haben, die keinen Profiler anhängen lässt, und von den zwei Änderungen, die den Speicher auf Modulebene von 218 MB auf 82 MB und die Resets auf null gebracht haben.
Cloudflare Durable Objects in einer Minute
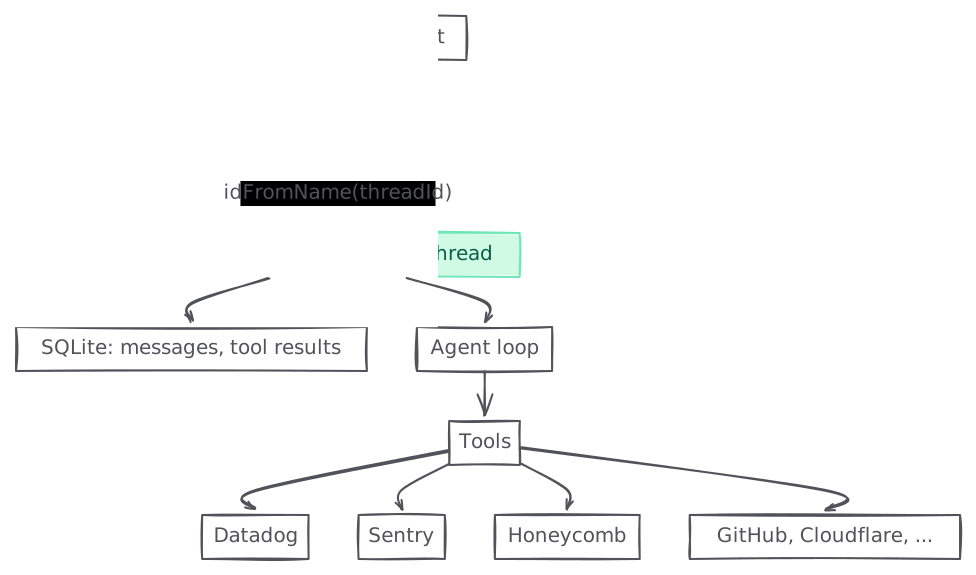
Falls du sie nicht kennst: Ein Durable Object ist ein kleiner, zustandsbehafteter, single-threaded Server, von dem Cloudflare garantiert, dass er für eine gegebene ID einzigartig ist. Ruf idFromName() mit dieser ID aus einem Worker auf, und jeder Request dafür, von überall auf der Welt, landet auf derselben Instanz, mit eigener SQLite-Datenbank, In-Memory-Zustand und Alarmen. Sie schläft, wenn nichts los ist, und wacht dort auf, wo sie aufgehört hat.
In Polylane erzeugen wir für jeden Thread eine Durable-Object-Instanz. Jedes Gespräch mit dem Agenten, ob ein Mensch es gestartet hat oder ein Alert, bekommt sein eigenes Durable Object. Das SQLite des Objekts hält die Nachrichten und Tool-Ergebnisse des Threads, der Agenten-Loop läuft darin, und seine Tools rufen hinaus zu den Providern, die der Thread braucht: Datadog, Sentry, Honeycomb, GitHub, Cloudflare und der Rest. Wird der Thread still, schläft das Objekt, und wenn die nächste Nachricht kommt, macht es genau dort weiter, wo es aufgehört hat.
Wie der Speicher von Durable Objects funktioniert
- Isolates und das 128-MB-Limit. Durable Objects laufen in V8-Isolates, und ein Isolate hat ein hartes Speicherlimit von 128 MB, das in jedem Plan gleich und nicht konfigurierbar ist.
- Co-Location. Ein einzelnes Isolate beherbergt viele Durable Objects derselben Klasse, zusammen mit dem Worker-Code um sie herum, und sie alle teilen sich den Speicher dieses Isolates. Das Limit gilt pro Isolate, nicht pro Objekt.
- Laute Nachbarn. Wegen der Co-Location ist das Objekt, das zurückgesetzt wird, wenn dem Isolate der Speicher ausgeht, oft nicht das Objekt, das den Speicher verbraucht hat. Jede Speicherprobe, die Cloudflare meldet, gilt für das ganze Isolate, und das gilt auch für jeden Reset.
Es gibt keine Möglichkeit, einen Speicher-Profiler an ein Durable Object in Produktion zu hängen: Das Heap-Snapshot-Tooling, das Cloudflare dokumentiert, läuft gegen eine lokale Dev-Session. In Kubernetes würdest du das Profiling einschalten und dich anhängen, bis du das Problem gefunden hast. In workerd ist process.memoryUsage() ein unenv-Polyfill, das Nullen zurückgibt, und die Baseline-Werte für Speicher und CPU sind für den Code, der darin läuft, nicht sichtbar. Was du bekommst, ist Cloudflares GraphQL-Analytics-API: Speicher-Perzentile und Absturzzahlen pro Namespace, im Nachhinein.
Was uns der Speichergraph gesagt hat
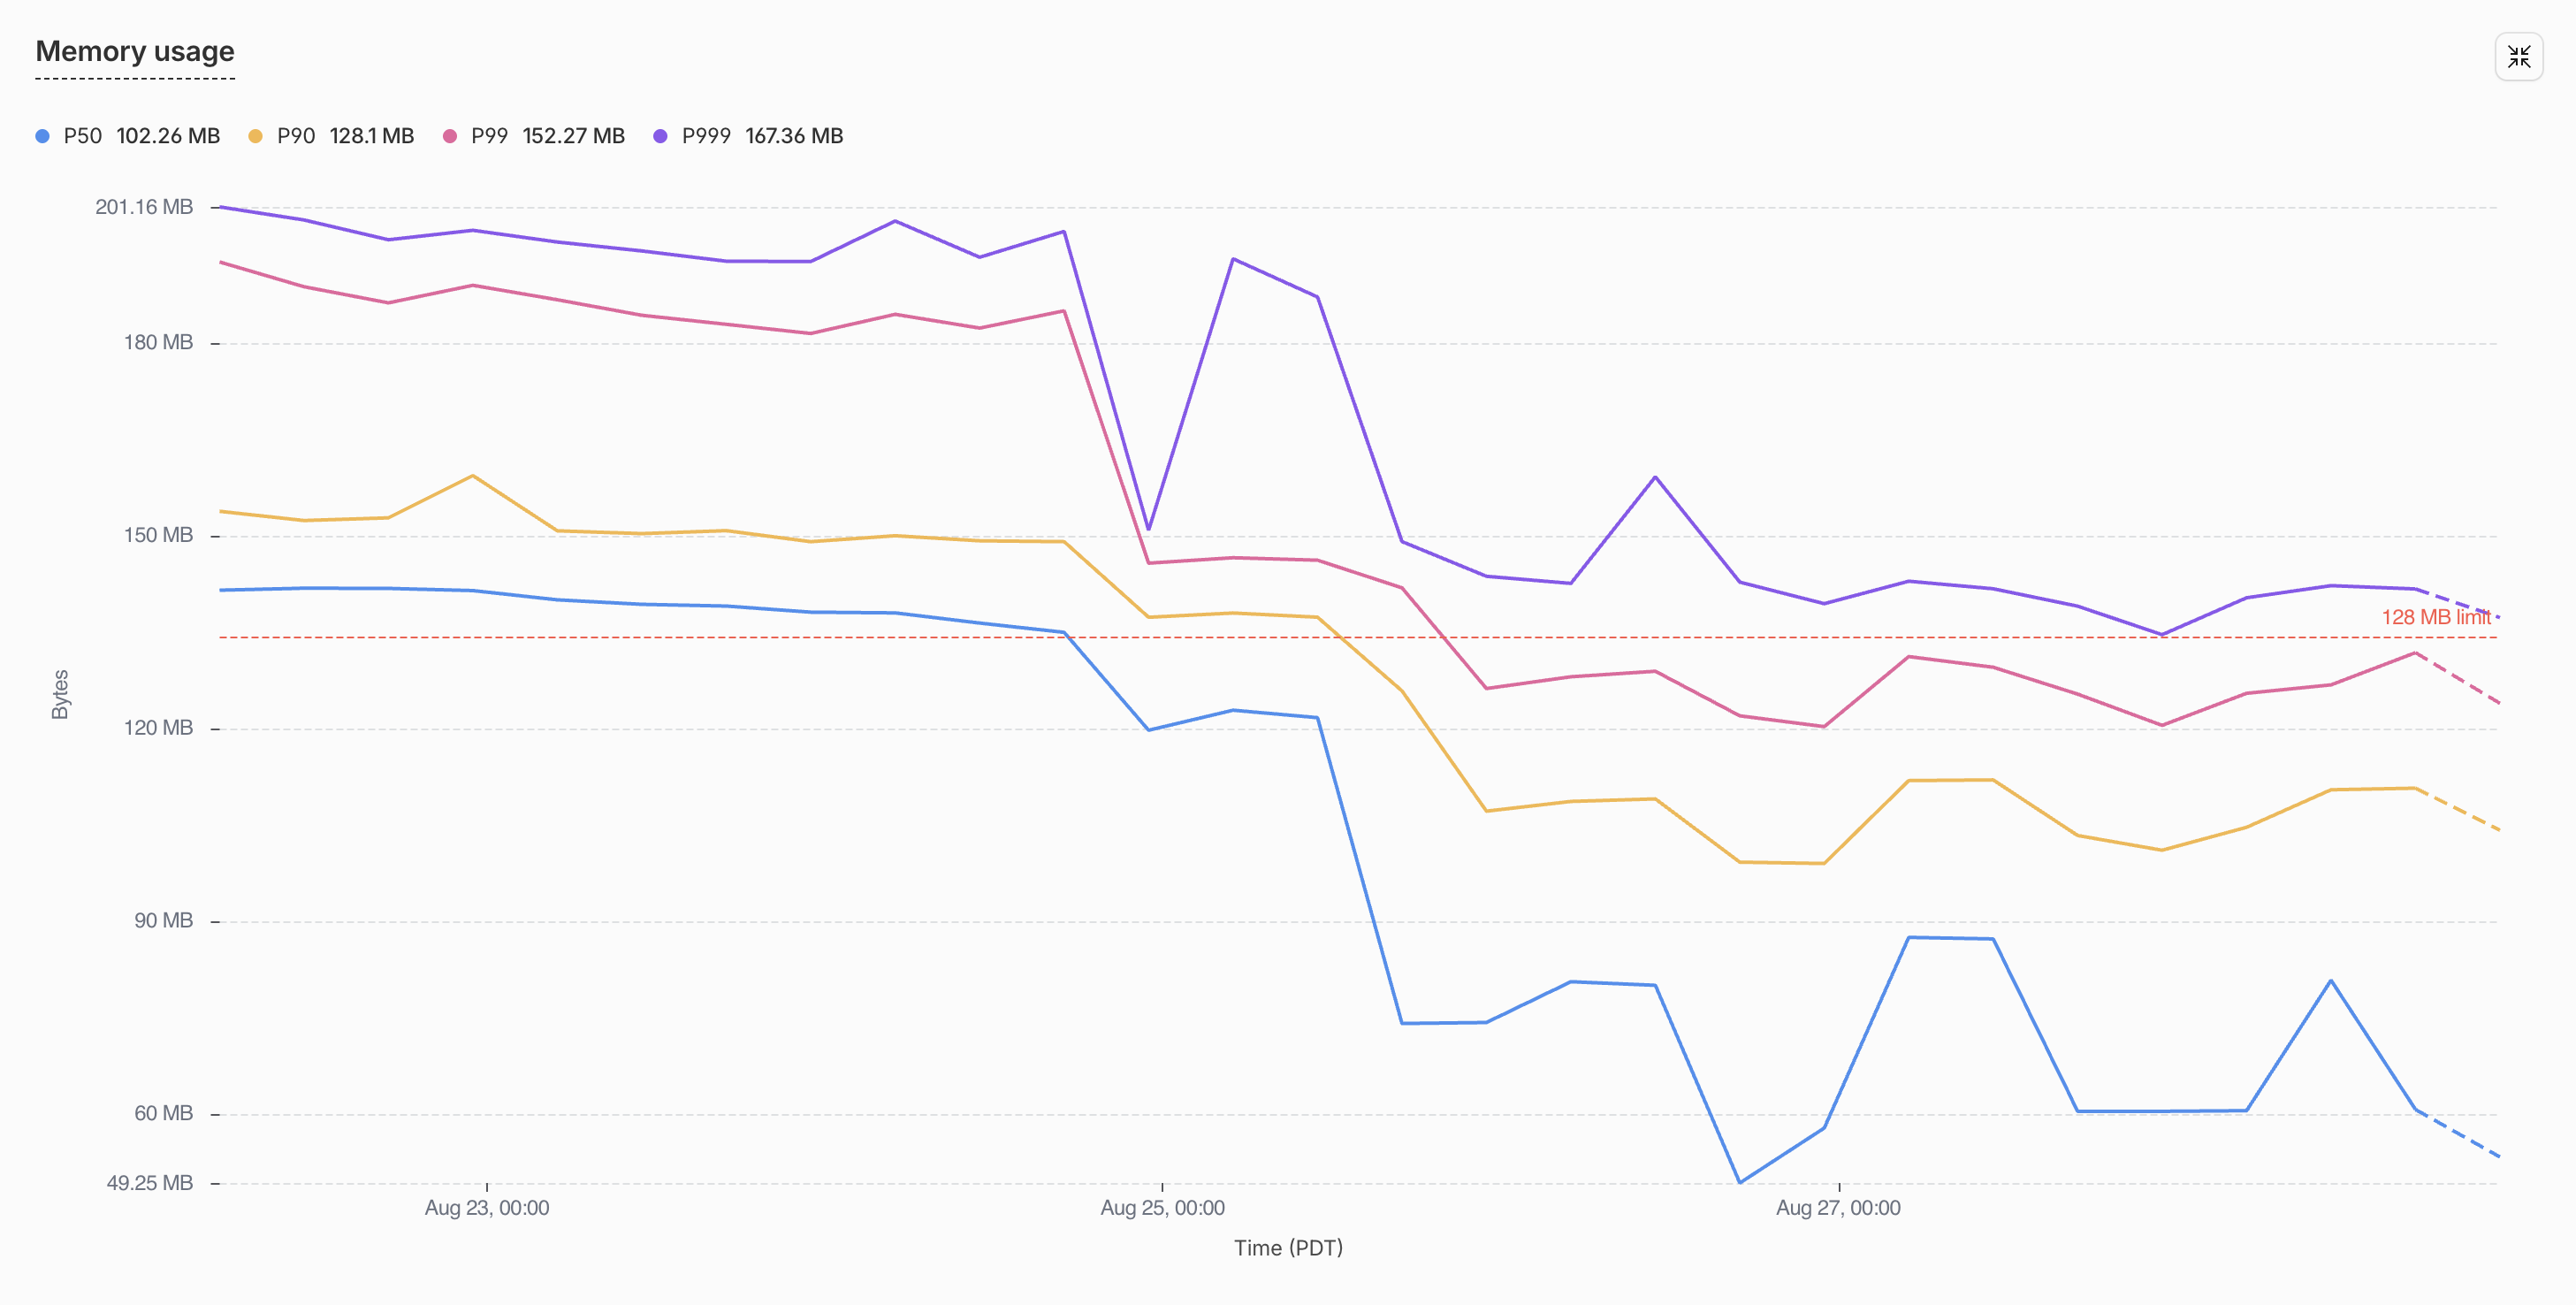
Cloudflares Analytics-API meldet den Speicher eines Durable-Object-Namespace als Perzentile über die Isolates, die ihn ausführen, in Fünfzehn-Minuten-Buckets, zusammen mit der Zahl der Exceeded-Memory-Fehler in jedem Bucket. Jeder Graph in diesem Beitrag stammt aus dieser API, gefiltert auf den Thread-Namespace und über Deploy-Marker hinweg verglichen, sobald wir angefangen haben, Fixes auszuliefern.
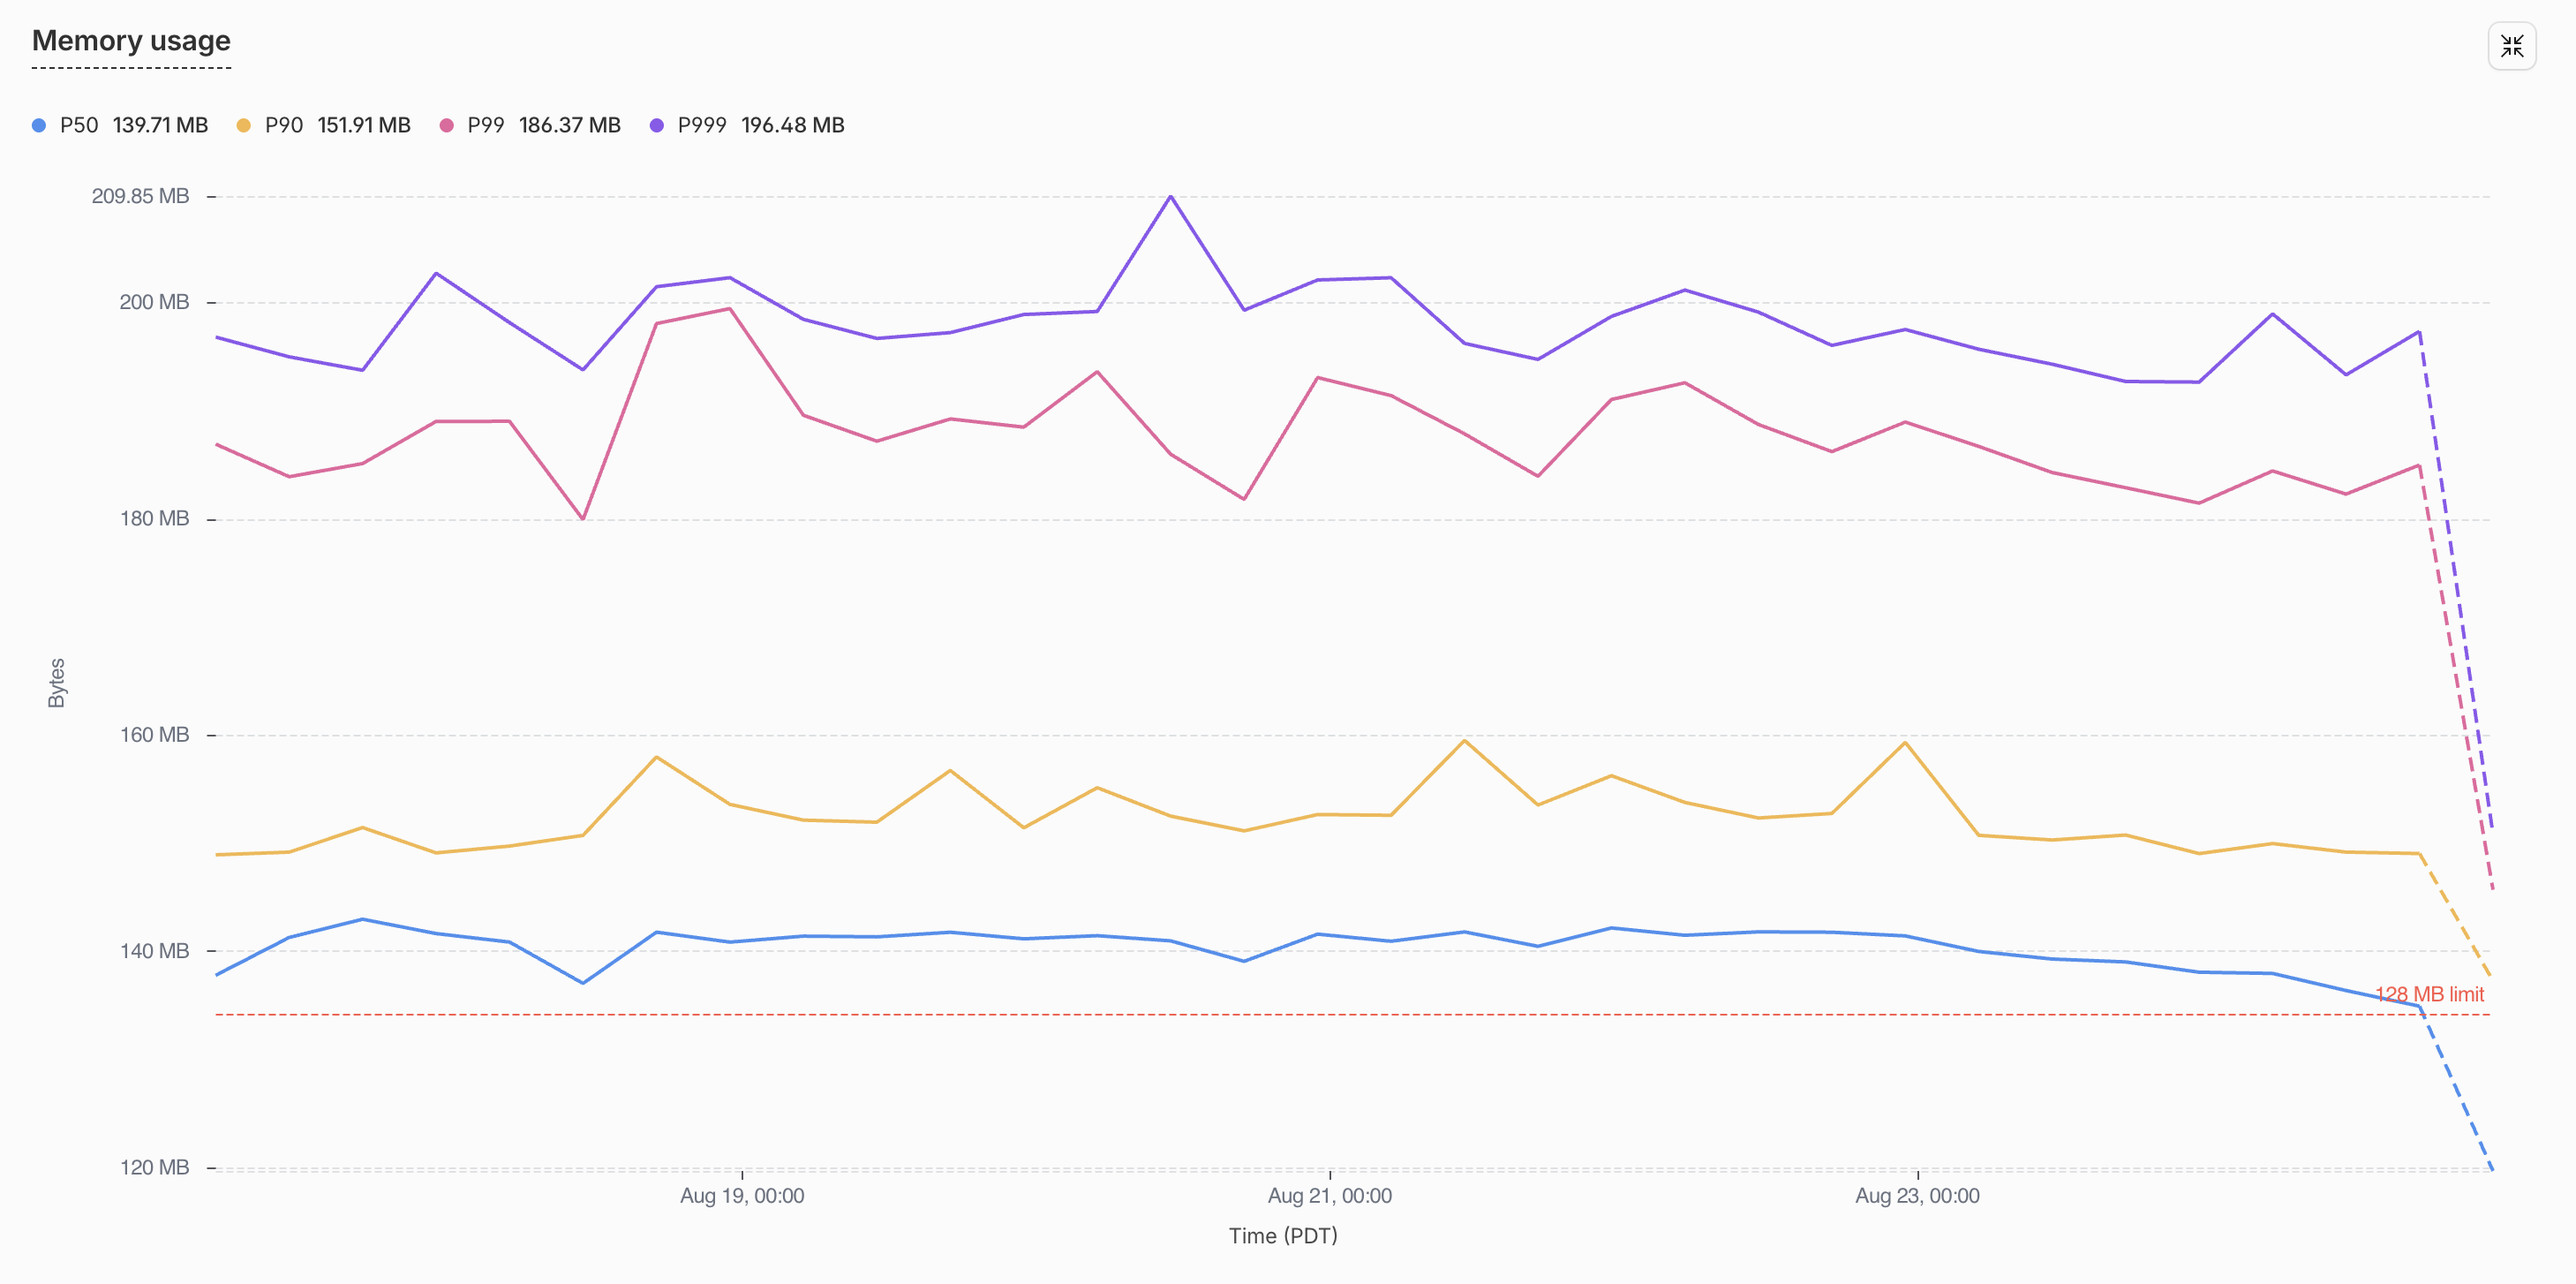
Das mittlere Isolate, die blaue Linie in Abbildung 1, lag die ganze Woche bei etwa 140 MB, und das 99. Perzentil lag nahe 190 MB. Beide Linien liegen über dem gestrichelten 128-MB-Limit, was heißt, dass das typische Isolate im Namespace bereits jenseits des Punkts war, ab dem Cloudflare es zurücksetzen darf, und nur verschont blieb, bis die nächste Allokation es kippte. Was der Graph nicht zeigte, war irgendein Zusammenhang mit dem Traffic. Die Linie war in den ruhigen Stunden so flach wie in den vollen, und keiner der rund 300 Resets am Tag kam mit einem Stack Trace, weil es nie unser Code war, der geworfen hat.
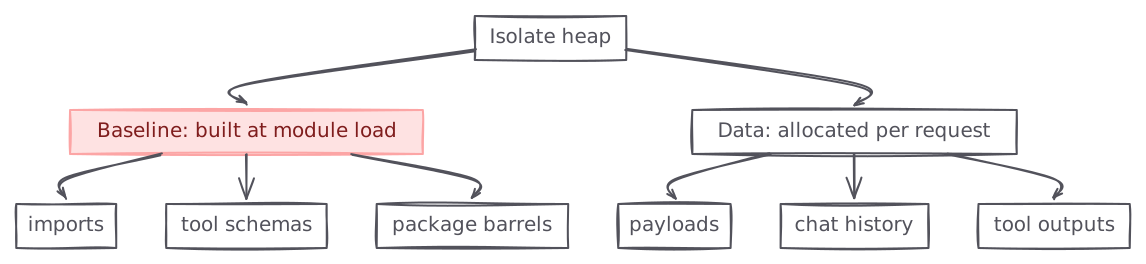
Wir haben dort gesucht, wo man zuerst suchen würde. Wir haben die Payload-Größen gelesen, geprüft, wie die Chat-Historie gekürzt wurde, und die Speicherkurve nach einem Request-Muster durchsucht, und nichts gefunden, was die Linie bewegt hätte. Diese Flachheit stellte sich als der wichtige Hinweis heraus. Der Speicher eines Isolates ist eines von zwei Dingen: Er ist Daten, also Request-Payloads, Chat-Historie, Tool-Ausgaben und alles andere, was beim Bedienen von Traffic alloziert wird, oder er ist Baseline, also die Objekte, die der Code selbst erzeugt, wenn ein Modul lädt, und für die Lebensdauer des Isolates am Leben hält, etwa Imports, Funktionen und Schemas. Daten steigen und fallen mit den Requests, während die Baseline vor dem ersten Request da ist und nie verschwindet, also beschreibt ein Graph, der im Leerlauf hoch und flach ist, die Baseline. Das Problem musste in dem stecken, was wir auslieferten, nicht in dem, was wir bedienten.
Warum Baseline-Speicher so leicht zu übersehen ist
Baseline-Speicher versteckt sich an zwei Orten, an denen du normalerweise nicht hinschaust.
Der erste ist der Bundler. Wir nehmen an, dass Tree Shaking den Code entfernt, den wir nicht benutzen, und meistens tut es das, aber esbuild hat Regeln dafür, wann es beschneiden darf, und das sind nicht die Regeln, die du vermuten würdest. Ein Paket ohne "sideEffects": false in seiner package.json wird überhaupt nie beschnitten. Ein export * in einem lazy ausgewerteten Modul wird ebenfalls nie beschnitten. Ein dynamisches import() einer Paketwurzel markiert jeden Export als benutzt. Wir kommen bei den Fixes auf jeden dieser Punkte zurück, denn sie erklären die Hälfte der 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Der zweite ist die Schema-Bibliothek. Typen fühlen sich kostenlos an, weil sie zur Compile-Zeit verschwinden, aber ein zod-Schema ist kein Typ, es ist ein Baum aus Closures, gebaut in dem Moment, in dem sein Modul ausgewertet wird. Ein mittelgroßes zod-4-Objektschema, ein Dutzend Felder mit Beschreibungen und Refinements, kostet ~134 KB Heap. Ein nacktes z.string() kostet ~12 KB. Das entsprechende einfache JSON-Schema-Objekt kostet ein paar hundert Bytes. Nichts davon steht in der README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Wir hatten nichts Exotisches getan
Jedes einzelne unserer Probleme kam von einem Default. Jedes Agenten-Tool deklarierte seine Eingabe mit z.object() auf Modulebene, weil die Docs es so machen. Jedes interne Paket hatte eine Barrel-index.ts mit export * from "./zod", weil das ordentlich ist. Ein paar Pfade benutzten await import("@scope/package"), weil Lazy Loading angeblich günstiger ist. Jeder Punkt für sich ist eine vernünftige Entscheidung. Zusammen waren sie 130 MB, in einem Isolate mit 128 zum Ausgeben.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Was es uns gekostet hat
Unser Agent hat über 250 Tools, die er über Code Mode und dynamische Worker benutzt. Allein ihre zod-Definitionen kosteten 78 MB Heap beim Laden der Module, mehr als die Hälfte des Budgets des Isolates, ausgegeben für Beschreibungen von Argumenten, bevor eines davon aufgerufen wurde. Jedes Tool, das wir hinzufügten, kostete weitere ~134 KB, ob dieses Tool je lief oder nicht.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Die Resets waren auch nicht kostenlos. Jedes exceededMemory wirft einen laufenden Agenten-Zug weg: ein Retry, ein zweiter Modellaufruf, ein Nutzer, der auf einen Spinner starrt. Bei ~300 am Tag ist das kein Incident mehr, sondern eine Dauersteuer, und wegen der Co-Location zahlte sie, welches Objekt auch immer gerade im Isolate war.
Error: Durable Object's isolate exceeded its memory limit and was reset.Wie wir es gefunden haben: ein Heap-Profiler für das Produktions-Bundle
Wir konnten die Produktion nicht profilieren, also haben wir einen kleinen Profiler gebaut, der lokal auf genau dem Bundle läuft, das die Produktion ausführt. Er misst die V8-Heap-Kosten der Auswertung jedes Moduls und gibt eine sortierte Tabelle aus. Wir haben ihn in einer Schleife laufen lassen: profilieren, die Spitze der Rangliste entfernen, erneut profilieren. Die letzte Prüfung für jeden Fix war ein Produktions-Deploy, verglichen mit Cloudflares Speichermetriken beiderseits des Deploy-Markers.
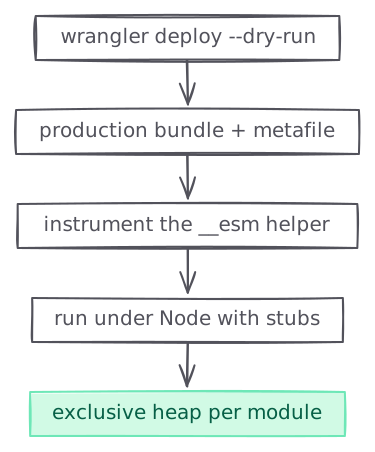
Drei Ideen machen es möglich:
- Dasselbe Bundle.
wrangler deploy --dry-run --outdir --metafilegibt genau das esbuild-Bundle aus, das ein Deploy hochladen würde, plus seinen Modulgraphen. Alles wird auf diesem Bundle gemessen. - Zuordnung pro Modul. esbuild hüllt lazy ausgewertete Module in
__esm(...)-Initialisierungs-Closures. Wir schreiben genau diesen einen Helper im gebauten Bundle um, sodass jede Modul-Initialisierung vor und nach sich selbstv8.getHeapStatistics().used_heap_sizeaufzeichnet, mit einem Init-Stack, der die eigenen Kosten eines Moduls (exklusiv) von denen seiner Abhängigkeiten (inklusiv) trennt. Das Ergebnis ist ein Datensatz in Flamegraph-Form. - Kontrollierte Läufe. Das instrumentierte Bundle läuft unter normalem Node mit einem Loader-Shim, der
cloudflare:*-Imports zu Stubs auflöst.
Das vollständige Rezept, bereit zum Einfügen in einen Coding-Agenten, steht am Ende dieses Beitrags. Die oben genannten zod-Einzelkosten stammen aus einem Mikro-Benchmark, der durch dasselbe Harness lief.
Was das erste Profil zeigte
| Quelle | Exklusiver Heap |
|---|---|
packages/tools (250+ Agenten-Tool-Definitionen, zod) | 78,0 MB |
| Paket-Barrels, die zod-Schema-Module re-exportieren (Zeilen darunter) | ~66 MB |
durable-workspaces (Workspace-Zustand und Zeitpläne) | 15,6 MB |
thread-core (Thread-Datenschicht) | 10,1 MB |
durable-automations (Automations-Definitionen) | 9,6 MB |
durable-threads (Thread-Liste und Live-Updates) | 7,3 MB |
durable-automation (ein Automations-Run) | 6,8 MB |
db (D1-Client und Modelle) | 6,3 MB |
durable-skills (Skill-Definitionen) | 5,7 MB |
durable-autofixes (Autofix-Branches und -Merges) | 4,9 MB |
| 12 kleinere Pakete | ~9 MB |
Die zweite Zeile ist die überraschende. Das sind Schemas, die das Bundle nur über export * from "./zod" in Paket-Barrels erreichen. Unser Code hat sie nie benutzt, der Tree Shaker konnte sie nicht entfernen, und sie kosteten ein Drittel des Speicherlimits, alles in Modulen, die nie etwas aufgerufen hat.
Fix A: Tool-Definitionen als Daten, nicht als Code
Jede Tool-Definition deklarierte ihr Eingabeschema in zod und wandelte es zur Laufzeit in JSON Schema um, weil JSON Schema ohnehin das ist, was ans Modell geschickt wird. Wir bauten ~134 KB Closures pro Tool, um ein paar hundert Bytes Daten zu erzeugen, also haben wir die Daten direkt geschrieben.
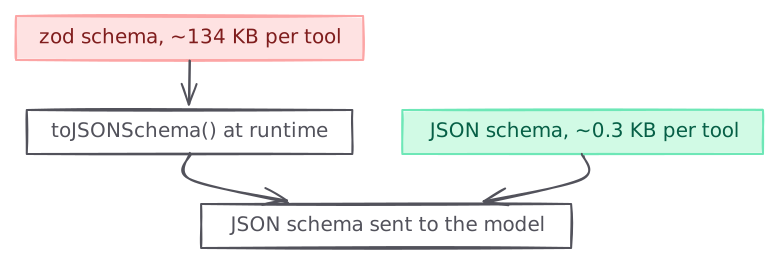
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters ist ein dünner Wrapper um jsonSchema() aus dem AI SDK. ParametersInput ist json-schema-to-ts, das die Typinferenz übernimmt, die früher zod gemacht hat. Die Laufzeitvalidierung ist in einen ~300-zeiligen Validator gewandert, der die Eigenschaften nachbildet, auf die der Agenten-Loop angewiesen ist: unbekannte Schlüssel entfernt, Defaults gefüllt, Unions per Diskriminator aufgelöst und Fehlermeldungen so formuliert, dass das Modell seinen eigenen Tool-Aufruf beim Retry reparieren kann.
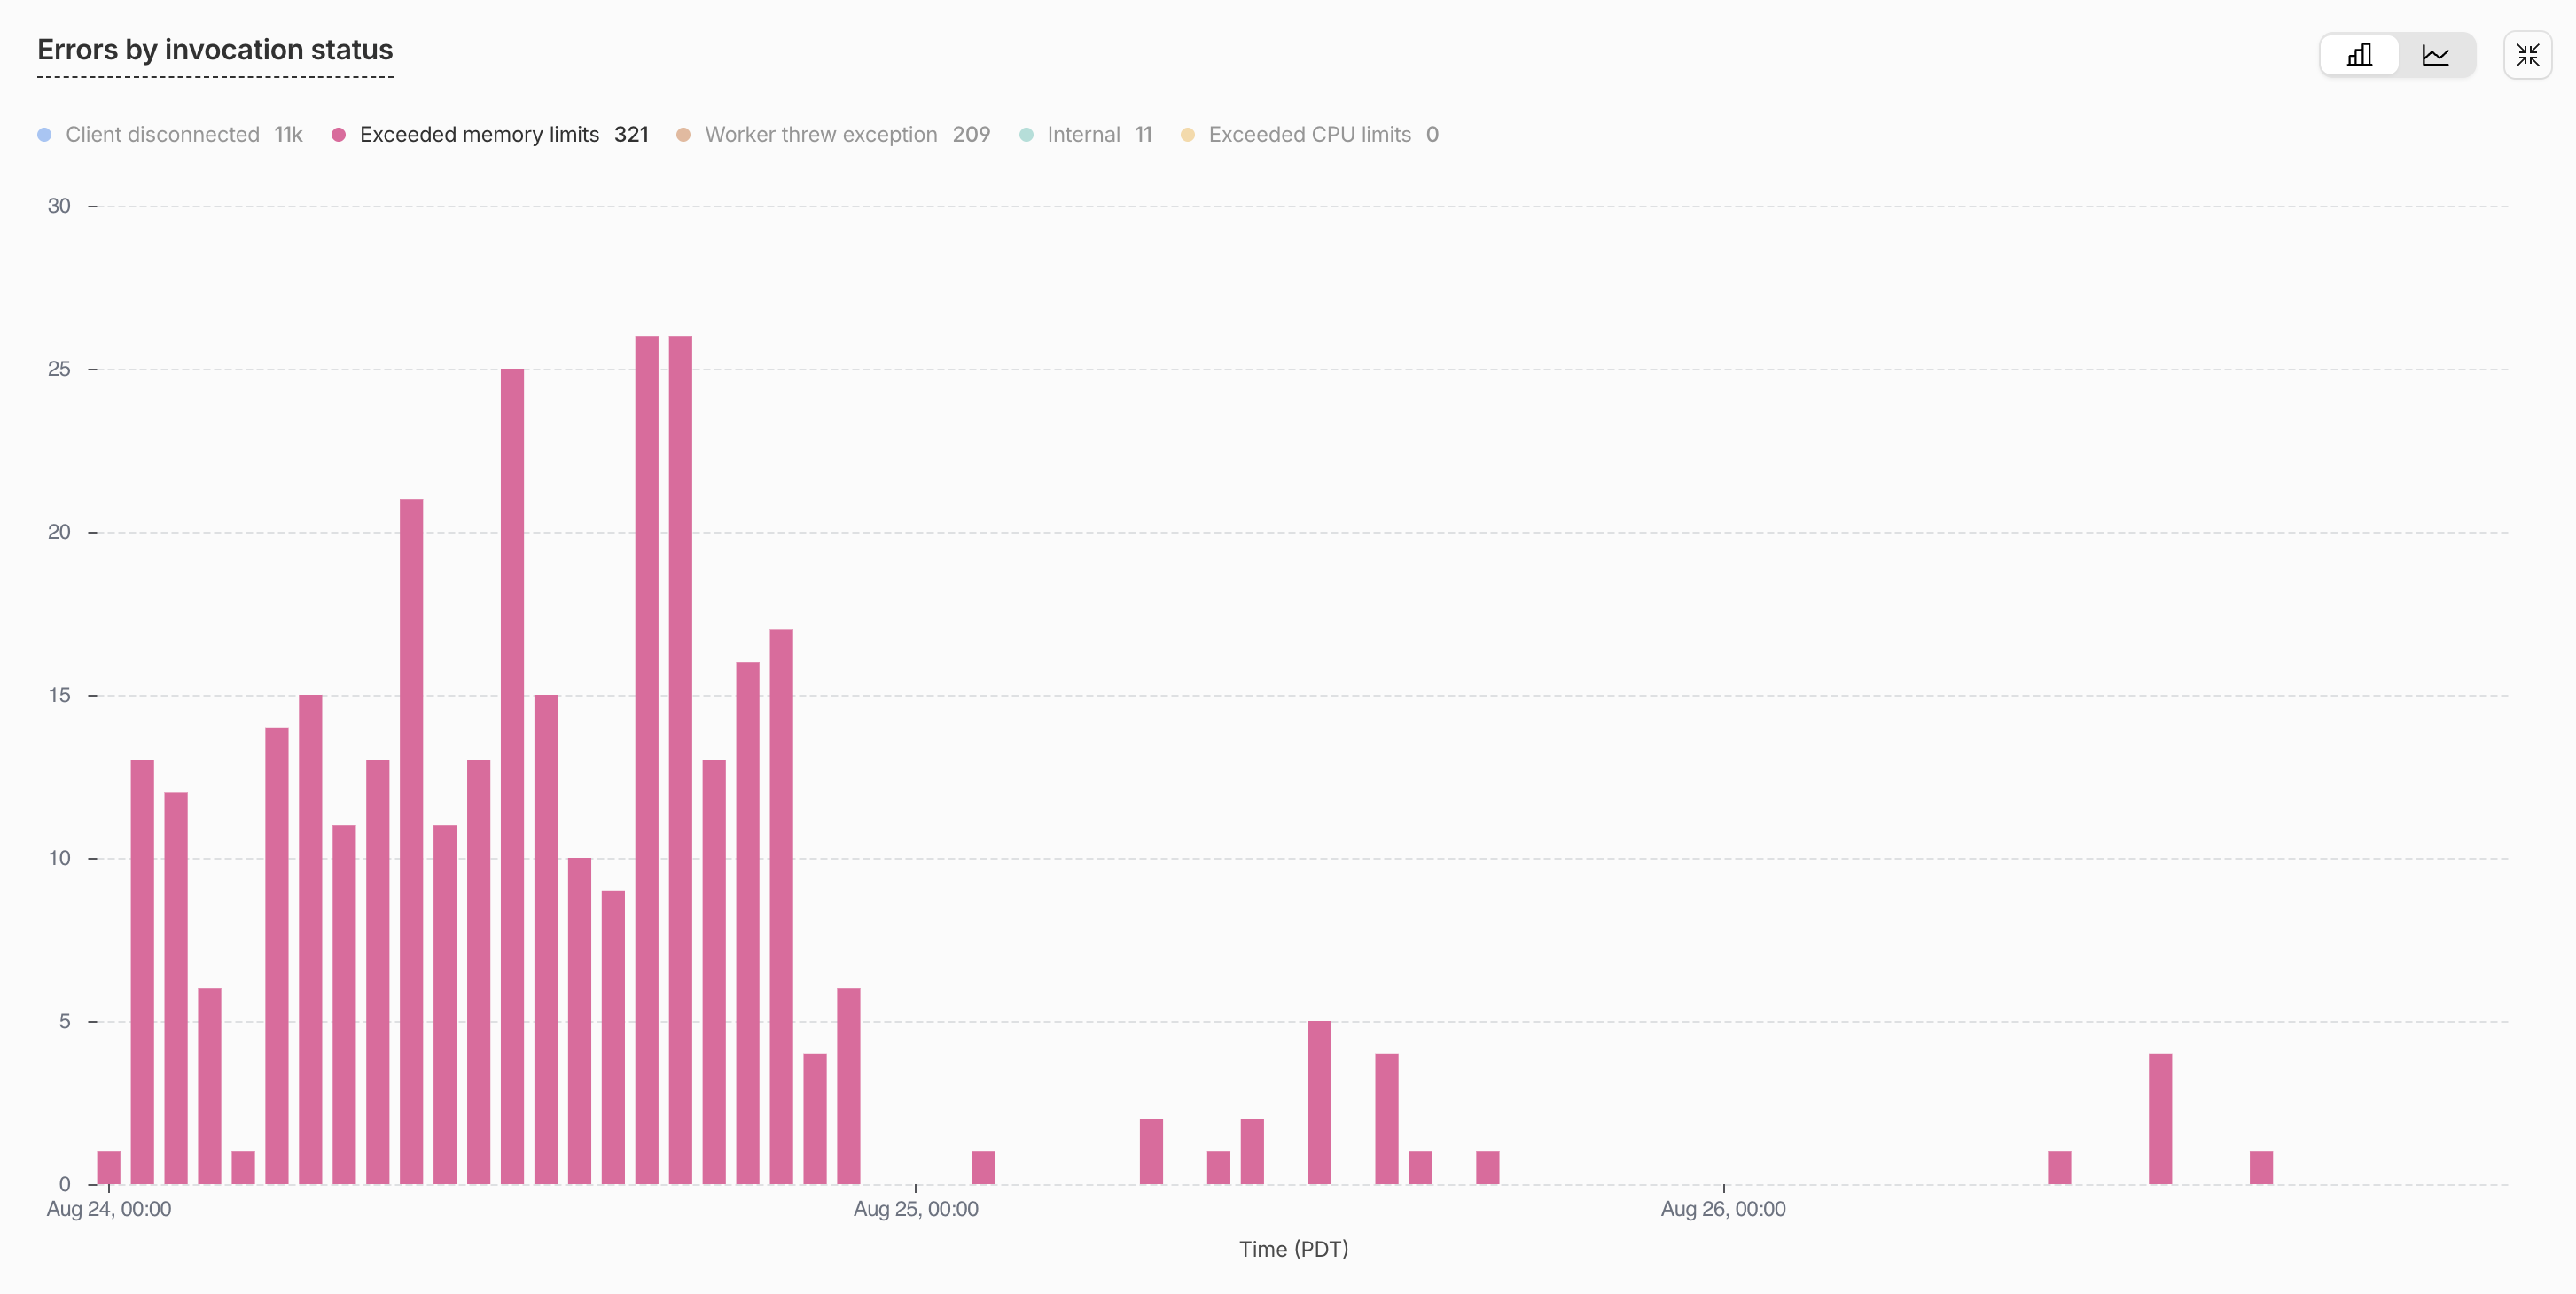
Der Heap nach der Modulauswertung ging lokal von 218,6 auf 154,0 MB, und packages/tools von 78 MB auf 0,7 MB. In der Produktion fielen die Resets am Deploy-Marker von 40-110 pro Stunde auf 0-6 pro Stunde, und der Speicher des mittleren Isolates von ~140 MB auf ~120 MB.
Fix B: Barrels, die sich tatsächlich tree-shaken lassen
Die verbleibenden ~66 MB waren Schemas, die das Isolate nie benutzt hat. Drei Bundler-Verhalten erklären das:
- Ohne
"sideEffects": falsein derpackage.jsoneines Pakets beschneidet esbuild nichts darin. - Selbst mit dem Flag wird
export * from "./zod"in einem lazy ausgewerteten Modul nie beschnitten, und alles, was über ein dynamischesimport()erreichbar ist, wird lazy ausgewertet. Benannte Re-Exports (export { zFoo } from "./zod") werden problemlos beschnitten. await import("@scope/package")materialisiert das gesamte Namespace-Objekt des Pakets und markiert jeden Export als benutzt: Schemas, Klassen, alles.
Wir haben jeden dieser Punkte mit einem Fünf-Dateien-Fixture bestätigt, gebaut mit der esbuild-Version, die wrangler einbettet: ein Entry, ein Paket mit einer index.ts-Barrel, eine zod.ts mit einem Schema, dessen Konstruktor meldet, wenn er läuft, eine do.ts-Klasse, die dieses Schema importiert, und ein lazy Zwischenmodul dazwischen. Die Tabelle hält für jede Kombination fest, ob der Konstruktor des Schemas bei der Auswertung lief.
| Entry importiert Barrel über | Re-Export-Form der Barrel | sideEffects: false | Schema enthalten |
|---|---|---|---|
| Statischer Import | export * | Ja | Nein |
| Statischer Import | export * | Nein | Ja |
Dynamisches import() des Pakets | Beliebig | Ja | Ja |
| Statischer Import aus einem lazy geladenen Modul | export * | Ja | Ja |
| Statischer Import aus einem lazy geladenen Modul | Benannte Liste | Ja | Nein |
| Beliebig | Benannte Liste | Nein | Ja |
Zeilen 3 und 4 sind die beiden, die überraschen, und zusammen machten sie die ~66 MB aus. Hier ist, was eine Barrel mit uns gemacht hat:
Der Fix ist mechanisch: "sideEffects": false in allen 110+ Workspace-Paketen, die export * der Barrels zu benannten Re-Export-Listen umschreiben und await import("@scope/package") von Paketwurzeln durch statische benannte Imports ersetzen.
Eine Ablation auf dem echten Produktions-Bundle zeigt, dass jeder Teil nötig ist.
| Konfiguration | Heap nach Modulauswertung | Schema-Module im Bundle |
|---|---|---|
| Baseline (nach Fix A) | 154,0 MB | 77 |
sideEffects: false allein | 143,6 MB | 77 |
+ Statische Imports, Barrels zurück auf export * (Kontrolle) | 98,6 MB | 29 |
| + Benannte Re-Export-Listen (vollständiger Fix) | 82,1 MB | 0 |
Die Kontrollzeile ist die interessante: Selbst ein vollständig statischer Import-Graph behält 29 Schema-Module, die benannten Listen sind also nicht optional.
Der Endzustand
| Heap auf Modulebene (lokale Sonde) | Mittlerer Speicher in Produktion | Resets in Produktion | |
|---|---|---|---|
| Vorher | 218,6 MB | ~140 MB | ~300/Tag |
| Nach A | 154,0 MB | ~120 MB | ~10/Tag |
| Nach A+B | 82,1 MB | ~70 MB | 0 |
Ein Durable Object, das im Leerlauf über dem Speicherlimit der Plattform lag, liegt jetzt im Leerlauf bei kaum der Hälfte davon, und die ~300 täglichen Resets sind weg.
Das ist kein Konfigurations-Flag
Mehr als 250 Tool-Definitionen von zod auf rohes JSON Schema umzuschreiben und einen 300-zeiligen Validator zu schreiben, der ersetzt, was zod für uns getan hat, hat ein paar Tage gedauert, selbst mit Coding-Agenten. sideEffects: false zu über 100 Paketen hinzuzufügen und jedes export * in eine generierte benannte Liste zu verwandeln ist unglamouröse Arbeit, und danach typecheckst du das ganze Repo und behebst, was bricht. Die einfache Alternative ist, einen Retry hinzuzufügen und mit den Resets zu leben, und viele Teams tun das. Wenn dein Durable Object im Leerlauf auch nur in der Nähe des Limits ist, würde ich sagen, die Woche ist es wert, denn das Limit bewegt sich nicht, und deine Tool-Zahl geht nur nach oben.
Die drei Dinge, die ich von Tag eins an gerne gewusst hätte:
- Hoch und flach im Leerlauf heißt Baseline. Profiliere, was du auslieferst, nicht, was du bedienst.
- Tree Shaking hat Regeln.
sideEffects: false, benannte Re-Exports, statische Imports. Verpass eine, und das ganze Paket fährt mit. - Schemas sind Code, keine Typen. Wenn der Konsument JSON Schema will, schreib JSON Schema.
Mach das heute, um den Speicher deines Durable Objects in Ordnung zu bringen
Der Profiler ist ~100 Zeilen ohne Abhängigkeiten außer Node und wrangler. Füg das Rezept unten in deinen Coding-Agenten im Wurzelverzeichnis eines beliebigen Repos ein, das mit wrangler deployt, lies die obersten zehn Zeilen der Tabelle, die er ausgibt, und sieh nach, was da ist. Dann arbeite die Liste ab: einfaches JSON Schema für alles, was das Modell ohnehin als JSON Schema bekommt, "sideEffects": false und benannte Re-Exports für die Barrels, statische Imports für die Paketwurzeln.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Wenn du das ganze Audit erledigt haben willst, hier ist ein Skill für deinen Coding-Agenten:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Wir haben diesen Skill auch Polylane selbst hinzugefügt, sodass jeder Polylane-Nutzer diese tiefe Untersuchung des Speichers seiner Durable Objects von Haus aus bekommt, ohne etwas einfügen zu müssen.