

Jak naprawiliśmy błędy przekroczenia pamięci w Cloudflare Durable Objects
Explore with AI
Każdy wątek agenta w Polylane działa we własnym Cloudflare Durable Object, a wszystkie są instancjami jednej klasy. W sierpniu 2026 Durable Objects naszych wątków były resetowane około 300 razy dziennie za przekroczenie limitu pamięci. Tę samą historię słyszeliśmy od wielu zespołów uruchamiających swoje przepływy agentowe na Cloudflare Durable Objects.
Jeśli trafisz na exceededMemory w Durable Object, standardowa rada brzmi: sprawdź, co alokują twoje żądania: zbyt duży payload, historia czatu rosnąca bez ograniczeń, cache, który nigdy nie usuwa wpisów. Nic z tego nas nie dotyczyło. Izolat był ponad limitem, zanim obsłużył pierwsze żądanie, więc ciężar musiał siedzieć w kodzie, który wysyłaliśmy, a nie w danych, które serwowaliśmy.
Ten wpis jest o tym, co naprawdę było w heapie, jak to znaleźliśmy na platformie, która nie pozwala podłączyć profilera, i o dwóch zmianach, które zbiły pamięć zakresu modułów z 218 MB do 82 MB, a resety do zera.
Cloudflare Durable Objects w minutę
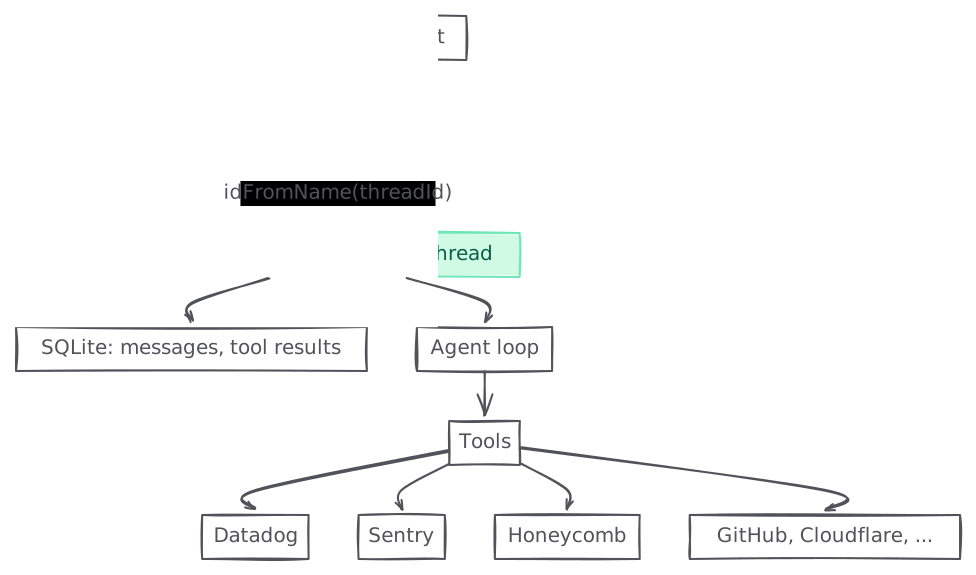
Jeśli ich nie używano: Durable Object to mały, stanowy, jednowątkowy serwer, o którym Cloudflare gwarantuje, że jest unikalny dla danego ID. Wywołaj idFromName() z tym ID z Workera, a każde żądanie do niego, z dowolnego miejsca na świecie, trafi na tę samą instancję, z własną bazą SQLite, stanem w pamięci i alarmami. Hibernuje, gdy jest bezczynny, i budzi się tam, gdzie skończył.
W Polylane tworzymy instancję Durable Object dla każdego wątku. Każda rozmowa z agentem, niezależnie od tego, czy zaczął ją człowiek, czy alert, dostaje własny Durable Object. SQLite obiektu trzyma wiadomości wątku i wyniki narzędzi, pętla agenta działa w jego środku, a jego narzędzia wywołują dostawców, których wątek potrzebuje: Datadog, Sentry, Honeycomb, GitHub, Cloudflare i resztę. Gdy wątek cichnie, obiekt hibernuje, a gdy przychodzi następna wiadomość, podejmuje pracę dokładnie tam, gdzie się zatrzymał.
Jak działa pamięć w Durable Objects
- Izolaty i limit 128 MB. Durable Objects działają w izolatach V8, a izolat ma twardy limit pamięci 128 MB, taki sam w każdym planie i niekonfigurowalny.
- Współlokacja. Jeden izolat hostuje wiele Durable Objects tej samej klasy, razem z otaczającym je kodem Workera, i wszystkie dzielą pamięć tego izolatu. Limit dotyczy izolatu, nie obiektu.
- Hałaśliwi sąsiedzi. Ze względu na współlokację obiekt, który zostaje zresetowany, gdy izolatowi kończy się pamięć, często nie jest tym, który tę pamięć zużył. Każda próbka pamięci raportowana przez Cloudflare dotyczy całego izolatu, tak samo jak każdy reset.
Nie ma sposobu, żeby podłączyć profiler pamięci do produkcyjnego Durable Object: narzędzia do migawek heapu, które dokumentuje Cloudflare, działają na lokalnej sesji deweloperskiej. W Kubernetes włącza się profilowanie i podłącza, aż problem zostanie znaleziony. W workerd process.memoryUsage() to polyfill unenv zwracający zera, a bazowe wartości pamięci i CPU nie są widoczne dla kodu działającego w środku. Dostajesz GraphQL analytics API Cloudflare: percentyle pamięci i liczbę awarii per namespace, po fakcie.
Co powiedział nam wykres pamięci
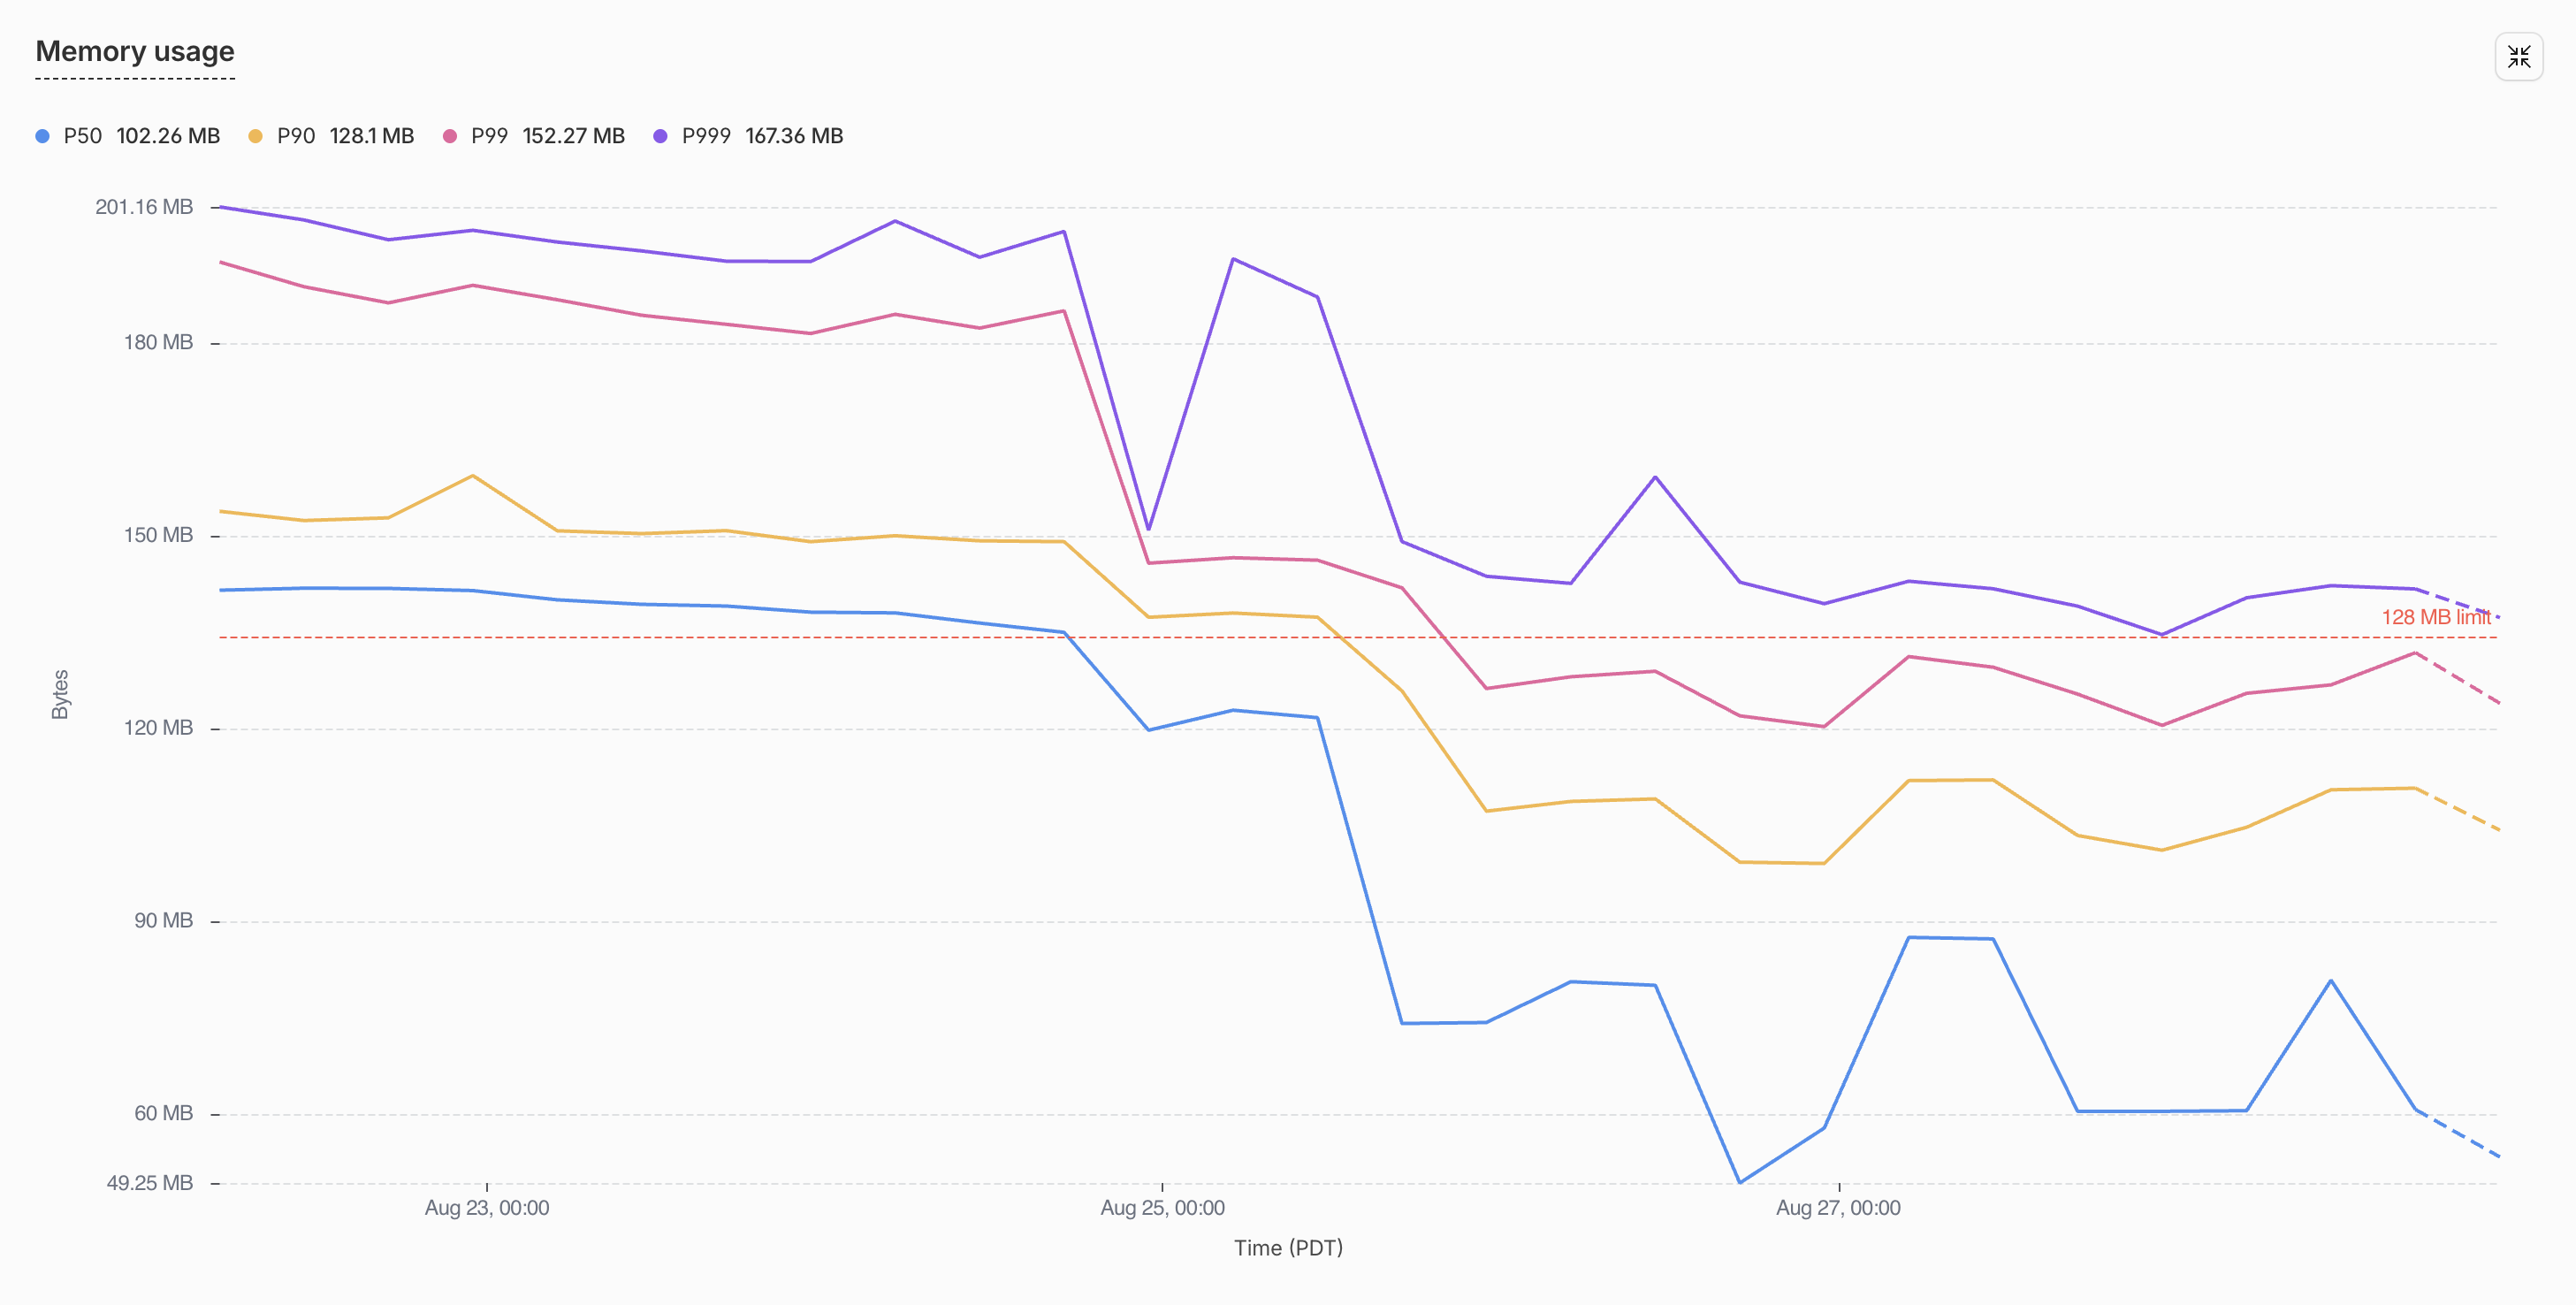
Analytics API Cloudflare raportuje pamięć namespace Durable Object jako percentyle po izolatach, które go uruchamiają, w piętnastominutowych kubełkach, obok liczby błędów przekroczenia pamięci w każdym kubełku. Każdy wykres w tym wpisie pochodzi z tego API, przefiltrowany do namespace wątków i porównany między markerami wdrożeń, gdy zaczęliśmy wysyłać poprawki.
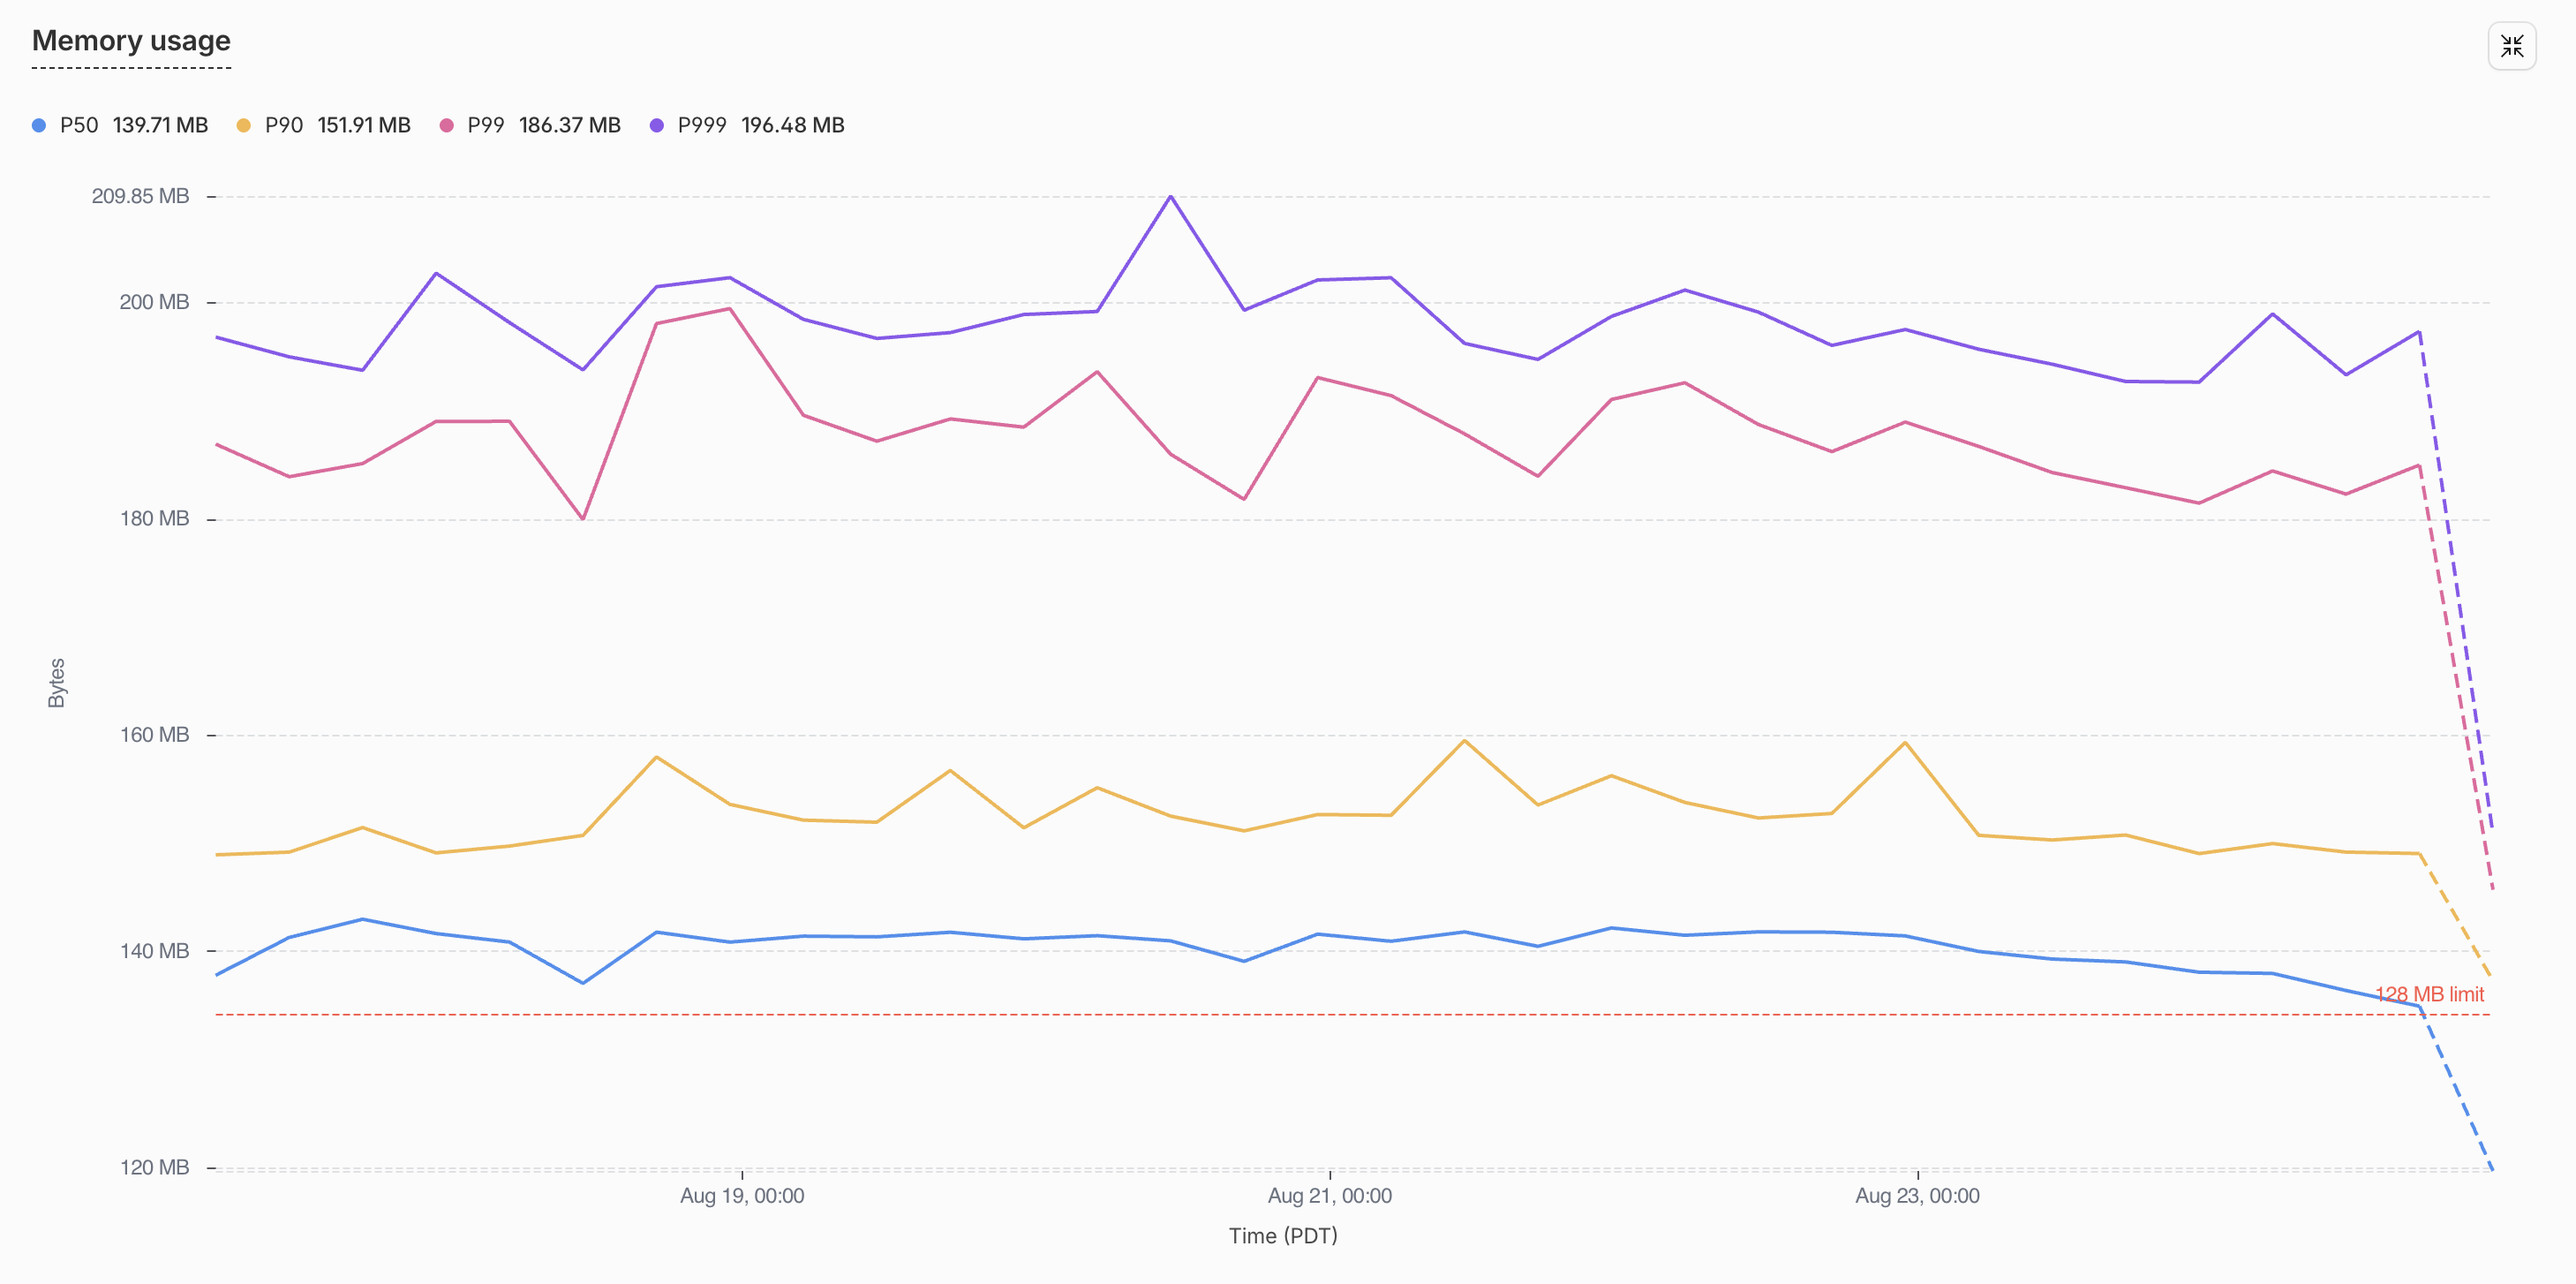
Mediana izolatu, niebieska linia na rysunku 1, siedziała na około 140 MB przez cały tydzień, a 99. percentyl w okolicy 190 MB. Obie linie są powyżej przerywanej linii limitu 128 MB, co oznacza, że typowy izolat w namespace był już za punktem, w którym Cloudflare ma prawo go zresetować, i był oszczędzany tylko do następnej alokacji, która przechyliła szalę. Czego wykres nie pokazał, to jakiegokolwiek związku z ruchem. Linia była równie płaska w cichych godzinach jak w ruchliwych, a żaden z około 300 resetów dziennie nie przyszedł ze stack trace, bo to nigdy nie nasz kod rzucał błąd.
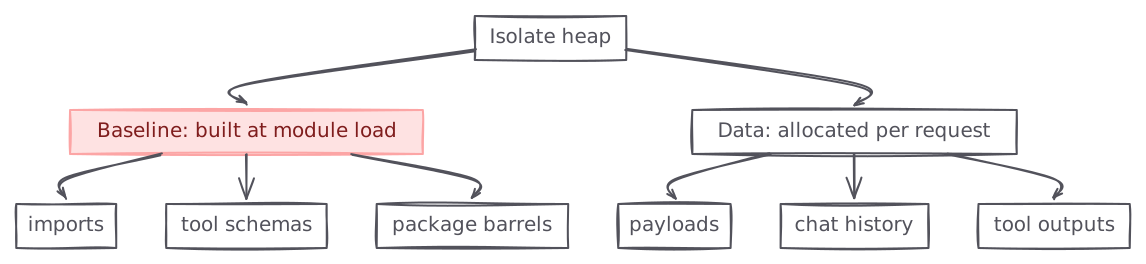
Patrzyliśmy tam, gdzie należałoby patrzeć najpierw. Czytaliśmy rozmiary payloadów, sprawdzaliśmy, jak przycinana jest historia czatu, i szukaliśmy w krzywej pamięci wzorca żądań, i nie znaleźliśmy nic, co ruszałoby linię. Ta płaskość okazała się kluczową wskazówką. Pamięć izolatu to jedna z dwóch rzeczy: albo dane, czyli payloady żądań, historia czatu, wyniki narzędzi i wszystko inne alokowane przy obsłudze ruchu, albo baseline, czyli obiekty, które sam kod tworzy przy ładowaniu modułu i utrzymuje przy życiu przez cały czas życia izolatu, takie jak importy, funkcje i schematy. Dane rosną i opadają z żądaniami, a baseline jest tam przed pierwszym żądaniem i nigdy nie znika, więc wykres wysoki i płaski w bezczynności opisuje baseline. Problem musiał siedzieć w tym, co wysyłaliśmy, a nie w tym, co serwowaliśmy.
Dlaczego pamięć baseline tak łatwo przegapić
Pamięć baseline kryje się w dwóch miejscach, w które zwykle się nie patrzy.
Pierwsze to bundler. Zakładamy, że tree shaking usuwa kod, którego nie używamy, i w większości tak jest, ale esbuild ma reguły, kiedy może przycinać, i nie są to reguły, które by się zgadywało. Pakiet bez "sideEffects": false w swoim package.json nigdy nie jest przycinany. export * wewnątrz modułu ewaluowanego leniwie też nigdy nie jest przycinany. Dynamiczny import() korzenia pakietu oznacza każdy eksport jako używany. Wrócimy do każdego z nich w poprawkach, bo tłumaczą połowę ze 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Drugie to biblioteka schematów. Typy wydają się darmowe, bo znikają w czasie kompilacji, ale schemat zod nie jest typem, to drzewo domknięć budowane w chwili ewaluacji modułu. Jeden średniej wielkości schemat obiektu zod 4, kilkanaście pól z opisami i refinementami, kosztuje ~134 KB heapu. Goły z.string() kosztuje ~12 KB. Odpowiadający mu zwykły obiekt JSON schema kosztuje kilkaset bajtów. Nic z tego nie ma w README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Nie zrobiliśmy nic egzotycznego
Każdy z naszych problemów wynikał z domyślnego wyboru. Każde narzędzie agenta deklarowało swoje wejście przez z.object() w zakresie modułu, bo tak robi dokumentacja. Każdy wewnętrzny pakiet miał barrel index.ts z export * from "./zod", bo to schludne. Kilka ścieżek używało await import("@scope/package"), bo leniwe ładowanie ma być tańsze. Każdy z tych wyborów jest sam w sobie rozsądny. Razem dawały 130 MB, w izolacie, który ma do wydania 128.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Ile nas to kosztowało
Nasz agent ma ponad 250 narzędzi, których używa przez code mode i dynamiczne workery. Same ich definicje zod kosztowały 78 MB heapu przy ładowaniu modułów, ponad połowę budżetu izolatu, wydane na opisy argumentów, zanim którekolwiek z nich zostało wywołane. Każde dodane narzędzie kosztowało kolejne ~134 KB, niezależnie od tego, czy kiedykolwiek się uruchomiło.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Resety też nie były darmowe. Każde exceededMemory wyrzuca trwającą turę agenta: ponowienie, drugie wywołanie modelu, użytkownik patrzący na spinner. Przy ~300 dziennie przestaje to być incydentem i staje się stałym podatkiem, a przez współlokację płacił go ten obiekt, który akurat był w izolacie w danym momencie.
Error: Durable Object's isolate exceeded its memory limit and was reset.Jak to znaleźliśmy: profiler heapu dla produkcyjnego bundle
Nie mogliśmy profilować produkcji, więc zbudowaliśmy mały profiler, który działa lokalnie na dokładnie tym bundle, który uruchamia produkcja. Mierzy koszt heapu V8 ewaluacji każdego modułu i wypisuje uszeregowaną tabelę. Uruchamialiśmy go w pętli: profil, usunięcie szczytu rankingu, profil ponownie. Ostatecznym sprawdzeniem każdej poprawki było produkcyjne wdrożenie porównane z metrykami pamięci Cloudflare po obu stronach markera wdrożenia.
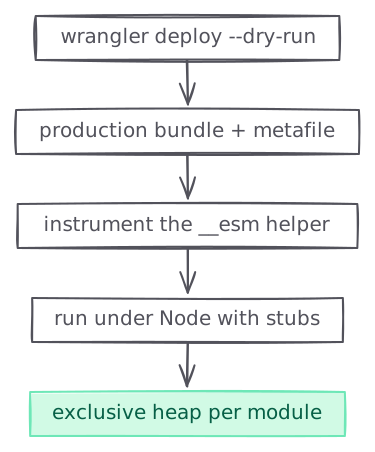
Działa dzięki trzem pomysłom:
- Ten sam bundle.
wrangler deploy --dry-run --outdir --metafileemituje dokładnie ten bundle esbuild, który wysłałoby wdrożenie, plus jego graf modułów. Wszystko jest mierzone na tym bundle. - Przypisanie do modułów. esbuild opakowuje leniwie ewaluowane moduły w domknięcia inicjalizujące
__esm(...). Przepisujemy ten jeden helper w zbudowanym bundle, żeby inicjalizacja każdego modułu zapisywałav8.getHeapStatistics().used_heap_sizeprzed sobą i po sobie, ze stosem inicjalizacji oddzielającym własny koszt modułu (wyłączny) od kosztu jego zależności (łączny). Wynik to zbiór danych w kształcie flamegraphu. - Kontrolowane uruchomienia. Zinstrumentowany bundle działa pod zwykłym Node z shimem loadera, który rozwiązuje importy
cloudflare:*na stuby.
Kompletny przepis, gotowy do wklejenia do agenta kodującego, jest na końcu tego wpisu. Jednostkowe koszty zod cytowane powyżej pochodzą z mikrobenchmarku przepuszczonego przez ten sam harness.
Co pokazał pierwszy profil
| Źródło | Wyłączny heap |
|---|---|
packages/tools (250+ definicji narzędzi agenta, zod) | 78.0 MB |
| Barrele pakietów re-eksportujące moduły schematów zod (wiersze poniżej) | ~66 MB |
durable-workspaces (stan obszaru roboczego i harmonogramy) | 15.6 MB |
thread-core (warstwa danych wątków) | 10.1 MB |
durable-automations (definicje automatyzacji) | 9.6 MB |
durable-threads (lista wątków i aktualizacje na żywo) | 7.3 MB |
durable-automation (jeden przebieg automatyzacji) | 6.8 MB |
db (klient D1 i modele) | 6.3 MB |
durable-skills (definicje skilli) | 5.7 MB |
durable-autofixes (gałęzie i scalenia autofixów) | 4.9 MB |
| 12 mniejszych pakietów | ~9 MB |
Drugi wiersz jest tym zaskakującym. To schematy, które trafiają do bundle wyłącznie przez export * from "./zod" w barrelach pakietów. Nasz kod nigdy ich nie używał, tree shaker nie mógł ich usunąć, a kosztowały trzecią część limitu pamięci, w całości w modułach, których nic nigdy nie wywołało.
Poprawka A: definicje narzędzi jako dane, nie kod
Każda definicja narzędzia deklarowała schemat wejścia w zod i konwertowała go do JSON schema w czasie działania, bo JSON schema i tak jest tym, co dostaje model. Budowaliśmy ~134 KB domknięć per narzędzie, żeby wyprodukować kilkaset bajtów danych, więc napisaliśmy te dane bezpośrednio.
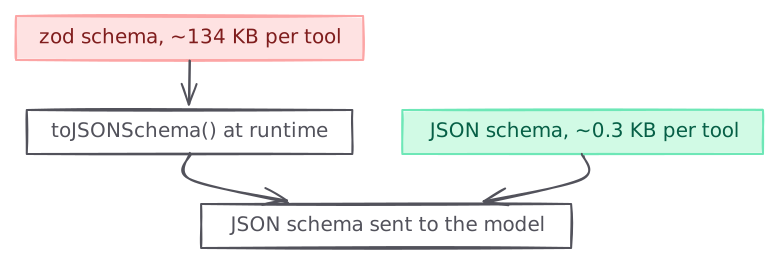
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters to cienka nakładka na jsonSchema() z AI SDK. ParametersInput to json-schema-to-ts robiące inferencję typów, którą wcześniej robił zod. Walidacja w czasie działania przeniosła się do ~300-liniowego walidatora, który odtwarza właściwości, na których polega pętla agenta: nieznane klucze usuwane, wartości domyślne wypełniane, unie rozwiązywane po dyskryminatorze, a komunikaty błędów sformułowane tak, żeby model mógł naprawić własne wywołanie narzędzia przy ponowieniu.
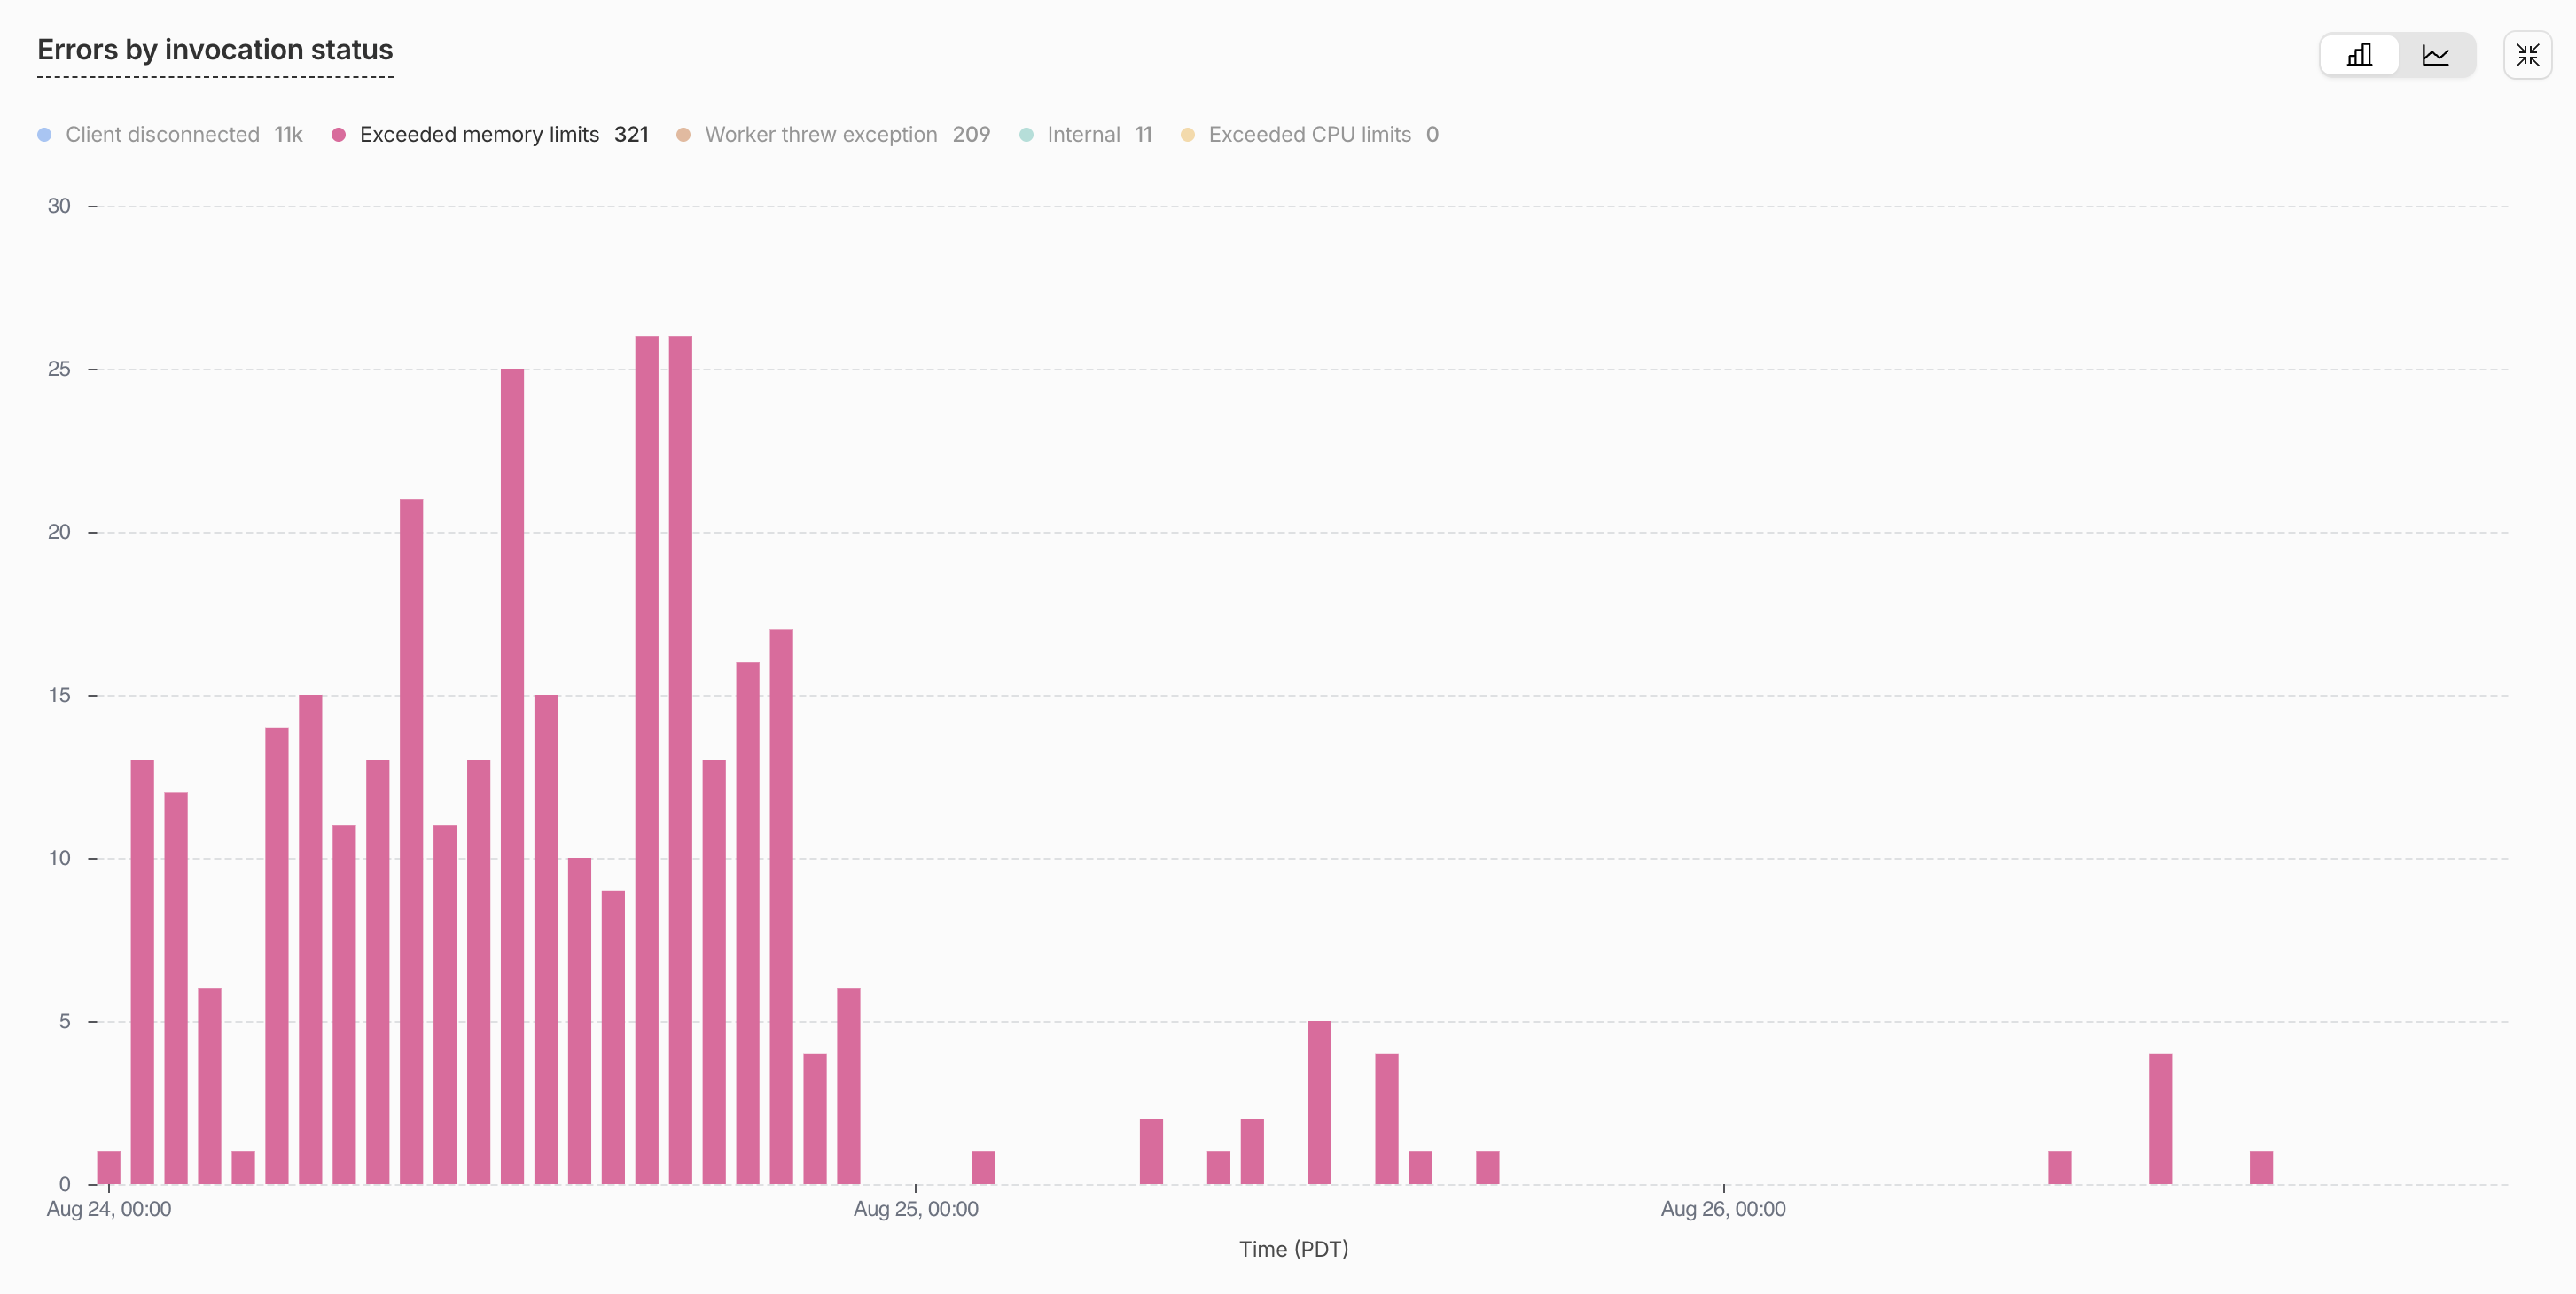
Heap po ewaluacji modułów spadł lokalnie z 218.6 do 154.0 MB, a packages/tools z 78 MB do 0.7 MB. Na produkcji resety spadły z 40-110 na godzinę do 0-6 na godzinę przy markerze wdrożenia, a mediana pamięci izolatu z ~140 MB do ~120 MB.
Poprawka B: barrele, które naprawdę da się tree-shakować
Pozostałe ~66 MB to schematy, których izolat nigdy nie używał. Tłumaczą to trzy zachowania bundlera:
- Bez
"sideEffects": falsewpackage.jsonpakietu esbuild nie przycina z niego nic. - Nawet z flagą
export * from "./zod"nigdy nie jest przycinany wewnątrz modułu ewaluowanego leniwie, a wszystko osiągalne przez dynamicznyimport()jest ewaluowane leniwie. Nazwane re-eksporty (export { zFoo } from "./zod") przycinają się bez problemu. await import("@scope/package")materializuje cały obiekt przestrzeni nazw pakietu, oznaczając każdy eksport jako używany: schematy, klasy, wszystko.
Każde z nich potwierdziliśmy pięcioplikową fixturą zbudowaną wersją esbuild, którą osadza wrangler: wejście, pakiet z barrelem index.ts, zod.ts z jednym schematem, którego konstruktor ogłasza, gdy się uruchamia, klasa do.ts importująca ten schemat i leniwy pośrednik między nimi. Tabela zapisuje, czy konstruktor schematu uruchomił się przy ewaluacji dla każdej kombinacji.
| Wejście importuje barrel przez | Kształt re-eksportu w barrelu | sideEffects: false | Schemat w bundle |
|---|---|---|---|
| Import statyczny | export * | Tak | Nie |
| Import statyczny | export * | Nie | Tak |
Dynamiczny import() pakietu | Dowolny | Tak | Tak |
| Import statyczny z leniwie ładowanego modułu | export * | Tak | Tak |
| Import statyczny z leniwie ładowanego modułu | Lista nazwana | Tak | Nie |
| Dowolny | Lista nazwana | Nie | Tak |
Wiersze 3 i 4 to te dwa, które zaskakują ludzi, i razem odpowiadały za ~66 MB. Oto, co robił nam jeden barrel:
Poprawka jest mechaniczna: "sideEffects": false we wszystkich 110+ pakietach workspace, przepisanie export * w barrelach na nazwane listy re-eksportów i zamiana await import("@scope/package") korzeni pakietów na statyczne nazwane importy.
Ablacja na prawdziwym produkcyjnym bundle pokazuje, że każdy element jest konieczny.
| Konfiguracja | Heap po ewaluacji modułów | Moduły schematów w bundle |
|---|---|---|
| Baseline (po poprawce A) | 154.0 MB | 77 |
Samo sideEffects: false | 143.6 MB | 77 |
+ Importy statyczne, barrele z powrotem na export * (kontrola) | 98.6 MB | 29 |
| + Nazwane listy re-eksportów (pełna poprawka) | 82.1 MB | 0 |
Wiersz kontrolny jest tym interesującym: nawet w pełni statyczny graf importów zachowuje 29 modułów schematów, więc nazwane listy nie są opcjonalne.
Stan końcowy
| Heap zakresu modułów (lokalna sonda) | Mediana pamięci na produkcji | Resety na produkcji | |
|---|---|---|---|
| Przed | 218.6 MB | ~140 MB | ~300/dzień |
| Po A | 154.0 MB | ~120 MB | ~10/dzień |
| Po A+B | 82.1 MB | ~70 MB | 0 |
Durable Object, który w bezczynności siedział powyżej limitu pamięci platformy, w bezczynności zajmuje teraz ledwie jego połowę, a ~300 dziennych resetów zniknęło.
To nie jest flaga w konfiguracji
Przepisanie ponad 250 definicji narzędzi z zod na surowy JSON schema i napisanie 300-liniowego walidatora zastępującego to, co robił dla nas zod, zajęło kilka dni, nawet z agentami kodującymi. Dodanie sideEffects: false do ponad 100 pakietów i zamiana każdego export * na wygenerowaną nazwaną listę to mało efektowna praca, a potem typecheckujesz całe repozytorium i naprawiasz to, co się posypało. Łatwą alternatywą jest dodanie ponowienia i życie z resetami, i wiele zespołów tak robi. Jeśli twój Durable Object w bezczynności jest gdziekolwiek blisko limitu, twierdzę, że ten tydzień jest tego wart, bo limit się nie ruszy, a liczba twoich narzędzi tylko rośnie.
Trzy rzeczy, które chciałbym wiedzieć od pierwszego dnia:
- Wysoko i płasko w bezczynności oznacza baseline. Profiluj to, co wysyłasz, nie to, co serwujesz.
- Tree shaking ma reguły.
sideEffects: false, nazwane re-eksporty, importy statyczne. Pomiń jedną, a cały pakiet jedzie razem. - Schematy to kod, nie typy. Jeśli konsument chce JSON schema, pisz JSON schema.
Zrób to dziś, żeby naprawić pamięć swojego Durable Object
Profiler to ~100 linii bez zależności poza Node i wranglerem. Wklej poniższy przepis do swojego agenta kodującego w korzeniu dowolnego repozytorium wdrażanego wranglerem, przeczytaj dziesięć górnych wierszy tabeli, którą wypisze, i zobacz, co tam jest. Potem idź w dół listy: zwykły JSON schema dla wszystkiego, co model i tak dostaje jako JSON schema, "sideEffects": false i nazwane re-eksporty dla barreli, importy statyczne dla korzeni pakietów.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Jeśli chcesz, żeby cały audyt został zrobiony za ciebie, oto skill dla twojego agenta kodującego:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Dodaliśmy ten skill także do samego Polylane, więc każdy użytkownik Polylane dostaje to dogłębne badanie pamięci swoich Durable Objects od razu, bez wklejania czegokolwiek.