

Как мы исправили ошибки превышения памяти в наших Cloudflare Durable Objects
Explore with AI
Каждый тред агента в Polylane работает внутри собственного Cloudflare Durable Object, и все они являются экземплярами одного класса. В августе 2026 года Durable Objects наших тредов сбрасывались примерно 300 раз в день за превышение лимита памяти. Ту же историю мы слышали от нескольких команд, которые запускают свои агентские процессы на Cloudflare Durable Objects.
Если вы сталкивались с exceededMemory на Durable Object, обычный совет: посмотреть, что аллоцируют ваши запросы: слишком большой payload, история чата, растущая без ограничений, кэш, который никогда не вытесняет. Ничего из этого к нам не относилось. Изолят превышал лимит до того, как обслужил хотя бы один запрос, так что вес должен был быть в коде, который мы выпускали, а не в данных, которые мы отдавали.
Эта статья о том, что на самом деле лежало в heap, как мы нашли это на платформе, которая не позволяет подключить профайлер, и о двух изменениях, которые снизили память уровня модулей с 218 MB до 82 MB, а сбросы до нуля.
Cloudflare Durable Objects за одну минуту
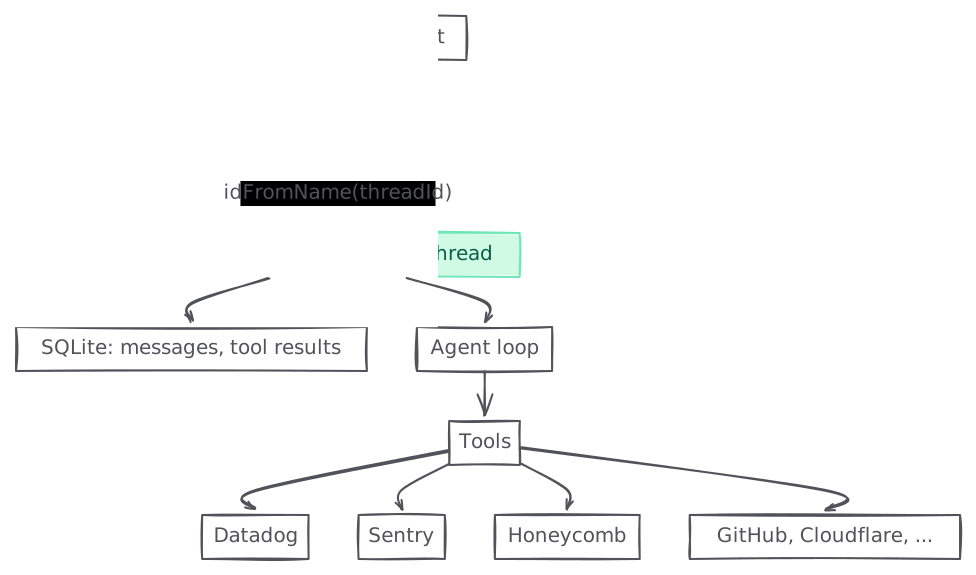
Если вы ими не пользовались: Durable Object: это небольшой однопоточный сервер с состоянием, уникальность которого для заданного ID гарантирует Cloudflare. Вызовите idFromName() с этим ID из Worker, и каждый запрос к нему, из любой точки мира, попадёт на один и тот же экземпляр, с собственной базой данных SQLite, состоянием в памяти и алармами. Он засыпает в простое и просыпается там, где остановился.
В Polylane мы создаём экземпляр Durable Object для каждого треда. Каждый разговор с агентом, начал ли его человек или алерт, получает собственный Durable Object. SQLite объекта хранит сообщения треда и результаты инструментов, внутри него работает цикл агента, а его инструменты обращаются к тем провайдерам, которые нужны треду: Datadog, Sentry, Honeycomb, GitHub, Cloudflare и остальные. Когда тред затихает, объект засыпает, а когда приходит следующее сообщение, он продолжает точно с того места, где остановился.
Как устроена память Durable Objects
- Изоляты и лимит 128 MB. Durable Objects работают внутри изолятов V8, а у изолята есть жёсткий лимит памяти 128 MB, одинаковый на всех планах и не настраиваемый.
- Совместное размещение. Один изолят хостит много Durable Objects одного класса вместе с кодом Worker вокруг них, и все они делят память этого изолята. Лимит действует на изолят, а не на объект.
- Шумные соседи. Из-за совместного размещения объект, который сбрасывается, когда у изолята заканчивается память, часто не тот объект, который эту память использовал. Каждая выборка памяти, которую сообщает Cloudflare, относится ко всему изоляту, как и каждый сброс.
Подключить профайлер памяти к production Durable Object невозможно: инструменты снимков heap, которые документирует Cloudflare, работают с локальной dev-сессией. В Kubernetes вы бы включили профилирование и подключались, пока не нашли проблему. В workerd process.memoryUsage(): это полифил unenv, возвращающий нули, а базовые показатели памяти и CPU не видны коду, который работает внутри. Что у вас есть: GraphQL analytics API от Cloudflare: перцентили памяти и счётчики падений по пространству имён, постфактум.
Что нам сказал график памяти
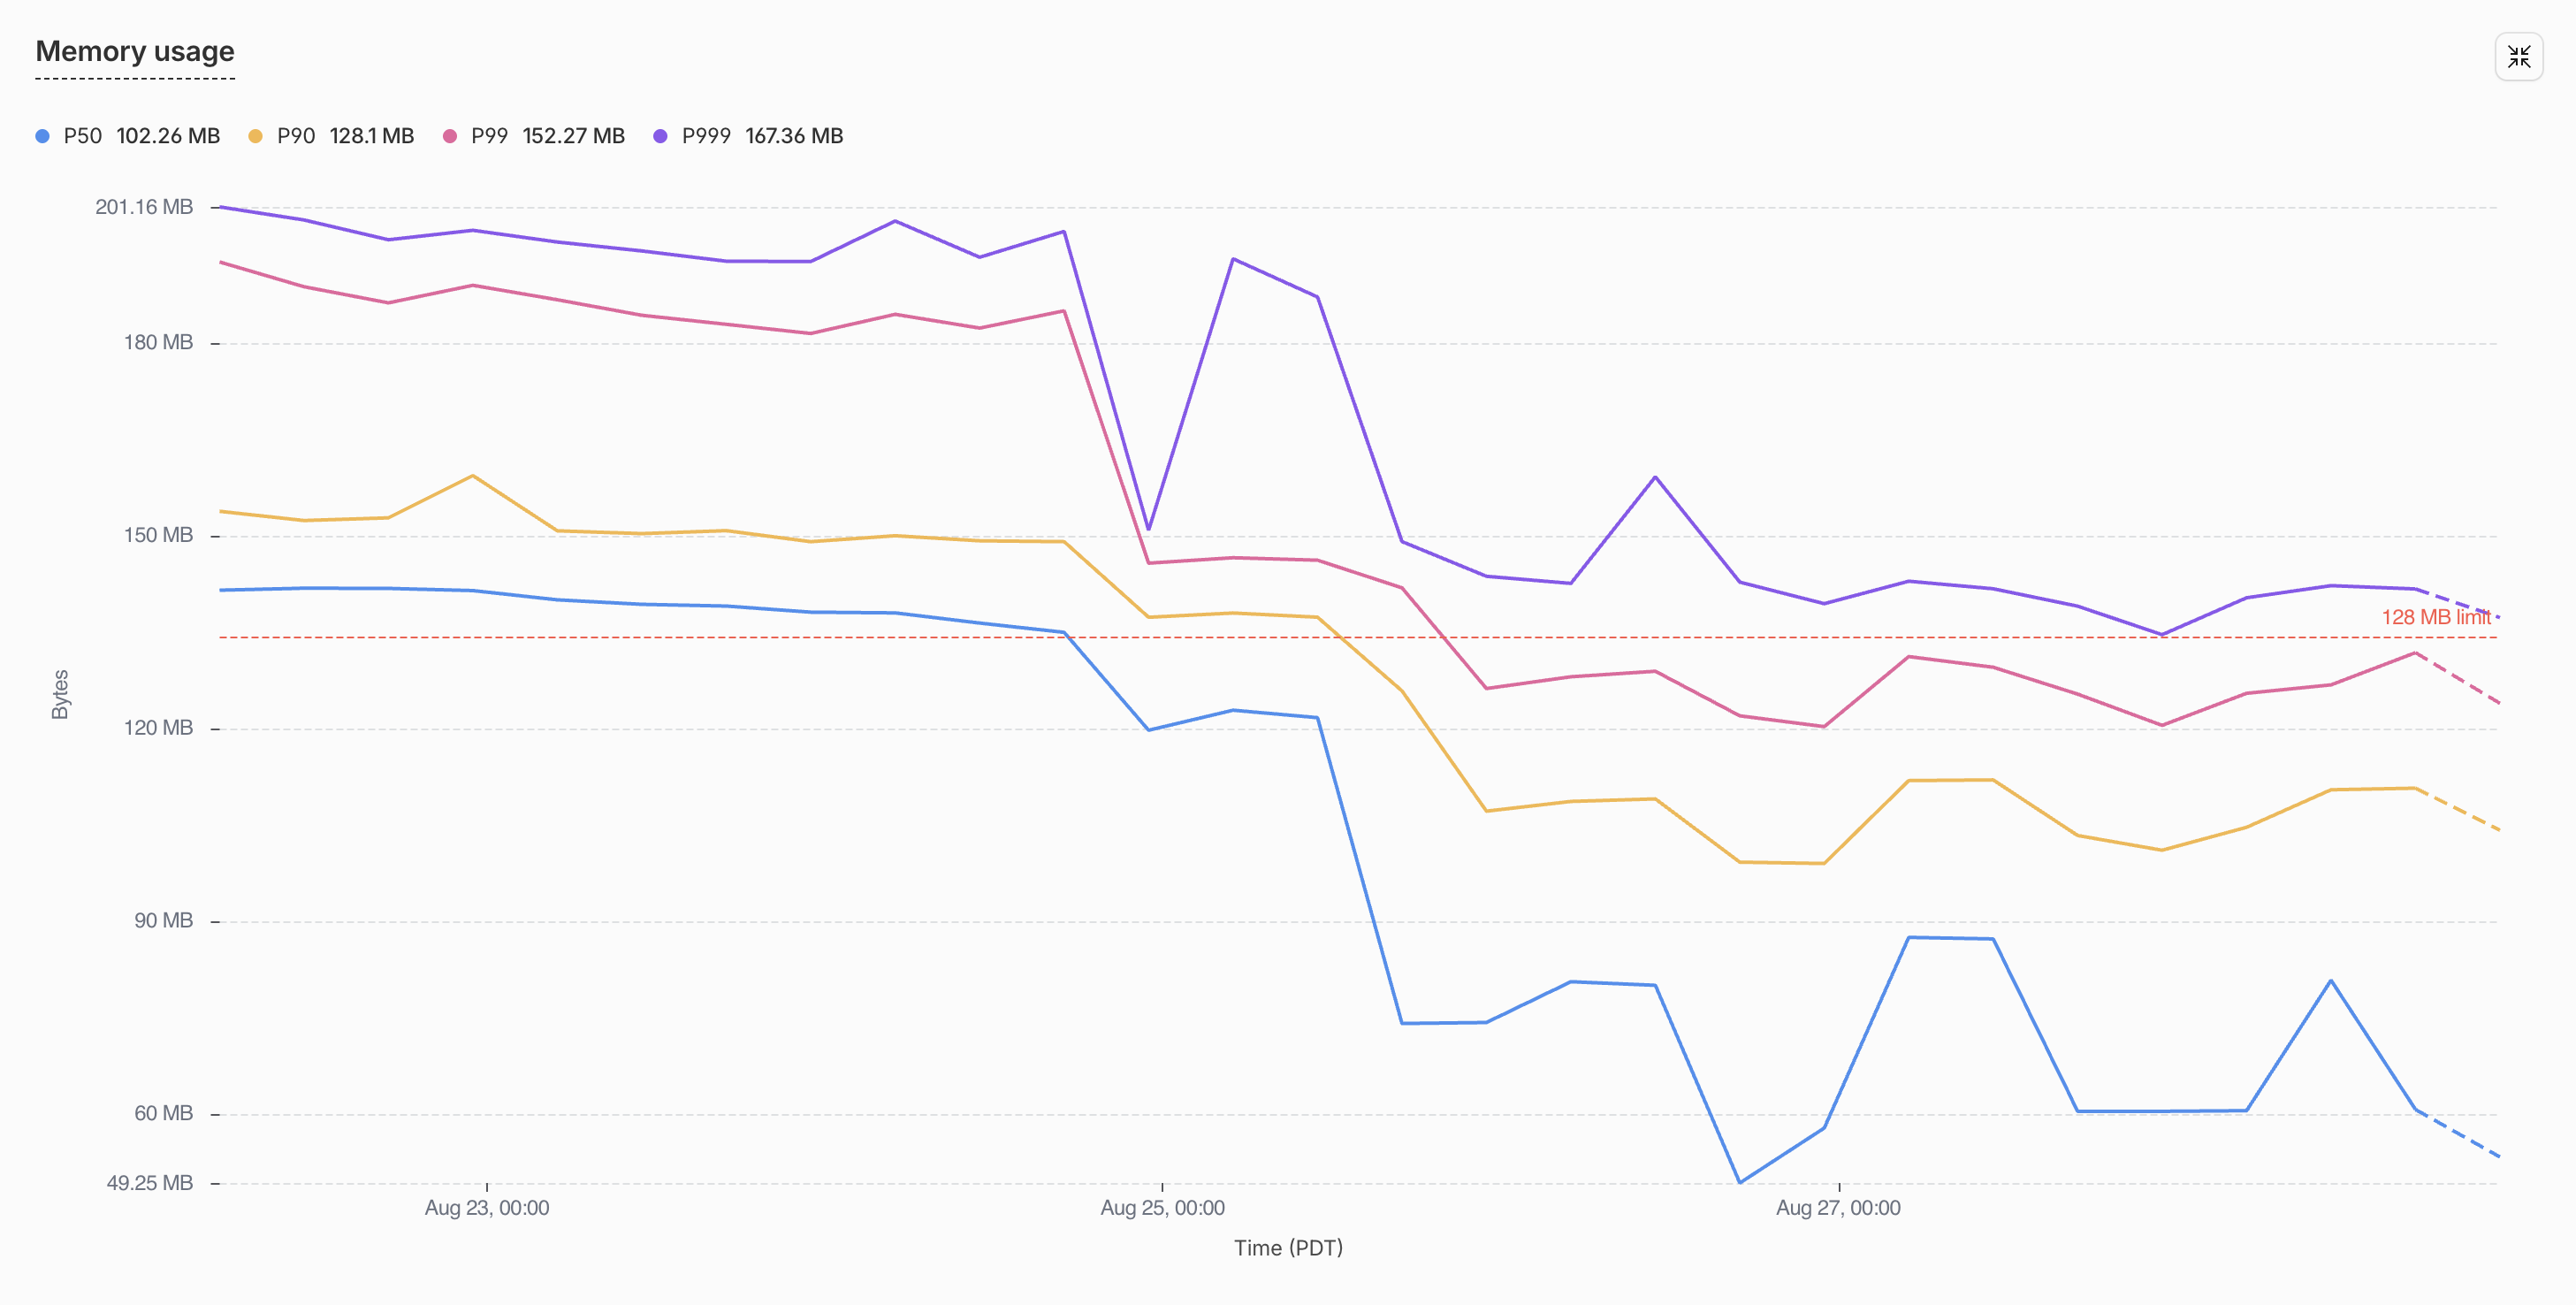
Analytics API Cloudflare сообщает память для пространства имён Durable Object как перцентили по изолятам, которые его запускают, в пятнадцатиминутных корзинах, вместе с числом ошибок превышения памяти в каждой корзине. Каждый график в этой статье получен из этого API, отфильтрован по пространству имён тредов и сравнён по маркерам деплоев, как только мы начали выпускать исправления.
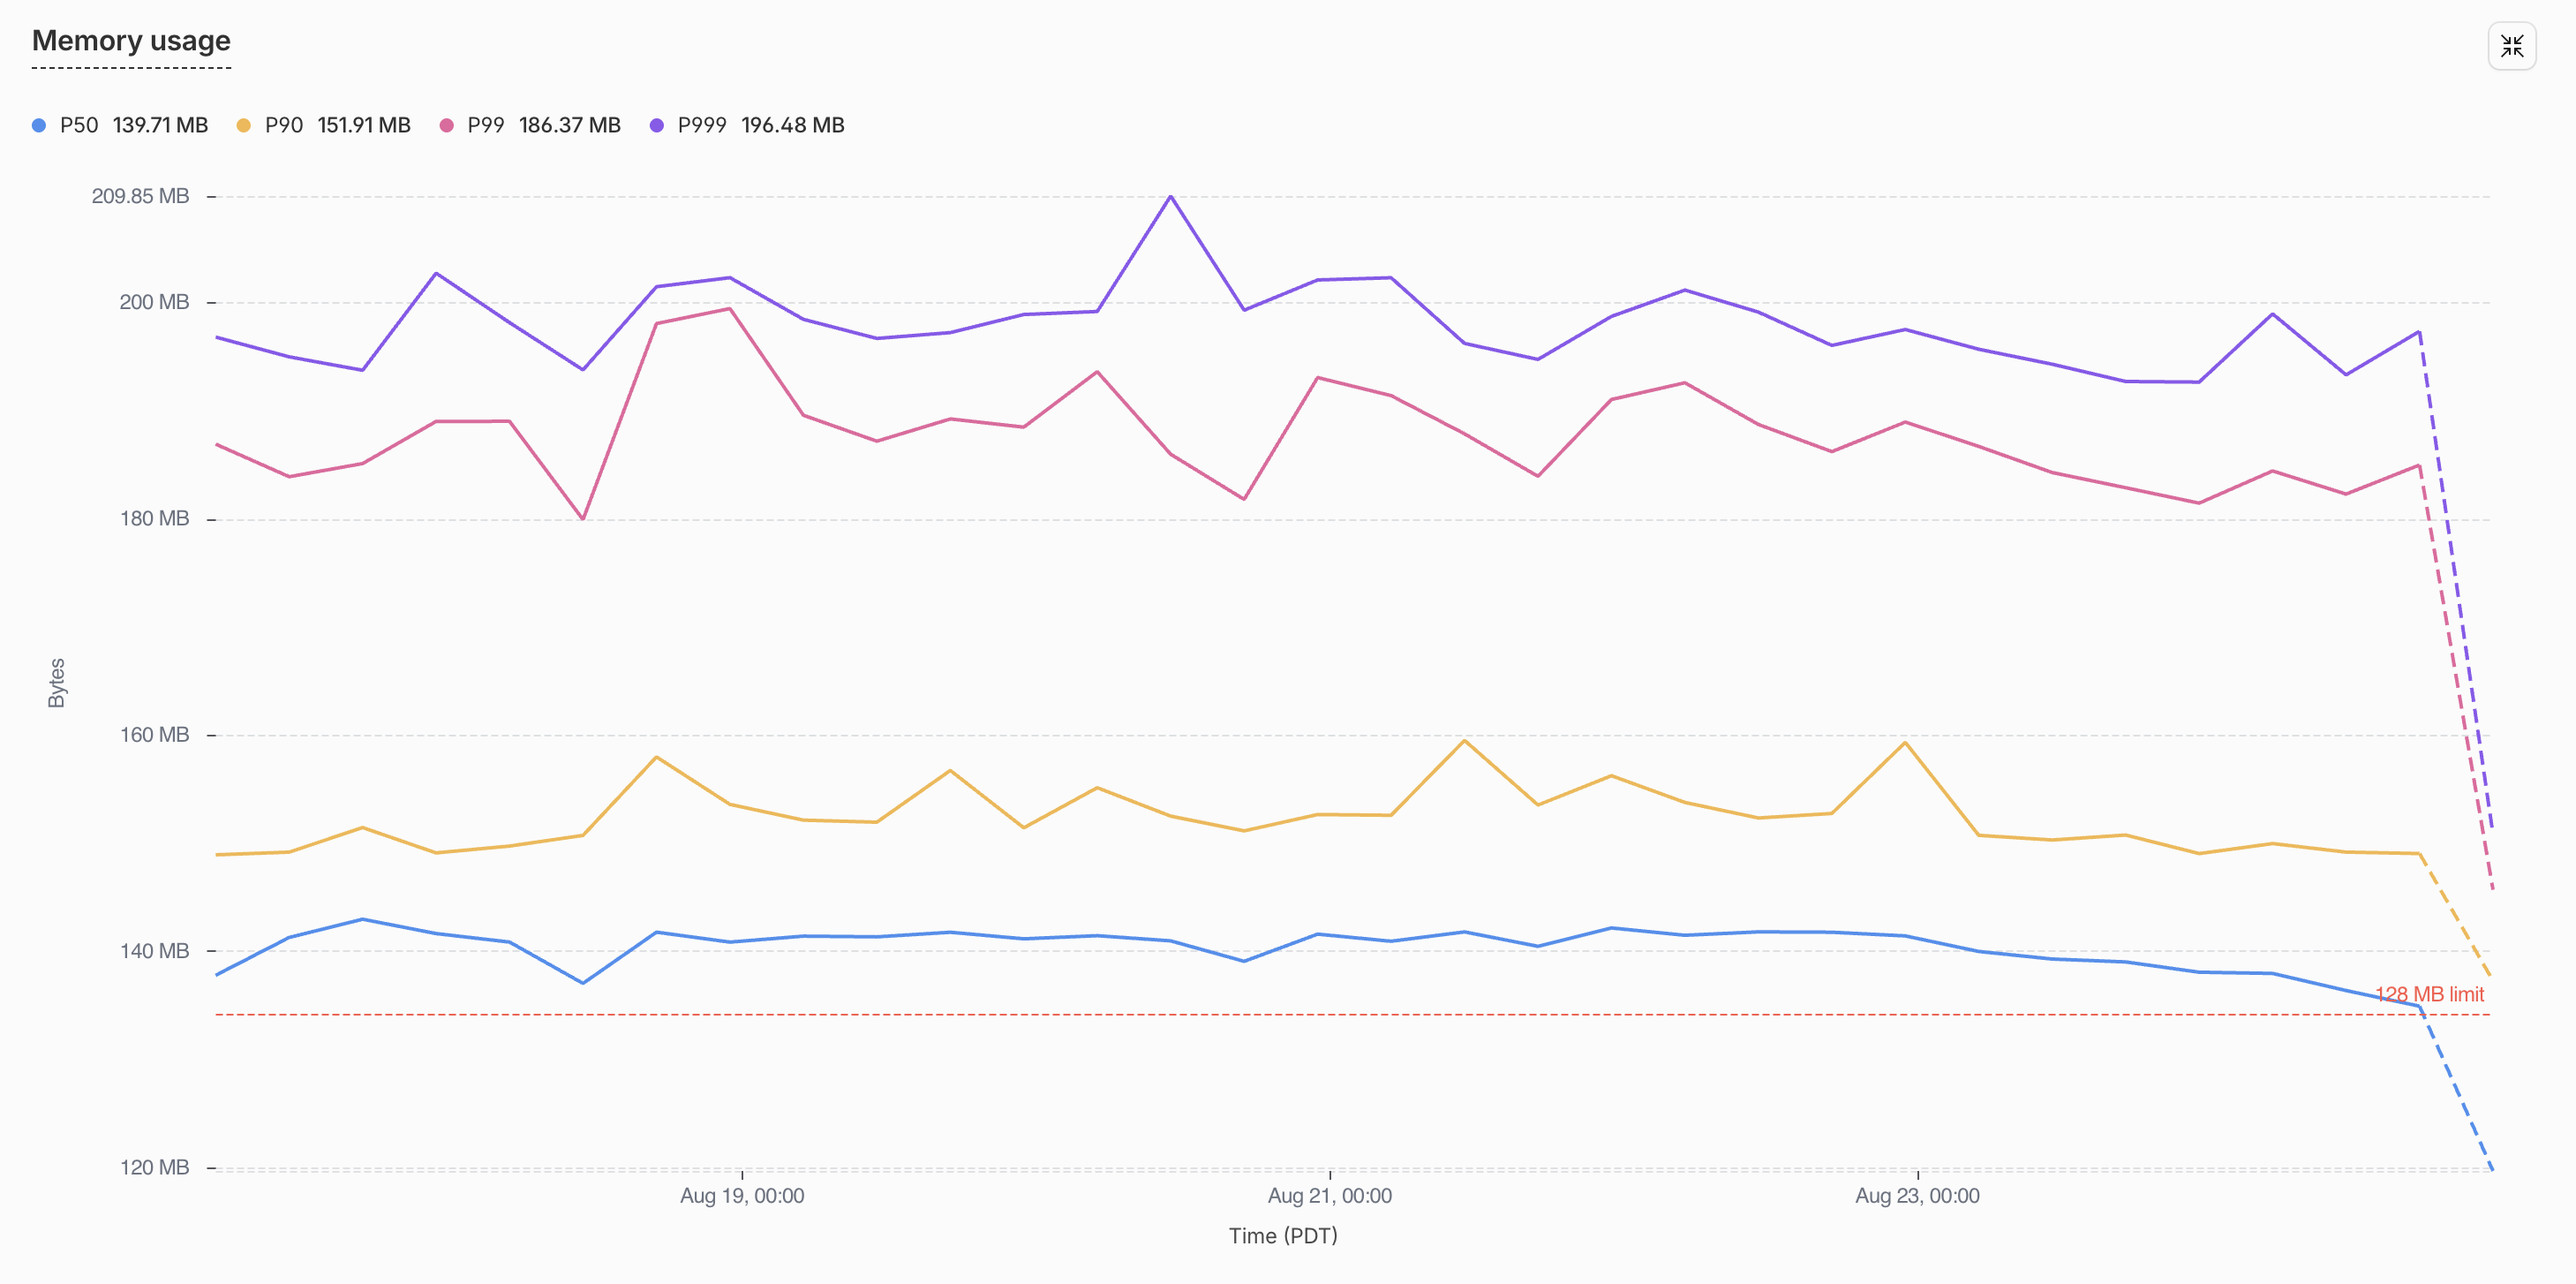
Медианный изолят, синяя линия на рисунке 1, всю неделю держался около 140 MB, а 99-й перцентиль около 190 MB. Обе линии выше пунктирного лимита 128 MB, а значит, типичный изолят в пространстве имён уже прошёл точку, за которой Cloudflare вправе его сбросить, и его лишь щадили до следующей аллокации, которая перевесит чашу. Чего график не показывал, так это какой-либо связи с трафиком. Линия была одинаково плоской в тихие часы и в загруженные, и ни один из примерно 300 сбросов в день не приходил со стектрейсом, потому что исключение никогда не выбрасывал наш код.
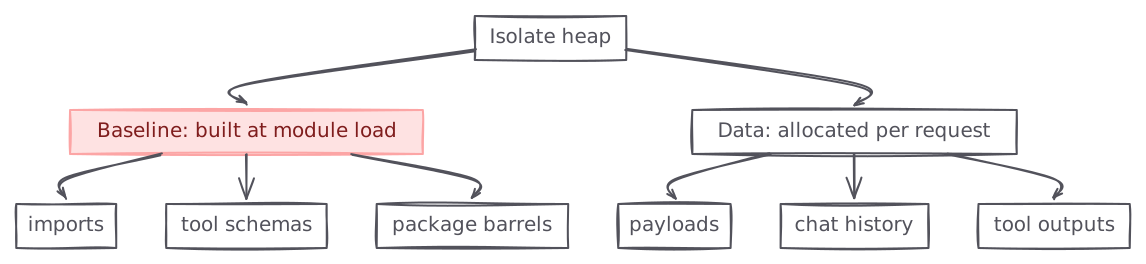
Мы смотрели туда, куда вы бы посмотрели первым делом. Мы читали размеры payload, проверяли, как обрезается история чата, и искали в кривой памяти паттерн запросов, и не нашли ничего, что сдвигало бы линию. Эта плоскость и оказалась важной подсказкой. Память изолята: это одно из двух: либо данные, то есть payload запросов, история чата, выводы инструментов и всё остальное, аллоцированное при обслуживании трафика, либо базовый уровень, то есть объекты, которые сам код создаёт при загрузке модуля и держит живыми всё время жизни изолята: импорты, функции и схемы. Данные растут и падают вместе с запросами, а базовый уровень существует до первого запроса и никогда не исчезает, так что высокий и плоский в простое график описывает базовый уровень. Проблема должна была быть в том, что мы выпускали, а не в том, что мы отдавали.
Почему память базового уровня так легко упустить
Память базового уровня прячется в двух местах, куда вы обычно не смотрите.
Первое: бандлер. Мы считаем, что tree shaking удаляет код, который мы не используем, и в основном так и есть, но у esbuild есть правила о том, когда он может отсекать, и это не те правила, которые вы бы предположили. Пакет без "sideEffects": false в своём package.json не отсекается вообще. export * внутри лениво вычисляемого модуля тоже никогда не отсекается. Динамический import() корня пакета помечает каждый экспорт как используемый. Мы вернёмся к каждому из этих пунктов в исправлениях, потому что они объясняют половину из 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Второе: библиотека схем. Типы кажутся бесплатными, потому что исчезают на этапе компиляции, но схема zod: это не тип, это дерево замыканий, которое строится в момент вычисления её модуля. Одна объектная схема zod 4 среднего размера, дюжина полей с описаниями и уточнениями, стоит ~134 KB heap. Голый z.string() стоит ~12 KB. Эквивалентный простой объект JSON schema стоит несколько сотен байт. Ничего из этого нет в README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Мы не делали ничего экзотического
Каждая из наших проблем произошла из настройки по умолчанию. Каждый агентский инструмент объявлял свой ввод через z.object() на уровне модуля, потому что так делают в документации. У каждого внутреннего пакета был barrel index.ts с export * from "./zod", потому что это аккуратно. Несколько путей использовали await import("@scope/package"), потому что ленивая загрузка вроде бы дешевле. Каждый выбор сам по себе разумен. Вместе они составили 130 MB в изоляте, у которого есть 128.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Во что это нам обходилось
У нашего агента более 250 инструментов, которые он использует через code mode и динамические воркеры. Одни только их определения zod стоили 78 MB heap при загрузке модулей, больше половины бюджета изолята, потраченного на описания аргументов до того, как хоть один из них был вызван. Каждый добавленный инструмент стоил ещё ~134 KB, независимо от того, запускался ли он когда-либо.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Сбросы тоже не были бесплатными. Каждый exceededMemory выбрасывает ход агента в процессе: повтор, второй вызов модели, пользователь, смотрящий на спиннер. При ~300 в день это перестаёт быть инцидентом и становится постоянным налогом, а из-за совместного размещения его платил тот объект, который в этот момент оказался в изоляте.
Error: Durable Object's isolate exceeded its memory limit and was reset.Как мы это нашли: heap-профайлер для production-бандла
Мы не могли профилировать production, поэтому построили небольшой профайлер, который запускается локально на точно том бандле, который работает в production. Он измеряет стоимость вычисления каждого модуля в heap V8 и печатает ранжированную таблицу. Мы запускали его в цикле: профилировать, убрать верхушку рейтинга, профилировать снова. Финальной проверкой каждого исправления был production-деплой, сравнённый с метриками памяти Cloudflare по обе стороны маркера деплоя.
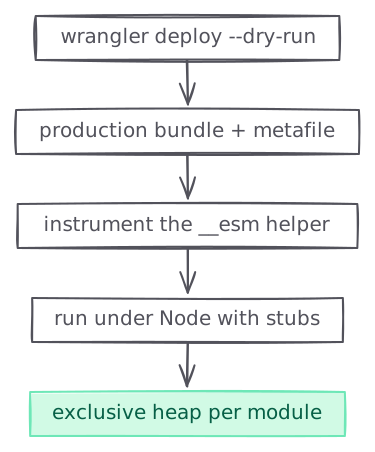
Это работает благодаря трём идеям:
- Тот же бандл.
wrangler deploy --dry-run --outdir --metafileвыдаёт точно тот бандл esbuild, который загрузил бы деплой, плюс его граф модулей. Всё измеряется на этом бандле. - Атрибуция по модулям. esbuild оборачивает лениво вычисляемые модули в замыкания-инициализаторы
__esm(...). Мы переписываем этот единственный хелпер в собранном бандле так, чтобы инициализация каждого модуля записывалаv8.getHeapStatistics().used_heap_sizeдо и после себя, а стек инициализации отделял собственную стоимость модуля (эксклюзивную) от стоимости его зависимостей (инклюзивной). Результат: набор данных в форме флеймграфа. - Контролируемые запуски. Инструментированный бандл запускается под обычным Node с шимом загрузчика, который разрешает импорты
cloudflare:*в заглушки.
Полный рецепт, готовый для вставки в кодинг-агент, находится в конце статьи. Единичные стоимости zod, приведённые выше, получены из микробенчмарка, прогнанного через тот же стенд.
Что показал первый профиль
| Источник | Эксклюзивный heap |
|---|---|
packages/tools (250+ определений агентских инструментов, zod) | 78.0 MB |
| Barrel’ы пакетов, реэкспортирующие модули схем zod (строки ниже) | ~66 MB |
durable-workspaces (состояние рабочего пространства и расписания) | 15.6 MB |
thread-core (слой данных тредов) | 10.1 MB |
durable-automations (определения автоматизаций) | 9.6 MB |
durable-threads (список тредов и живые обновления) | 7.3 MB |
durable-automation (один прогон автоматизации) | 6.8 MB |
db (клиент D1 и модели) | 6.3 MB |
durable-skills (определения навыков) | 5.7 MB |
durable-autofixes (ветки и merge автофиксов) | 4.9 MB |
| 12 пакетов поменьше | ~9 MB |
Вторая строка: самая удивительная. Это схемы, которые попадают в бандл только через export * from "./zod" в barrel’ах пакетов. Наш код никогда их не использовал, tree shaker не мог их удалить, а стоили они треть лимита памяти, и всё это в модулях, которые никто никогда не вызывал.
Исправление A: определения инструментов как данные, а не код
Каждое определение инструмента объявляло схему ввода в zod и конвертировало её в JSON schema во время выполнения, потому что JSON schema: это то, что в любом случае отправляется модели. Мы строили ~134 KB замыканий на инструмент, чтобы получить несколько сотен байт данных, поэтому мы записали данные напрямую.
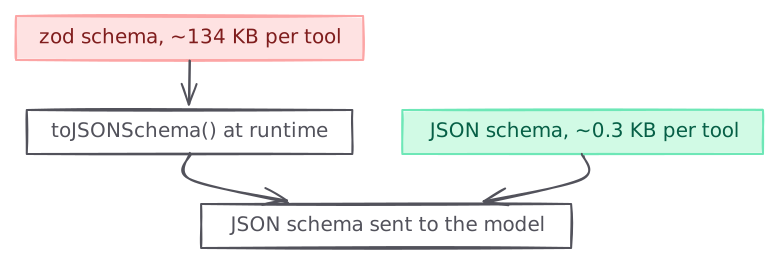
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;defineParameters: тонкая обёртка над jsonSchema() из AI SDK. ParametersInput: это json-schema-to-ts, выполняющий вывод типов, который раньше делал zod. Валидация во время выполнения переехала в валидатор на ~300 строк, который воспроизводит свойства, от которых зависит цикл агента: неизвестные ключи отбрасываются, значения по умолчанию заполняются, объединения разрешаются по дискриминатору, а сообщения об ошибках сформулированы так, чтобы модель могла исправить собственный вызов инструмента при повторе.
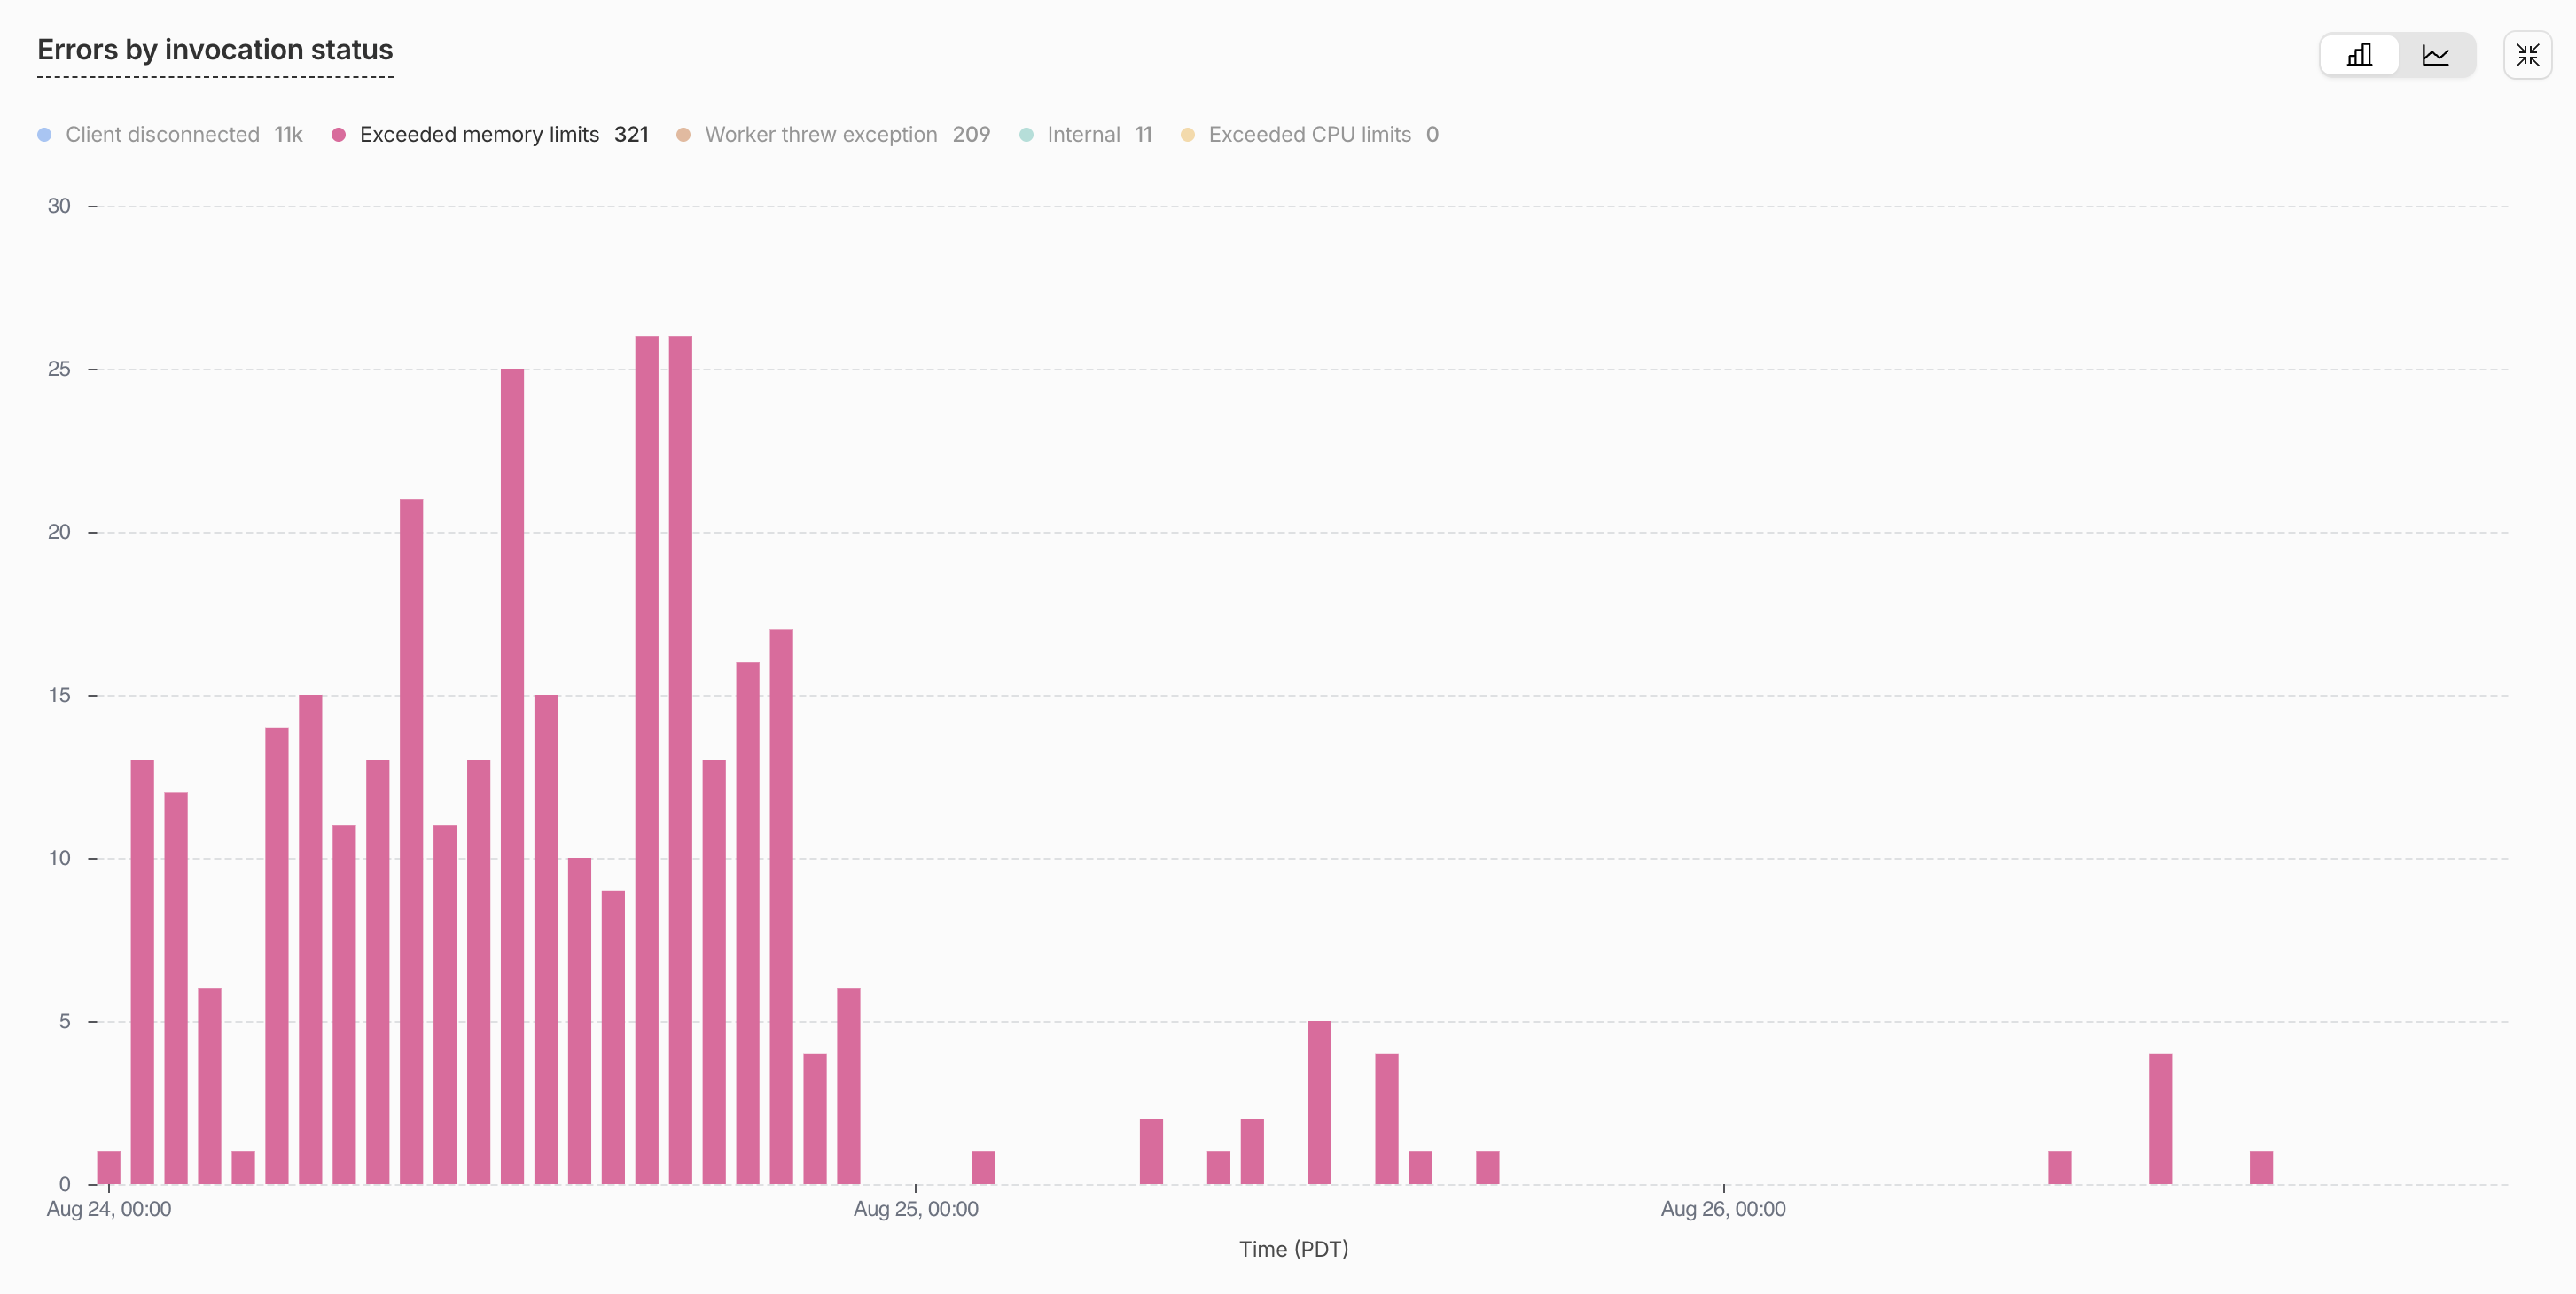
Heap после вычисления модулей упал локально с 218.6 до 154.0 MB, а packages/tools с 78 MB до 0.7 MB. В production сбросы упали с 40-110 в час до 0-6 в час на маркере деплоя, а память медианного изолята с ~140 MB до ~120 MB.
Исправление B: barrel’ы, которые действительно поддаются tree shaking
Оставшиеся ~66 MB были схемами, которые изолят никогда не использовал. Это объясняют три поведения бандлера:
- Без
"sideEffects": falseвpackage.jsonпакета esbuild не отсекает из него ничего. - Даже с флагом
export * from "./zod"никогда не отсекается внутри лениво вычисляемого модуля, а всё, что достижимо через динамическийimport(), вычисляется лениво. Именованные реэкспорты (export { zFoo } from "./zod") отсекаются нормально. await import("@scope/package")материализует весь объект пространства имён пакета, помечая каждый экспорт как используемый: схемы, классы, всё.
Мы подтвердили каждый из этих пунктов фикстурой из пяти файлов, собранной той версией esbuild, которую встраивает wrangler: точка входа, пакет с barrel’ом index.ts, zod.ts с одной схемой, конструктор которой сообщает о своём запуске, класс do.ts, импортирующий эту схему, и ленивый промежуточный модуль между ними. Таблица фиксирует для каждой комбинации, запускался ли конструктор схемы при вычислении.
| Точка входа импортирует barrel через | Форма реэкспорта в barrel | sideEffects: false | Схема включена |
|---|---|---|---|
| Статический импорт | export * | Да | Нет |
| Статический импорт | export * | Нет | Да |
Динамический import() пакета | Любая | Да | Да |
| Статический импорт из лениво загружаемого модуля | export * | Да | Да |
| Статический импорт из лениво загружаемого модуля | Именованный список | Да | Нет |
| Любая | Именованный список | Нет | Да |
Строки 3 и 4: те две, которые удивляют людей, и вместе они дали ~66 MB. Вот что один barrel делал с нами:
Исправление механическое: "sideEffects": false во всех 110+ пакетах рабочего пространства, переписать export * в barrel’ах на именованные списки реэкспортов и заменить await import("@scope/package") корней пакетов статическими именованными импортами.
Абляция на реальном production-бандле показывает, что каждая часть необходима.
| Конфигурация | Heap после вычисления модулей | Модулей схем в бандле |
|---|---|---|
| Базовый уровень (после исправления A) | 154.0 MB | 77 |
Только sideEffects: false | 143.6 MB | 77 |
+ Статические импорты, barrel’ы снова на export * (контроль) | 98.6 MB | 29 |
| + Именованные списки реэкспортов (полное исправление) | 82.1 MB | 0 |
Контрольная строка: самая интересная: даже полностью статический граф импортов сохраняет 29 модулей схем, так что именованные списки не опциональны.
Конечное состояние
| Heap уровня модулей (локальный пробник) | Медианная память в production | Сбросы в production | |
|---|---|---|---|
| До | 218.6 MB | ~140 MB | ~300/день |
| После A | 154.0 MB | ~120 MB | ~10/день |
| После A+B | 82.1 MB | ~70 MB | 0 |
Durable Object, который в простое превышал лимит памяти платформы, теперь в простое занимает едва половину, а ~300 ежедневных сбросов исчезли.
Это не флаг в конфигурации
Переписать более 250 определений инструментов с zod на сырую JSON schema и написать валидатор на 300 строк взамен того, что zod делал за нас, заняло несколько дней, даже с кодинг-агентами. Добавить sideEffects: false в более чем 100 пакетов и превратить каждый export * в сгенерированный именованный список: негламурная работа, после которой вы типизируете весь репозиторий и исправляете то, что сломалось. Простая альтернатива: добавить повтор и жить со сбросами, и многие команды так и делают. Если ваш Durable Object хоть сколько-нибудь близок к лимиту в простое, я бы сказал, что эта неделя того стоит, потому что лимит не двигается, а число ваших инструментов только растёт.
Три вещи, которые я хотел бы знать с первого дня:
- Высокий и плоский в простое значит базовый уровень. Профилируйте то, что вы выпускаете, а не то, что вы отдаёте.
- У tree shaking есть правила.
sideEffects: false, именованные реэкспорты, статические импорты. Упустите одно, и весь пакет поедет с вами. - Схемы: это код, а не типы. Если потребителю нужна JSON schema, пишите JSON schema.
Сделайте это сегодня, чтобы исправить память своего Durable Object
Профайлер: это ~100 строк без зависимостей, кроме Node и wrangler. Вставьте рецепт ниже в свой кодинг-агент в корне любого репозитория, который деплоится через wrangler, прочитайте первые десять строк таблицы, которую он напечатает, и посмотрите, что там. Затем идите по списку вниз: простая JSON schema для всего, что модель и так получает как JSON schema, "sideEffects": false и именованные реэкспорты для barrel’ов, статические импорты для корней пакетов.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Если вы хотите, чтобы весь аудит был сделан за вас, вот навык для вашего кодинг-агента:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Мы также добавили этот навык в сам Polylane, так что каждый пользователь Polylane получает это глубокое расследование памяти своих Durable Objects из коробки, без необходимости что-либо вставлять.