

Sådan fik vi styr på vores Cloudflare Durable Objects memory exceeded-fejl
Explore with AI
Hver agenttråd i Polylane kører inde i sit eget Cloudflare Durable Object, alle sammen instanser af én klasse. I august 2026 blev vores trådes Durable Objects nulstillet omkring 300 gange om dagen for at overskride hukommelsesgrænsen. Vi hørte den samme historie fra flere teams, der kører deres agentiske flows på Cloudflare Durable Objects.
Hvis du er stødt på exceededMemory på et Durable Object, er det sædvanlige råd at kigge på, hvad dine requests allokerer: en payload, der er for stor, en chathistorik, der vokser uden grænse, en cache, der aldrig rydder op. Intet af det gjaldt for os. Isolatet var over grænsen, før det havde betjent en enkelt request, så vægten måtte ligge i den kode, vi leverede, og ikke i de data, vi betjente.
Dette indlæg handler om, hvad der faktisk lå i heapen, hvordan vi fandt det på en platform, der ikke lader dig koble en profiler på, og de to ændringer, der tog hukommelsen på modulniveau fra 218 MB til 82 MB og nulstillingerne til nul.
Cloudflare Durable Objects på ét minut
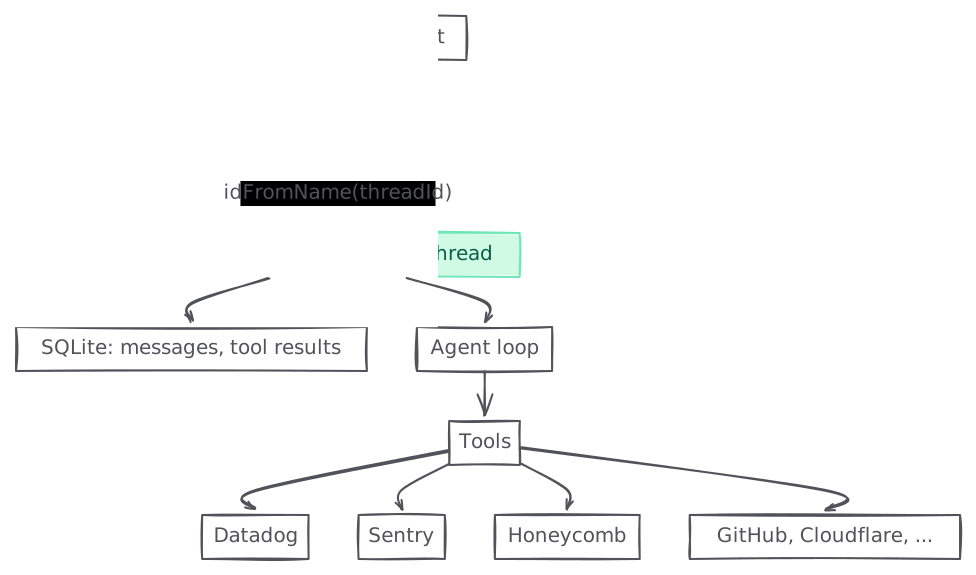
Hvis du ikke har brugt dem: et Durable Object er en lille, tilstandsfuld, enkelttrådet server, som Cloudflare garanterer er unik for et givet id. Kald idFromName() med det id fra en Worker, og hver request til det, fra hvor som helst i verden, lander på den samme instans, med sin egen SQLite-database, in-memory-tilstand og alarmer. Det går i dvale, når det er inaktivt, og vågner op, hvor det slap.
I Polylane opretter vi en Durable Object-instans for hver tråd. Hver samtale med agenten, uanset om en person startede den eller en alarm gjorde, får sit eget Durable Object. Objektets SQLite holder trådens beskeder og værktøjsresultater, agentloopet kører inde i det, og dets værktøjer kalder ud til de udbydere, tråden har brug for: Datadog, Sentry, Honeycomb, GitHub, Cloudflare og resten. Når tråden bliver stille, går objektet i dvale, og når den næste besked ankommer, fortsætter det præcis, hvor det stoppede.
Sådan virker hukommelse i Durable Objects
- Isolates og grænsen på 128 MB. Durable Objects kører inde i V8-isolates, og et isolate har en hård hukommelsesgrænse på 128 MB, som er den samme på alle planer og ikke kan konfigureres.
- Samplacering. Et enkelt isolate huser mange Durable Objects af samme klasse, sammen med Worker-koden omkring dem, og de deler alle det isolates hukommelse. Grænsen er pr. isolate, ikke pr. objekt.
- Støjende naboer. På grund af samplaceringen er det objekt, der bliver nulstillet, når isolatet løber tør for hukommelse, ofte ikke det objekt, der brugte hukommelsen. Hver hukommelsesmåling, Cloudflare rapporterer, er hele isolatets, og det er hver nulstilling også.
Der er ingen måde at koble en hukommelsesprofiler på et Durable Object i produktion: det heap snapshot-værktøj, Cloudflare dokumenterer, kører mod en lokal dev-session. I Kubernetes ville du slå profilering til og koble dig på, indtil du fandt problemet. I workerd er process.memoryUsage() en unenv-polyfill, der returnerer nuller, og baseline-tallene for hukommelse og CPU er ikke synlige for den kode, der kører indeni. Det, du får, er Cloudflares GraphQL analytics API: hukommelsespercentiler og crash-tællinger pr. namespace, efter det er sket.
Hvad hukommelsesgrafen fortalte os
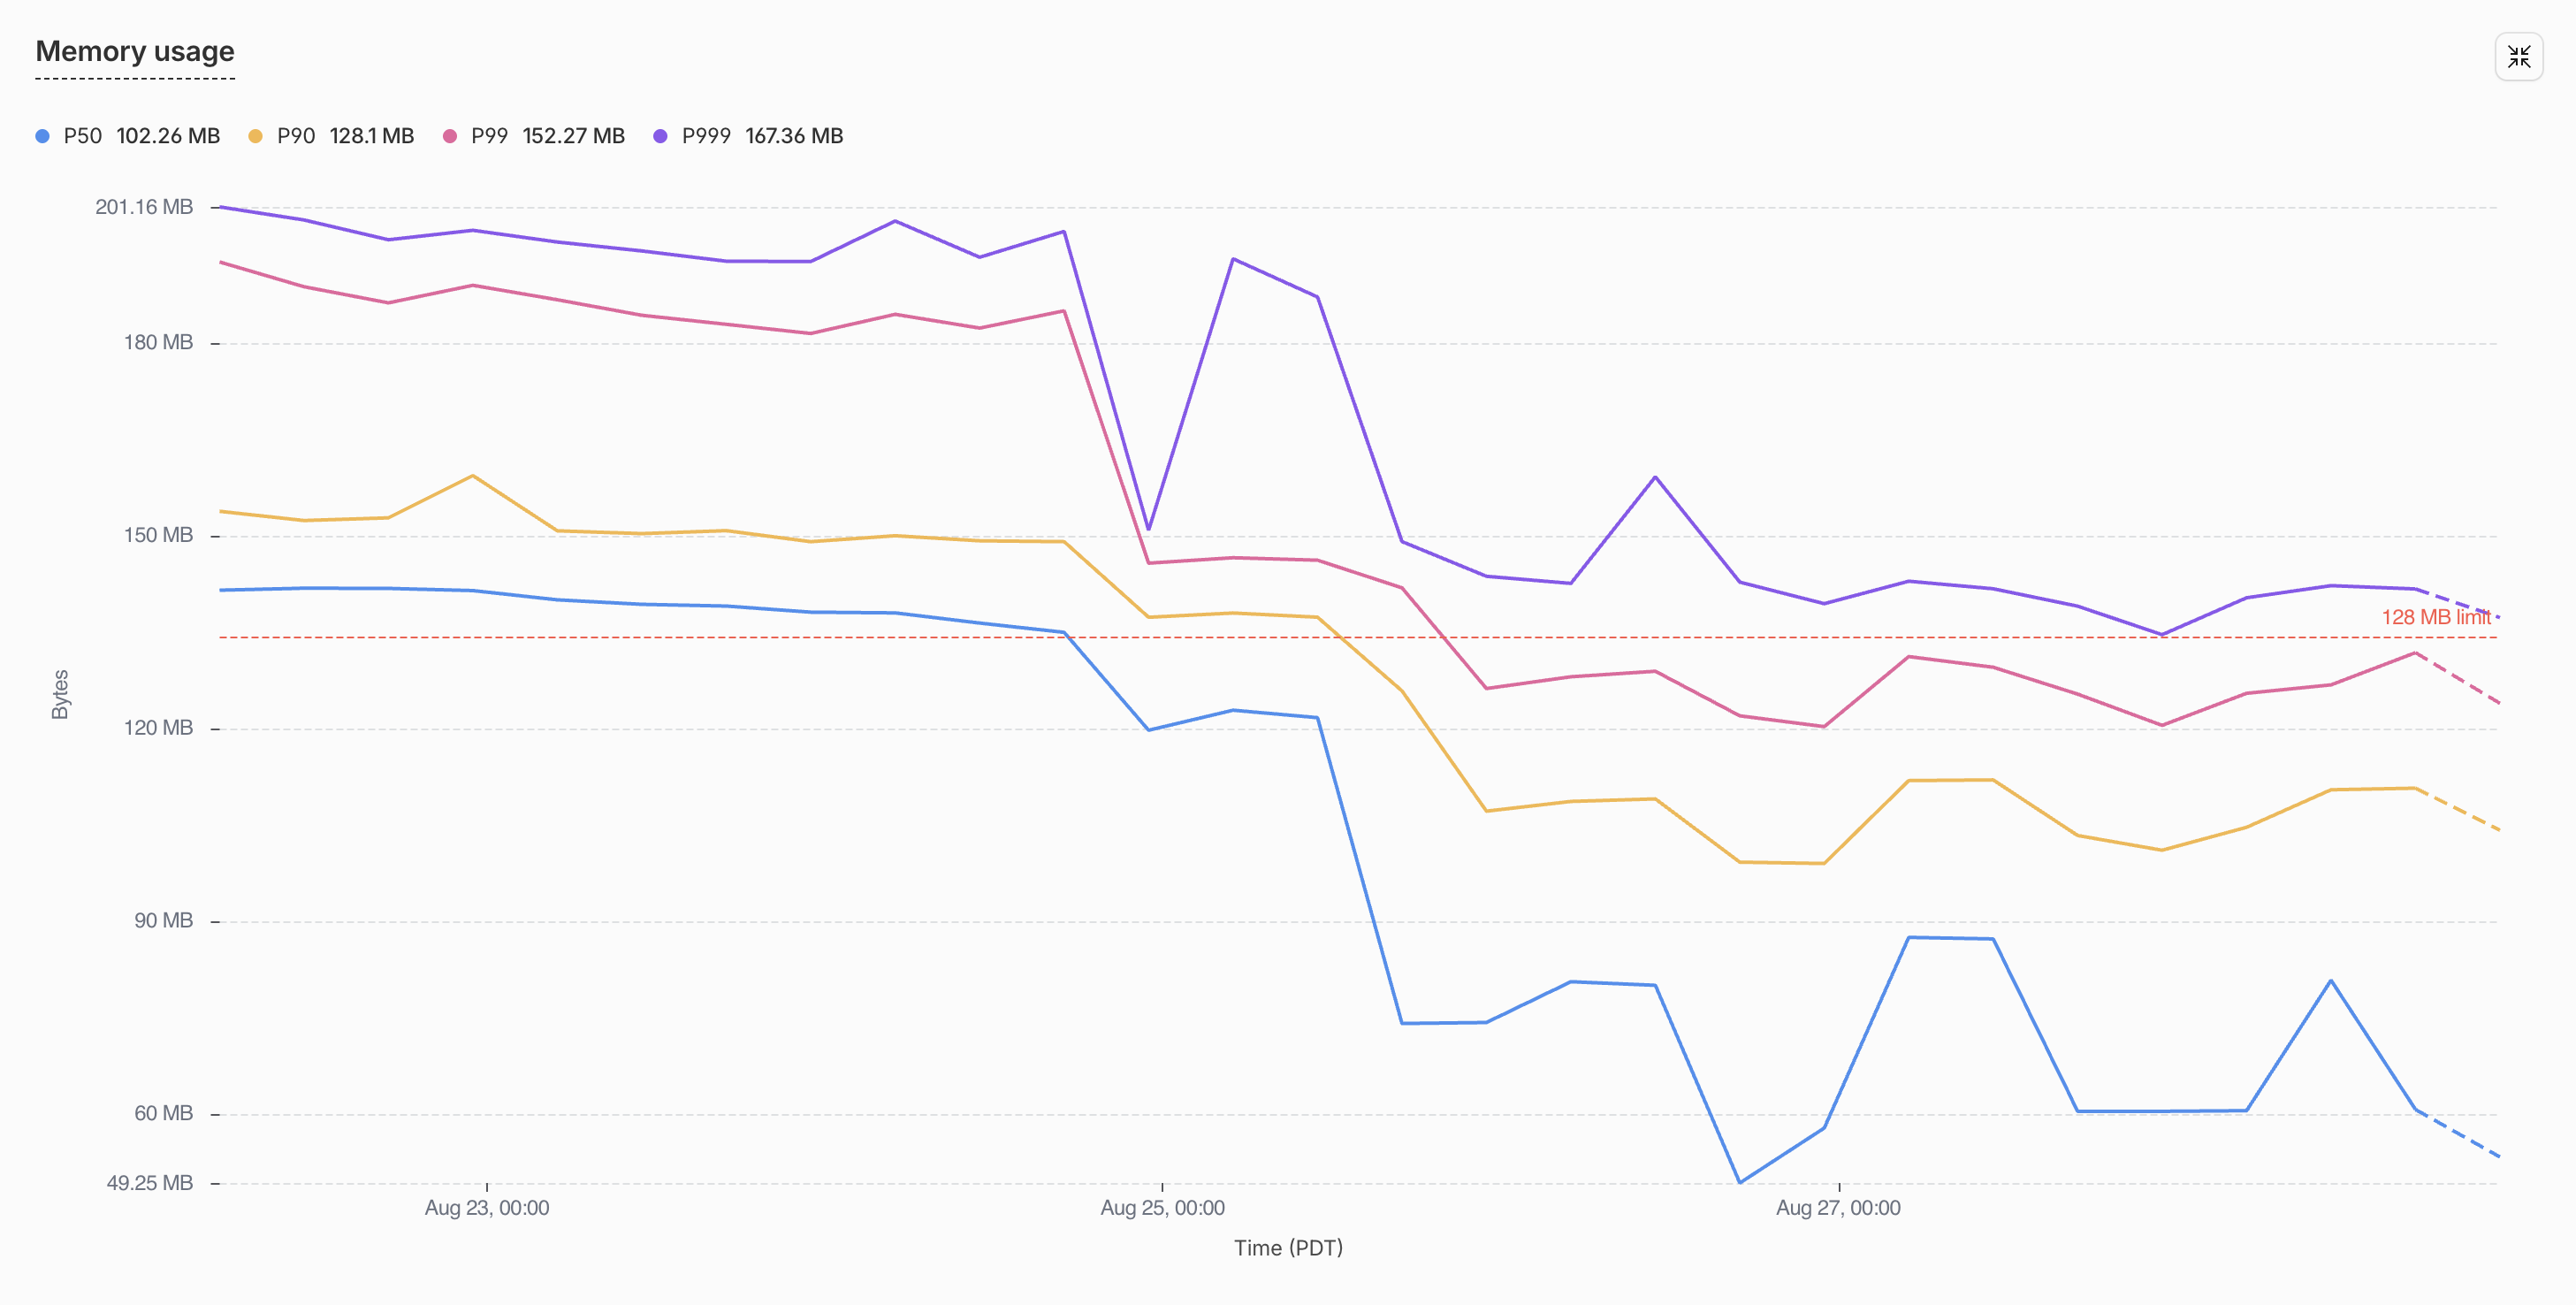
Cloudflares analytics API rapporterer hukommelse for et Durable Object-namespace som percentiler på tværs af de isolates, der kører det, i buckets på femten minutter, sammen med antallet af exceeded-memory-fejl i hver bucket. Hver graf i dette indlæg kommer fra det API, filtreret til tråd-namespacet og sammenlignet på tværs af deploy-markører, da vi begyndte at levere rettelser.
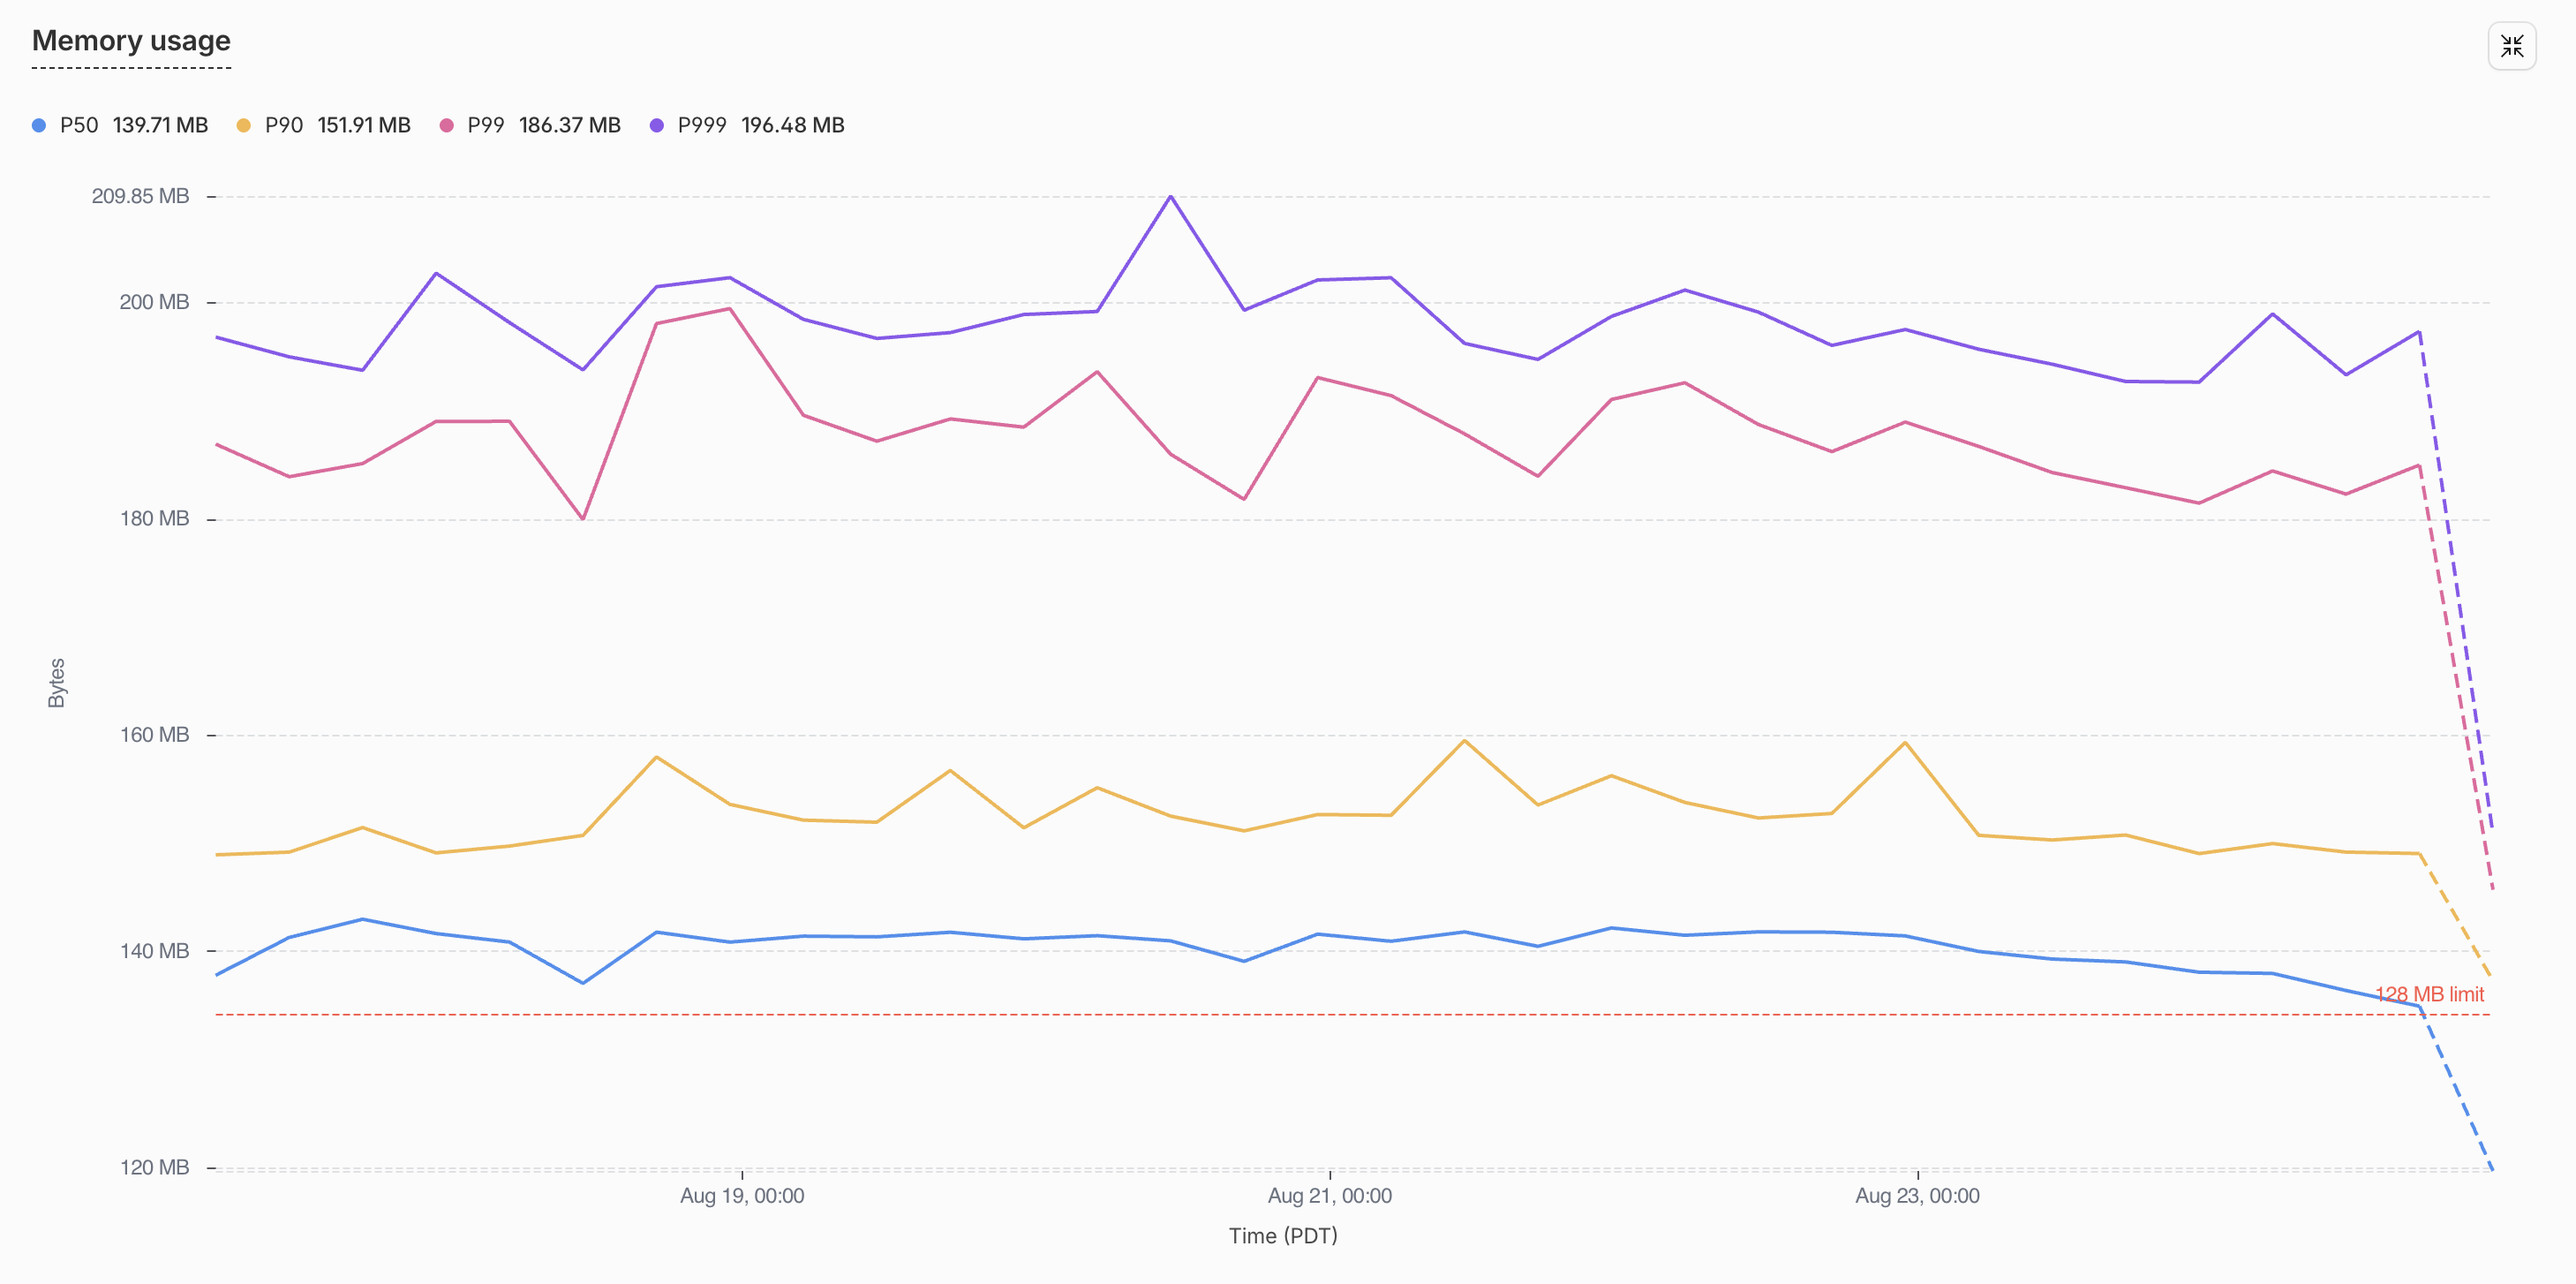
Median-isolatet, den blå linje i figur 1, lå på omkring 140 MB hele ugen, og 99. percentil lå nær 190 MB. Begge linjer er over den stiplede grænse på 128 MB, hvilket betyder, at det typiske isolate i namespacet allerede var forbi det punkt, hvor Cloudflare har ret til at nulstille det, og kun blev skånet, indtil den næste allokering tippede det over. Det, grafen ikke viste, var nogen sammenhæng med trafik. Linjen var lige så flad i de stille timer som i de travle, og ingen af de omkring 300 nulstillinger om dagen kom med en stack trace, fordi det aldrig var vores kode, der kastede fejlen.
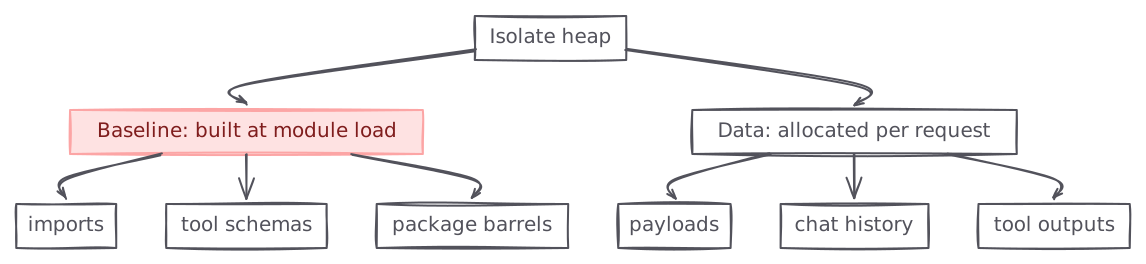
Vi kiggede, hvor man ville forvente at kigge først. Vi læste payload-størrelserne, vi tjekkede, hvordan chathistorikken blev afkortet, og vi søgte i hukommelseskurven efter et request-mønster, og fandt intet, der flyttede linjen. Den fladhed viste sig at være det vigtige spor. Et isolates hukommelse er én af to ting: det er data, altså request-payloads, chathistorik, værktøjsoutput og alt andet, der allokeres, mens trafik betjenes, eller det er baseline, altså de objekter, koden selv opretter, når et modul indlæses, og holder i live i isolatets levetid, såsom imports, funktioner og skemaer. Data stiger og falder med requests, mens baseline er der før den første request og aldrig forsvinder, så en graf, der er høj og flad i tomgang, beskriver baseline. Problemet måtte ligge i det, vi leverede, og ikke i det, vi betjente.
Hvorfor baseline-hukommelse er så nem at overse
Baseline-hukommelse gemmer sig to steder, hvor du normalt ikke kigger.
Det første er bundleren. Vi antager, at tree shaking fjerner den kode, vi ikke bruger, og det gør den for det meste, men esbuild har regler for, hvornår den må beskære, og de er ikke de regler, du ville gætte på. En pakke uden "sideEffects": false i sin package.json beskæres aldrig overhovedet. Et export * inde i et lazily evalueret modul beskæres heller aldrig. Et dynamisk import() af en pakkerod markerer hver eksport som brugt. Vi kommer tilbage til hver af disse i rettelserne, fordi de forklarer halvdelen af de 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Det andet er skemabiblioteket. Typer føles gratis, fordi de forsvinder på kompileringstidspunktet, men et zod-skema er ikke en type, det er et træ af closures, der bygges i det øjeblik, dets modul evalueres. Ét mellemstort zod 4-objektskema, et dusin felter med beskrivelser og refinements, koster ~134 KB heap. Et nøgent z.string() koster ~12 KB. Det tilsvarende almindelige JSON-skemaobjekt koster nogle få hundrede bytes. Intet af det står i README’en.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Vi havde ikke gjort noget eksotisk
Hvert eneste af vores problemer kom fra en standardindstilling. Hvert agentværktøj erklærede sit input med z.object() på modulniveau, fordi det er sådan, docs gør det. Hver intern pakke havde en barrel-index.ts med export * from "./zod", fordi det er pænt. Nogle få stier brugte await import("@scope/package"), fordi lazy loading skulle være billigere. Hver af dem er et fornuftigt valg i sig selv. Tilsammen var de 130 MB, i et isolate med 128 at gøre godt med.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Hvad det kostede os
Vores agent har over 250 værktøjer, som den bruger gennem code mode og dynamiske workers. Deres zod-definitioner alene kostede 78 MB heap ved modulindlæsning, mere end halvdelen af isolatets budget, brugt på beskrivelser af argumenter, før nogen af dem blev kaldt. Hvert værktøj, vi tilføjede, kostede yderligere ~134 KB, uanset om det værktøj nogensinde kørte.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Nulstillingerne var heller ikke gratis. Hver exceededMemory smider en igangværende agenttur væk: et nyt forsøg, et andet modelkald, en bruger, der kigger på en spinner. Ved ~300 om dagen holder det op med at være en hændelse og bliver en fast skat, og på grund af samplaceringen blev den betalt af det objekt, der tilfældigvis lå i isolatet på det tidspunkt.
Error: Durable Object's isolate exceeded its memory limit and was reset.Sådan fandt vi det: en heap-profiler til produktionsbundlet
Vi kunne ikke profilere produktion, så vi byggede en lille profiler, der kører lokalt på præcis det bundle, produktion kører. Den måler V8-heap-omkostningen ved at evaluere hvert modul og printer en rangeret tabel. Vi kørte den i et loop: profilér, fjern toppen af ranglisten, profilér igen. Den endelige kontrol for hver rettelse var et produktions-deploy sammenlignet med Cloudflares hukommelsesmetrikker på hver side af deploy-markøren.
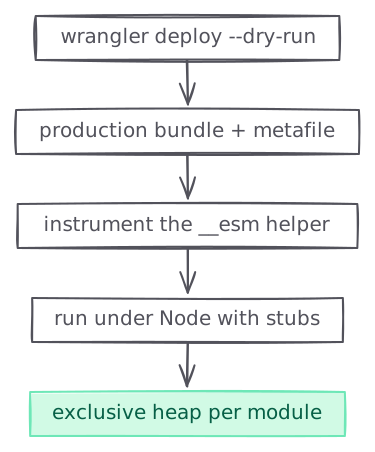
Tre ideer får det til at virke:
- Samme bundle.
wrangler deploy --dry-run --outdir --metafileudsender præcis det esbuild-bundle, et deploy ville uploade, plus dets modulgraf. Alt måles på det bundle. - Tilskrivning pr. modul. esbuild pakker lazily evaluerede moduler ind i
__esm(...)-initialiseringsclosures. Vi omskriver den ene helper i det byggede bundle, så hver modul-init registrererv8.getHeapStatistics().used_heap_sizefør og efter sig selv, med en init-stak, der adskiller et moduls egen omkostning (eksklusiv) fra dets afhængigheders (inklusiv). Resultatet er et datasæt formet som et flamegraph. - Kontrollerede kørsler. Det instrumenterede bundle kører under almindelig Node med et loader-shim, der opløser
cloudflare:*-imports til stubs.
Den komplette opskrift, klar til at sætte ind i en kodeagent, står i slutningen af dette indlæg. De zod-enhedsomkostninger, der citeres ovenfor, kommer fra et mikrobenchmark kørt gennem det samme harness.
Hvad den første profil viste
| Kilde | Eksklusiv heap |
|---|---|
packages/tools (250+ agentværktøjsdefinitioner, zod) | 78.0 MB |
| Pakke-barrels, der re-eksporterer zod-skemamoduler (rækkerne nedenfor) | ~66 MB |
durable-workspaces (workspace-tilstand og tidsplaner) | 15.6 MB |
thread-core (trådens datalag) | 10.1 MB |
durable-automations (automatiseringsdefinitioner) | 9.6 MB |
durable-threads (trådliste og live-opdateringer) | 7.3 MB |
durable-automation (én automatiseringskørsel) | 6.8 MB |
db (D1-klient og modeller) | 6.3 MB |
durable-skills (skill-definitioner) | 5.7 MB |
durable-autofixes (autofix-branches og -merges) | 4.9 MB |
| 12 mindre pakker | ~9 MB |
Den anden række er den overraskende. Det er skemaer, der kun når bundlet gennem export * from "./zod" i pakke-barrels. Vores kode brugte dem aldrig, tree shakeren kunne ikke fjerne dem, og de kostede en tredjedel af hukommelsesgrænsen, alt sammen i moduler, som intet nogensinde kaldte.
Rettelse A: værktøjsdefinitioner som data, ikke kode
Hver værktøjsdefinition erklærede sit inputskema i zod og konverterede det til JSON-skema ved kørsel, fordi JSON-skema alligevel er det, modellen får sendt. Vi byggede ~134 KB closures pr. værktøj for at producere nogle få hundrede bytes data, så vi skrev dataene direkte.
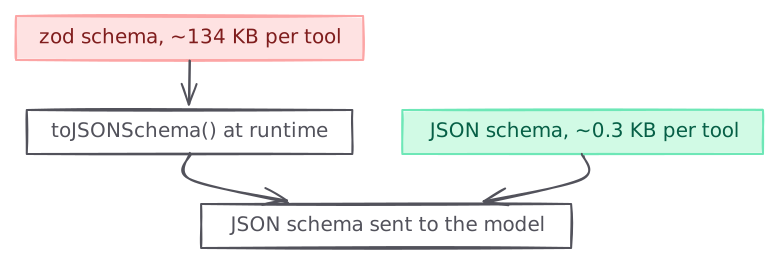
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters er en tynd wrapper over AI SDK’s jsonSchema(). ParametersInput er json-schema-to-ts, der laver den typeinferens, zod plejede at lave. Validering ved kørsel flyttede til en validator på ~300 linjer, der genskaber de egenskaber, agentloopet afhænger af: ukendte nøgler fjernes, standardværdier udfyldes, unions opløses efter diskriminator, og fejlbeskeder er formuleret, så modellen kan reparere sit eget værktøjskald ved næste forsøg.
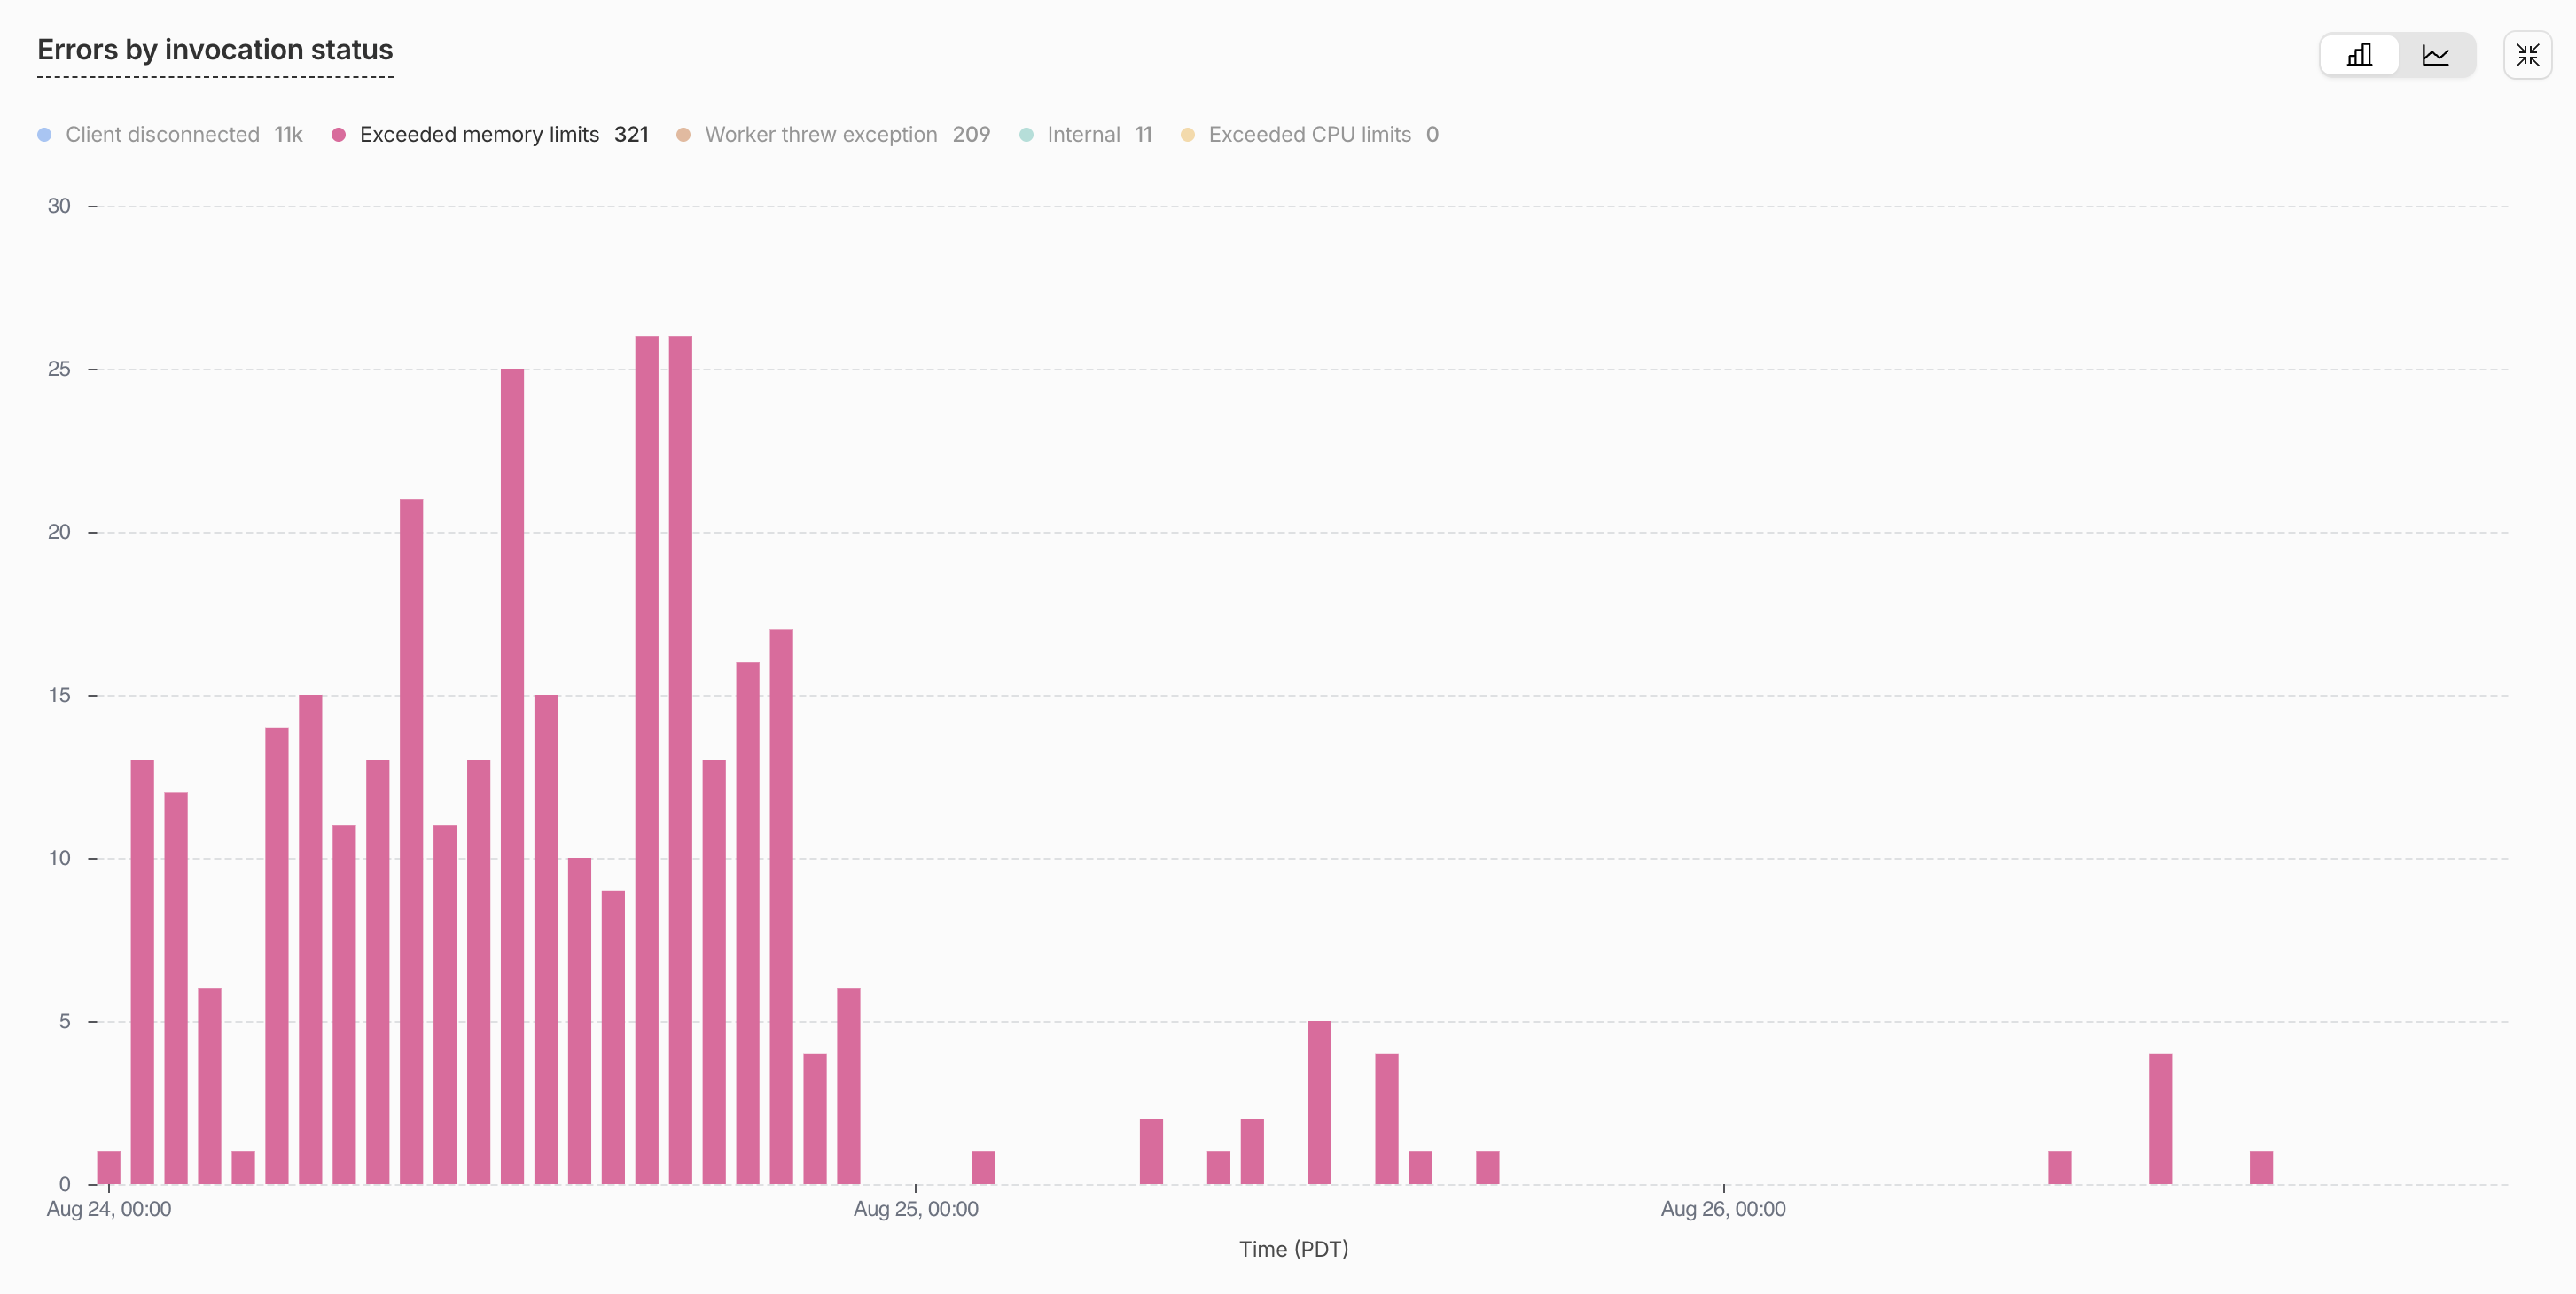
Heap ved modulevaluering gik fra 218.6 til 154.0 MB lokalt, og packages/tools fra 78 MB til 0.7 MB. I produktion faldt nulstillingerne fra 40-110 i timen til 0-6 i timen ved deploy-markøren, og median-isolatets hukommelse fra ~140 MB til ~120 MB.
Rettelse B: barrels, der faktisk kan tree-shakes
De resterende ~66 MB var skemaer, isolatet aldrig brugte. Tre bundler-adfærd forklarer det:
- Uden
"sideEffects": falsei en pakkespackage.jsonbeskærer esbuild intet fra den. - Selv med flaget beskæres
export * from "./zod"aldrig inde i et lazily evalueret modul, og alt, der kan nås gennem et dynamiskimport(), evalueres lazily. Navngivne re-eksporter (export { zFoo } from "./zod") beskæres fint. await import("@scope/package")materialiserer pakkens hele namespace-objekt og markerer hver eksport som brugt: skemaer, klasser, alt.
Vi bekræftede hver af disse med en fixture på fem filer bygget med den esbuild-version, wrangler indlejrer: en entry, en pakke med en index.ts-barrel, en zod.ts med ét skema, hvis constructor melder, når den kører, en do.ts-klasse, der importerer det skema, og et lazy mellemled imellem. Tabellen registrerer, om skemaets constructor kørte ved evaluering for hver kombination.
| Entry importerer barrel via | Barrelens re-eksportform | sideEffects: false | Skema inkluderet |
|---|---|---|---|
| Statisk import | export * | Ja | Nej |
| Statisk import | export * | Nej | Ja |
Dynamisk import() af pakken | Enhver | Ja | Ja |
| Statisk import fra et lazily indlæst modul | export * | Ja | Ja |
| Statisk import fra et lazily indlæst modul | Navngiven liste | Ja | Nej |
| Enhver | Navngiven liste | Nej | Ja |
Række 3 og 4 er de to, der overrasker folk, og tilsammen stod de for de ~66 MB. Her er, hvad én barrel gjorde ved os:
Rettelsen er mekanisk: "sideEffects": false i alle 110+ workspace-pakker, omskriv barrelenes export * til navngivne re-eksportlister, og erstat await import("@scope/package") af pakkerødder med statiske navngivne imports.
En ablation på det rigtige produktionsbundle viser, at hver del er nødvendig.
| Konfiguration | Heap efter modulevaluering | Skemamoduler i bundlet |
|---|---|---|
| Baseline (efter rettelse A) | 154.0 MB | 77 |
sideEffects: false alene | 143.6 MB | 77 |
+ Statiske imports, barrels tilbage til export * (kontrol) | 98.6 MB | 29 |
| + Navngivne re-eksportlister (fuld rettelse) | 82.1 MB | 0 |
Kontrolrækken er den interessante: selv en fuldt statisk importgraf beholder 29 skemamoduler, så de navngivne lister er ikke valgfrie.
Sluttilstanden
| Heap på modulniveau (lokal probe) | Medianhukommelse i produktion | Nulstillinger i produktion | |
|---|---|---|---|
| Før | 218.6 MB | ~140 MB | ~300/dag |
| Efter A | 154.0 MB | ~120 MB | ~10/dag |
| Efter A+B | 82.1 MB | ~70 MB | 0 |
Et Durable Object, der lå i tomgang over platformens hukommelsesgrænse, ligger nu i tomgang på knap halvdelen af den, og de ~300 daglige nulstillinger er væk.
Det her er ikke et konfigurationsflag
At omskrive mere end 250 værktøjsdefinitioner fra zod til råt JSON-skema og skrive en validator på 300 linjer til at erstatte det, zod gjorde for os, tog nogle dage, selv med kodeagenter. At tilføje sideEffects: false til over 100 pakker og gøre hvert export * til en genereret navngiven liste er utaknemmeligt arbejde, og bagefter typechecker du hele repositoryet og retter det, der går i stykker. Det nemme alternativ er at tilføje et nyt forsøg og leve med nulstillingerne, og det gør mange teams. Hvis dit Durable Object er nogenlunde tæt på grænsen i tomgang, vil jeg påstå, at ugen er værd at bruge, fordi grænsen ikke flytter sig, og dit antal værktøjer kun går op.
De tre ting, jeg gerne ville have vidst fra dag ét:
- Høj og flad i tomgang betyder baseline. Profilér det, du leverer, ikke det, du betjener.
- Tree shaking har regler.
sideEffects: false, navngivne re-eksporter, statiske imports. Overser du én, kommer hele pakken med. - Skemaer er kode, ikke typer. Hvis forbrugeren vil have JSON-skema, så skriv JSON-skema.
Gør det her i dag for at få styr på dit Durable Objects hukommelse
Profileren er ~100 linjer uden andre afhængigheder end Node og wrangler. Sæt opskriften nedenfor ind i din kodeagent i roden af et hvilket som helst repository, der deployer med wrangler, læs de ti øverste rækker i den tabel, den printer, og se, hvad der er. Arbejd så ned gennem listen: almindeligt JSON-skema for alt, modellen alligevel modtager som JSON-skema, "sideEffects": false og navngivne re-eksporter for barrels, statiske imports for pakkerødderne.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Hvis du vil have hele auditten gjort for dig, er her en skill til din kodeagent:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Vi har også føjet denne skill til Polylane selv, så hver Polylane-bruger får denne dybe undersøgelse af deres Durable Object-hukommelse ud af boksen, uden noget at sætte ind.