

Comment nous avons corrigé les erreurs de dépassement mémoire de nos Cloudflare Durable Objects
Explore with AI
Chaque thread d’agent dans Polylane tourne à l’intérieur de son propre Cloudflare Durable Object, tous instances d’une seule classe. En août 2026, les Durable Objects de nos threads étaient réinitialisés environ 300 fois par jour pour dépassement de la limite mémoire. Nous avons entendu la même histoire de plusieurs équipes qui font tourner leurs flux agentiques sur des Cloudflare Durable Objects.
Si tu as rencontré exceededMemory sur un Durable Object, le conseil habituel est de regarder ce que tes requêtes allouent : une charge utile trop grosse, un historique de chat qui grandit sans limite, un cache qui n’évince jamais. Rien de tout cela ne s’appliquait à nous. L’isolate dépassait la limite avant de servir une seule requête, le poids devait donc se trouver dans le code que nous livrions plutôt que dans les données que nous servions.
Cet article raconte ce qu’il y avait vraiment dans le heap, comment nous l’avons trouvé sur une plateforme qui ne permet pas d’attacher un profileur, et les deux changements qui ont fait passer la mémoire au niveau des modules de 218 MB à 82 MB et les réinitialisations à zéro.
Les Cloudflare Durable Objects en une minute
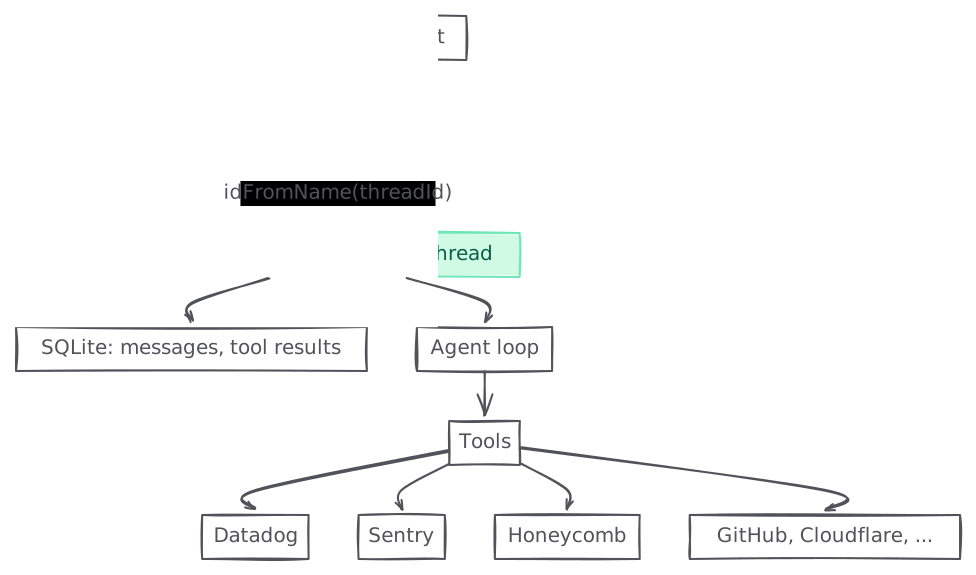
Si tu ne les as jamais utilisés : un Durable Object est un petit serveur avec état, mono-thread, dont Cloudflare garantit l’unicité pour un identifiant donné. Appelle idFromName() avec cet identifiant depuis un Worker et chaque requête qui le concerne, d’où qu’elle vienne dans le monde, atterrit sur la même instance, avec sa propre base SQLite, son état en mémoire et ses alarmes. Il hiberne quand il est inactif et se réveille là où il s’était arrêté.
Dans Polylane, nous créons une instance de Durable Object pour chaque thread. Chaque conversation avec l’agent, qu’une personne l’ait démarrée ou qu’une alerte l’ait fait, reçoit son propre Durable Object. Le SQLite de l’objet contient les messages du thread et les résultats des outils, la boucle d’agent tourne à l’intérieur, et ses outils appellent les fournisseurs dont le thread a besoin : Datadog, Sentry, Honeycomb, GitHub, Cloudflare et les autres. Quand le thread se tait, l’objet hiberne, et quand le message suivant arrive, il reprend exactement où il s’était arrêté.
Comment fonctionne la mémoire des Durable Objects
- Les isolates et le plafond de 128 MB. Les Durable Objects tournent dans des isolates V8, et un isolate a une limite mémoire dure de 128 MB, la même sur tous les forfaits et non configurable.
- La colocation. Un seul isolate héberge de nombreux Durable Objects de la même classe, avec le code du Worker autour d’eux, et ils partagent tous la mémoire de cet isolate. La limite est par isolate plutôt que par objet.
- Les voisins bruyants. À cause de la colocation, l’objet qui est réinitialisé quand l’isolate manque de mémoire n’est souvent pas l’objet qui a utilisé la mémoire. Chaque échantillon de mémoire que Cloudflare rapporte concerne l’isolate entier, et chaque réinitialisation aussi.
Il n’y a aucun moyen d’attacher un profileur mémoire à un Durable Object en production : l’outillage de heap snapshot que Cloudflare documente s’exécute contre une session de développement locale. Dans Kubernetes, tu activerais le profilage et tu t’attacherais jusqu’à trouver le problème. Dans workerd, process.memoryUsage() est un polyfill unenv qui renvoie des zéros, et les chiffres de mémoire et de CPU de base ne sont pas visibles pour le code qui tourne à l’intérieur. Ce que tu obtiens, c’est l’API d’analytics GraphQL de Cloudflare : des percentiles de mémoire et des comptes de plantages par namespace, après coup.
Ce que le graphique de mémoire nous a dit
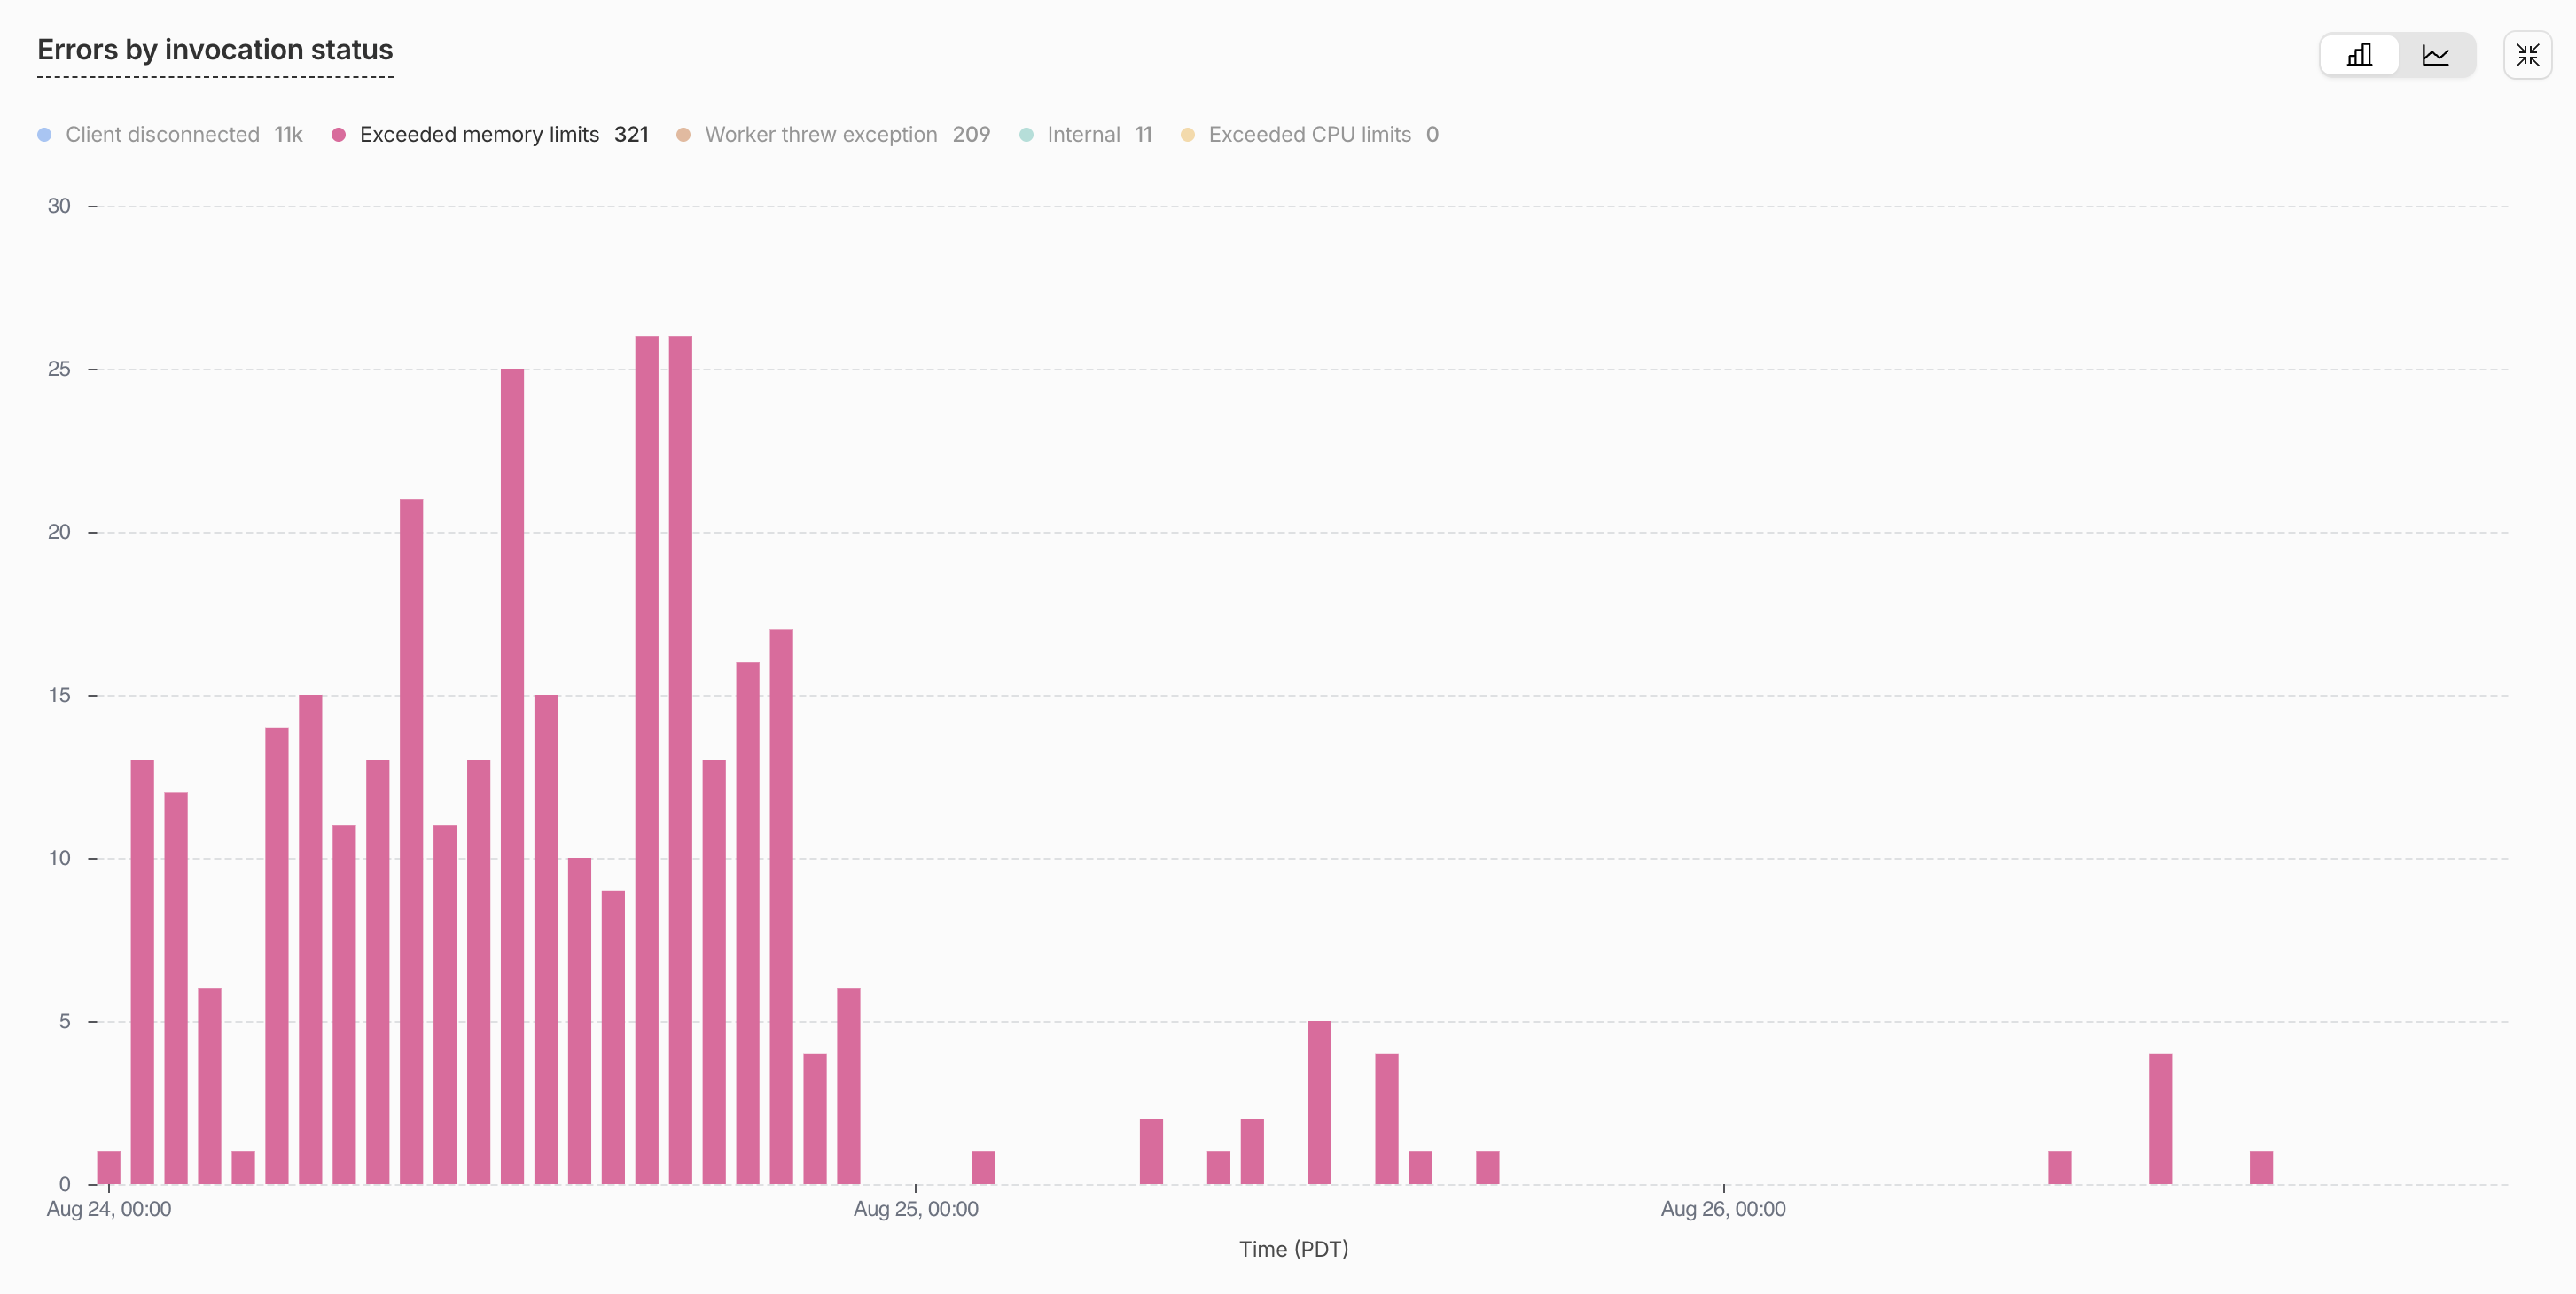
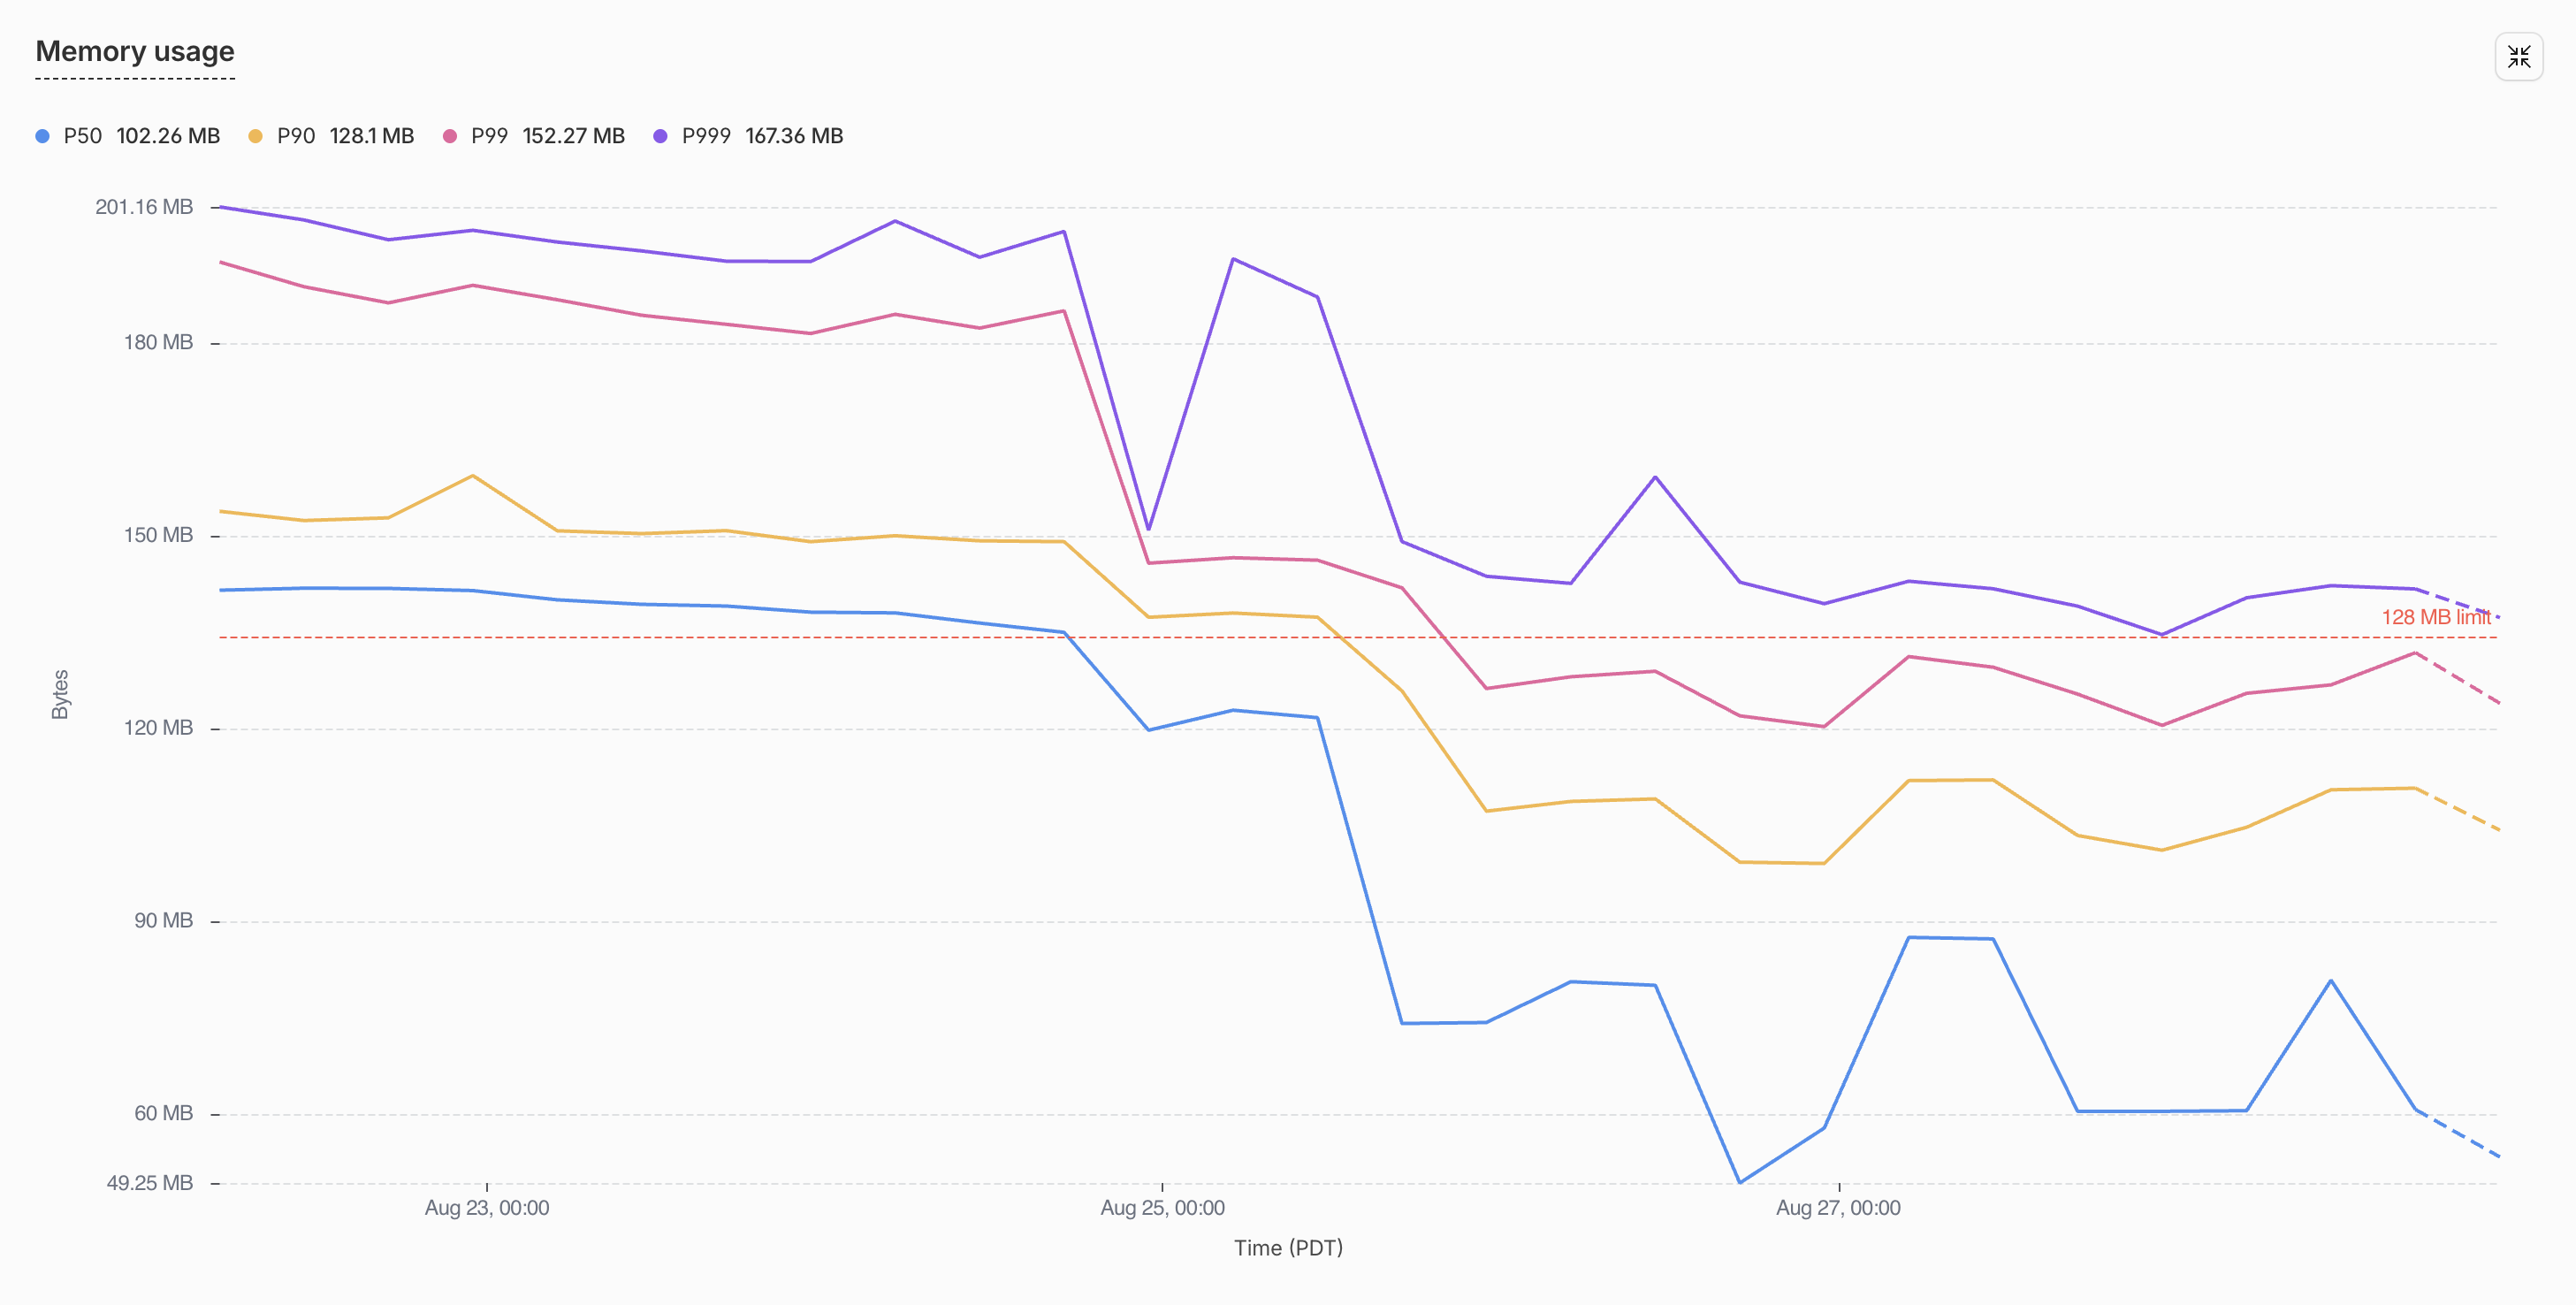
L’API d’analytics de Cloudflare rapporte la mémoire d’un namespace de Durable Objects sous forme de percentiles à travers les isolates qui le font tourner, par tranches de quinze minutes, avec le nombre d’erreurs de dépassement mémoire dans chaque tranche. Chaque graphique de cet article vient de cette API, filtrée sur le namespace des threads et comparée autour des marqueurs de déploiement une fois que nous avons commencé à livrer des correctifs.
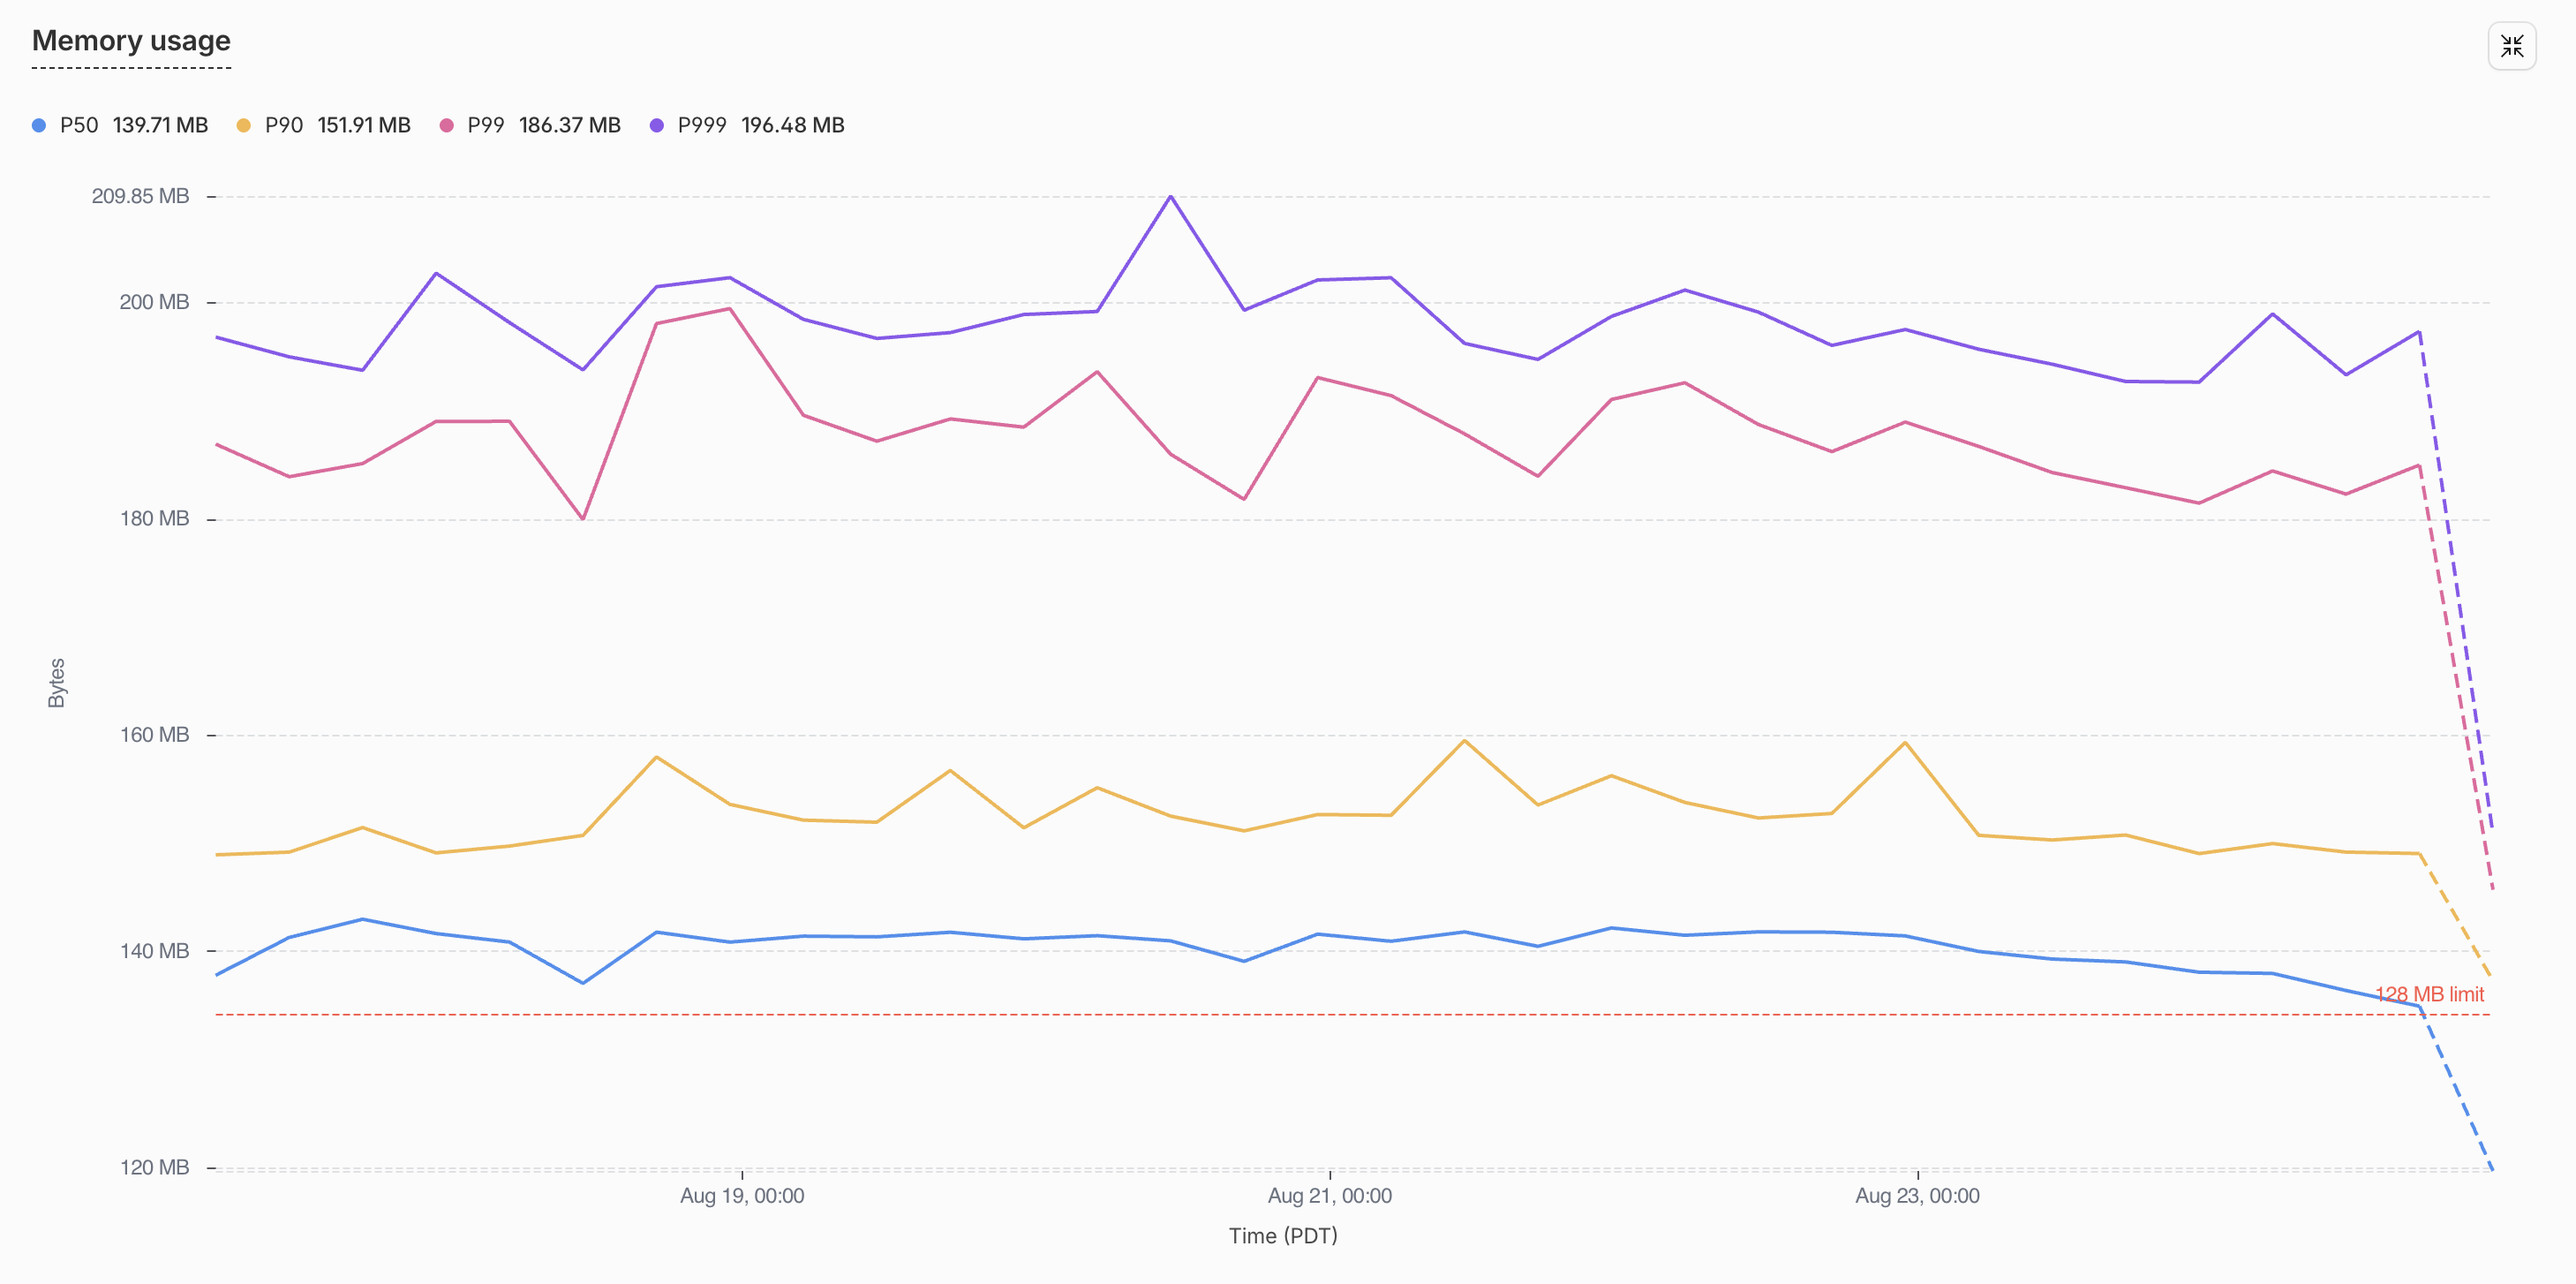
L’isolate médian, la ligne bleue de la figure 1, est resté à environ 140 MB pendant toute la semaine, et le 99e percentile proche de 190 MB. Les deux lignes sont au-dessus de la limite en pointillés de 128 MB, ce qui veut dire que l’isolate typique du namespace avait déjà dépassé le point où Cloudflare est en droit de le réinitialiser, et n’était épargné que jusqu’à ce que l’allocation suivante le fasse basculer. Ce que le graphique ne montrait pas, c’était une quelconque relation avec le trafic. La ligne était aussi plate pendant les heures calmes que pendant les heures chargées, et aucune des quelque 300 réinitialisations quotidiennes ne venait avec une stack trace, parce que ce n’était jamais notre code qui levait l’erreur.
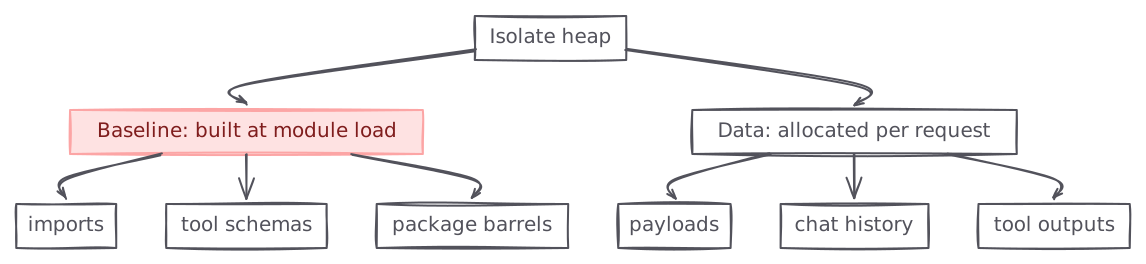
Nous avons regardé là où on regarde en premier. Nous avons lu les tailles des charges utiles, vérifié comment l’historique de chat était tronqué, et cherché un motif de requêtes dans la courbe de mémoire, sans rien trouver qui fasse bouger la ligne. Cette platitude s’est avérée être l’indice important. La mémoire d’un isolate est l’une de deux choses : ce sont des données, c’est-à-dire les charges utiles des requêtes, l’historique de chat, les sorties d’outils et tout ce qui est alloué en servant du trafic, ou c’est de la base, c’est-à-dire les objets que le code lui-même crée quand un module se charge et garde en vie pendant toute la durée de l’isolate, comme les imports, les fonctions et les schémas. Les données montent et descendent avec les requêtes, alors que la base est là avant la première requête et ne disparaît jamais, donc un graphique haut et plat au repos décrit la base. Le problème devait se trouver dans ce que nous livrions plutôt que dans ce que nous servions.
Pourquoi la mémoire de base est si facile à manquer
La mémoire de base se cache à deux endroits où tu ne regardes pas d’habitude.
Le premier est le bundler. Nous supposons que le tree shaking retire le code que nous n’utilisons pas, et c’est en grande partie vrai, mais esbuild a des règles sur les moments où il peut élaguer, et ce ne sont pas celles que tu devinerais. Un package sans "sideEffects": false dans son package.json n’est jamais élagué du tout. Un export * à l’intérieur d’un module évalué paresseusement n’est jamais élagué non plus. Un import() dynamique de la racine d’un package marque chaque export comme utilisé. Nous reviendrons sur chacun de ces points dans les correctifs, parce qu’ils expliquent la moitié des 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Le second est la bibliothèque de schémas. Les types semblent gratuits parce qu’ils disparaissent à la compilation, mais un schéma zod n’est pas un type, c’est un arbre de closures construit au moment où son module s’évalue. Un schéma d’objet zod 4 de taille moyenne, une douzaine de champs avec descriptions et raffinements, coûte ~134 KB de heap. Un simple z.string() coûte ~12 KB. L’objet JSON schema équivalent coûte quelques centaines d’octets. Rien de tout cela n’est dans le README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Nous n’avions rien fait d’exotique
Chacun de nos problèmes venait d’un comportement par défaut. Chaque outil d’agent déclarait son entrée avec z.object() au niveau du module, parce que c’est comme ça que la documentation le fait. Chaque package interne avait un barrel index.ts avec export * from "./zod", parce que c’est propre. Quelques chemins utilisaient await import("@scope/package") parce que le chargement paresseux est censé être moins cher. Chacun est un choix raisonnable pris isolément. Ensemble, ils faisaient 130 MB, dans un isolate qui en a 128 à dépenser.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Ce que ça nous coûtait
Notre agent a plus de 250 outils, qu’il utilise via le code mode et des workers dynamiques. Leurs définitions zod à elles seules coûtaient 78 MB de heap au chargement des modules, plus de la moitié du budget de l’isolate, dépensés en descriptions d’arguments avant qu’aucun d’eux ne soit appelé. Chaque outil que nous ajoutions coûtait ~134 KB de plus, que cet outil tourne un jour ou non.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Les réinitialisations n’étaient pas gratuites non plus. Chaque exceededMemory jette un tour d’agent en cours : une nouvelle tentative, un second appel au modèle, un utilisateur qui regarde un spinner. À ~300 par jour, ça cesse d’être un incident et devient une taxe permanente, et à cause de la colocation, elle était payée par l’objet qui se trouvait par hasard dans l’isolate à ce moment-là.
Error: Durable Object's isolate exceeded its memory limit and was reset.Comment nous l’avons trouvé : un profileur de heap pour le bundle de production
Nous ne pouvions pas profiler la production, alors nous avons construit un petit profileur qui tourne localement sur le bundle exact que la production exécute. Il mesure le coût en heap V8 de l’évaluation de chaque module et affiche un tableau classé. Nous l’avons fait tourner en boucle : profiler, retirer le haut du classement, profiler à nouveau. La vérification finale de chaque correctif était un déploiement en production comparé aux métriques de mémoire de Cloudflare de part et d’autre du marqueur de déploiement.
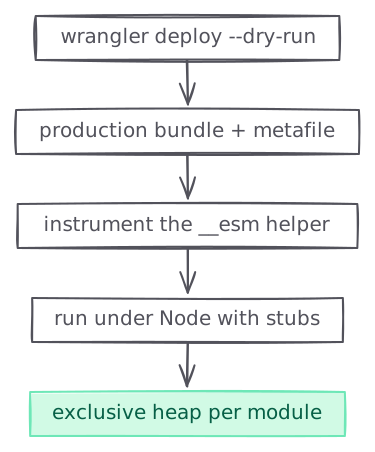
Trois idées le font fonctionner :
- Le même bundle.
wrangler deploy --dry-run --outdir --metafileproduit le bundle esbuild exact qu’un déploiement enverrait, plus son graphe de modules. Tout est mesuré sur ce bundle. - L’attribution par module. esbuild enveloppe les modules évalués paresseusement dans des closures d’initialisation
__esm(...). Nous réécrivons ce seul helper dans le bundle construit pour que chaque init de module enregistrev8.getHeapStatistics().used_heap_sizeavant et après lui-même, avec une pile d’init qui sépare le coût propre d’un module (exclusif) de celui de ses dépendances (inclusif). Le résultat est un jeu de données en forme de flamegraph. - Des exécutions contrôlées. Le bundle instrumenté tourne sous un Node ordinaire avec un shim de loader qui résout les imports
cloudflare:*vers des stubs.
La recette complète, prête à coller dans un agent de codage, est à la fin de cet article. Les coûts unitaires de zod cités plus haut viennent d’un micro-benchmark passé par le même harnais.
Ce que le premier profil a montré
| Source | Heap exclusif |
|---|---|
packages/tools (plus de 250 définitions d’outils d’agent, zod) | 78.0 MB |
| Barrels de packages réexportant des modules de schémas zod (lignes ci-dessous) | ~66 MB |
durable-workspaces (état et planifications des espaces de travail) | 15.6 MB |
thread-core (couche de données des threads) | 10.1 MB |
durable-automations (définitions d’automatisations) | 9.6 MB |
durable-threads (liste des threads et mises à jour en direct) | 7.3 MB |
durable-automation (un run d’automatisation) | 6.8 MB |
db (client D1 et modèles) | 6.3 MB |
durable-skills (définitions de skills) | 5.7 MB |
durable-autofixes (branches et fusions d’autofix) | 4.9 MB |
| 12 packages plus petits | ~9 MB |
La deuxième ligne est celle qui surprend. Ce sont des schémas qui n’atteignent le bundle que par export * from "./zod" dans des barrels de packages. Notre code ne les utilisait jamais, le tree shaker ne pouvait pas les retirer, et ils coûtaient un tiers de la limite mémoire, tout cela dans des modules que rien n’appelait jamais.
Correctif A : des définitions d’outils comme données, pas comme code
Chaque définition d’outil déclarait son schéma d’entrée en zod et le convertissait en JSON schema à l’exécution, parce que le JSON schema est de toute façon ce qu’on envoie au modèle. Nous construisions ~134 KB de closures par outil pour produire quelques centaines d’octets de données, alors nous avons écrit les données directement.
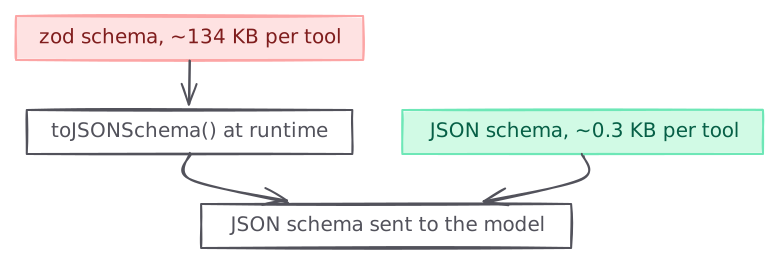
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters est une fine enveloppe autour du jsonSchema() de l’AI SDK. ParametersInput, c’est json-schema-to-ts qui fait l’inférence de types que zod faisait auparavant. La validation à l’exécution est passée dans un validateur d’environ 300 lignes qui reproduit les propriétés dont la boucle d’agent dépend : clés inconnues retirées, valeurs par défaut remplies, unions résolues par discriminant, et messages d’erreur formulés pour que le modèle puisse réparer son propre appel d’outil à la tentative suivante.
Le heap à l’évaluation des modules est passé de 218.6 à 154.0 MB en local, et packages/tools de 78 MB à 0.7 MB. En production, les réinitialisations sont tombées de 40 à 110 par heure à 0 à 6 par heure au marqueur de déploiement, et la mémoire de l’isolate médian de ~140 MB à ~120 MB.
Correctif B : des barrels qui peuvent vraiment être tree-shakés
Les ~66 MB restants étaient des schémas que l’isolate n’utilisait jamais. Trois comportements du bundler l’expliquent :
- Sans
"sideEffects": falsedans lepackage.jsond’un package, esbuild n’en élague rien. - Même avec le flag,
export * from "./zod"n’est jamais élagué à l’intérieur d’un module évalué paresseusement, et tout ce qui est atteignable via unimport()dynamique est évalué paresseusement. Les réexports nommés (export { zFoo } from "./zod") sont élagués sans problème. await import("@scope/package")matérialise l’objet namespace entier du package, marquant chaque export comme utilisé : schémas, classes, tout.
Nous avons confirmé chacun de ces points avec une fixture de cinq fichiers construite avec la version d’esbuild que wrangler embarque : une entrée, un package avec un barrel index.ts, un zod.ts contenant un schéma dont le constructeur annonce quand il s’exécute, une classe do.ts important ce schéma, et un intermédiaire paresseux entre eux. Le tableau enregistre si le constructeur du schéma s’est exécuté à l’évaluation pour chaque combinaison.
| L’entrée importe le barrel via | Forme du réexport du barrel | sideEffects: false | Schéma inclus |
|---|---|---|---|
| Import statique | export * | Oui | Non |
| Import statique | export * | Non | Oui |
import() dynamique du package | Toute | Oui | Oui |
| Import statique depuis un module chargé paresseusement | export * | Oui | Oui |
| Import statique depuis un module chargé paresseusement | Liste nommée | Oui | Non |
| Tout | Liste nommée | Non | Oui |
Les lignes 3 et 4 sont les deux qui surprennent, et ensemble elles expliquaient les ~66 MB. Voici ce qu’un seul barrel nous faisait :
Le correctif est mécanique : "sideEffects": false dans les 110 packages et plus de l’espace de travail, réécrire les export * des barrels en listes de réexports nommés, et remplacer les await import("@scope/package") de racines de packages par des imports nommés statiques.
Une ablation sur le vrai bundle de production montre que chaque pièce est nécessaire.
| Configuration | Heap après l’évaluation des modules | Modules de schémas dans le bundle |
|---|---|---|
| Base (après le correctif A) | 154.0 MB | 77 |
sideEffects: false seul | 143.6 MB | 77 |
+ Imports statiques, barrels revenus à export * (contrôle) | 98.6 MB | 29 |
| + Listes de réexports nommés (correctif complet) | 82.1 MB | 0 |
La ligne de contrôle est la plus intéressante : même un graphe d’imports entièrement statique conserve 29 modules de schémas, les listes nommées ne sont donc pas facultatives.
L’état final
| Heap au niveau des modules (sonde locale) | Mémoire médiane en production | Réinitialisations en production | |
|---|---|---|---|
| Avant | 218.6 MB | ~140 MB | ~300/jour |
| Après A | 154.0 MB | ~120 MB | ~10/jour |
| Après A+B | 82.1 MB | ~70 MB | 0 |
Un Durable Object qui tournait au repos au-dessus de la limite mémoire de la plateforme tourne maintenant au repos à peine à la moitié, et les ~300 réinitialisations quotidiennes ont disparu.
Ce n’est pas un flag de configuration
Réécrire plus de 250 définitions d’outils de zod vers du JSON schema brut, et écrire un validateur de 300 lignes pour remplacer ce que zod faisait pour nous, a pris quelques jours, même avec des agents de codage. Ajouter sideEffects: false à plus de 100 packages et transformer chaque export * en liste nommée générée est un travail ingrat, et tu typecheckes tout le dépôt ensuite et tu corriges ce qui casse. L’alternative facile est d’ajouter une nouvelle tentative et de vivre avec les réinitialisations, et beaucoup d’équipes le font. Si ton Durable Object est ne serait-ce que proche de la limite au repos, je dirais que la semaine en vaut la peine, parce que la limite ne bouge pas et que ton nombre d’outils ne fait qu’augmenter.
Les trois choses que j’aurais voulu savoir dès le premier jour :
- Haut et plat au repos veut dire base. Profile ce que tu livres, pas ce que tu sers.
- Le tree shaking a des règles.
sideEffects: false, réexports nommés, imports statiques. Manque un seul point et tout le package embarque. - Les schémas sont du code, pas des types. Si le consommateur veut du JSON schema, écris du JSON schema.
Fais ceci aujourd’hui pour corriger la mémoire de ton Durable Object
Le profileur fait ~100 lignes sans autre dépendance que Node et wrangler. Colle la recette ci-dessous dans ton agent de codage à la racine de n’importe quel dépôt qui déploie avec wrangler, lis les dix premières lignes du tableau qu’il affiche, et regarde ce qu’il y a. Puis descends la liste : du JSON schema brut pour tout ce que le modèle reçoit de toute façon en JSON schema, "sideEffects": false et des réexports nommés pour les barrels, des imports statiques pour les racines de packages.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Si tu veux que tout l’audit soit fait pour toi, voici un skill pour ton agent de codage :
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Nous avons aussi ajouté ce skill à Polylane lui-même, pour que chaque utilisateur de Polylane bénéficie d’office de cette enquête approfondie sur la mémoire de ses Durable Objects, sans rien à coller.