

CloudflareのDurable Objectsで起きたメモリー超過エラーをどう直したか
Explore with AI
Polylaneのすべてのエージェントスレッドは、それぞれ自分のCloudflare Durable Objectの中で動き、そのすべてが1つのクラスのインスタンスです。2026年8月、私たちのスレッドのDurable Objectsは、メモリー上限の超過により1日に約300回リセットされていました。CloudflareのDurable Objects上でエージェント的なフローを動かしている複数のチームから、同じ話を聞きました。
Durable ObjectでexceededMemoryに遭遇したとき、よくある助言はリクエストが何を確保しているかを見ることです。大きすぎるペイロード、際限なく育つチャット履歴、決して追い出さないキャッシュ。そのどれも私たちには当てはまりませんでした。アイソレートはリクエストを1つも処理する前に上限を超えていたので、重さは配信しているデータではなく、出荷しているコードの中にあるはずでした。
この記事は、ヒープの中に実際に何があったのか、プロファイラーを接続させてくれないプラットフォームでそれをどう見つけたのか、そしてモジュールスコープのメモリーを218 MBから82 MBへ、リセットをゼロへ導いた2つの変更についてです。
1分で分かるCloudflare Durable Objects
使ったことがない方のために。Durable Objectは、あるIDに対して唯一であることをCloudflareが保証する、小さく、状態を持つ、シングルスレッドのサーバーです。WorkerからそのIDでidFromName()を呼ぶと、世界中どこから来たリクエストでも同じインスタンスに着地し、そのインスタンスは自分のSQLiteデータベース、インメモリーの状態、アラームを持ちます。アイドル時には休止し、中断した場所から目を覚まします。
Polylaneでは、スレッドごとにDurable Objectのインスタンスを作ります。人が始めた会話でもアラートが始めた会話でも、エージェントとのすべての会話が自分のDurable Objectを持ちます。オブジェクトのSQLiteがスレッドのメッセージとツールの結果を保持し、その中でエージェントループが動き、ツールはスレッドが必要とするプロバイダーを呼び出します。Datadog、Sentry、Honeycomb、GitHub、Cloudflare、その他です。スレッドが静かになるとオブジェクトは休止し、次のメッセージが届くと止まった場所から正確に再開します。
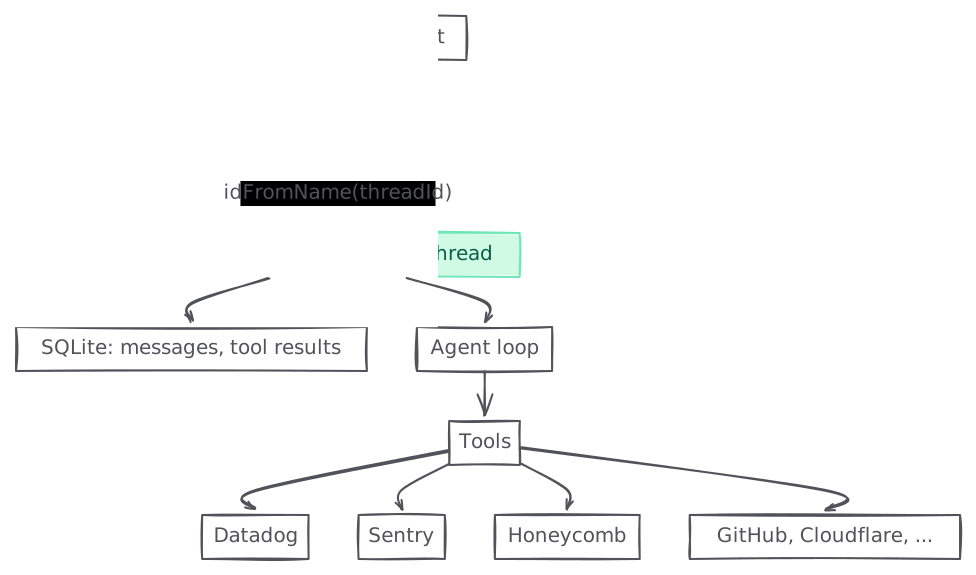
Durable Objectsのメモリーの仕組み
- **アイソレートと128 MBの上限。**Durable ObjectsはV8アイソレートの中で動き、アイソレートには128 MBの固定メモリー上限があります。これはすべてのプランで同じで、設定で変えられません。
- 同居。1つのアイソレートは同じクラスの多数のDurable Objectsをホストし、その周りのWorkerのコードも一緒に載り、すべてがそのアイソレートのメモリーを共有します。上限はオブジェクトごとではなくアイソレートごとです。
- **騒がしい隣人。**同居のため、アイソレートがメモリーを使い切ったときにリセットされるオブジェクトは、メモリーを使ったオブジェクトではないことがよくあります。Cloudflareが報告するすべてのメモリーのサンプルはアイソレート全体のもので、すべてのリセットも同様です。
本番のDurable Objectにメモリープロファイラーを接続する方法はありません。Cloudflareがドキュメントに載せているヒープスナップショットのツールはローカルの開発セッションに対して動くものです。Kubernetesなら、プロファイリングを有効にして問題が見つかるまで接続しておくでしょう。workerdでは、process.memoryUsage()はゼロを返すunenvのポリフィルで、ベースラインのメモリーとCPUの数値は中で動くコードには見えません。手に入るのはCloudflareのGraphQLアナリティクスAPIです。ネームスペースごとのメモリーのパーセンタイルとクラッシュ数を、事後に。
メモリーのグラフが教えてくれたこと
CloudflareのアナリティクスAPIは、Durable Objectのネームスペースのメモリーを、それを動かしているアイソレート全体のパーセンタイルとして15分のバケットで報告し、各バケットのメモリー超過エラーの数も併せて返します。この記事のすべてのグラフはそのAPIから来たもので、スレッドのネームスペースで絞り込み、修正を出荷し始めてからはデプロイのマーカーをまたいで比較しています。
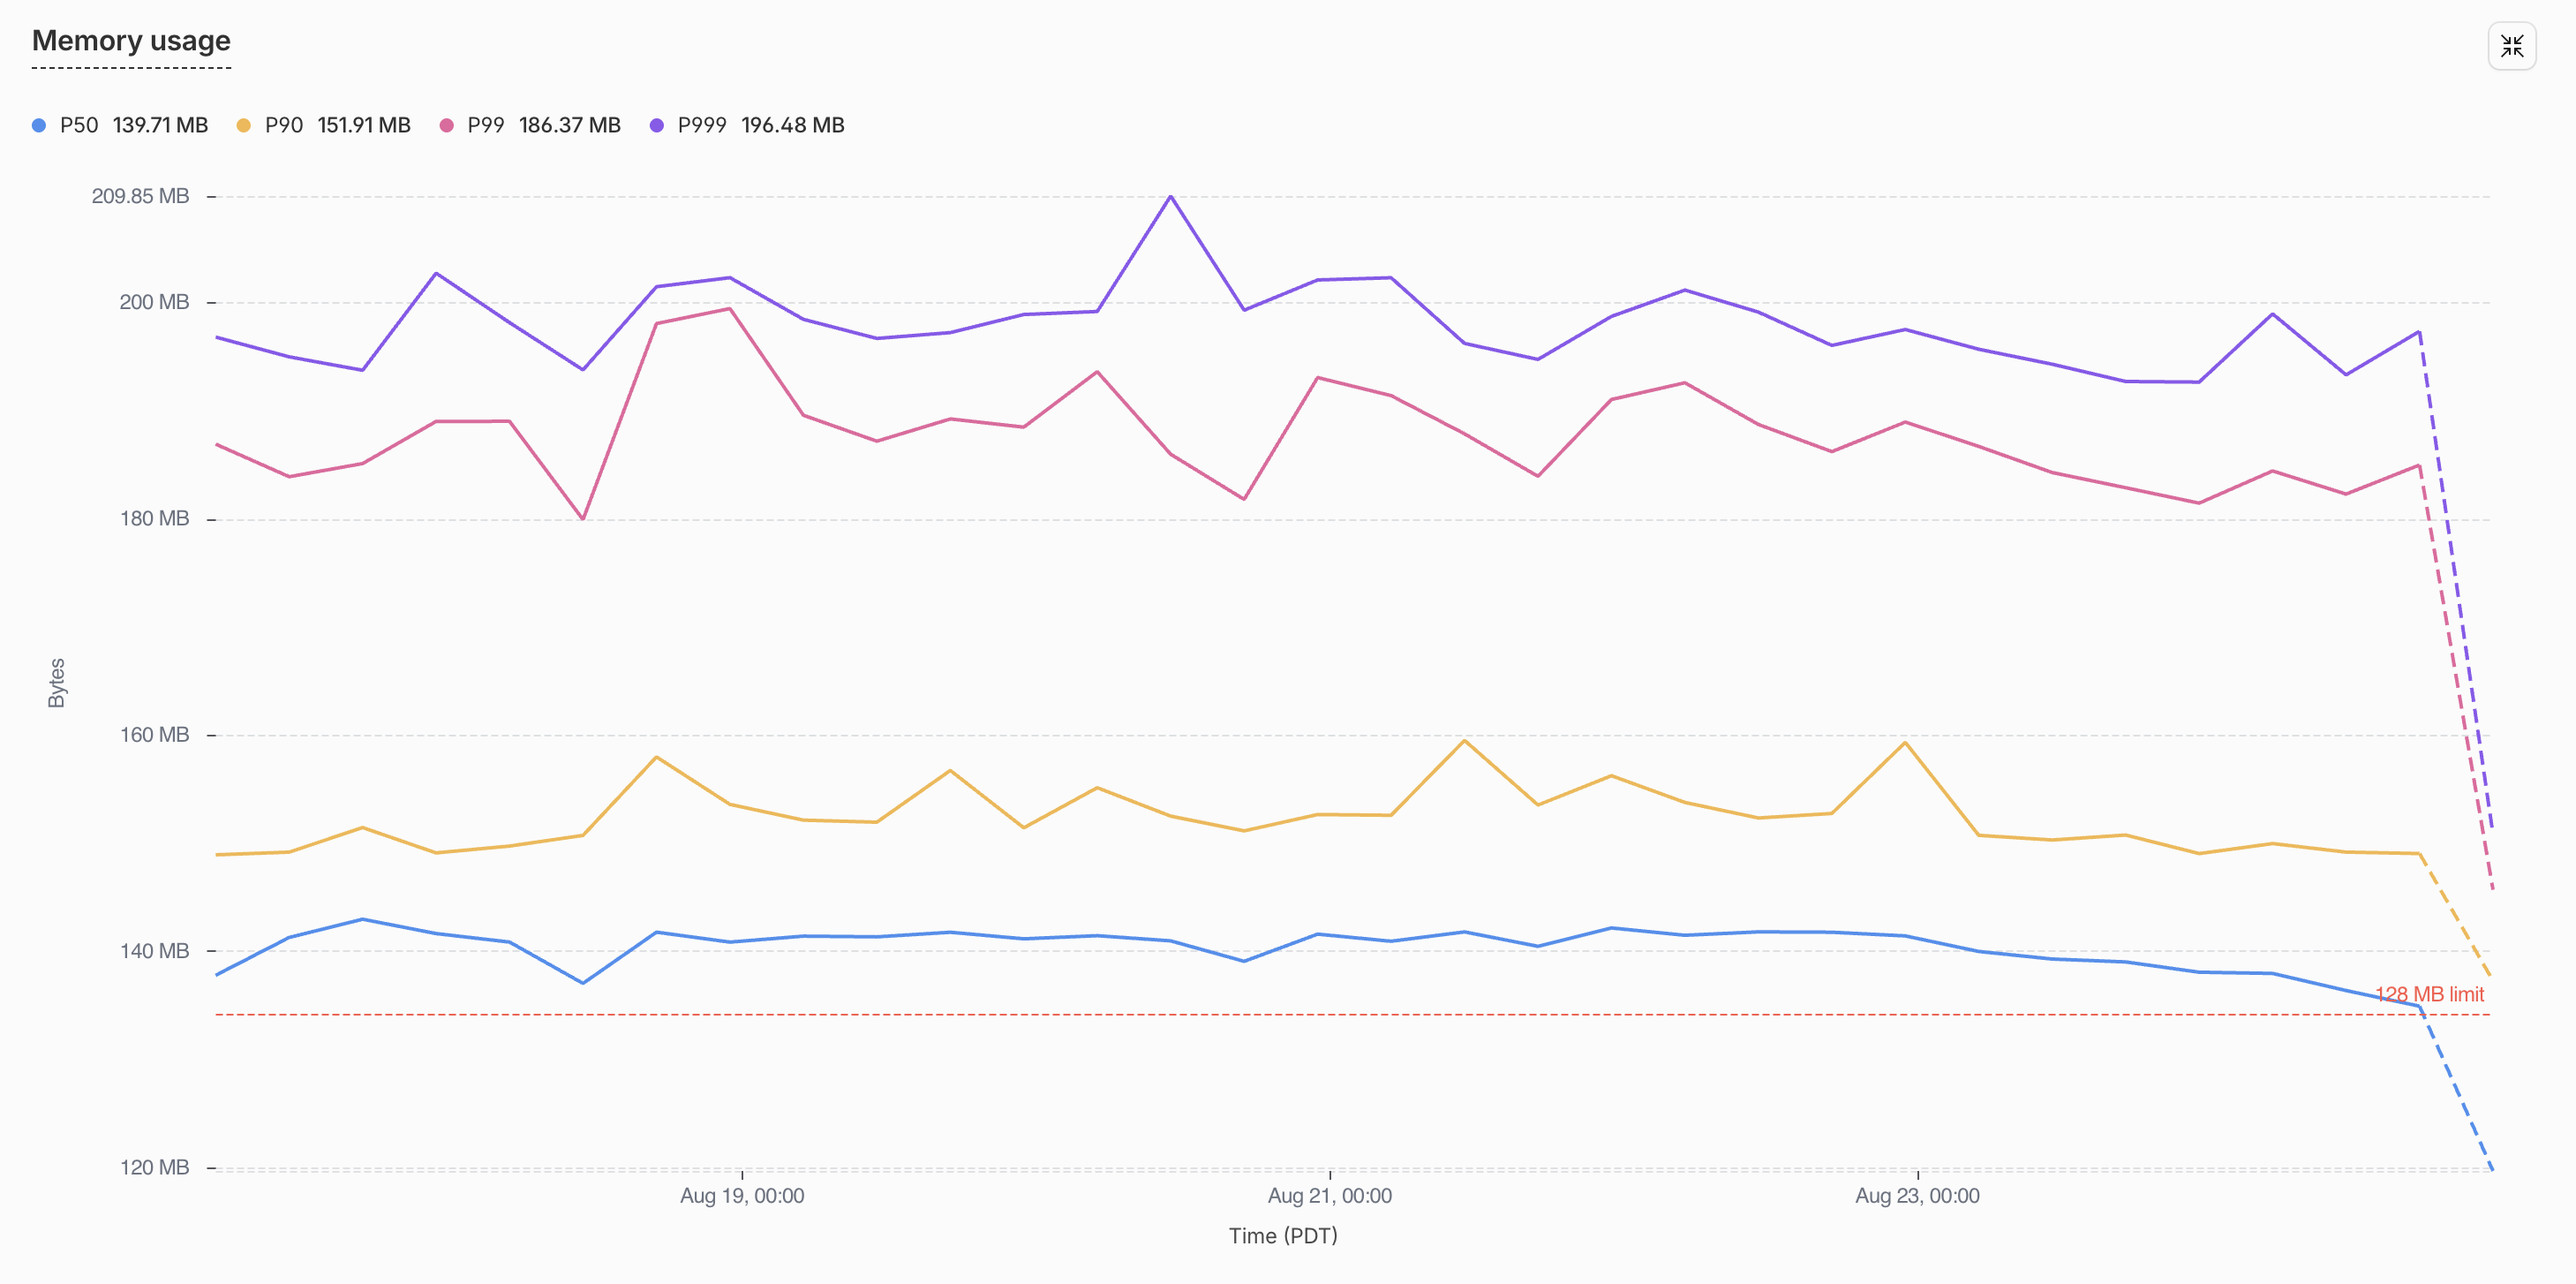
図1の青い線、中央値のアイソレートは1週間ずっと約140 MBにあり、99パーセンタイルは190 MB近くにありました。どちらの線も破線の128 MB上限を超えています。つまりネームスペース内の典型的なアイソレートは、Cloudflareがリセットする権利を持つ地点をすでに過ぎていて、次の確保が押し倒すまで見逃されていただけでした。グラフが示さなかったのは、トラフィックとの関係です。線は忙しい時間帯も静かな時間帯も同じように平らで、1日に約300回のリセットのどれもスタックトレースを伴いませんでした。例外を投げていたのは私たちのコードではなかったからです。
私たちはまず、誰もが最初に見るであろう場所を見ました。ペイロードのサイズを読み、チャット履歴の切り詰め方を確認し、メモリーの曲線にリクエストのパターンを探しましたが、線を動かすものは何も見つかりませんでした。この平らさが重要な手がかりでした。アイソレートのメモリーは2つのうちのどちらかです。データ、つまりリクエストのペイロード、チャット履歴、ツールの出力、その他トラフィックの処理中に確保されるもの。あるいはベースライン、つまりモジュールの読み込み時にコード自体が作り、アイソレートの生涯にわたって生かし続けるオブジェクト、たとえばインポート、関数、スキーマです。データはリクエストに応じて増減しますが、ベースラインは最初のリクエストの前からそこにあり、決して消えません。だから、アイドル時に高く平らなグラフはベースラインを描いているのです。問題は、配信しているものではなく出荷しているものの中にあるはずでした。
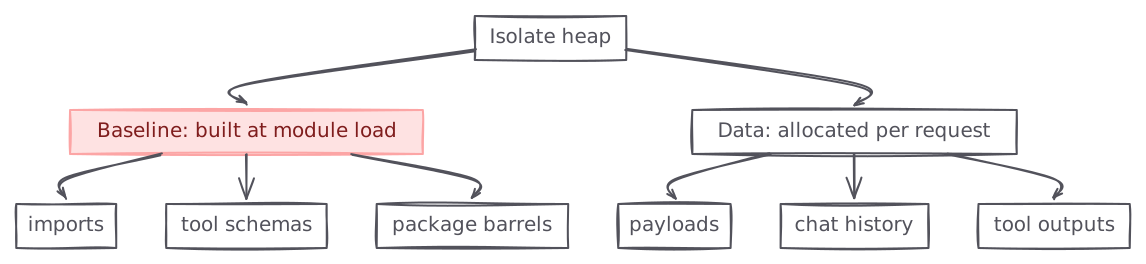
ベースラインのメモリーが見逃されやすい理由
ベースラインのメモリーは、普段は見ない2つの場所に隠れています。
1つ目はバンドラーです。私たちはツリーシェイキングが使っていないコードを取り除いてくれると思い込んでいて、たいていはそうなのですが、esbuildにはいつ刈り取れるかについてのルールがあり、それは直感で想像するルールではありません。package.jsonに"sideEffects": falseのないパッケージは、一切刈り取られません。遅延評価されるモジュールの中のexport *も刈り取られません。パッケージのルートの動的なimport()は、すべてのエクスポートを使用済みとして印を付けます。これらのそれぞれについては修正のところで戻ってきます。130 MBの半分を説明するのがこれらだからです。
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
2つ目はスキーマライブラリーです。型はコンパイル時に消えるので無料に感じますが、zodのスキーマは型ではなく、そのモジュールが評価された瞬間に構築されるクロージャーの木です。中規模のzod 4のオブジェクトスキーマ1つ、説明と精査付きのフィールドが12個ほどのもので、ヒープを約134 KB消費します。素のz.string()は約12 KBです。同等の素のJSONスキーマのオブジェクトは数百バイトです。そのどれもREADMEには書いてありません。
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
私たちは何も特別なことをしていなかった
私たちの問題のすべては、既定から来ていました。すべてのエージェントツールはモジュールスコープでz.object()によって入力を宣言していました。ドキュメントがそうしているからです。すべての内部パッケージにはexport * from "./zod"を持つバレルのindex.tsがありました。整然としているからです。いくつかのパスではawait import("@scope/package")を使っていました。遅延読み込みは安いはずだからです。1つ1つは、それだけ見れば合理的な選択です。合わせると130 MBで、使えるのは128 MBのアイソレートの中でした。
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
それが私たちに何をもたらしていたか
私たちのエージェントには250を超えるツールがあり、Code modeと動的なワーカーを通してそれらを使います。そのzodの定義だけで、モジュールの読み込み時にヒープを78 MB消費していました。アイソレートの予算の半分以上を、どれか1つが呼ばれる前に、引数の説明に費やしていたのです。追加するすべてのツールが、実際に動くかどうかにかかわらず、さらに約134 KBを消費しました。
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB = 50 MB left for every thread's actual dataリセットも無料ではありませんでした。すべてのexceededMemoryは進行中のエージェントのターンを捨てます。再試行、2回目のモデル呼び出し、スピナーを見つめるユーザー。1日に約300回となると、それはインシデントではなく恒常的な税になり、同居のせいで、そのときアイソレートにたまたまいたオブジェクトが支払っていました。
Error: Durable Object's isolate exceeded its memory limit and was reset.どう見つけたか:本番バンドルのためのヒーププロファイラー
本番をプロファイリングできなかったので、本番が動かしているまさにそのバンドルに対してローカルで動く小さなプロファイラーを作りました。すべてのモジュールを評価するV8ヒープのコストを測り、順位付けした表を出力します。私たちはこれをループで回しました。プロファイリングし、順位の先頭を取り除き、またプロファイリングする。すべての修正の最終確認は、本番デプロイを、デプロイマーカーの両側のCloudflareのメモリーメトリクスと比較することでした。
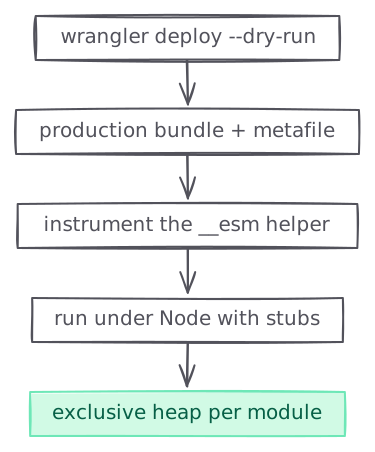
これを機能させているのは3つのアイデアです。
- 同じバンドル。
wrangler deploy --dry-run --outdir --metafileは、デプロイがアップロードするまさにそのesbuildバンドルと、そのモジュールグラフを出力します。すべてはそのバンドルの上で測ります。 - **モジュールへの帰属。**esbuildは遅延評価されるモジュールを
__esm(...)の初期化クロージャーで包みます。ビルドされたバンドル内のその1つのヘルパーを書き換えて、すべてのモジュールの初期化が自分の前後でv8.getHeapStatistics().used_heap_sizeを記録するようにし、初期化スタックでモジュール自身のコスト(排他的)を依存先のコスト(包含的)から分けます。結果はフレームグラフの形をしたデータセットです。 - **制御された実行。**計装されたバンドルは、
cloudflare:*のインポートをスタブに解決するローダーのシムを添えて、素のNodeで動かします。
コーディングエージェントに貼り付けられる完全なレシピは、この記事の最後にあります。上で引用したzodの単位コストは、同じハーネスで実行したマイクロベンチマークから来ています。
最初のプロファイルが示したもの
| ソース | 排他的ヒープ |
|---|---|
packages/tools(250以上のエージェントツール定義、zod) | 78.0 MB |
| zodスキーマモジュールを再エクスポートするパッケージのバレル(以下の行) | 約66 MB |
durable-workspaces(ワークスペースの状態とスケジュール) | 15.6 MB |
thread-core(スレッドのデータレイヤー) | 10.1 MB |
durable-automations(オートメーションの定義) | 9.6 MB |
durable-threads(スレッド一覧とライブ更新) | 7.3 MB |
durable-automation(1回のオートメーション実行) | 6.8 MB |
db(D1クライアントとモデル) | 6.3 MB |
durable-skills(スキルの定義) | 5.7 MB |
durable-autofixes(自動修正のブランチとマージ) | 4.9 MB |
| その他12の小さなパッケージ | 約9 MB |
驚くべきは2行目です。これらはパッケージのバレルにあるexport * from "./zod"を通してだけバンドルに到達するスキーマです。私たちのコードはそれらを使っておらず、ツリーシェイカーは取り除けず、メモリー上限の3分の1を消費していました。そのすべてが、何からも呼ばれないモジュールの中で。
修正A:ツールの定義をコードではなくデータに
すべてのツール定義は入力スキーマをzodで宣言し、実行時にJSONスキーマに変換していました。モデルに送られるのはどうせJSONスキーマだからです。数百バイトのデータを生み出すために、ツールごとに約134 KBのクロージャーを構築していたので、データを直接書くことにしました。
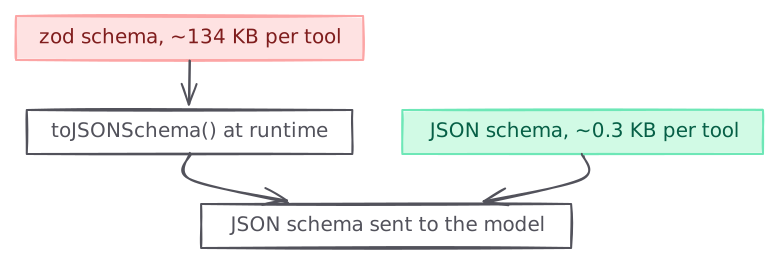
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;defineParametersはAI SDKのjsonSchema()の薄いラッパーです。ParametersInputは、zodがやっていた型推論をjson-schema-to-tsが行うものです。実行時の検証は、エージェントループが依存する性質を再現する約300行のバリデーターに移りました。未知のキーの除去、既定値の補完、判別子によるユニオンの解決、そしてモデルが再試行時に自分のツール呼び出しを修復できるように言葉を選んだエラーメッセージです。
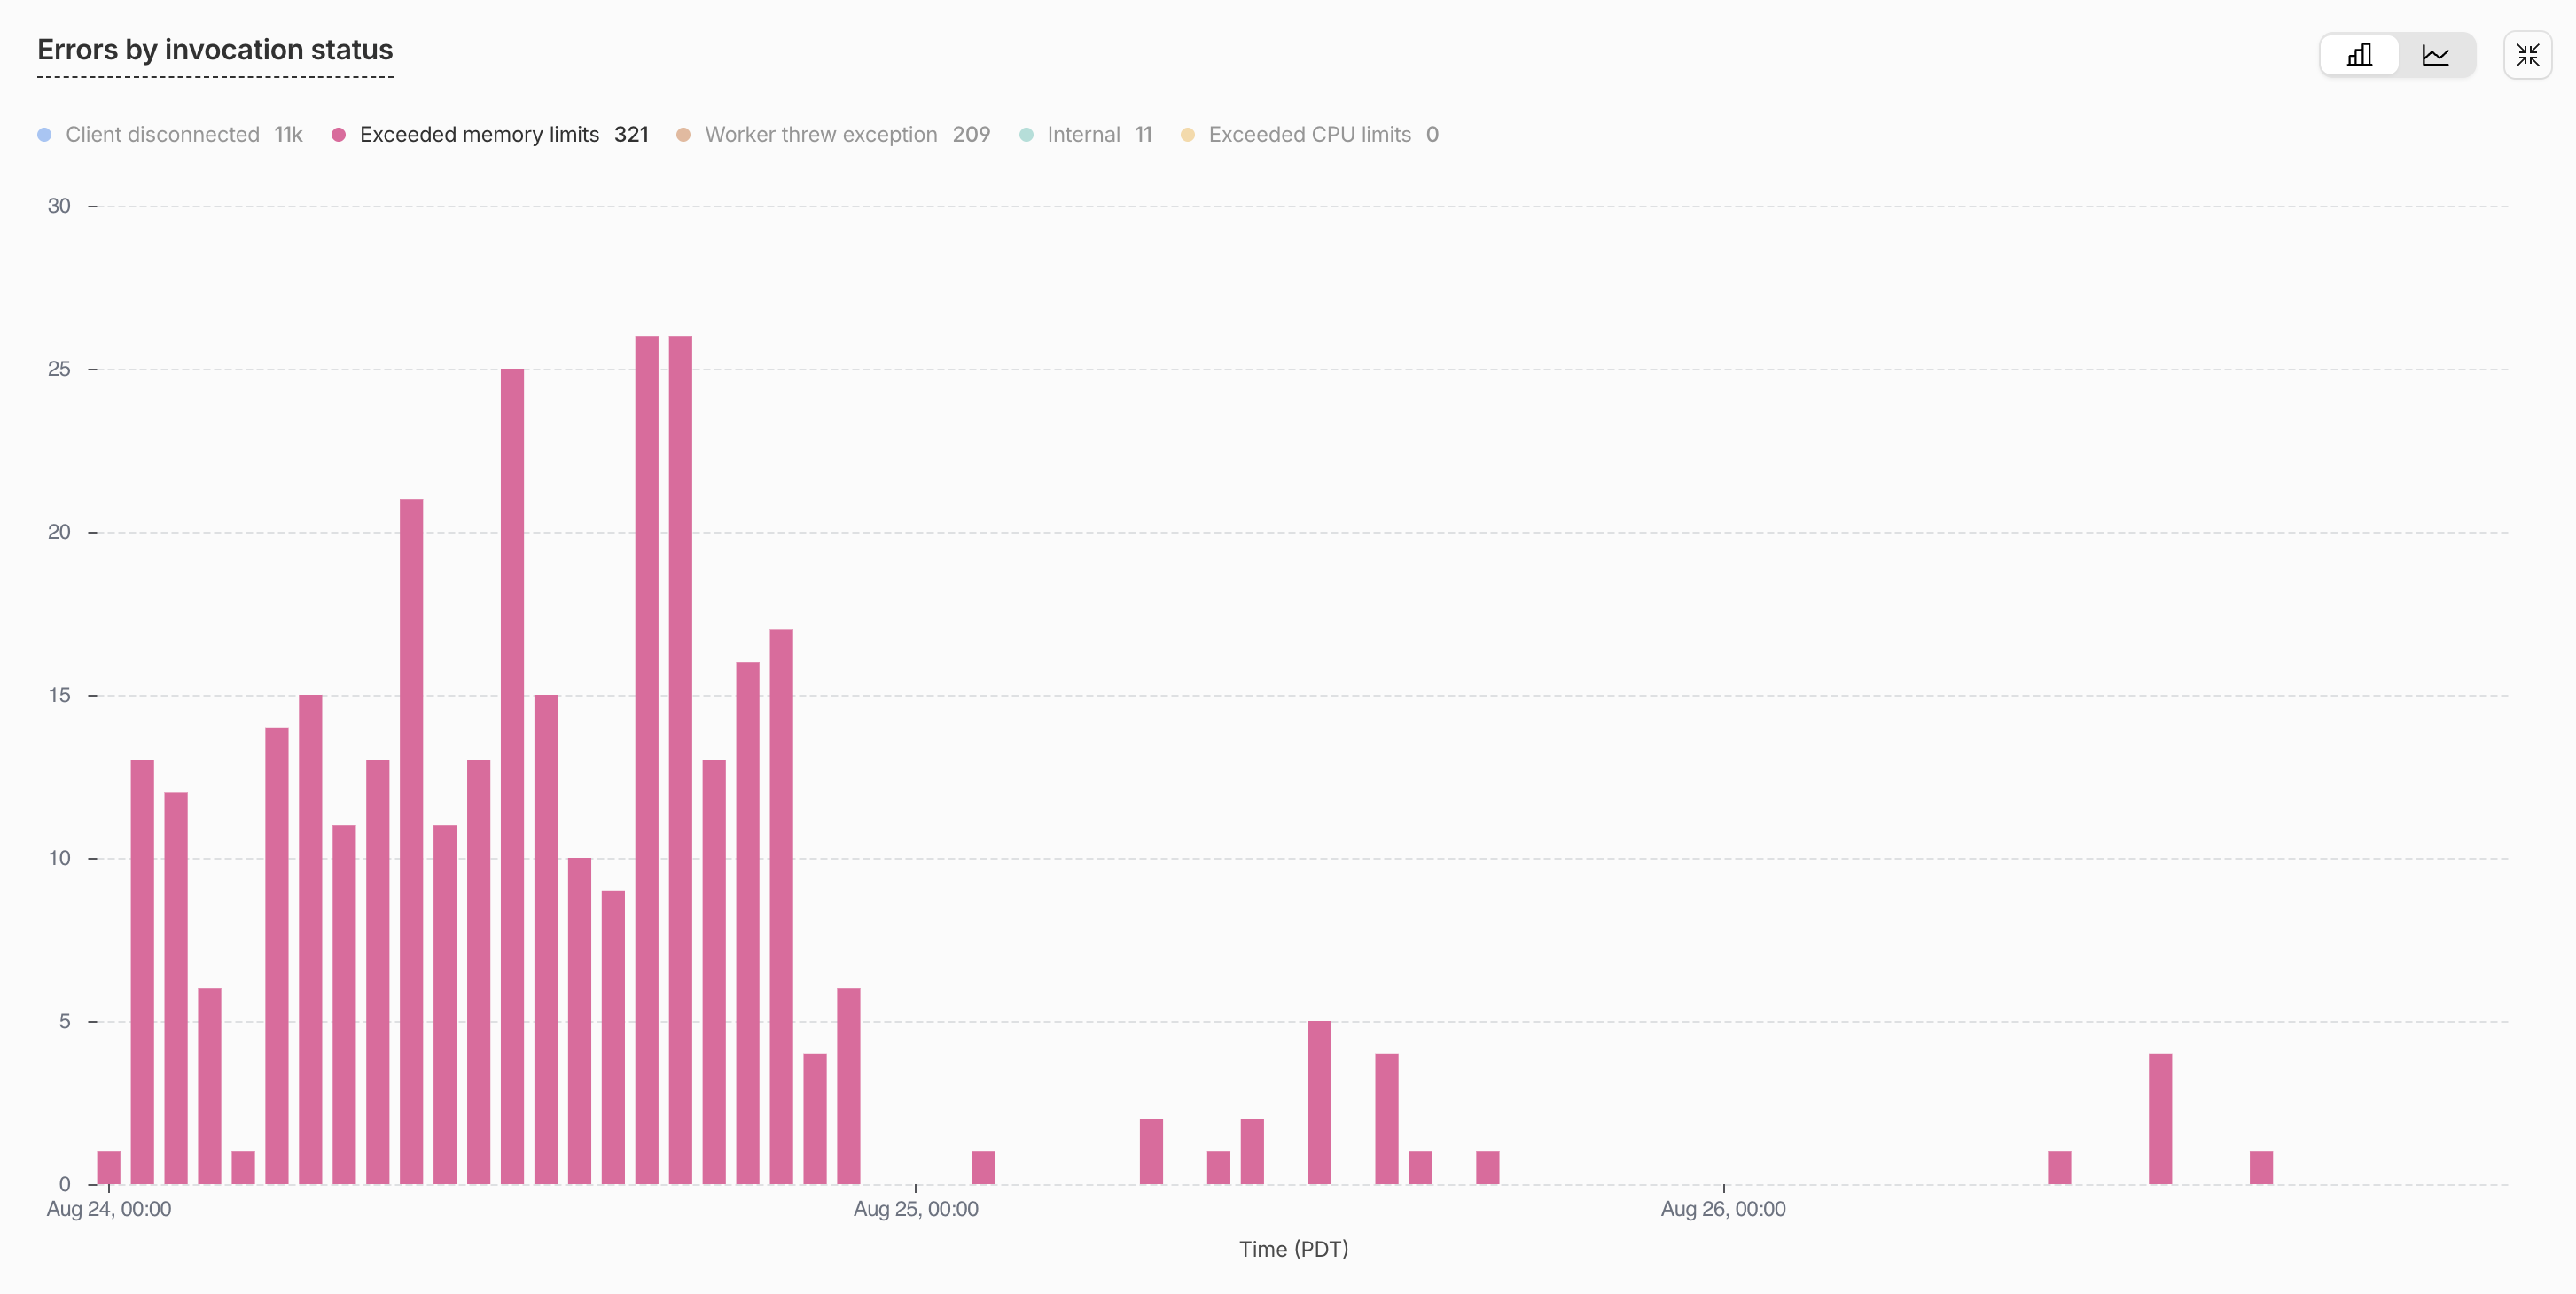
モジュール評価時のヒープはローカルで218.6 MBから154.0 MBへ、packages/toolsは78 MBから0.7 MBへ減りました。本番では、デプロイマーカーの時点でリセットが1時間あたり40から110回から0から6回へ、中央値のアイソレートのメモリーが約140 MBから約120 MBへ下がりました。
修正B:実際にツリーシェイキングできるバレル
残りの約66 MBは、アイソレートが決して使わないスキーマでした。3つのバンドラーの振る舞いがそれを説明します。
- パッケージの
package.jsonに"sideEffects": falseがなければ、esbuildはそこから何も刈り取りません。 - フラグがあっても、遅延評価されるモジュールの中の
export * from "./zod"は刈り取られず、動的なimport()を通して到達できるものはすべて遅延評価されます。名前付きの再エクスポート(export { zFoo } from "./zod")は問題なく刈り取られます。 await import("@scope/package")はパッケージのネームスペースオブジェクト全体を実体化し、すべてのエクスポートを使用済みとして印を付けます。スキーマも、クラスも、すべてです。
私たちはこれらのそれぞれを、wranglerが同梱するesbuildのバージョンで作った5ファイルのフィクスチャで確認しました。エントリー、index.tsのバレルを持つパッケージ、実行時に知らせるコンストラクターを持つスキーマ1つを収めたzod.ts、そのスキーマをインポートするdo.tsのクラス、そしてそれらの間の遅延の中間モジュールです。表は、それぞれの組み合わせについて、評価時にスキーマのコンストラクターが実行されたかを記録しています。
| エントリーからバレルへのインポート | バレルの再エクスポートの形 | sideEffects: false | スキーマが含まれる |
|---|---|---|---|
| 静的インポート | export * | あり | いいえ |
| 静的インポート | export * | なし | はい |
パッケージの動的import() | いずれも | あり | はい |
| 遅延読み込みされるモジュールからの静的インポート | export * | あり | はい |
| 遅延読み込みされるモジュールからの静的インポート | 名前付きリスト | あり | いいえ |
| いずれも | 名前付きリスト | なし | はい |
3行目と4行目が人を驚かせる2つで、合わせて約66 MBを占めていました。1つのバレルが私たちに何をしていたかを示します。
修正は機械的です。110を超えるすべてのワークスペースパッケージに"sideEffects": falseを入れ、バレルのexport *を名前付きの再エクスポートリストに書き換え、パッケージルートのawait import("@scope/package")を静的な名前付きインポートに置き換えます。
実際の本番バンドルに対するアブレーションは、それぞれの部品が必要であることを示しています。
| 構成 | モジュール評価後のヒープ | バンドル内のスキーマモジュール |
|---|---|---|
| ベースライン(修正Aの後) | 154.0 MB | 77 |
sideEffects: falseのみ | 143.6 MB | 77 |
+ 静的インポート、バレルはexport *に戻す(対照) | 98.6 MB | 29 |
| + 名前付き再エクスポートリスト(完全な修正) | 82.1 MB | 0 |
対照の行が興味深いところです。完全に静的なインポートグラフでも29のスキーマモジュールが残るので、名前付きリストは省略できません。
最終状態
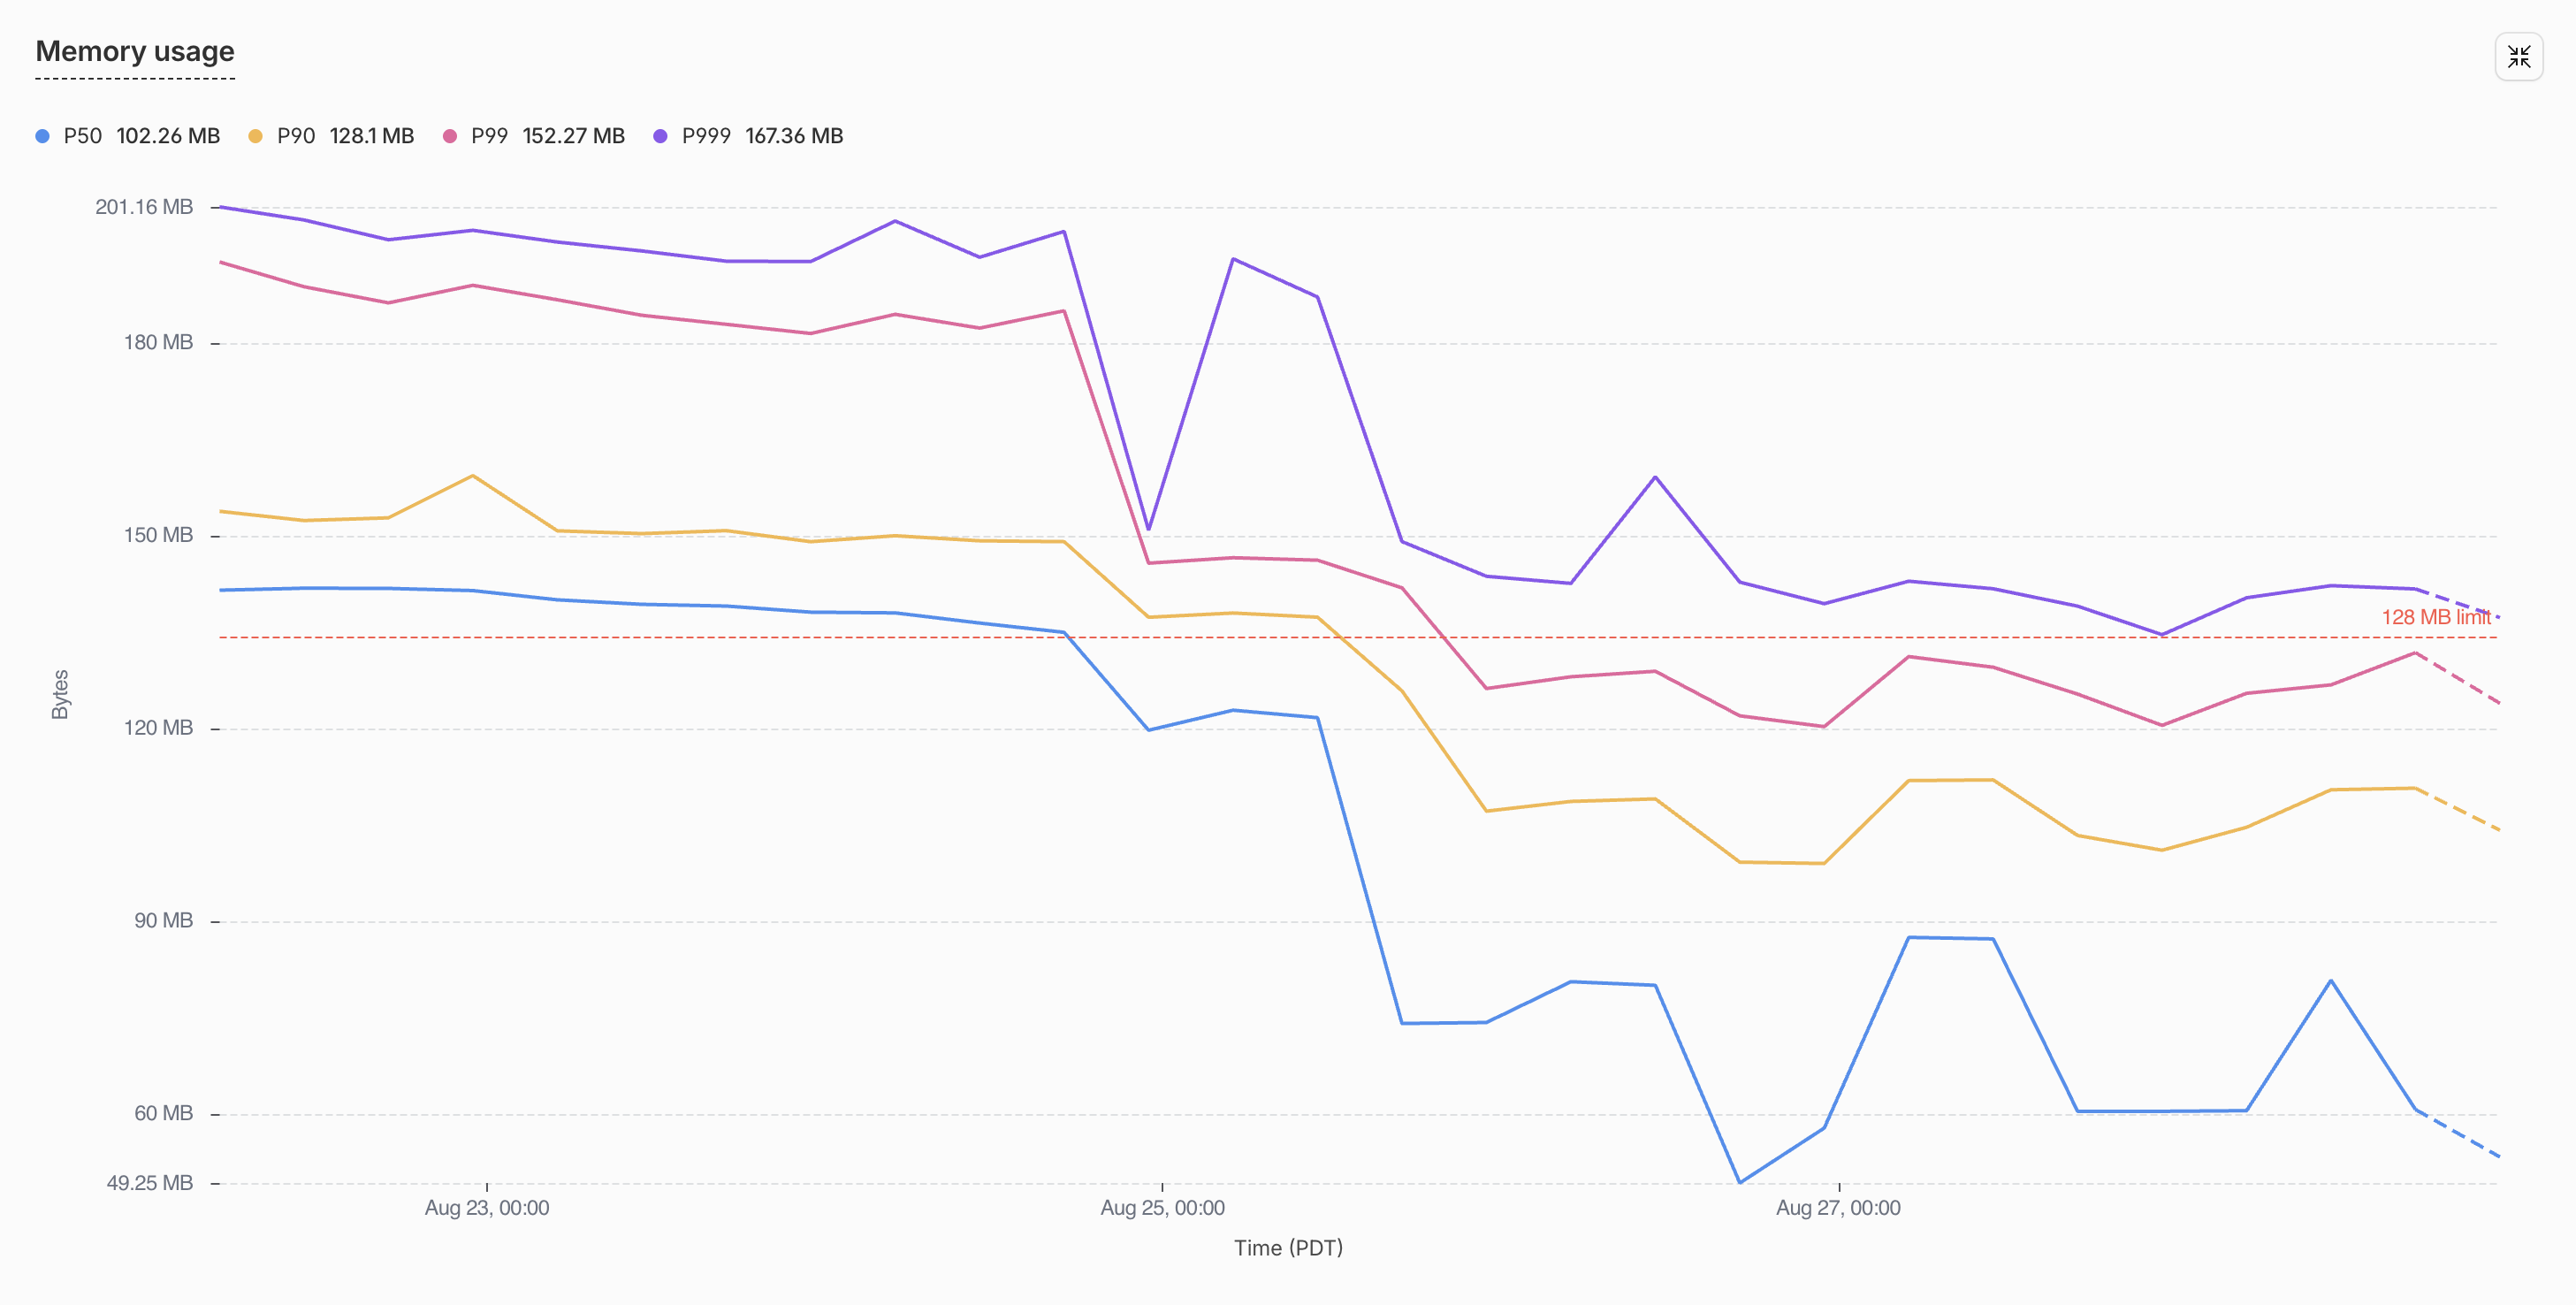
| モジュールスコープのヒープ(ローカルのプローブ) | 本番の中央値メモリー | 本番のリセット | |
|---|---|---|---|
| 前 | 218.6 MB | 約140 MB | 約300/日 |
| Aの後 | 154.0 MB | 約120 MB | 約10/日 |
| A+Bの後 | 82.1 MB | 約70 MB | 0 |
プラットフォームのメモリー上限を超えてアイドルしていたDurable Objectは、今ではその半分ほどでアイドルし、1日約300回のリセットはなくなりました。
これは設定フラグではない
250を超えるツール定義をzodから素のJSONスキーマに書き直し、zodがやってくれていたことの代わりに300行のバリデーターを書くのは、コーディングエージェントを使っても数日かかりました。100を超えるパッケージにsideEffects: falseを加え、すべてのexport *を生成された名前付きリストに変えるのは地味な仕事で、その後リポジトリ全体を型チェックして壊れたものを直します。楽な代替案は再試行を加えてリセットと共に生きることで、多くのチームがそうしています。もしDurable Objectがアイドル時に上限の近くにいるなら、その1週間は価値があると私は主張します。上限は動かず、ツールの数は増える一方だからです。
初日から知っておきたかった3つのこと。
- **アイドル時に高く平らならベースライン。**配信しているものではなく、出荷しているものをプロファイリングする。
- ツリーシェイキングにはルールがある。
sideEffects: false、名前付き再エクスポート、静的インポート。1つでも欠けると、パッケージ全体が乗り込んでくる。 - **スキーマは型ではなくコード。**消費者がJSONスキーマを望むなら、JSONスキーマを書く。
Durable Objectのメモリーを直すために、今日やること
プロファイラーは約100行で、Nodeとwrangler以外の依存はありません。以下のレシピを、wranglerでデプロイしているリポジトリのルートでコーディングエージェントに貼り付け、出力される表の上位10行を読み、何があるかを確かめてください。それからリストを下っていきます。モデルがどうせJSONスキーマとして受け取るものには素のJSONスキーマ、バレルには"sideEffects": falseと名前付き再エクスポート、パッケージルートには静的インポートです。
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
監査全体を任せたいなら、コーディングエージェント用のスキルがこちらです。
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
このスキルはPolylane自体にも追加したので、すべてのPolylaneユーザーは、何も貼り付けることなく、Durable Objectのメモリーに対するこの深い調査を最初から使えます。