

Como corrigimos os erros de memória excedida dos nossos Cloudflare Durable Objects
Explore with AI
Cada thread de agente no Polylane roda dentro do seu próprio Cloudflare Durable Object, todos instâncias de uma única classe. Em agosto de 2026, os Durable Objects das nossas threads eram reiniciados cerca de 300 vezes por dia por excederem o limite de memória. Ouvimos a mesma história de vários times que rodam seus fluxos agênticos em Cloudflare Durable Objects.
Se você já esbarrou em exceededMemory em um Durable Object, o conselho de sempre é olhar o que suas requisições alocam: um payload grande demais, um histórico de chat que cresce sem limite, um cache que nunca descarta nada. Nada disso se aplicava a nós. O isolate estava acima do limite antes de servir uma única requisição, então o peso tinha que estar no código que lançávamos, e não nos dados que servíamos.
Este post é sobre o que realmente estava no heap, como encontramos isso em uma plataforma que não permite anexar um profiler, e as duas mudanças que levaram a memória de escopo de módulo de 218 MB para 82 MB e os reinícios a zero.
Cloudflare Durable Objects em um minuto
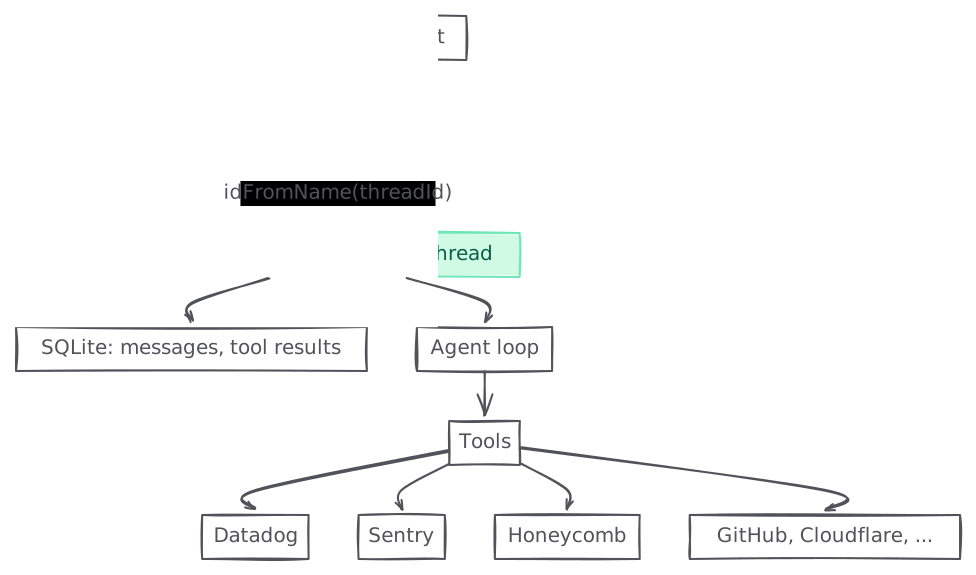
Se você nunca os usou: um Durable Object é um servidor pequeno, com estado e single-threaded que a Cloudflare garante ser único para um dado ID. Chame idFromName() com esse ID a partir de um Worker e toda requisição para ele, de qualquer lugar do mundo, cai na mesma instância, com seu próprio banco SQLite, estado em memória e alarmes. Ele hiberna quando ocioso e acorda de onde parou.
No Polylane, criamos uma instância de Durable Object para cada thread. Toda conversa com o agente, iniciada por uma pessoa ou por um alerta, ganha seu próprio Durable Object. O SQLite do objeto guarda as mensagens e os resultados de ferramentas da thread, o loop do agente roda dentro dele, e suas ferramentas chamam os provedores de que a thread precisa: Datadog, Sentry, Honeycomb, GitHub, Cloudflare e os demais. Quando a thread fica em silêncio o objeto hiberna, e quando a próxima mensagem chega ele retoma exatamente de onde parou.
Como funciona a memória dos Durable Objects
- Isolates e o teto de 128 MB. Durable Objects rodam dentro de isolates V8, e um isolate tem um limite rígido de memória de 128 MB que é o mesmo em todos os planos e não é configurável.
- Colocação. Um único isolate hospeda muitos Durable Objects da mesma classe, junto com o código do Worker ao redor deles, e todos compartilham a memória desse isolate. O limite é por isolate, não por objeto.
- Vizinhos barulhentos. Por causa da colocação, o objeto que é reiniciado quando o isolate fica sem memória muitas vezes não é o objeto que usou a memória. Cada amostra de memória que a Cloudflare reporta é do isolate inteiro, assim como cada reinício.
Não há como anexar um profiler de memória a um Durable Object em produção: o ferramental de heap snapshot que a Cloudflare documenta roda contra uma sessão local de desenvolvimento. No Kubernetes você ligaria o profiling e ficaria anexado até encontrar o problema. No workerd, process.memoryUsage() é um polyfill do unenv que retorna zeros, e os números de memória e CPU de baseline não ficam visíveis para o código que roda dentro. O que você tem é a API de analytics GraphQL da Cloudflare: percentis de memória e contagens de falhas por namespace, depois do fato.
O que o gráfico de memória nos disse
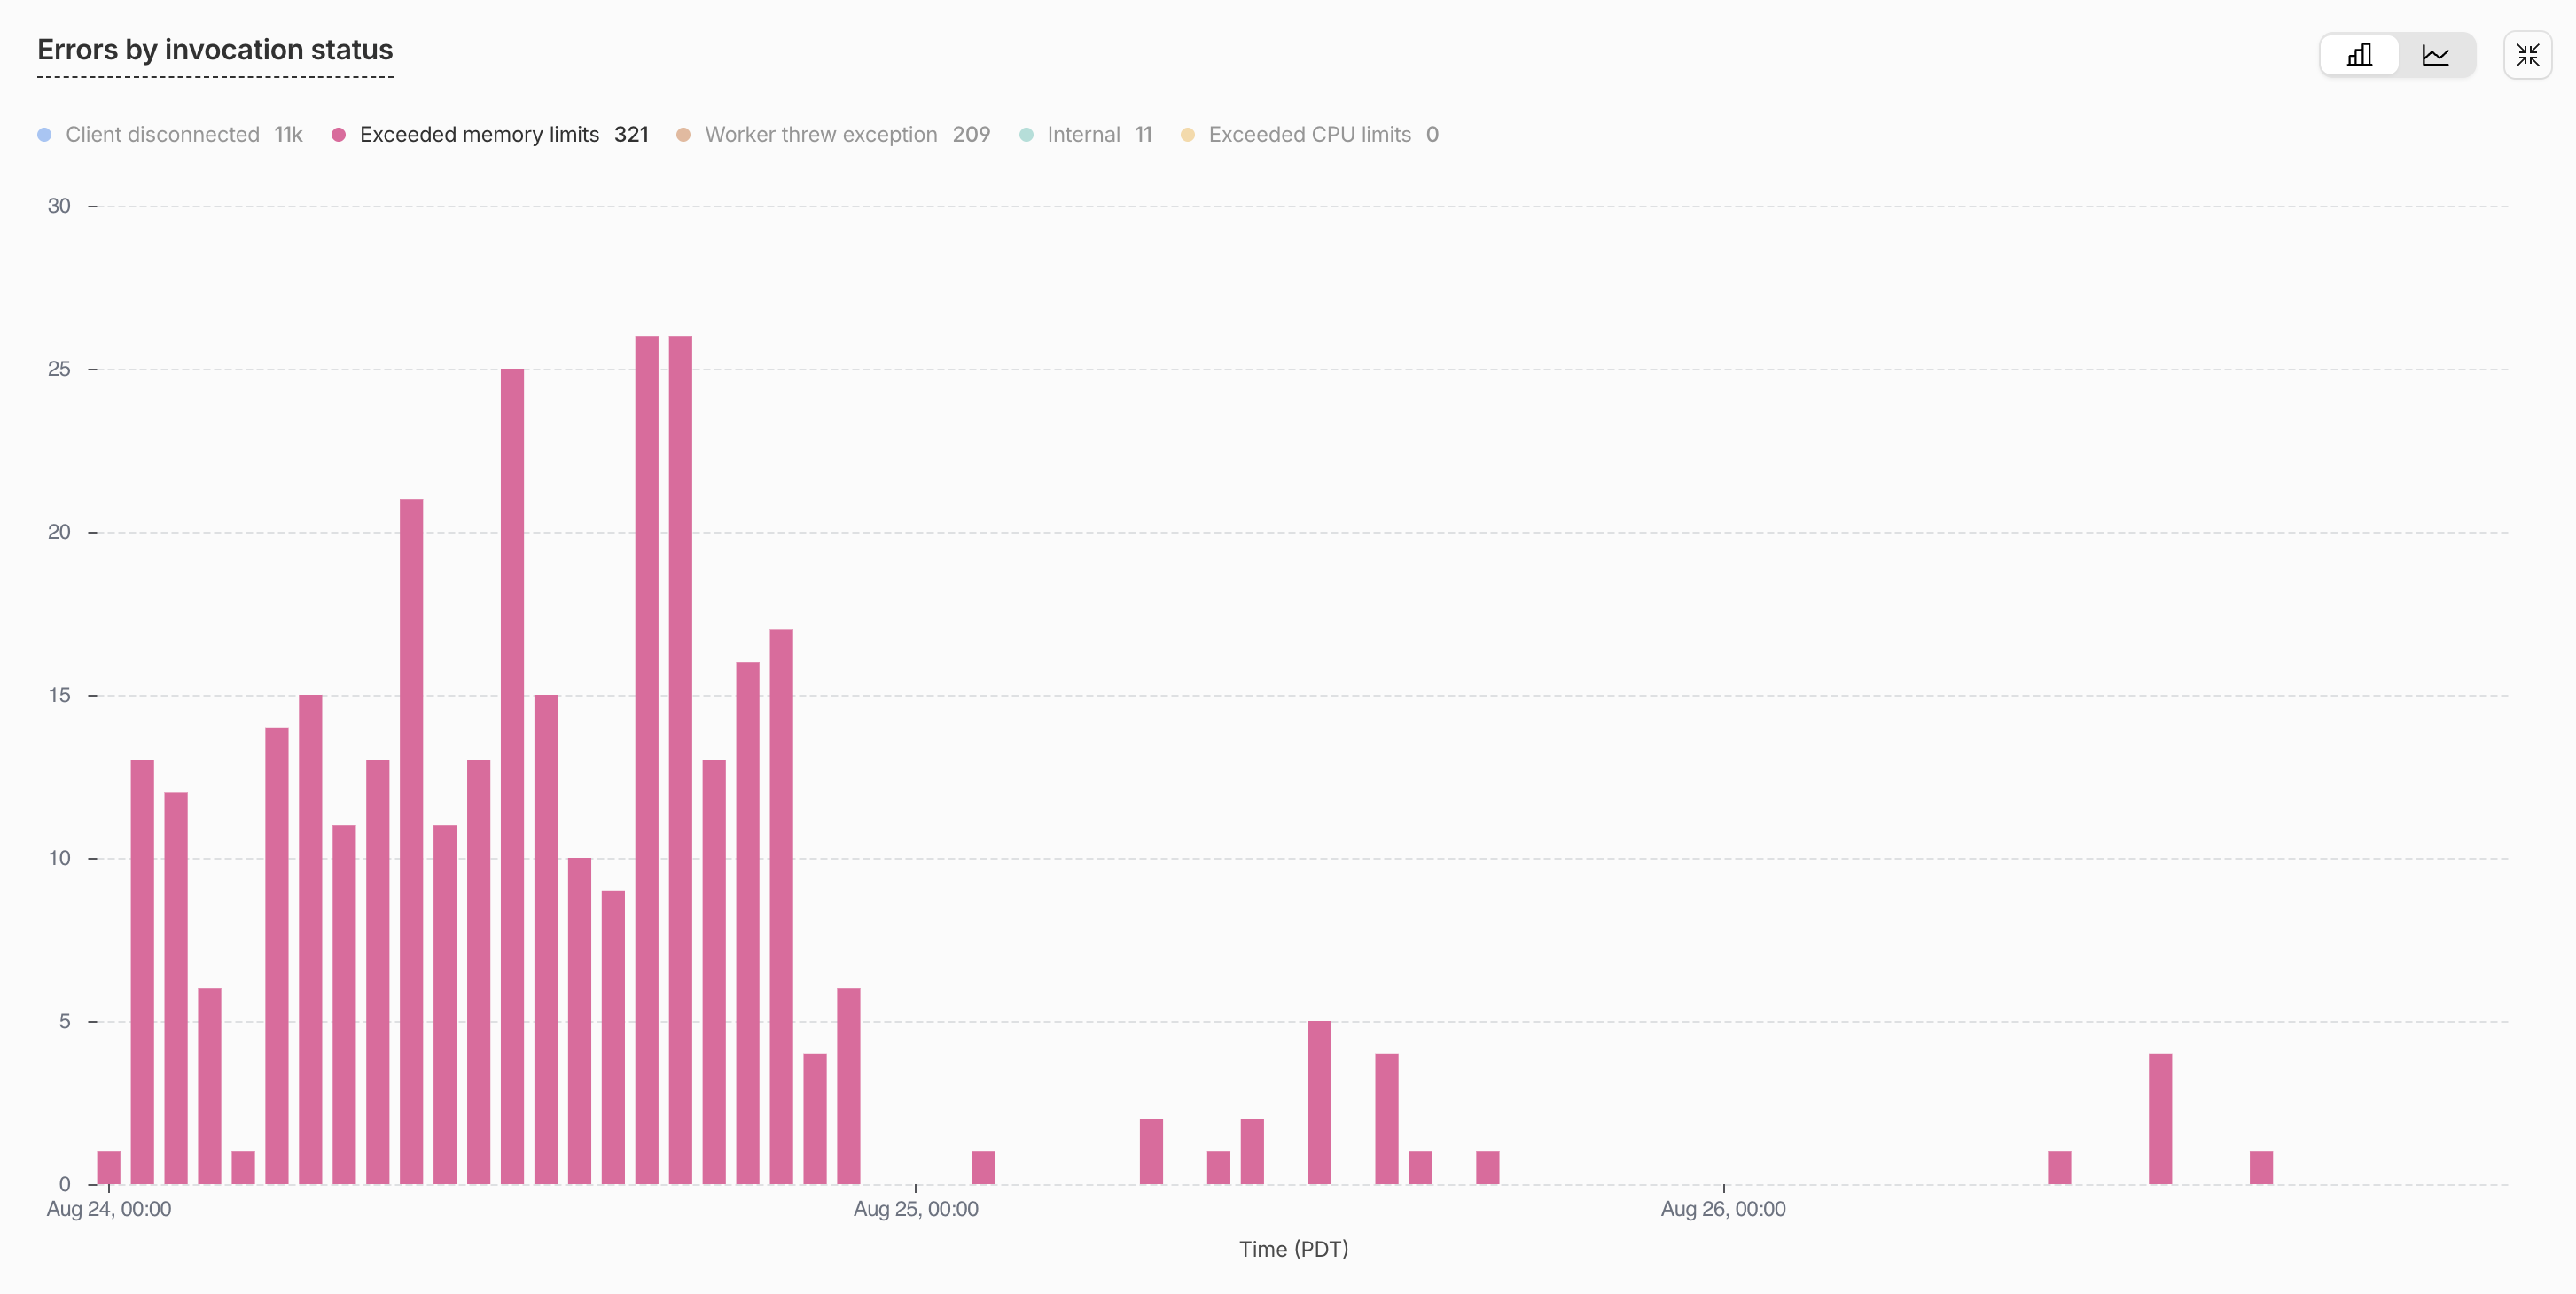
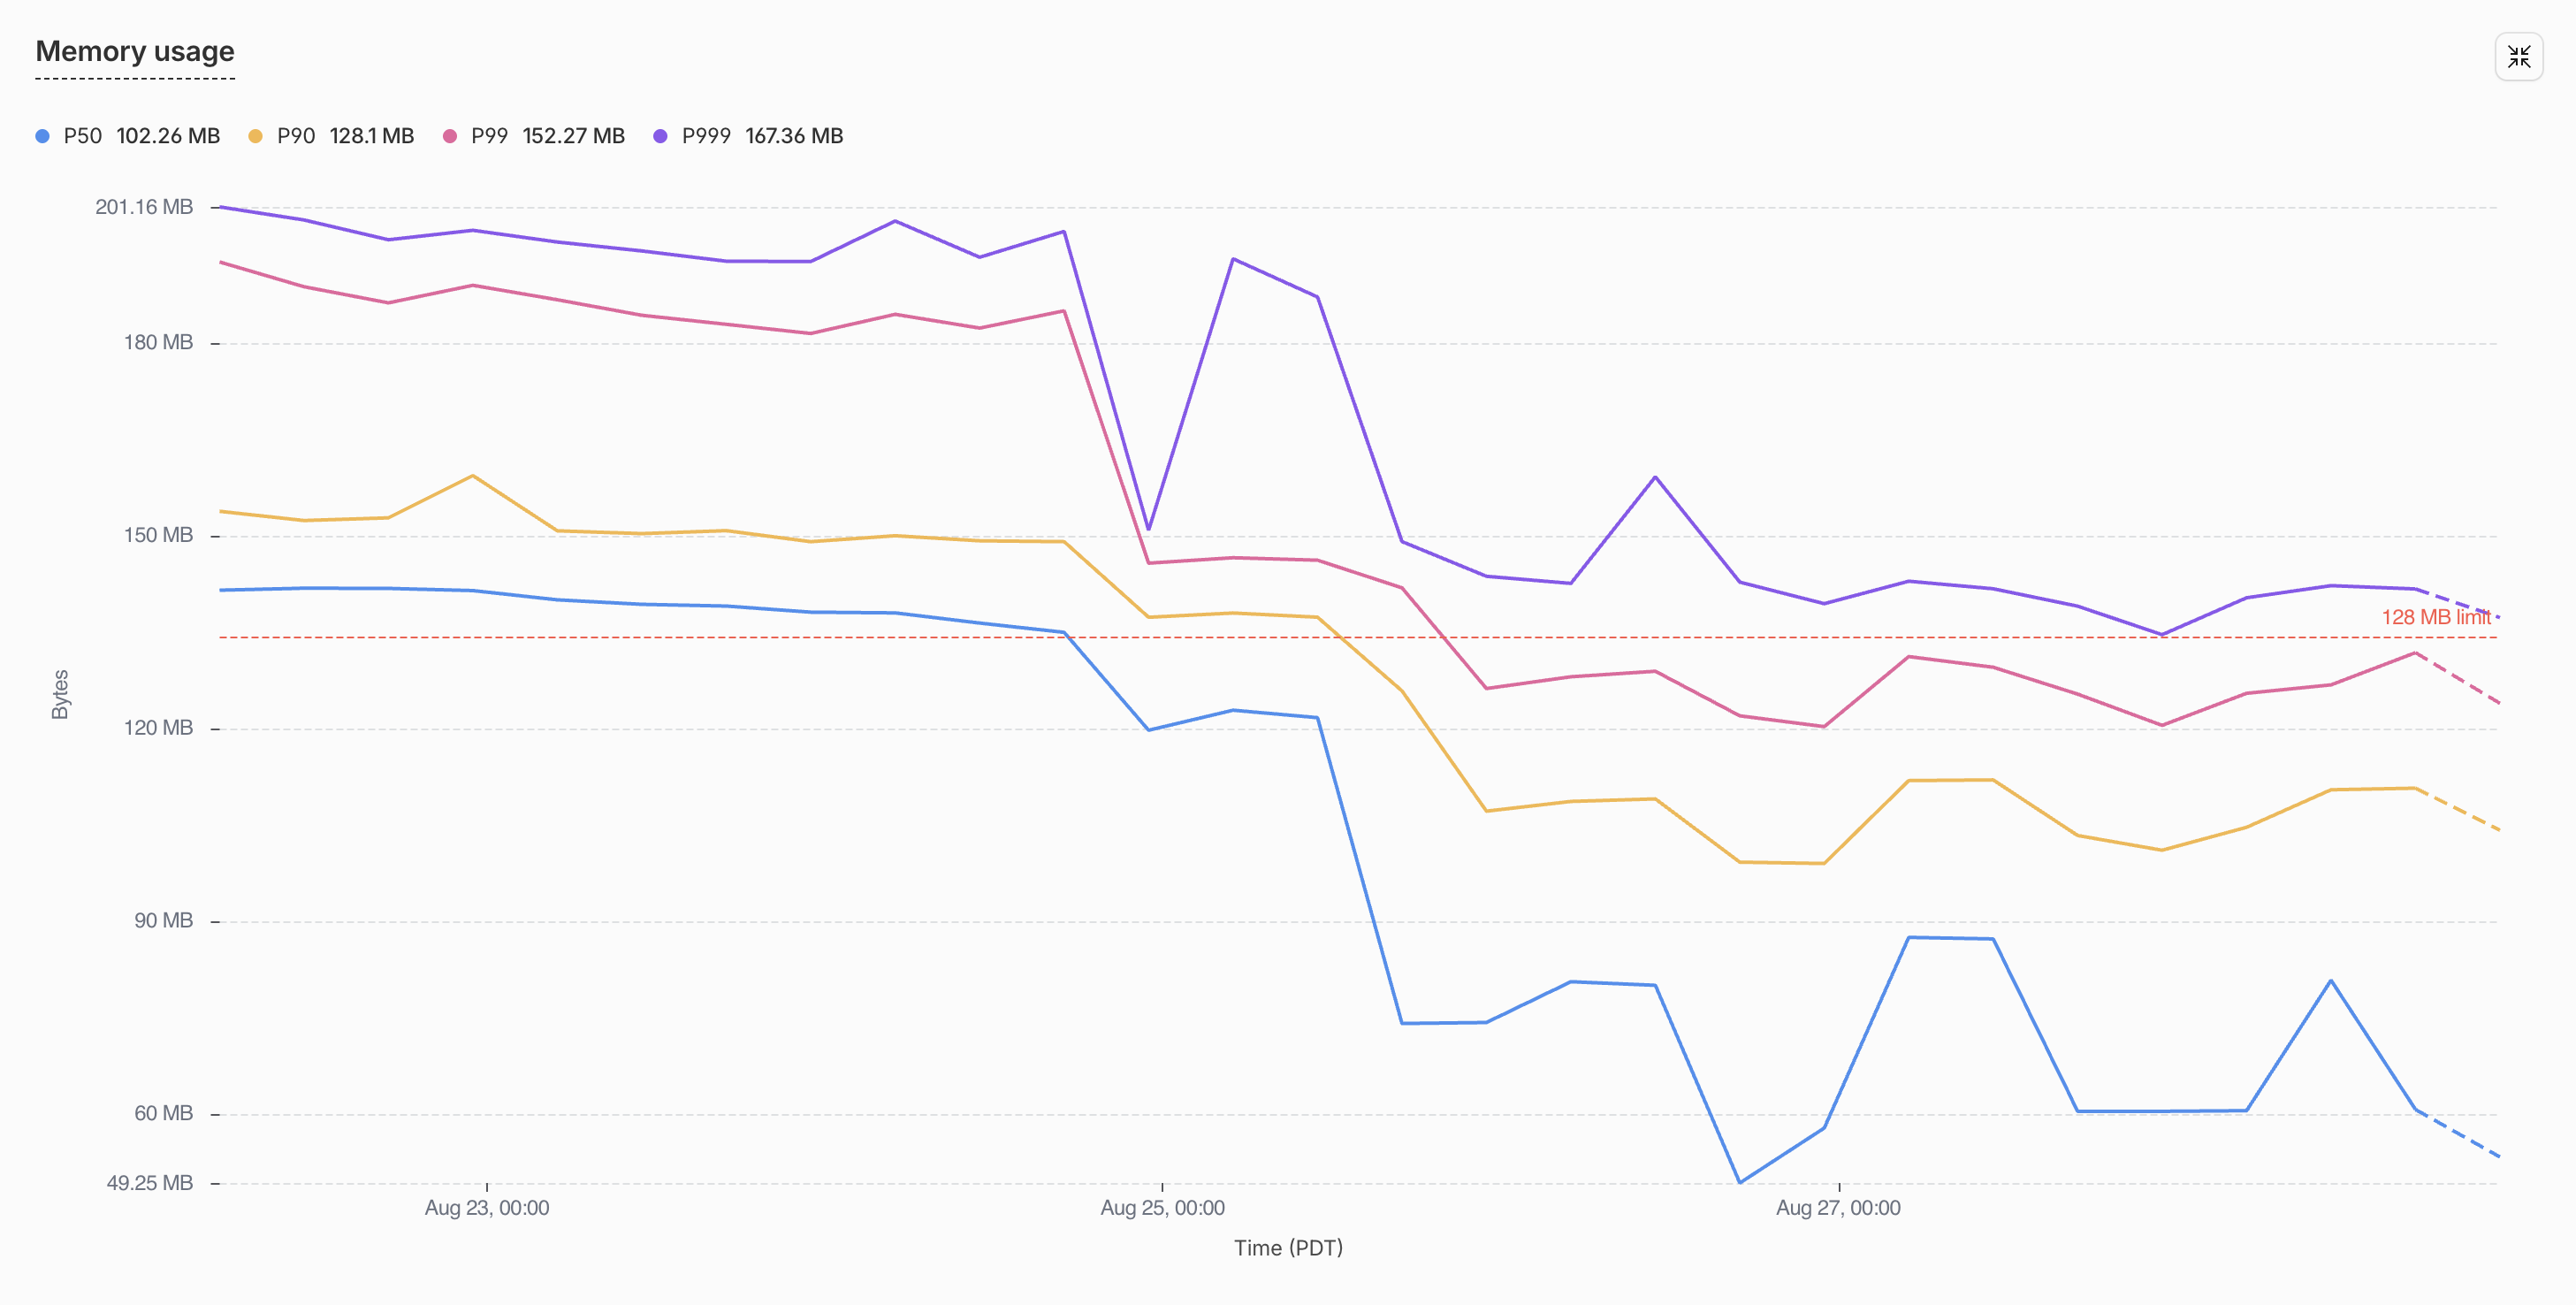
A API de analytics da Cloudflare reporta a memória de um namespace de Durable Objects como percentis entre os isolates que o rodam, em intervalos de quinze minutos, junto com a contagem de erros de memória excedida em cada intervalo. Todo gráfico neste post vem dessa API, filtrado para o namespace de threads e comparado entre marcadores de deploy assim que começamos a lançar as correções.
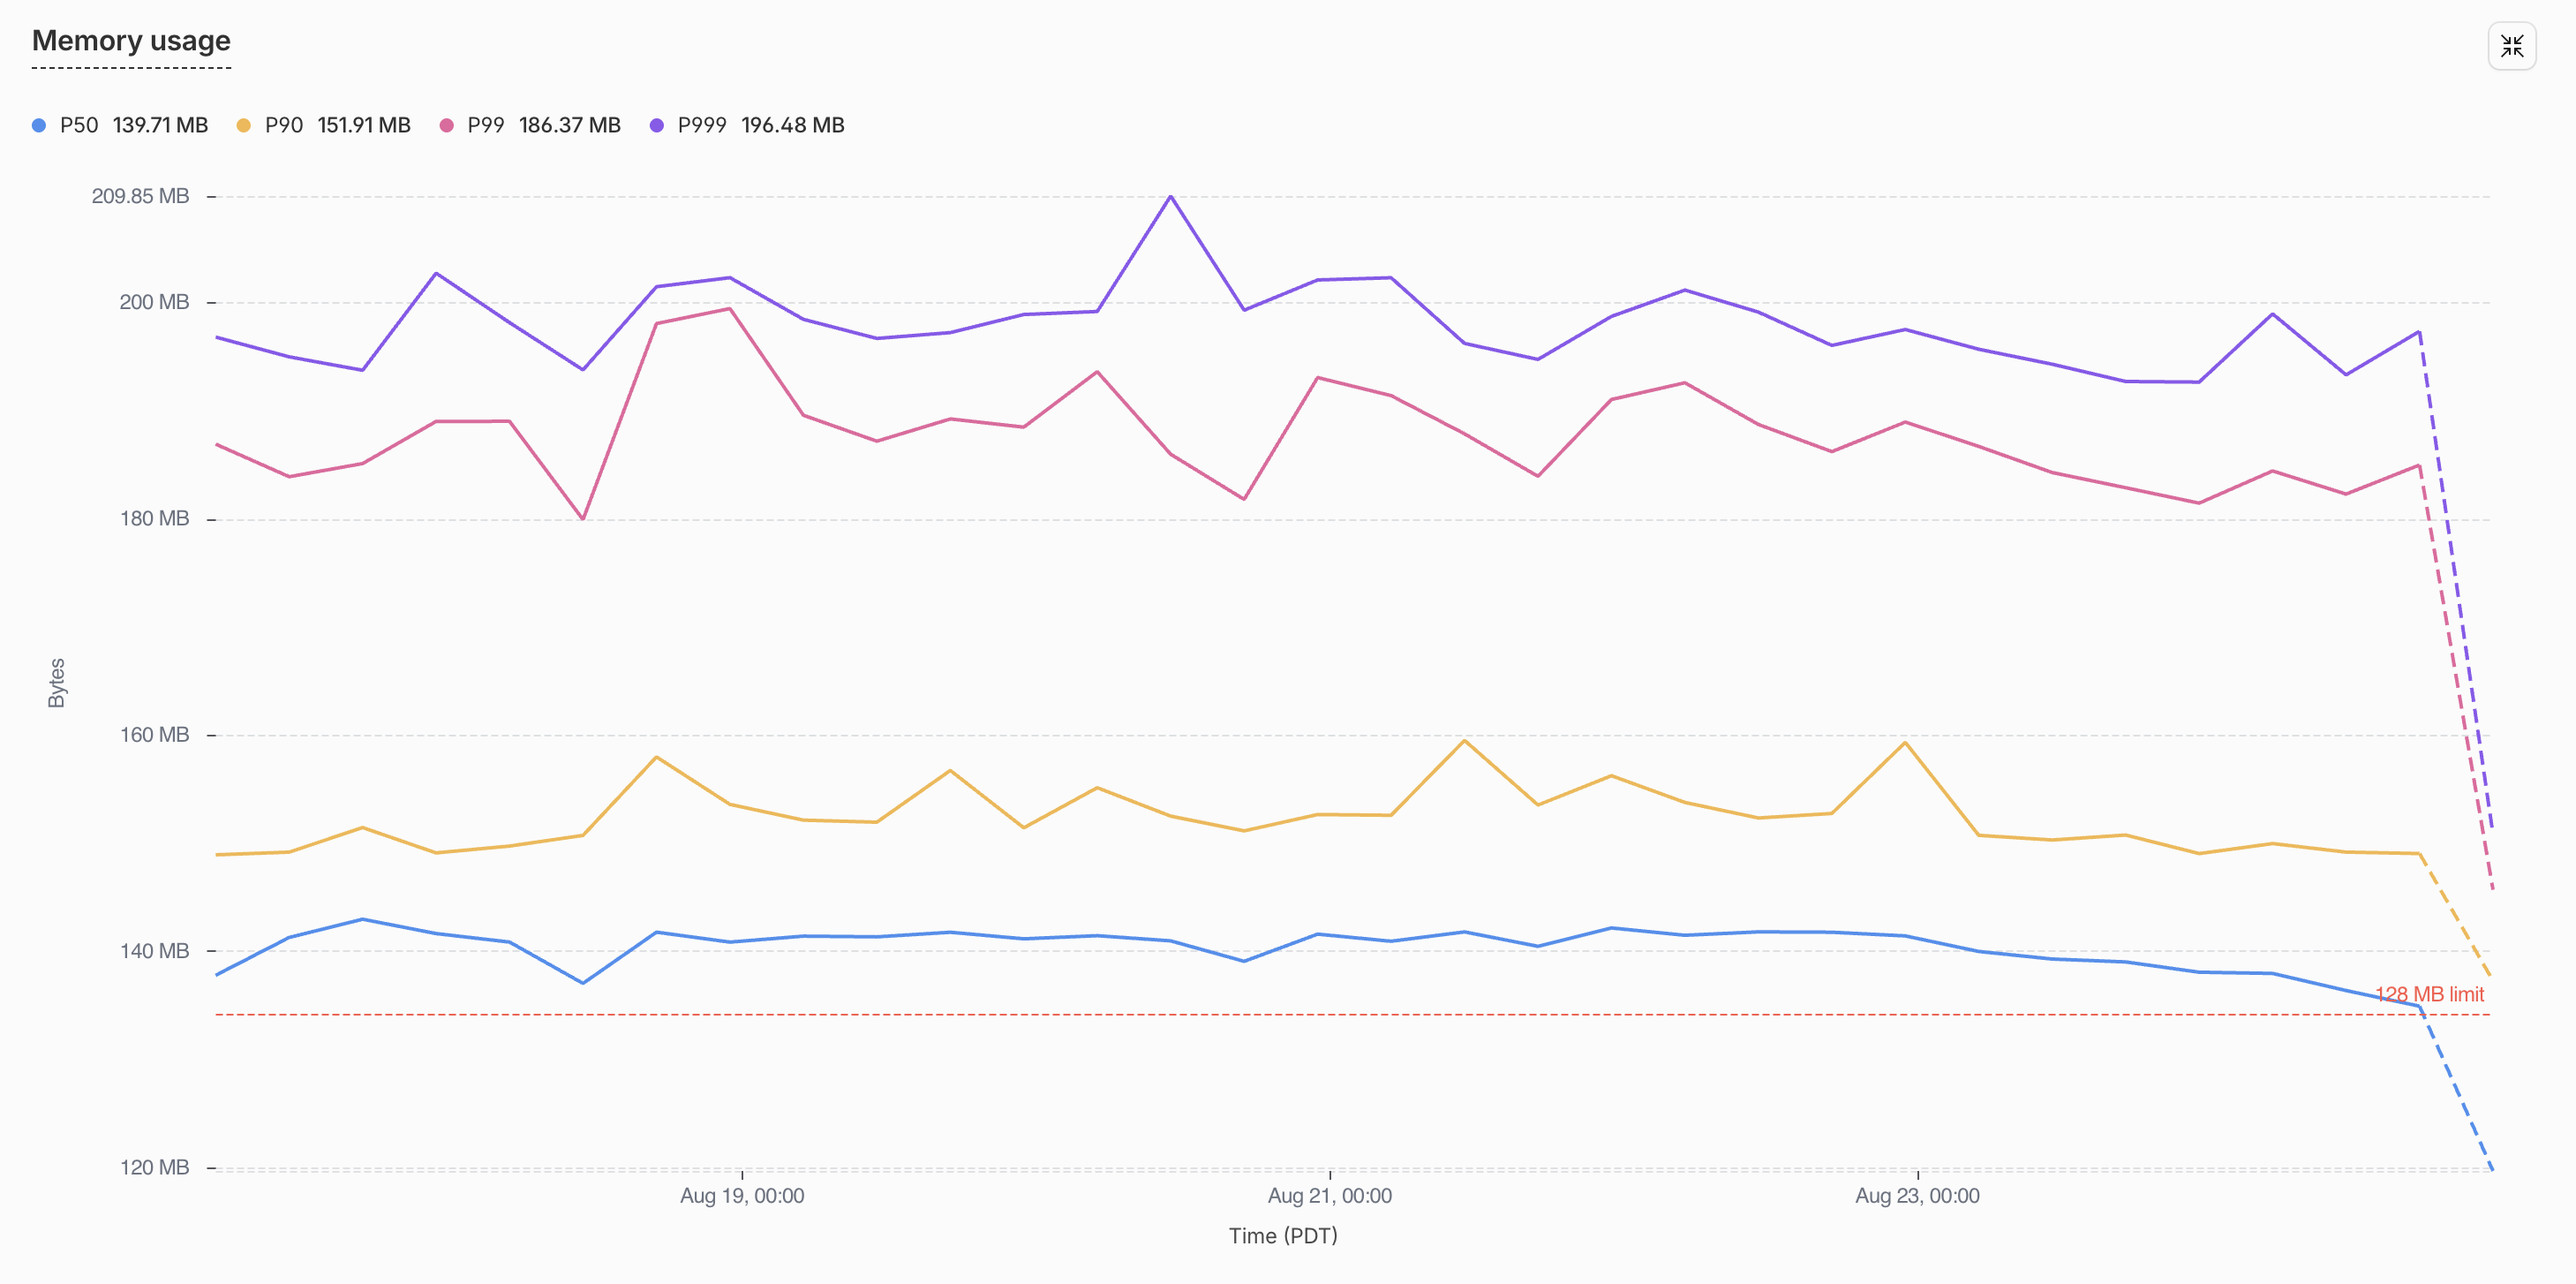
O isolate mediano, a linha azul na figura 1, ficou em cerca de 140 MB durante a semana inteira, e o percentil 99 ficou perto de 190 MB. As duas linhas estão acima do limite tracejado de 128 MB, o que significa que o isolate típico do namespace já tinha passado do ponto em que a Cloudflare tem o direito de reiniciá-lo, e só era poupado até a próxima alocação empurrá-lo para fora. O que o gráfico não mostrava era qualquer relação com o tráfego. A linha era tão plana nas horas calmas quanto nas movimentadas, e nenhum dos cerca de 300 reinícios por dia vinha com um stack trace, porque nunca era o nosso código que lançava a exceção.
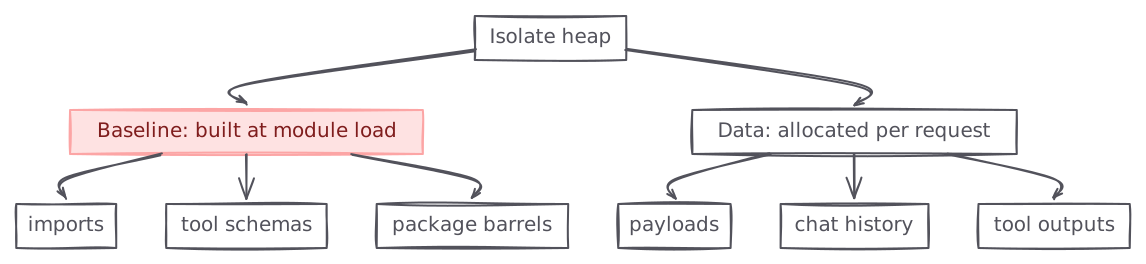
Olhamos onde você esperaria olhar primeiro. Lemos os tamanhos dos payloads, conferimos como o histórico de chat era truncado e procuramos na curva de memória um padrão de requisições, e não encontramos nada que movesse a linha. Essa planura acabou sendo a pista importante. A memória de um isolate é uma de duas coisas: é dado, ou seja, payloads de requisições, histórico de chat, saídas de ferramentas e qualquer outra coisa alocada enquanto se serve tráfego, ou é baseline, ou seja, os objetos que o próprio código cria quando um módulo carrega e mantém vivos pela vida do isolate, como imports, funções e schemas. Dado sobe e desce com as requisições, enquanto baseline está lá antes da primeira requisição e nunca vai embora, então um gráfico alto e plano em ociosidade está descrevendo baseline. O problema tinha que estar no que estávamos lançando, e não no que estávamos servindo.
Por que a memória de baseline é tão fácil de deixar passar
A memória de baseline se esconde em dois lugares onde você normalmente não olha.
O primeiro é o bundler. Presumimos que o tree shaking remove o código que não usamos, e em geral remove, mas o esbuild tem regras sobre quando pode podar e elas não são as regras que você imaginaria. Um pacote sem "sideEffects": false no package.json nunca é podado. Um export * dentro de um módulo avaliado preguiçosamente também nunca é podado. Um import() dinâmico da raiz de um pacote marca todos os exports como usados. Voltaremos a cada um deles nas correções, porque eles explicam metade dos 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
O segundo é a biblioteca de schemas. Tipos parecem de graça porque desaparecem em tempo de compilação, mas um schema zod não é um tipo, é uma árvore de closures construída no momento em que seu módulo é avaliado. Um schema de objeto zod 4 de tamanho médio, uma dúzia de campos com descrições e refinamentos, custa ~134 KB de heap. Um z.string() puro custa ~12 KB. O objeto JSON schema simples equivalente custa algumas centenas de bytes. Nada disso está no README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Não tínhamos feito nada exótico
Cada um dos nossos problemas veio de um padrão. Cada ferramenta de agente declarava sua entrada com z.object() no escopo do módulo, porque é assim que a documentação faz. Cada pacote interno tinha um barrel index.ts com export * from "./zod", porque é arrumado. Alguns caminhos usavam await import("@scope/package") porque carregamento preguiçoso deveria ser mais barato. Cada escolha é razoável sozinha. Juntas, eram 130 MB, em um isolate com 128 para gastar.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
O que isso estava nos custando
Nosso agente tem mais de 250 ferramentas, que ele usa por code mode e workers dinâmicos. Só as definições zod delas custavam 78 MB de heap no carregamento dos módulos, mais da metade do orçamento do isolate, gastos com descrições de argumentos antes de qualquer uma ser chamada. Cada ferramenta que adicionávamos custava mais ~134 KB, rodasse ela alguma vez ou não.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Os reinícios também não eram de graça. Cada exceededMemory joga fora um turno de agente em andamento: uma nova tentativa, uma segunda chamada ao modelo, um usuário olhando para um spinner. A ~300 por dia isso deixa de ser um incidente e vira um imposto permanente, e por causa da colocação ele era pago por qualquer objeto que estivesse no isolate naquele momento.
Error: Durable Object's isolate exceeded its memory limit and was reset.Como encontramos: um profiler de heap para o bundle de produção
Não podíamos perfilar a produção, então construímos um pequeno profiler que roda localmente no exato bundle que a produção roda. Ele mede o custo de heap V8 de avaliar cada módulo e imprime uma tabela classificada. Rodamos em loop: perfilar, remover o topo da classificação, perfilar de novo. A verificação final de cada correção foi um deploy em produção comparado com as métricas de memória da Cloudflare dos dois lados do marcador de deploy.
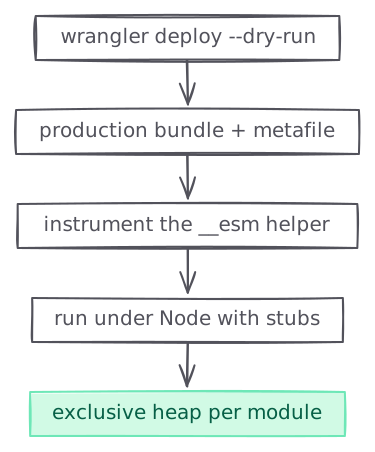
Três ideias fazem isso funcionar:
- Mesmo bundle.
wrangler deploy --dry-run --outdir --metafileemite o exato bundle esbuild que um deploy enviaria, mais o grafo de módulos dele. Tudo é medido nesse bundle. - Atribuição por módulo. O esbuild envolve módulos avaliados preguiçosamente em closures inicializadoras
__esm(...). Reescrevemos esse único helper no bundle construído para que cada inicialização de módulo registrev8.getHeapStatistics().used_heap_sizeantes e depois de si mesma, com uma pilha de inicialização separando o custo próprio de um módulo (exclusivo) do custo de suas dependências (inclusivo). O resultado é um conjunto de dados em forma de flamegraph. - Execuções controladas. O bundle instrumentado roda sob Node puro com um shim de loader que resolve imports
cloudflare:*para stubs.
A receita completa, pronta para colar em um agente de programação, está no fim deste post. Os custos unitários do zod citados acima vêm de um micro-benchmark rodado pelo mesmo harness.
O que o primeiro perfil mostrou
| Fonte | Heap exclusivo |
|---|---|
packages/tools (250+ definições de ferramentas de agente, zod) | 78.0 MB |
| Barrels de pacotes reexportando módulos de schema zod (linhas abaixo) | ~66 MB |
durable-workspaces (estado e agendamentos do workspace) | 15.6 MB |
thread-core (camada de dados das threads) | 10.1 MB |
durable-automations (definições de automações) | 9.6 MB |
durable-threads (lista de threads e atualizações ao vivo) | 7.3 MB |
durable-automation (uma execução de automação) | 6.8 MB |
db (cliente e modelos do D1) | 6.3 MB |
durable-skills (definições de skills) | 5.7 MB |
durable-autofixes (branches e merges de autofix) | 4.9 MB |
| 12 pacotes menores | ~9 MB |
A segunda linha é a surpreendente. São schemas que chegam ao bundle apenas através de export * from "./zod" em barrels de pacotes. Nosso código nunca os usava, o tree shaker não conseguia removê-los, e eles custavam um terço do limite de memória, tudo em módulos que nada jamais chamava.
Correção A: definições de ferramentas como dados, não código
Cada definição de ferramenta declarava seu schema de entrada em zod e o convertia para JSON schema em tempo de execução, porque JSON schema é o que o modelo recebe de qualquer forma. Estávamos construindo ~134 KB de closures por ferramenta para produzir algumas centenas de bytes de dados, então escrevemos os dados diretamente.
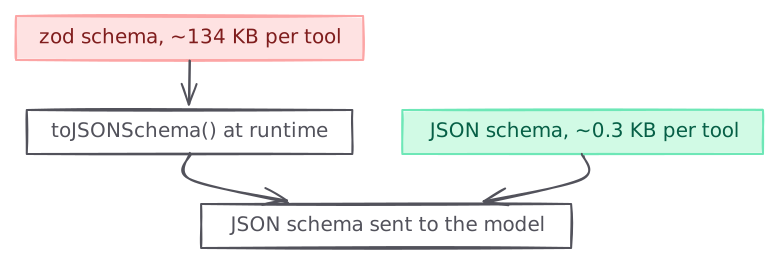
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters é um wrapper fino sobre o jsonSchema() do AI SDK. ParametersInput é o json-schema-to-ts fazendo a inferência de tipos que o zod fazia. A validação em tempo de execução migrou para um validador de ~300 linhas que reproduz as propriedades de que o loop do agente depende: chaves desconhecidas removidas, valores padrão preenchidos, unions resolvidas por discriminador, e mensagens de erro redigidas para que o modelo consiga consertar sua própria chamada de ferramenta na nova tentativa.
O heap de avaliação de módulos foi de 218.6 para 154.0 MB localmente, e packages/tools de 78 MB para 0.7 MB. Em produção, os reinícios caíram de 40-110 por hora para 0-6 por hora no marcador de deploy, e a memória do isolate mediano de ~140 MB para ~120 MB.
Correção B: barrels que realmente podem passar por tree shaking
Os ~66 MB restantes eram schemas que o isolate nunca usava. Três comportamentos do bundler explicam isso:
- Sem
"sideEffects": falsenopackage.jsonde um pacote, o esbuild não poda nada dele. - Mesmo com a flag,
export * from "./zod"nunca é podado dentro de um módulo avaliado preguiçosamente, e qualquer coisa alcançável por umimport()dinâmico é avaliada preguiçosamente. Reexports nomeados (export { zFoo } from "./zod") são podados normalmente. await import("@scope/package")materializa o objeto namespace inteiro do pacote, marcando todos os exports como usados: schemas, classes, tudo.
Confirmamos cada um deles com uma fixture de cinco arquivos construída com a versão do esbuild que o wrangler embute: uma entrada, um pacote com um barrel index.ts, um zod.ts contendo um schema cujo construtor anuncia quando roda, uma classe do.ts importando esse schema, e um intermediário preguiçoso entre eles. A tabela registra se o construtor do schema rodou na avaliação para cada combinação.
| Entrada importa o barrel via | Formato do reexport no barrel | sideEffects: false | Schema incluído |
|---|---|---|---|
| Import estático | export * | Sim | Não |
| Import estático | export * | Não | Sim |
import() dinâmico do pacote | Qualquer | Sim | Sim |
| Import estático a partir de um módulo carregado preguiçosamente | export * | Sim | Sim |
| Import estático a partir de um módulo carregado preguiçosamente | Lista nomeada | Sim | Não |
| Qualquer | Lista nomeada | Não | Sim |
As linhas 3 e 4 são as duas que surpreendem as pessoas, e juntas respondiam pelos ~66 MB. Eis o que um barrel estava fazendo conosco:
A correção é mecânica: "sideEffects": false em todos os 110+ pacotes do workspace, reescrever o export * dos barrels como listas de reexports nomeados, e substituir await import("@scope/package") de raízes de pacotes por imports nomeados estáticos.
Uma ablação no bundle real de produção mostra que cada peça é necessária.
| Configuração | Heap após a avaliação dos módulos | Módulos de schema no bundle |
|---|---|---|
| Baseline (após a correção A) | 154.0 MB | 77 |
sideEffects: false sozinho | 143.6 MB | 77 |
+ Imports estáticos, barrels de volta a export * (controle) | 98.6 MB | 29 |
| + Listas de reexports nomeados (correção completa) | 82.1 MB | 0 |
A linha de controle é a interessante: mesmo um grafo de imports totalmente estático mantém 29 módulos de schema, então as listas nomeadas não são opcionais.
O estado final
| Heap de escopo de módulo (sonda local) | Memória mediana em produção | Reinícios em produção | |
|---|---|---|---|
| Antes | 218.6 MB | ~140 MB | ~300/dia |
| Após A | 154.0 MB | ~120 MB | ~10/dia |
| Após A+B | 82.1 MB | ~70 MB | 0 |
Um Durable Object que ficava ocioso acima do limite de memória da plataforma agora fica ocioso em pouco mais da metade dele, e os ~300 reinícios diários sumiram.
Isto não é uma flag de configuração
Reescrever mais de 250 definições de ferramentas de zod para JSON schema puro, e escrever um validador de 300 linhas para substituir o que o zod fazia por nós, levou alguns dias, mesmo com agentes de programação. Adicionar sideEffects: false a mais de 100 pacotes e transformar cada export * em uma lista nomeada gerada é trabalho sem glamour, e depois você faz o typecheck do repositório inteiro e conserta o que quebra. A alternativa fácil é adicionar uma nova tentativa e conviver com os reinícios, e muitos times fazem isso. Se o seu Durable Object está perto do limite em ociosidade, eu diria que a semana vale a pena, porque o limite não se move e a sua contagem de ferramentas só aumenta.
As três coisas que eu gostaria de ter sabido desde o primeiro dia:
- Alto e plano em ociosidade significa baseline. Perfile o que você lança, não o que você serve.
- Tree shaking tem regras.
sideEffects: false, reexports nomeados, imports estáticos. Deixe uma passar e o pacote inteiro vai junto. - Schemas são código, não tipos. Se o consumidor quer JSON schema, escreva JSON schema.
Faça isto hoje para corrigir a memória do seu Durable Object
O profiler tem ~100 linhas, sem dependências além de Node e wrangler. Cole a receita abaixo no seu agente de programação na raiz de qualquer repositório que faça deploy com wrangler, leia as dez primeiras linhas da tabela que ele imprime e veja o que está lá. Depois desça pela lista: JSON schema puro para qualquer coisa que o modelo receba como JSON schema de qualquer forma, "sideEffects": false e reexports nomeados para os barrels, imports estáticos para as raízes de pacotes.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Se quiser a auditoria inteira feita por você, aqui vai uma skill para o seu agente de programação:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Também adicionamos essa skill ao próprio Polylane, então todo usuário do Polylane recebe essa investigação profunda da memória dos seus Durable Objects logo de saída, sem nada para colar.