

Як ми виправили помилки перевищення пам'яті в наших Cloudflare Durable Objects
Explore with AI
Кожен тред агента в Polylane працює всередині власного Cloudflare Durable Object, і всі вони є екземплярами одного класу. У серпні 2026 року Durable Objects наших тредів скидалися приблизно 300 разів на день через перевищення ліміту пам’яті. Ту саму історію ми чули від кількох команд, які запускають свої агентні процеси на Cloudflare Durable Objects.
Якщо ви натрапляли на exceededMemory у Durable Object, звична порада полягає в тому, щоб подивитися, що виділяють ваші запити: надто великий payload, історія чату, яка росте без обмежень, кеш, який ніколи не витісняє. Ніщо з цього не стосувалося нас. Ізолят перевищував ліміт ще до того, як обслужив перший запит, тож вага мала бути в коді, який ми випускали, а не в даних, які ми обслуговували.
Ця публікація про те, що насправді було в купі, як ми це знайшли на платформі, яка не дозволяє під’єднати профайлер, і про дві зміни, які зменшили пам’ять на рівні модулів із 218 МБ до 82 МБ, а скидання до нуля.
Cloudflare Durable Objects за одну хвилину
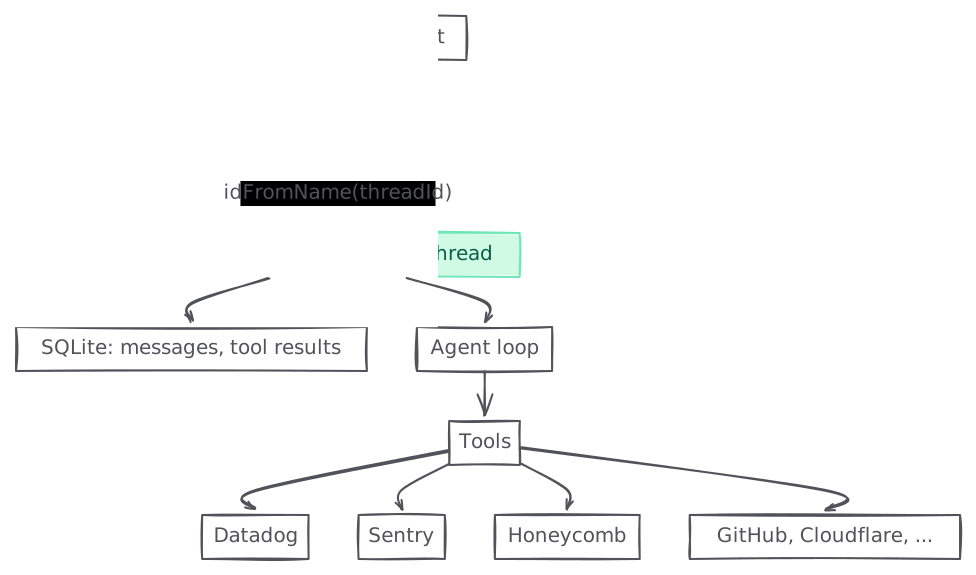
Якщо ви ними не користувалися: Durable Object є невеликим однопотоковим сервером зі станом, унікальність якого для заданого ідентифікатора гарантує Cloudflare. Викличте idFromName() з цим ідентифікатором із Worker, і кожен запит до нього, з будь-якої точки світу, потрапляє на той самий екземпляр із власною базою даних SQLite, станом у пам’яті та алярмами. Він засинає в простої і прокидається там, де зупинився.
У Polylane ми створюємо екземпляр Durable Object для кожного треду. Кожна розмова з агентом, чи почала її людина, чи алерт, отримує власний Durable Object. SQLite об’єкта зберігає повідомлення треду і результати інструментів, цикл агента працює всередині нього, а його інструменти звертаються до тих провайдерів, які потрібні треду: Datadog, Sentry, Honeycomb, GitHub, Cloudflare та інших. Коли тред затихає, об’єкт засинає, а коли надходить наступне повідомлення, продовжує точно з того місця, де зупинився.
Як працює пам’ять Durable Objects
- Ізоляти і ліміт 128 МБ. Durable Objects працюють всередині ізолятів V8, а ізолят має жорсткий ліміт пам’яті 128 МБ, однаковий на кожному плані і не налаштовуваний.
- Спільне розміщення. Один ізолят розміщує багато Durable Objects одного класу разом із кодом Worker навколо них, і всі вони ділять пам’ять цього ізолята. Ліміт діє на ізолят, а не на об’єкт.
- Шумні сусіди. Через спільне розміщення об’єкт, який скидається, коли ізолят вичерпує пам’ять, часто не є тим об’єктом, який використав пам’ять. Кожен зразок пам’яті, який повідомляє Cloudflare, стосується всього ізолята, як і кожне скидання.
Немає способу під’єднати профайлер пам’яті до продакшн Durable Object: інструменти знімків купи, які документує Cloudflare, працюють із локальною dev-сесією. У Kubernetes ви б увімкнули профілювання і під’єднувалися, доки не знайшли проблему. У workerd process.memoryUsage() є поліфілом unenv, який повертає нулі, а базові показники пам’яті та CPU невидимі для коду, що працює всередині. Що ви отримуєте, це GraphQL API аналітики Cloudflare: перцентилі пам’яті і кількість збоїв на простір імен, заднім числом.
Що нам сказав графік пам’яті
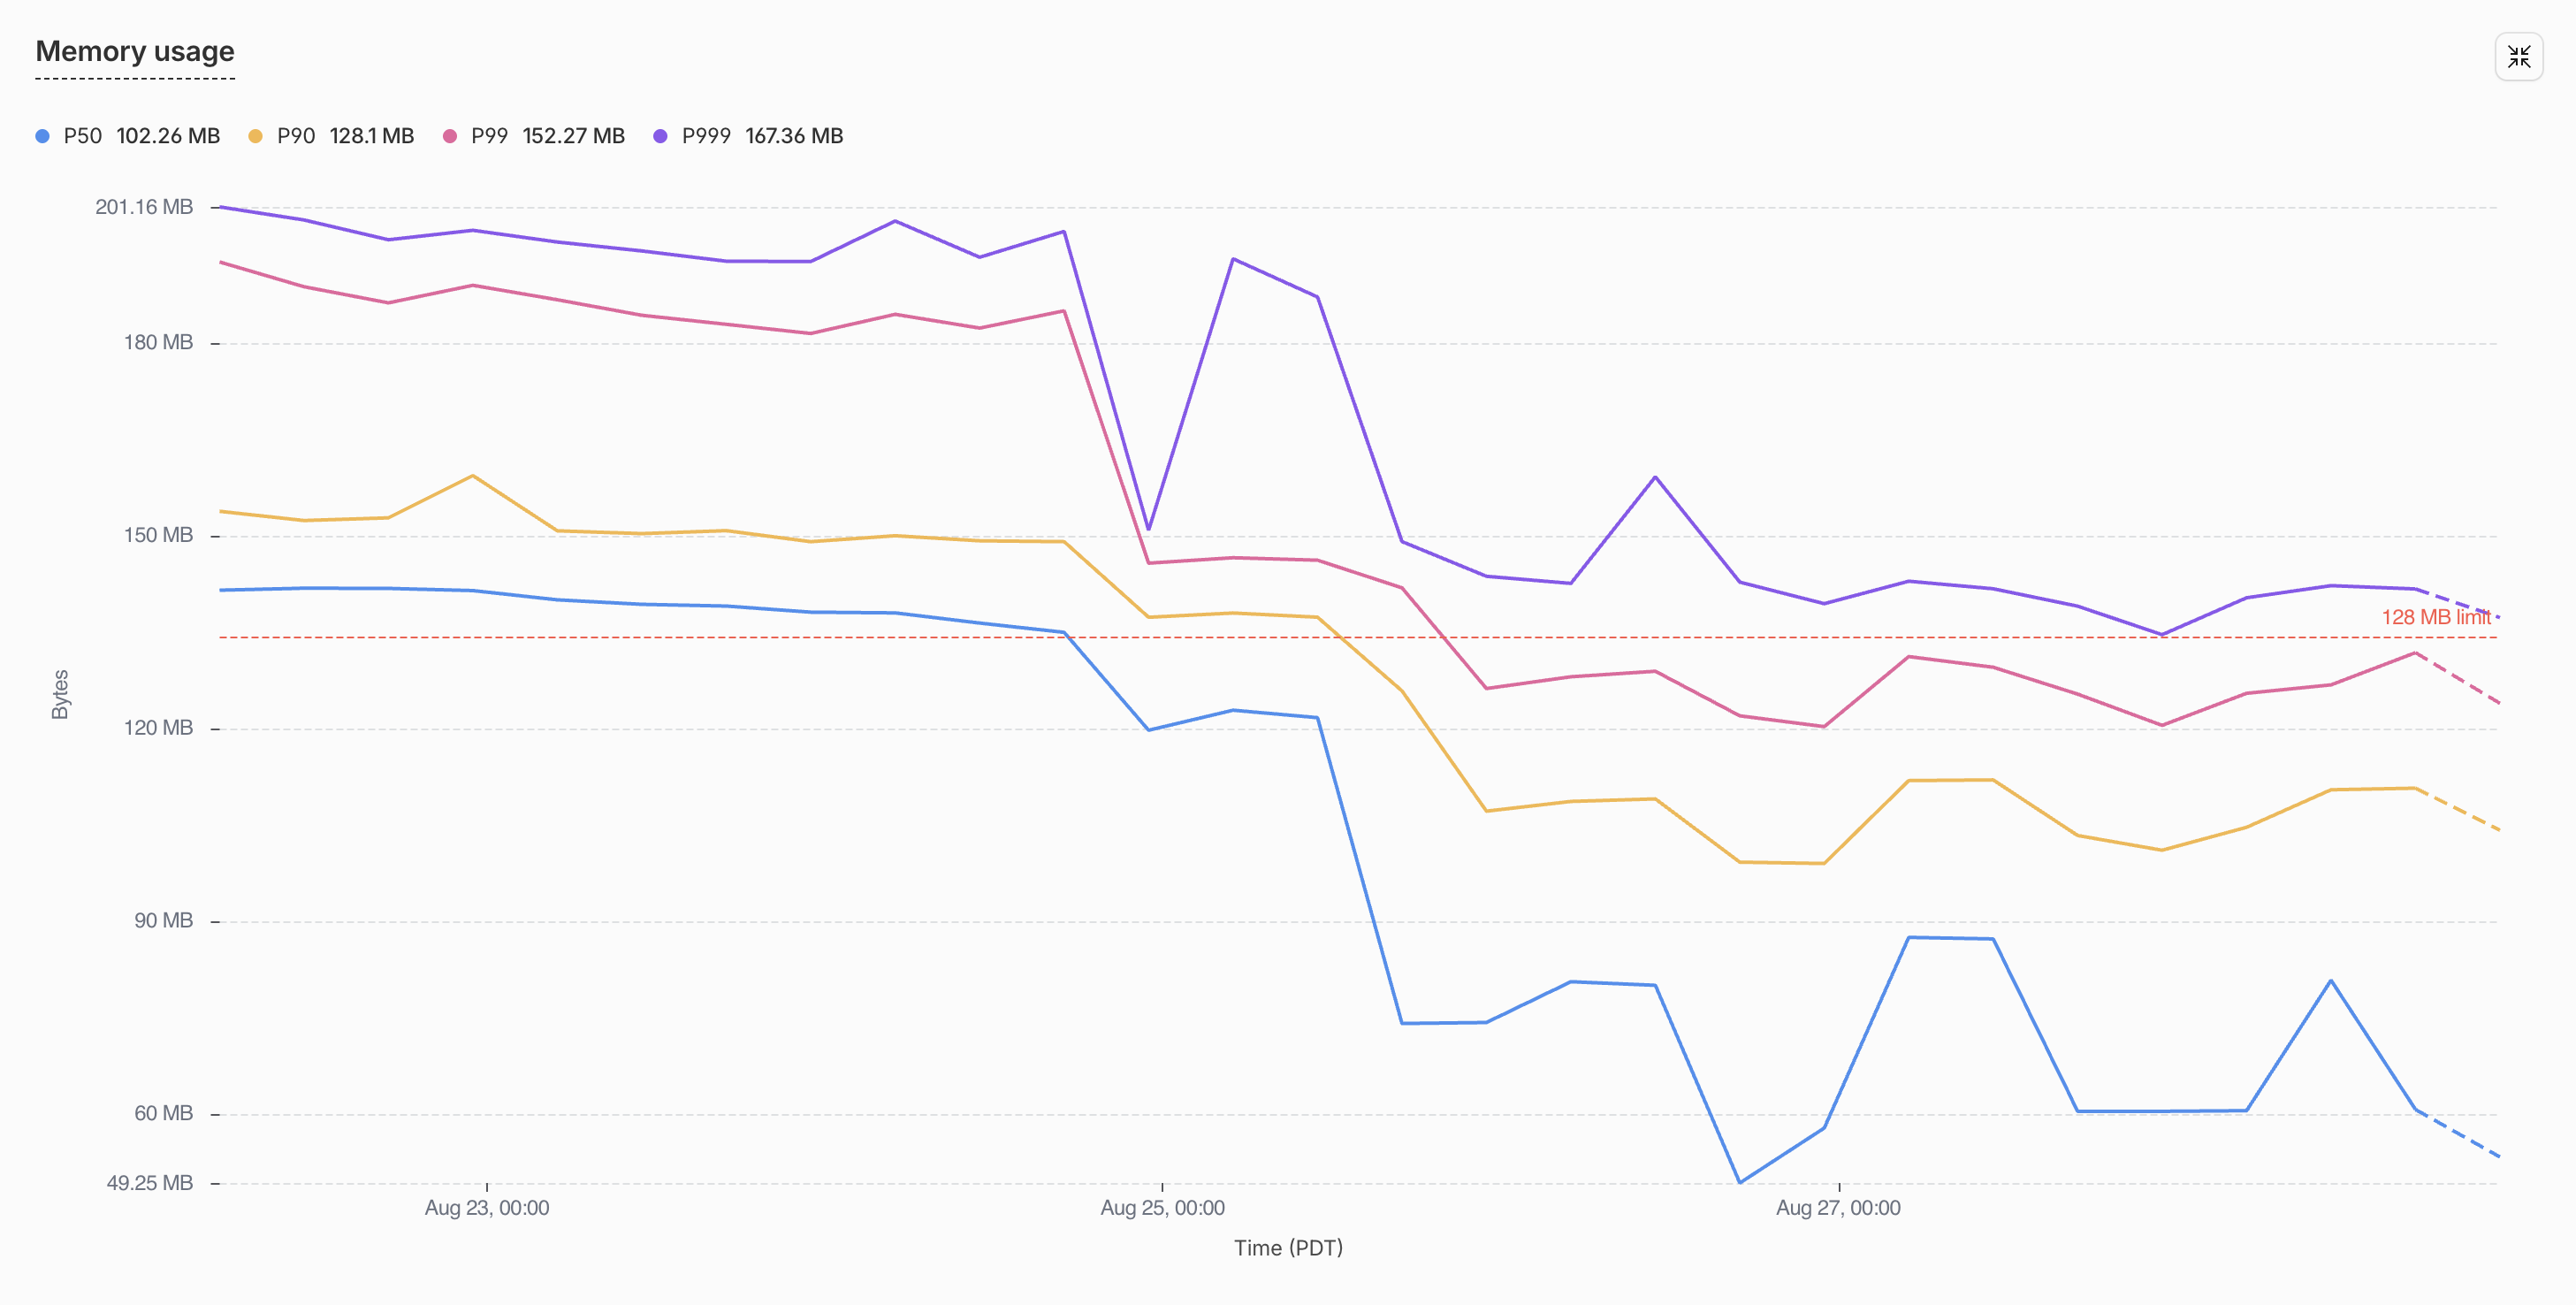
API аналітики Cloudflare повідомляє пам’ять для простору імен Durable Object як перцентилі по ізолятах, які його виконують, у п’ятнадцятихвилинних відрізках, разом із кількістю помилок перевищення пам’яті в кожному відрізку. Кожен графік у цій публікації походить із цього API, відфільтрований до простору імен тредів і порівняний за маркерами розгортань, щойно ми почали випускати виправлення.
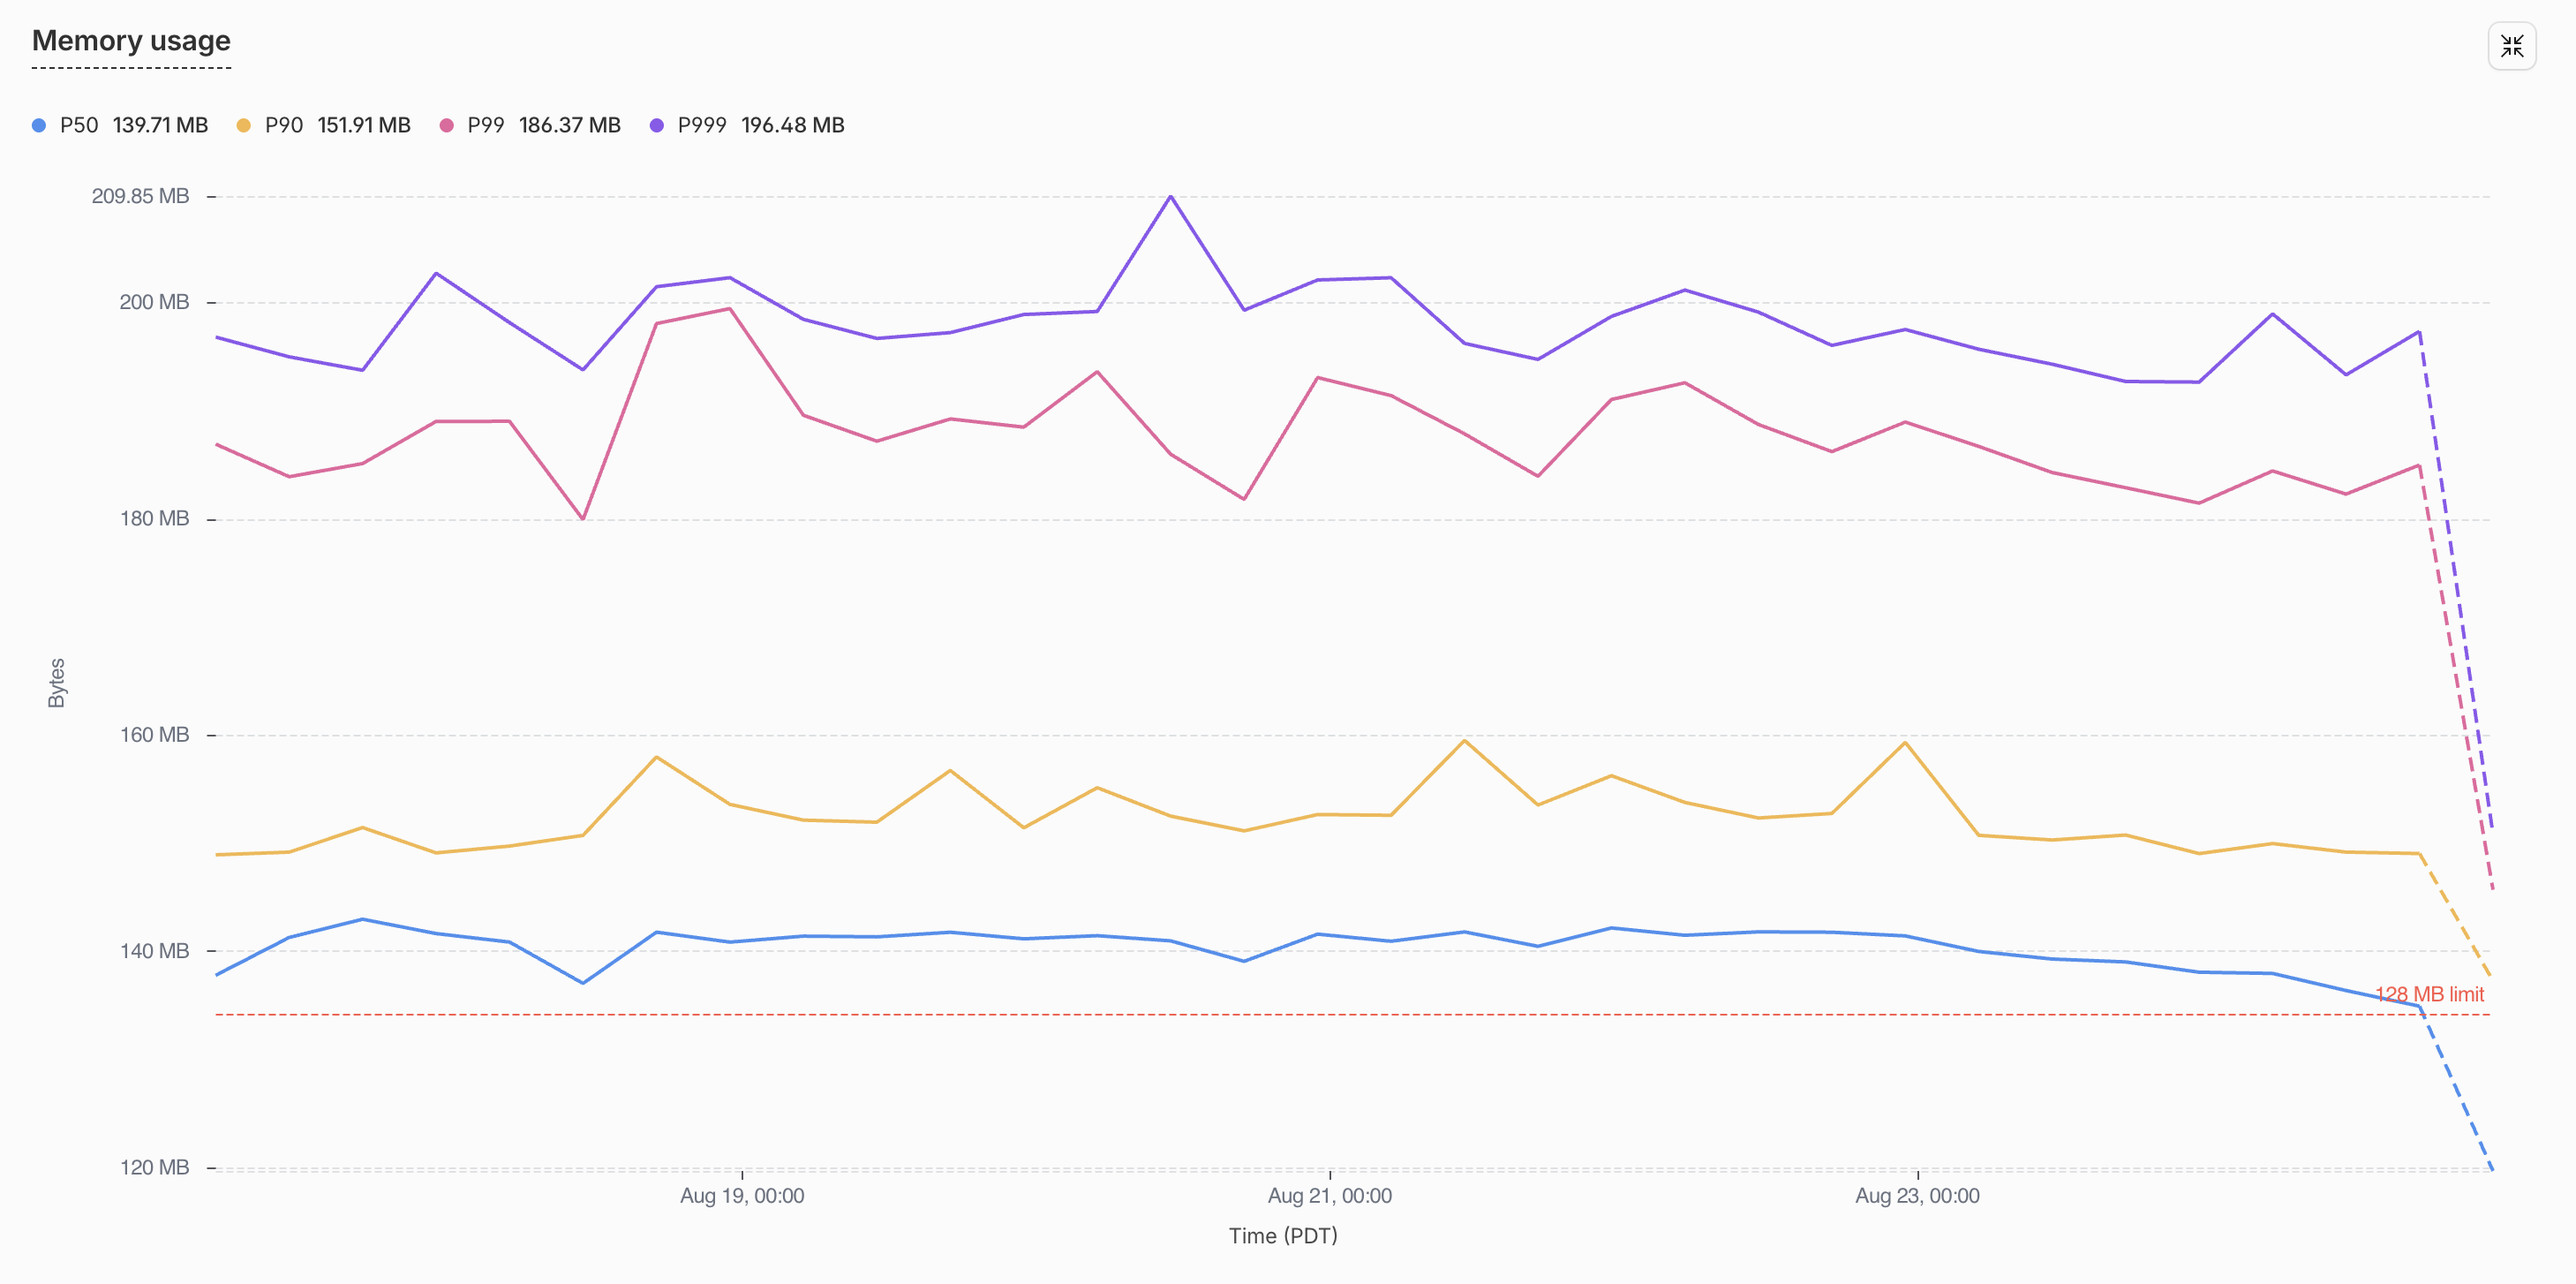
Медіанний ізолят, синя лінія на рисунку 1, увесь тиждень тримався близько 140 МБ, а 99-й перцентиль близько 190 МБ. Обидві лінії над пунктирним лімітом 128 МБ, а це означає, що типовий ізолят у просторі імен уже перейшов точку, за якою Cloudflare має право його скинути, і його лишали в спокої лише до наступного виділення пам’яті, яке перекидало його через межу. Чого графік не показував, це будь-якого зв’язку з трафіком. Лінія була однаково рівною в тихі години і в години навантаження, і жодне з приблизно 300 скидань на день не супроводжувалося трасуванням стека, бо виняток ніколи не кидав наш код.
Ми дивилися туди, куди ви подивилися б спочатку. Ми читали розміри payload, перевіряли, як обрізається історія чату, шукали в кривій пам’яті патерн запитів і не знайшли нічого, що зсувало б лінію. Ця рівність виявилася важливою підказкою. Пам’ять ізолята є однією з двох речей: або це дані, тобто payload запитів, історія чату, виводи інструментів і все інше, виділене під час обслуговування трафіку, або це базовий рівень, тобто об’єкти, які сам код створює під час завантаження модуля і тримає живими протягом усього життя ізолята, як-от імпорти, функції та схеми. Дані ростуть і спадають із запитами, а базовий рівень існує до першого запиту і ніколи не зникає, тож графік, високий і рівний у простої, описує базовий рівень. Проблема мала бути в тому, що ми випускали, а не в тому, що ми обслуговували.
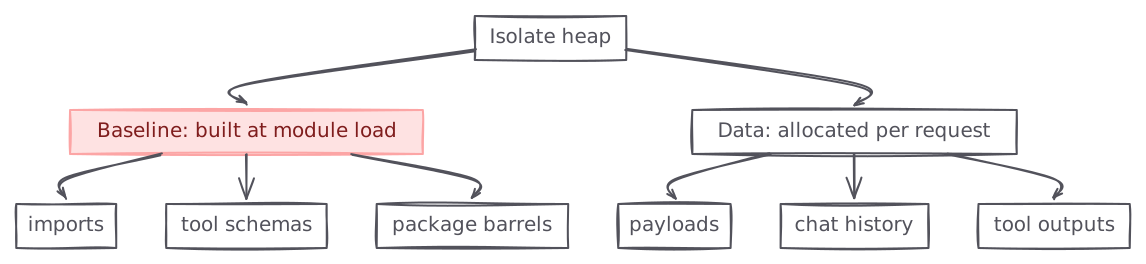
Чому пам’ять базового рівня так легко пропустити
Пам’ять базового рівня ховається у двох місцях, куди ви зазвичай не дивитеся.
Перше: бандлер. Ми вважаємо, що tree shaking видаляє код, який ми не використовуємо, і здебільшого так і є, але esbuild має правила щодо того, коли він може обрізати, і це не ті правила, які ви б припустили. Пакет без "sideEffects": false у своєму package.json не обрізається взагалі. export * всередині ліниво обчислюваного модуля також ніколи не обрізається. Динамічний import() кореня пакета позначає кожен експорт як використаний. Ми повернемося до кожного з них у виправленнях, бо вони пояснюють половину зі 130 МБ.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
Друге: бібліотека схем. Типи здаються безкоштовними, бо вони зникають під час компіляції, але схема zod не є типом, це дерево замикань, яке будується в момент обчислення її модуля. Одна середня об’єктна схема zod 4, десяток полів з описами і уточненнями, коштує ~134 КБ купи. Голий z.string() коштує ~12 КБ. Еквівалентний простий об’єкт JSON schema коштує кількасот байтів. Нічого з цього немає в README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
Ми не робили нічого екзотичного
Кожна з наших проблем походила з типового налаштування. Кожен інструмент агента оголошував свій вхід через z.object() на рівні модуля, бо так роблять у документації. Кожен внутрішній пакет мав barrel index.ts з export * from "./zod", бо це акуратно. Кілька шляхів використовували await import("@scope/package"), бо ліниве завантаження нібито дешевше. Кожен вибір сам по собі розумний. Разом вони становили 130 МБ в ізоляті, який має 128.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Скільки це нам коштувало
Наш агент має понад 250 інструментів, якими він користується через code mode і динамічних воркерів. Лише їхні визначення zod коштували 78 МБ купи під час завантаження модулів, більше половини бюджету ізолята, витрачених на описи аргументів до того, як будь-який із них викликали. Кожен доданий інструмент коштував ще ~134 КБ, незалежно від того, чи запускався він колись.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Скидання також не були безкоштовними. Кожен exceededMemory викидає хід агента, що виконується: повтор, другий виклик моделі, користувач, який дивиться на індикатор завантаження. При ~300 на день це перестає бути інцидентом і стає постійним податком, а через спільне розміщення його платив той об’єкт, який у цей момент опинився в ізоляті.
Error: Durable Object's isolate exceeded its memory limit and was reset.Як ми це знайшли: профайлер купи для продакшн-бандла
Ми не могли профілювати продакшн, тож побудували невеликий профайлер, який працює локально на тому самому бандлі, що й продакшн. Він вимірює вартість обчислення кожного модуля в купі V8 і друкує ранжовану таблицю. Ми запускали його в циклі: профілювати, прибрати верхівку рейтингу, профілювати знову. Остаточною перевіркою кожного виправлення було продакшн-розгортання, порівняне з метриками пам’яті Cloudflare з обох боків маркера розгортання.
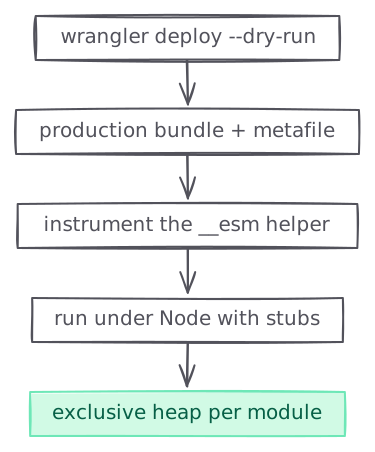
Це працює завдяки трьом ідеям:
- Той самий бандл.
wrangler deploy --dry-run --outdir --metafileвидає точний бандл esbuild, який завантажило б розгортання, плюс його граф модулів. Усе вимірюється на цьому бандлі. - Атрибуція модулів. esbuild обгортає ліниво обчислювані модулі в замикання-ініціалізатори
__esm(...). Ми переписуємо цей єдиний хелпер у зібраному бандлі, щоб кожна ініціалізація модуля записувалаv8.getHeapStatistics().used_heap_sizeдо і після себе, зі стеком ініціалізацій, який відокремлює власну вартість модуля (ексклюзивну) від вартості його залежностей (інклюзивної). Результат є набором даних у формі flamegraph. - Контрольовані запуски. Інструментований бандл працює під звичайним Node із шимом завантажувача, який розв’язує імпорти
cloudflare:*у заглушки.
Повний рецепт, готовий для вставлення в агент кодування, наведено в кінці цієї публікації. Наведені вище одиничні вартості zod походять із мікробенчмарка, виконаного через ту саму обгортку.
Що показав перший профіль
| Джерело | Ексклюзивна купа |
|---|---|
packages/tools (250+ визначень інструментів агента, zod) | 78,0 МБ |
| Barrel пакетів, які реекспортують модулі схем zod (рядки нижче) | ~66 МБ |
durable-workspaces (стан робочих просторів і розклади) | 15,6 МБ |
thread-core (шар даних тредів) | 10,1 МБ |
durable-automations (визначення автоматизацій) | 9,6 МБ |
durable-threads (список тредів і живі оновлення) | 7,3 МБ |
durable-automation (один запуск автоматизації) | 6,8 МБ |
db (клієнт D1 і моделі) | 6,3 МБ |
durable-skills (визначення навичок) | 5,7 МБ |
durable-autofixes (гілки і злиття автовиправлень) | 4,9 МБ |
| 12 менших пакетів | ~9 МБ |
Другий рядок є несподіваним. Це схеми, які потрапляють у бандл лише через export * from "./zod" у barrel пакетів. Наш код ніколи їх не використовував, tree shaker не міг їх видалити, і вони коштували третину ліміту пам’яті, повністю в модулях, які ніщо ніколи не викликало.
Виправлення A: визначення інструментів як дані, а не код
Кожне визначення інструмента оголошувало свою вхідну схему в zod і конвертувало її в JSON schema під час виконання, бо JSON schema є тим, що так чи інакше надсилається моделі. Ми будували ~134 КБ замикань на інструмент, щоб отримати кількасот байтів даних, тож ми написали дані напряму.
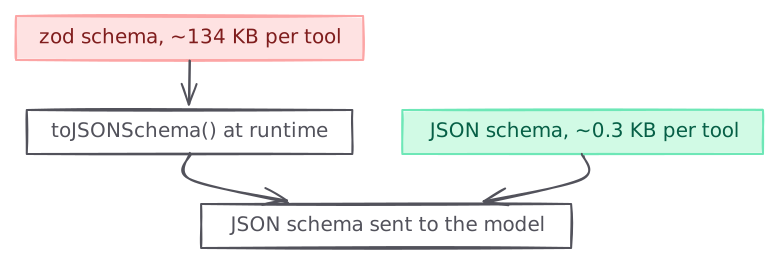
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters є тонкою обгорткою над jsonSchema() з AI SDK. ParametersInput є json-schema-to-ts, який виконує виведення типів, яке раніше робив zod. Валідація під час виконання перейшла у валідатор на ~300 рядків, який відтворює властивості, від яких залежить цикл агента: невідомі ключі вилучаються, значення за замовчуванням заповнюються, об’єднання розв’язуються за дискримінатором, а повідомлення про помилки сформульовані так, щоб модель могла виправити власний виклик інструмента під час повтору.
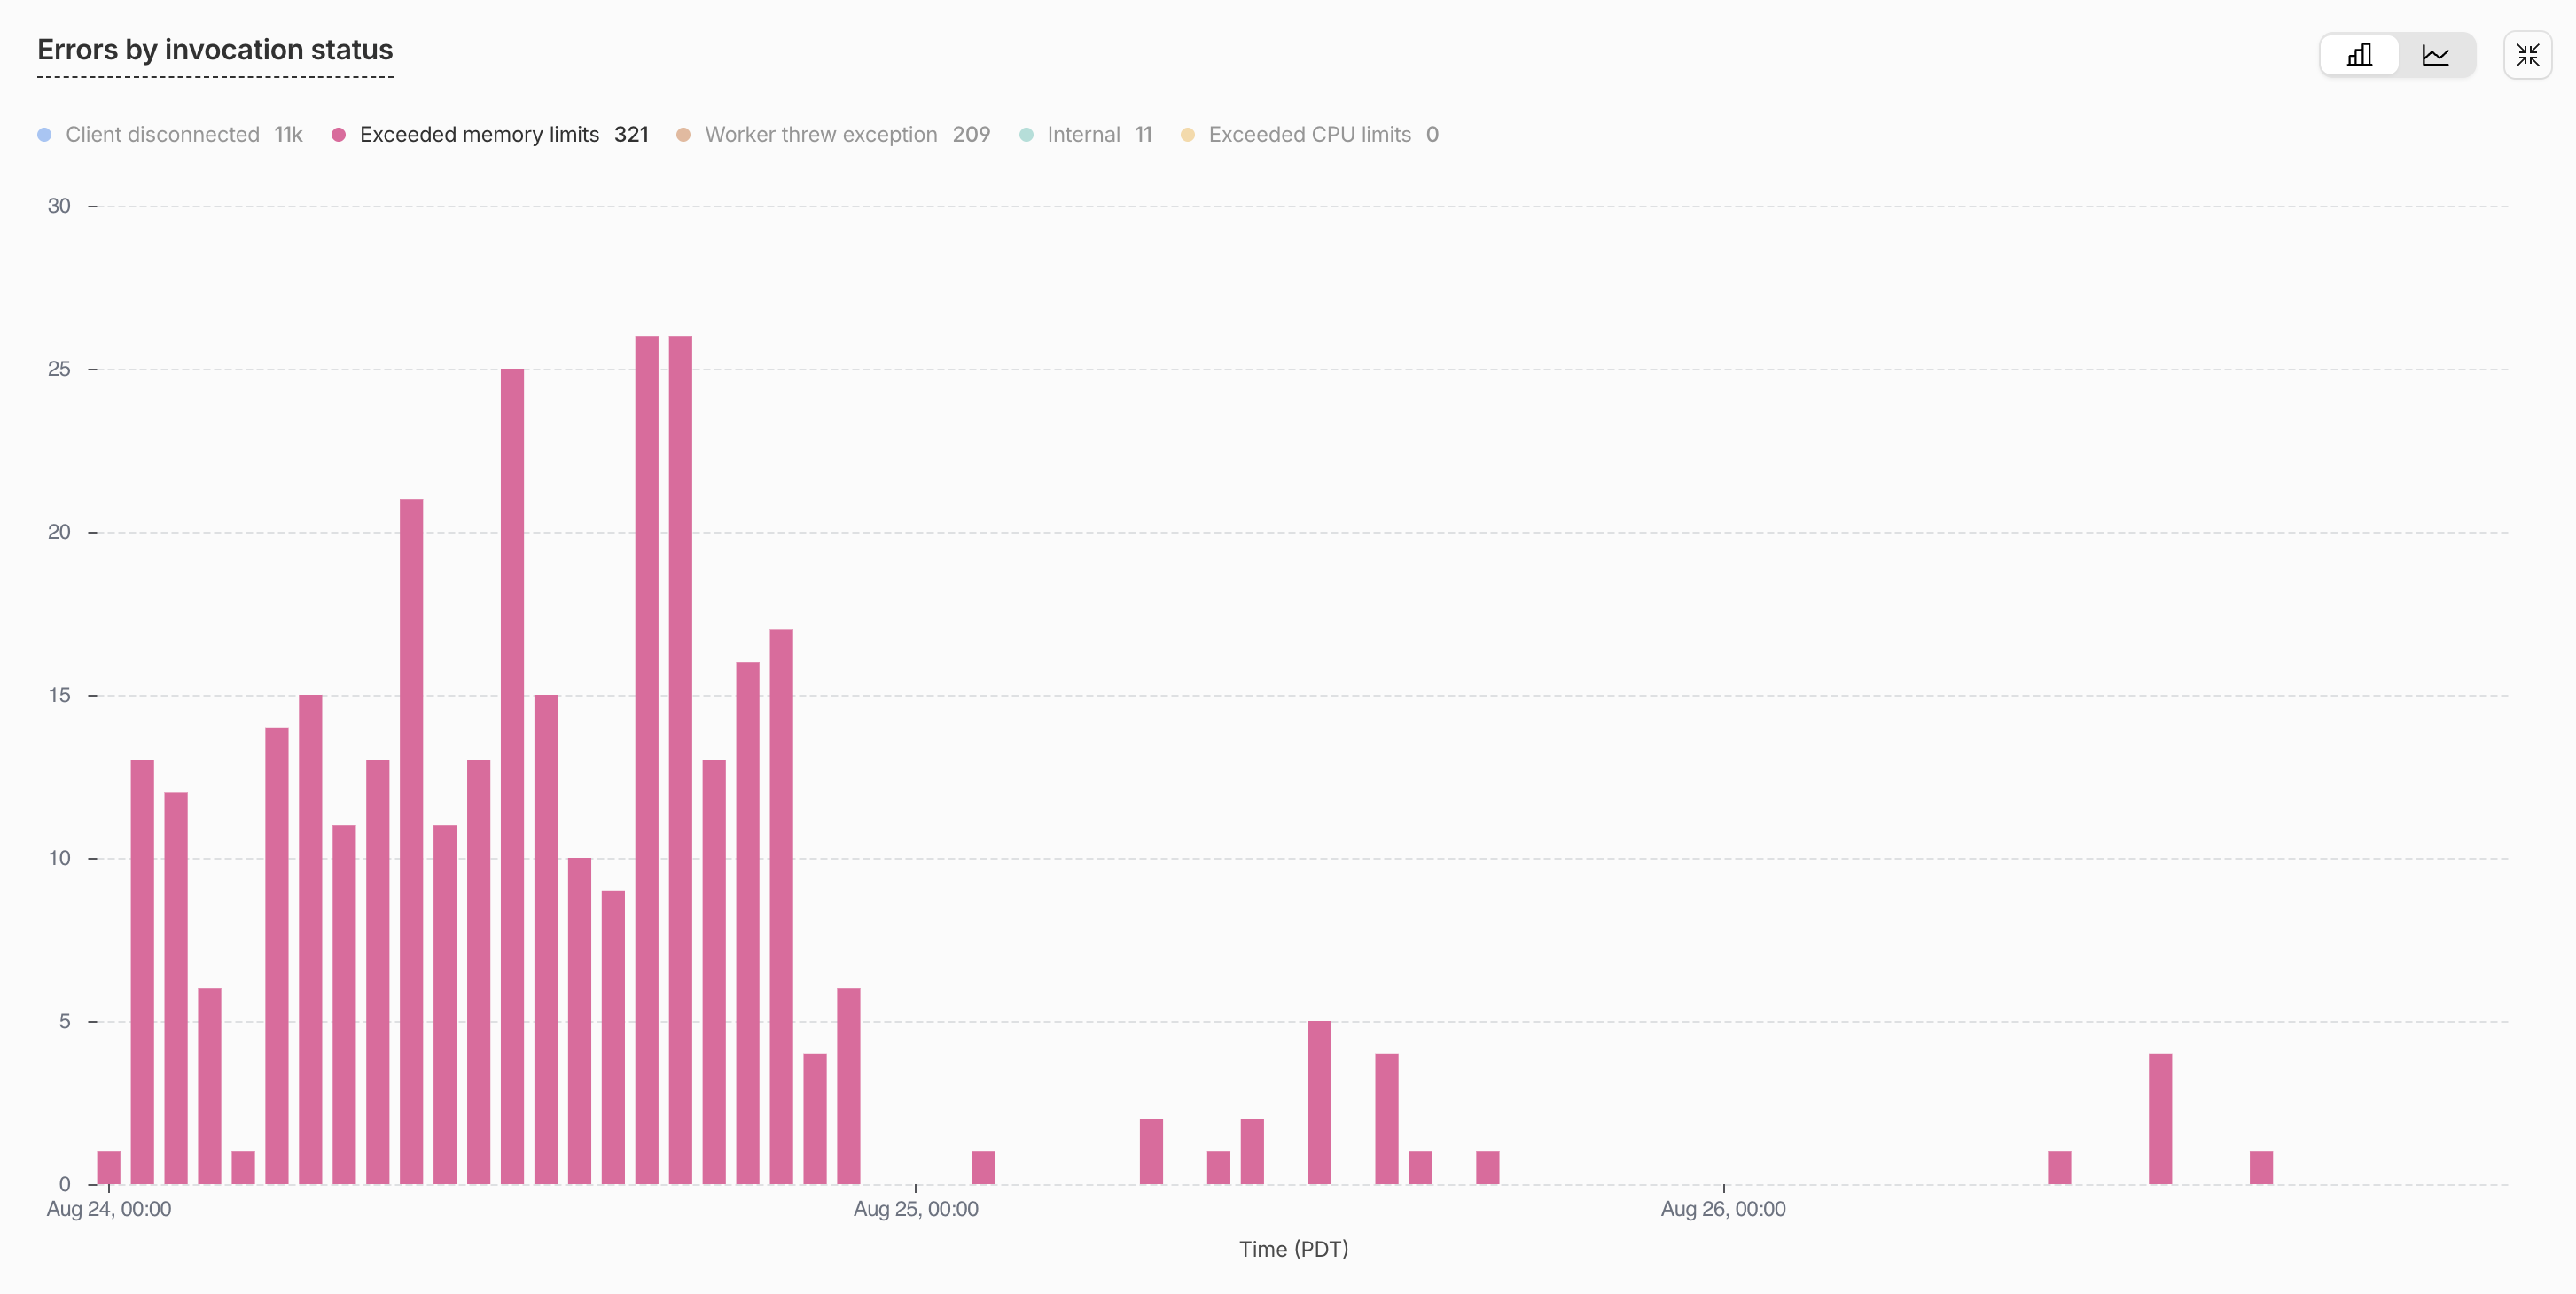
Купа після обчислення модулів локально зменшилася з 218,6 до 154,0 МБ, а packages/tools з 78 МБ до 0,7 МБ. У продакшні скидання впали з 40-110 на годину до 0-6 на годину на маркері розгортання, а пам’ять медіанного ізолята з ~140 МБ до ~120 МБ.
Виправлення B: barrel, які справді піддаються tree shaking
Решта ~66 МБ була схемами, які ізолят ніколи не використовував. Це пояснюють три поведінки бандлера:
- Без
"sideEffects": falseуpackage.jsonпакета esbuild не обрізає з нього нічого. - Навіть із прапорцем
export * from "./zod"ніколи не обрізається всередині ліниво обчислюваного модуля, а все, що досяжне через динамічнийimport(), обчислюється ліниво. Іменовані реекспорти (export { zFoo } from "./zod") обрізаються нормально. await import("@scope/package")матеріалізує весь об’єкт простору імен пакета, позначаючи кожен експорт як використаний: схеми, класи, усе.
Ми підтвердили кожну з них фікстурою з п’яти файлів, зібраною версією esbuild, яку вбудовує wrangler: точка входу, пакет із barrel index.ts, zod.ts з однією схемою, конструктор якої оголошує, коли він виконується, клас do.ts, що імпортує цю схему, і лінивий посередник між ними. Таблиця записує, чи виконувався конструктор схеми під час обчислення для кожної комбінації.
| Точка входу імпортує barrel через | Форма реекспорту в barrel | sideEffects: false | Схема включена |
|---|---|---|---|
| Статичний імпорт | export * | Так | Ні |
| Статичний імпорт | export * | Ні | Так |
Динамічний import() пакета | Будь-яка | Так | Так |
| Статичний імпорт із ліниво завантаженого модуля | export * | Так | Так |
| Статичний імпорт із ліниво завантаженого модуля | Іменований список | Так | Ні |
| Будь-який | Іменований список | Ні | Так |
Рядки 3 і 4 є тими двома, що дивують людей, і разом вони пояснювали ~66 МБ. Ось що один barrel робив із нами:
Виправлення механічне: "sideEffects": false у всіх 110+ пакетах робочого простору, переписати export * у barrel на іменовані списки реекспортів і замінити await import("@scope/package") коренів пакетів на статичні іменовані імпорти.
Абляція на реальному продакшн-бандлі показує, що кожна частина необхідна.
| Конфігурація | Купа після обчислення модулів | Модулі схем у бандлі |
|---|---|---|
| Базова (після виправлення A) | 154,0 МБ | 77 |
Лише sideEffects: false | 143,6 МБ | 77 |
+ Статичні імпорти, barrel повернуто до export * (контроль) | 98,6 МБ | 29 |
| + Іменовані списки реекспортів (повне виправлення) | 82,1 МБ | 0 |
Контрольний рядок є найцікавішим: навіть повністю статичний граф імпортів зберігає 29 модулів схем, тож іменовані списки не є необов’язковими.
Кінцевий стан
| Купа на рівні модулів (локальний зонд) | Медіанна пам’ять у продакшні | Скидання в продакшні | |
|---|---|---|---|
| До | 218,6 МБ | ~140 МБ | ~300/день |
| Після A | 154,0 МБ | ~120 МБ | ~10/день |
| Після A+B | 82,1 МБ | ~70 МБ | 0 |
Durable Object, який у простої перевищував ліміт пам’яті платформи, тепер у простої займає ледве половину, а ~300 щоденних скидань зникли.
Це не прапорець у конфігурації
Переписування понад 250 визначень інструментів із zod на сирий JSON schema і написання валідатора на 300 рядків на заміну того, що zod робив за нас, зайняло кілька днів, навіть з агентами кодування. Додавання sideEffects: false до понад 100 пакетів і перетворення кожного export * на згенерований іменований список є негламурною роботою, після якої ви типізуєте весь репозиторій і виправляєте те, що зламалося. Легка альтернатива полягає в тому, щоб додати повтор і жити зі скиданнями, і чимало команд так і роблять. Якщо ваш Durable Object у простої хоч трохи наближається до ліміту, я б сказав, що цей тиждень того вартий, бо ліміт не рухається, а кількість ваших інструментів лише зростає.
Три речі, які я хотів би знати з першого дня:
- Високо і рівно в простої означає базовий рівень. Профілюйте те, що ви випускаєте, а не те, що обслуговуєте.
- Tree shaking має правила.
sideEffects: false, іменовані реекспорти, статичні імпорти. Пропустіть одне, і весь пакет їде разом. - Схеми є кодом, а не типами. Якщо споживач хоче JSON schema, пишіть JSON schema.
Зробіть це сьогодні, щоб виправити пам’ять свого Durable Object
Профайлер займає ~100 рядків без залежностей, крім Node і wrangler. Вставте рецепт нижче у свій агент кодування в корені будь-якого репозиторію, який розгортається через wrangler, прочитайте перші десять рядків таблиці, яку він надрукує, і подивіться, що там. Потім рухайтеся вниз по списку: простий JSON schema для всього, що модель так чи інакше отримує як JSON schema, "sideEffects": false та іменовані реекспорти для barrel, статичні імпорти для коренів пакетів.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Якщо ви хочете, щоб весь аудит зробили за вас, ось навичка для вашого агента кодування:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
Ми також додали цю навичку в сам Polylane, тож кожен користувач Polylane отримує це глибоке розслідування пам’яті своїх Durable Objects із коробки, без жодного вставлення.