

Cómo arreglamos los errores de memoria excedida de nuestros Durable Objects de Cloudflare
Explore with AI
Cada hilo de agente en Polylane corre dentro de su propio Durable Object de Cloudflare, todos instancias de una misma clase. En agosto de 2026, los Durable Objects de nuestros hilos se reiniciaban unas 300 veces al día por exceder el límite de memoria. Oímos la misma historia de varios equipos que ejecutan sus flujos agénticos sobre Durable Objects de Cloudflare.
Si te has topado con exceededMemory en un Durable Object, el consejo habitual es mirar qué asignan tus solicitudes: un payload demasiado grande, un historial de chat que crece sin límite, una caché que nunca desaloja. Nada de eso se aplicaba a nosotros. El isolate estaba por encima del límite antes de servir una sola solicitud, así que el peso tenía que estar en el código que enviábamos y no en los datos que servíamos.
Este artículo trata de lo que había de verdad en el heap, de cómo lo encontramos en una plataforma que no te deja conectar un profiler, y de los dos cambios que llevaron la memoria a nivel de módulo de 218 MB a 82 MB y los reinicios a cero.
Los Durable Objects de Cloudflare en un minuto
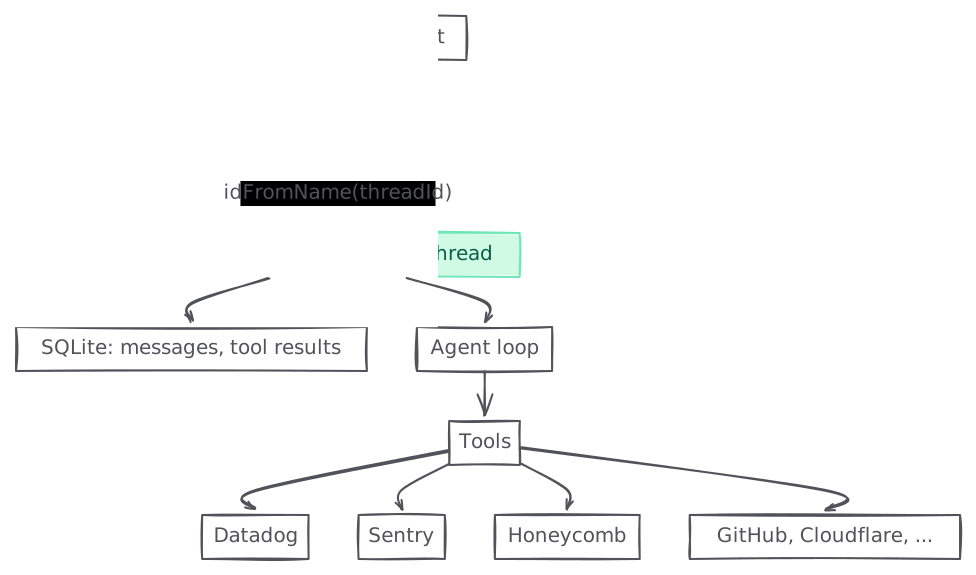
Si no los has usado: un Durable Object es un servidor pequeño, con estado y de un solo hilo, que Cloudflare garantiza que es único para un ID dado. Llama a idFromName() con ese ID desde un Worker y cada solicitud para él, desde cualquier parte del mundo, aterriza en la misma instancia, con su propia base de datos SQLite, su estado en memoria y sus alarmas. Hiberna cuando está inactivo y despierta donde lo dejó.
En Polylane, creamos una instancia de Durable Object por cada hilo. Cada conversación con el agente, la iniciara una persona o una alerta, recibe su propio Durable Object. El SQLite del objeto guarda los mensajes y los resultados de herramientas del hilo, el ciclo del agente corre dentro de él, y sus herramientas llaman a los proveedores que el hilo necesite: Datadog, Sentry, Honeycomb, GitHub, Cloudflare y el resto. Cuando el hilo se queda en silencio el objeto hiberna, y cuando llega el siguiente mensaje retoma exactamente donde se detuvo.
Cómo funciona la memoria de los Durable Objects
- Isolates y el tope de 128 MB. Los Durable Objects corren dentro de isolates de V8, y un isolate tiene un límite fijo de memoria de 128 MB que es el mismo en todos los planes y no es configurable.
- Colocación conjunta. Un solo isolate aloja muchos Durable Objects de la misma clase, junto con el código del Worker que los rodea, y todos comparten la memoria de ese isolate. El límite es por isolate y no por objeto.
- Vecinos ruidosos. Por la colocación conjunta, el objeto que se reinicia cuando el isolate se queda sin memoria a menudo no es el objeto que usó la memoria. Cada muestra de memoria que reporta Cloudflare es la del isolate completo, y también lo es cada reinicio.
No hay forma de conectar un profiler de memoria a un Durable Object en producción: las herramientas de heap snapshot que documenta Cloudflare corren contra una sesión de desarrollo local. En Kubernetes activarías el perfilado y te conectarías hasta encontrar el problema. En workerd, process.memoryUsage() es un polyfill de unenv que devuelve ceros, y las cifras de memoria base y CPU no son visibles para el código que corre dentro. Lo que tienes es la API de analítica GraphQL de Cloudflare: percentiles de memoria y recuentos de fallos por namespace, a posteriori.
Lo que nos dijo la gráfica de memoria
La API de analítica de Cloudflare reporta la memoria de un namespace de Durable Objects como percentiles entre los isolates que lo ejecutan, en cubos de quince minutos, junto al recuento de errores de memoria excedida en cada cubo. Todas las gráficas de este artículo salen de esa API, filtradas al namespace de los hilos y comparadas entre marcadores de despliegue una vez que empezamos a publicar arreglos.
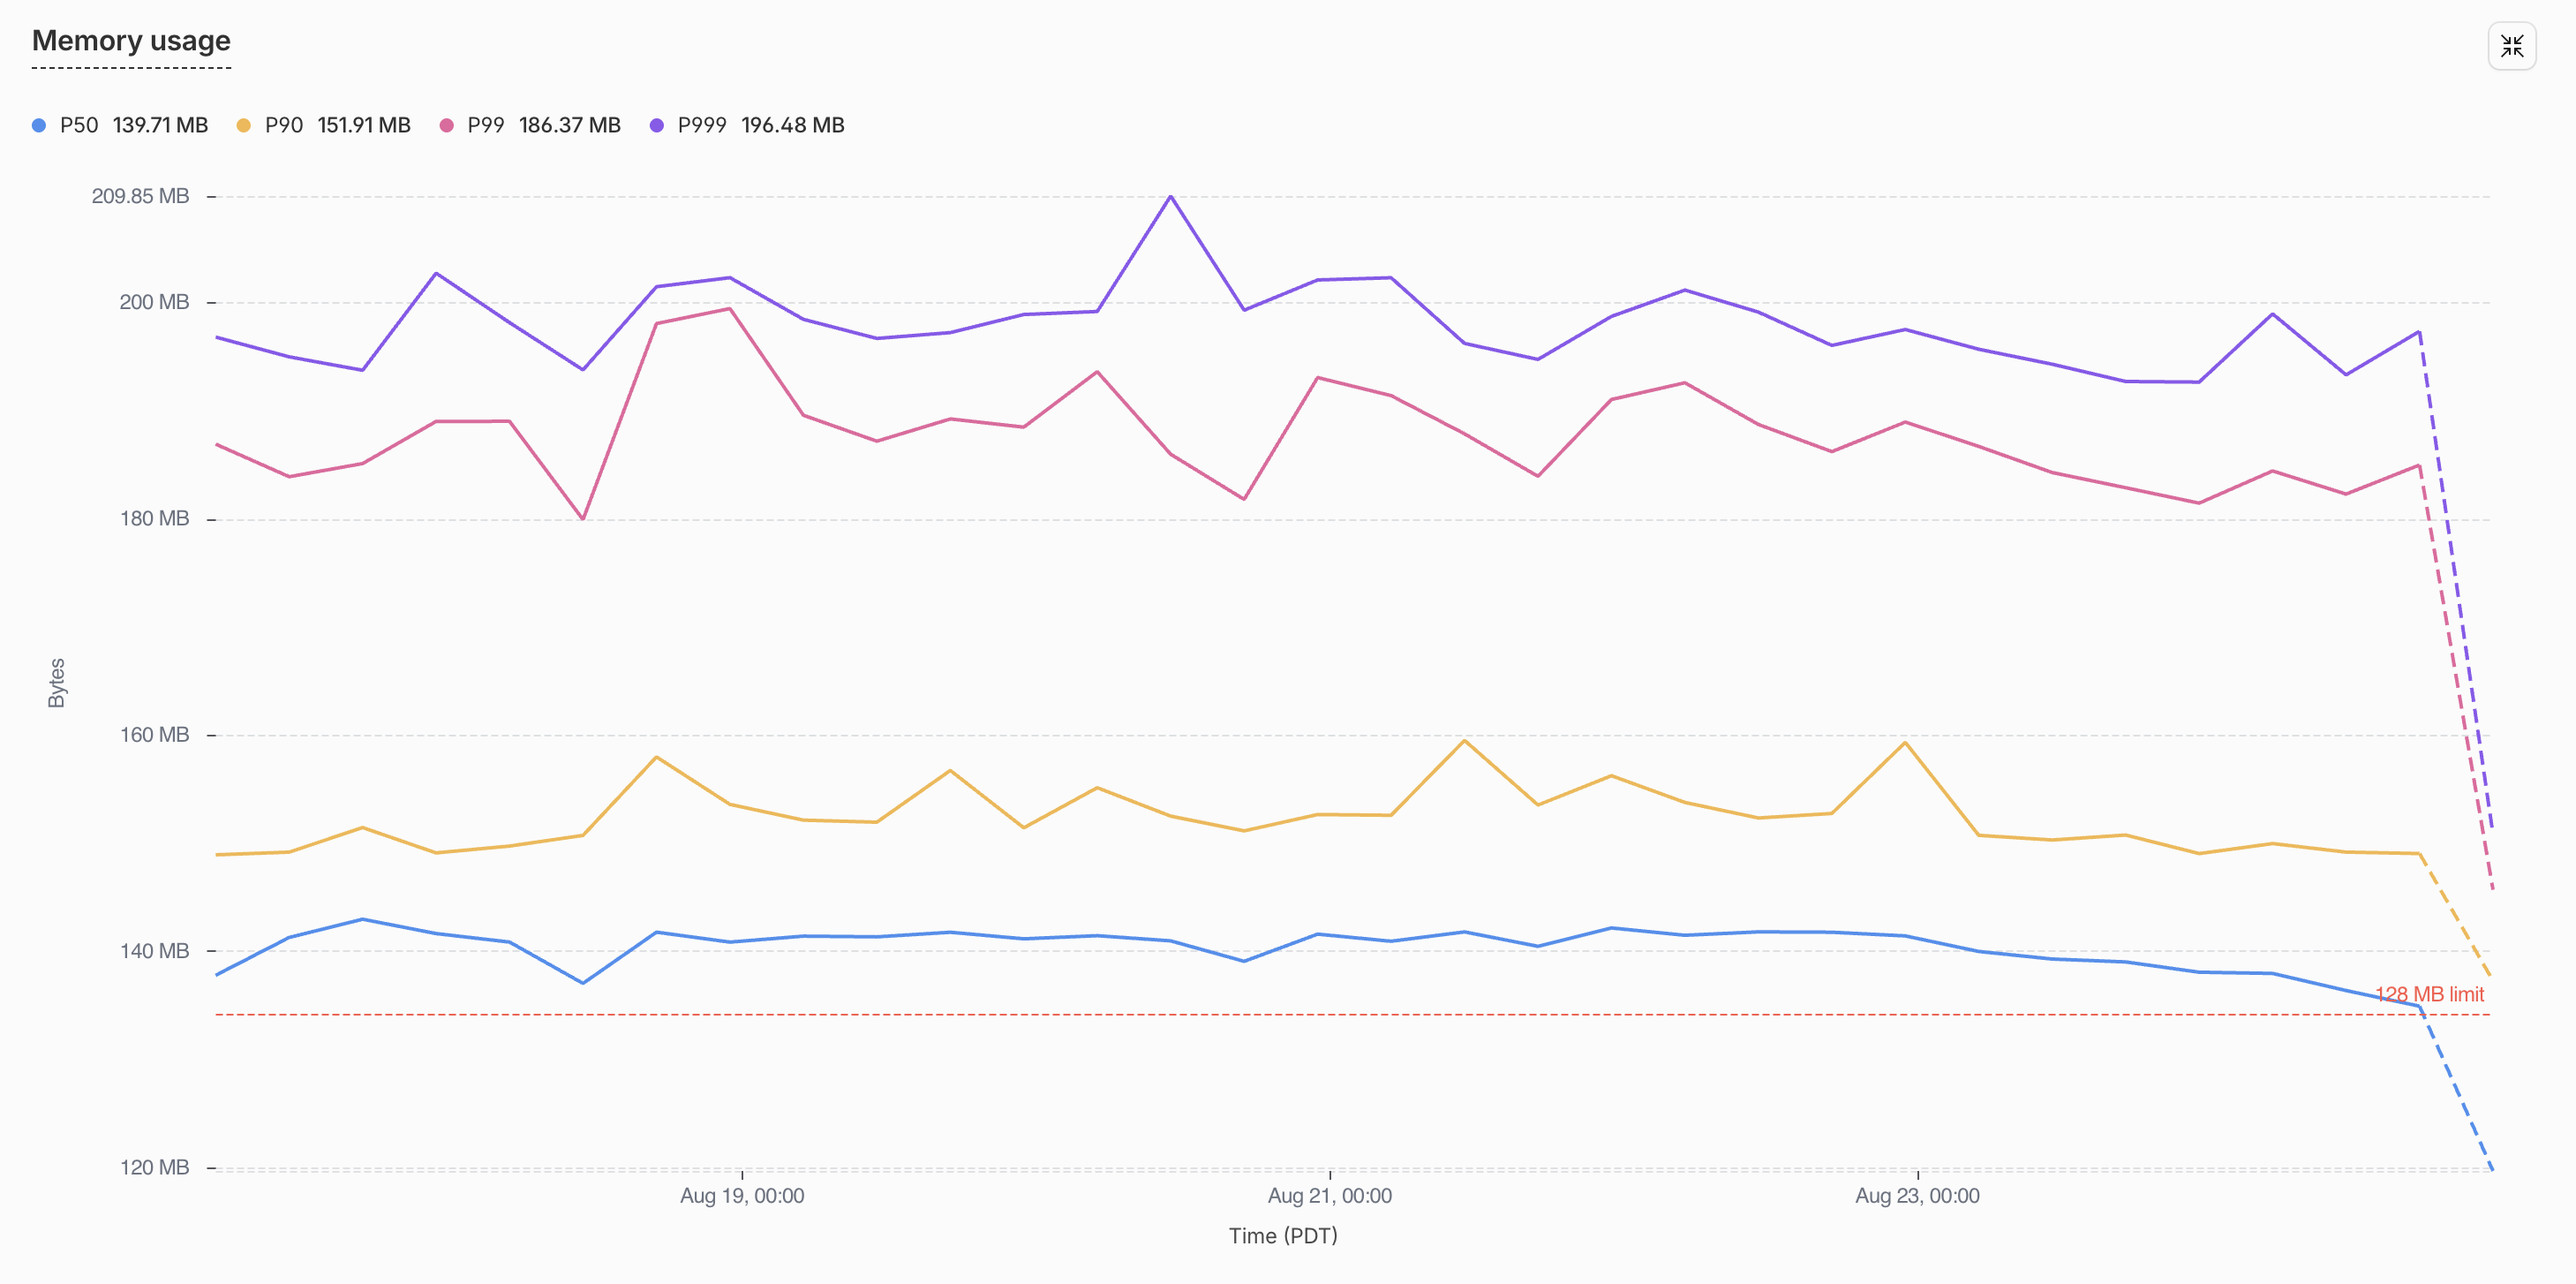
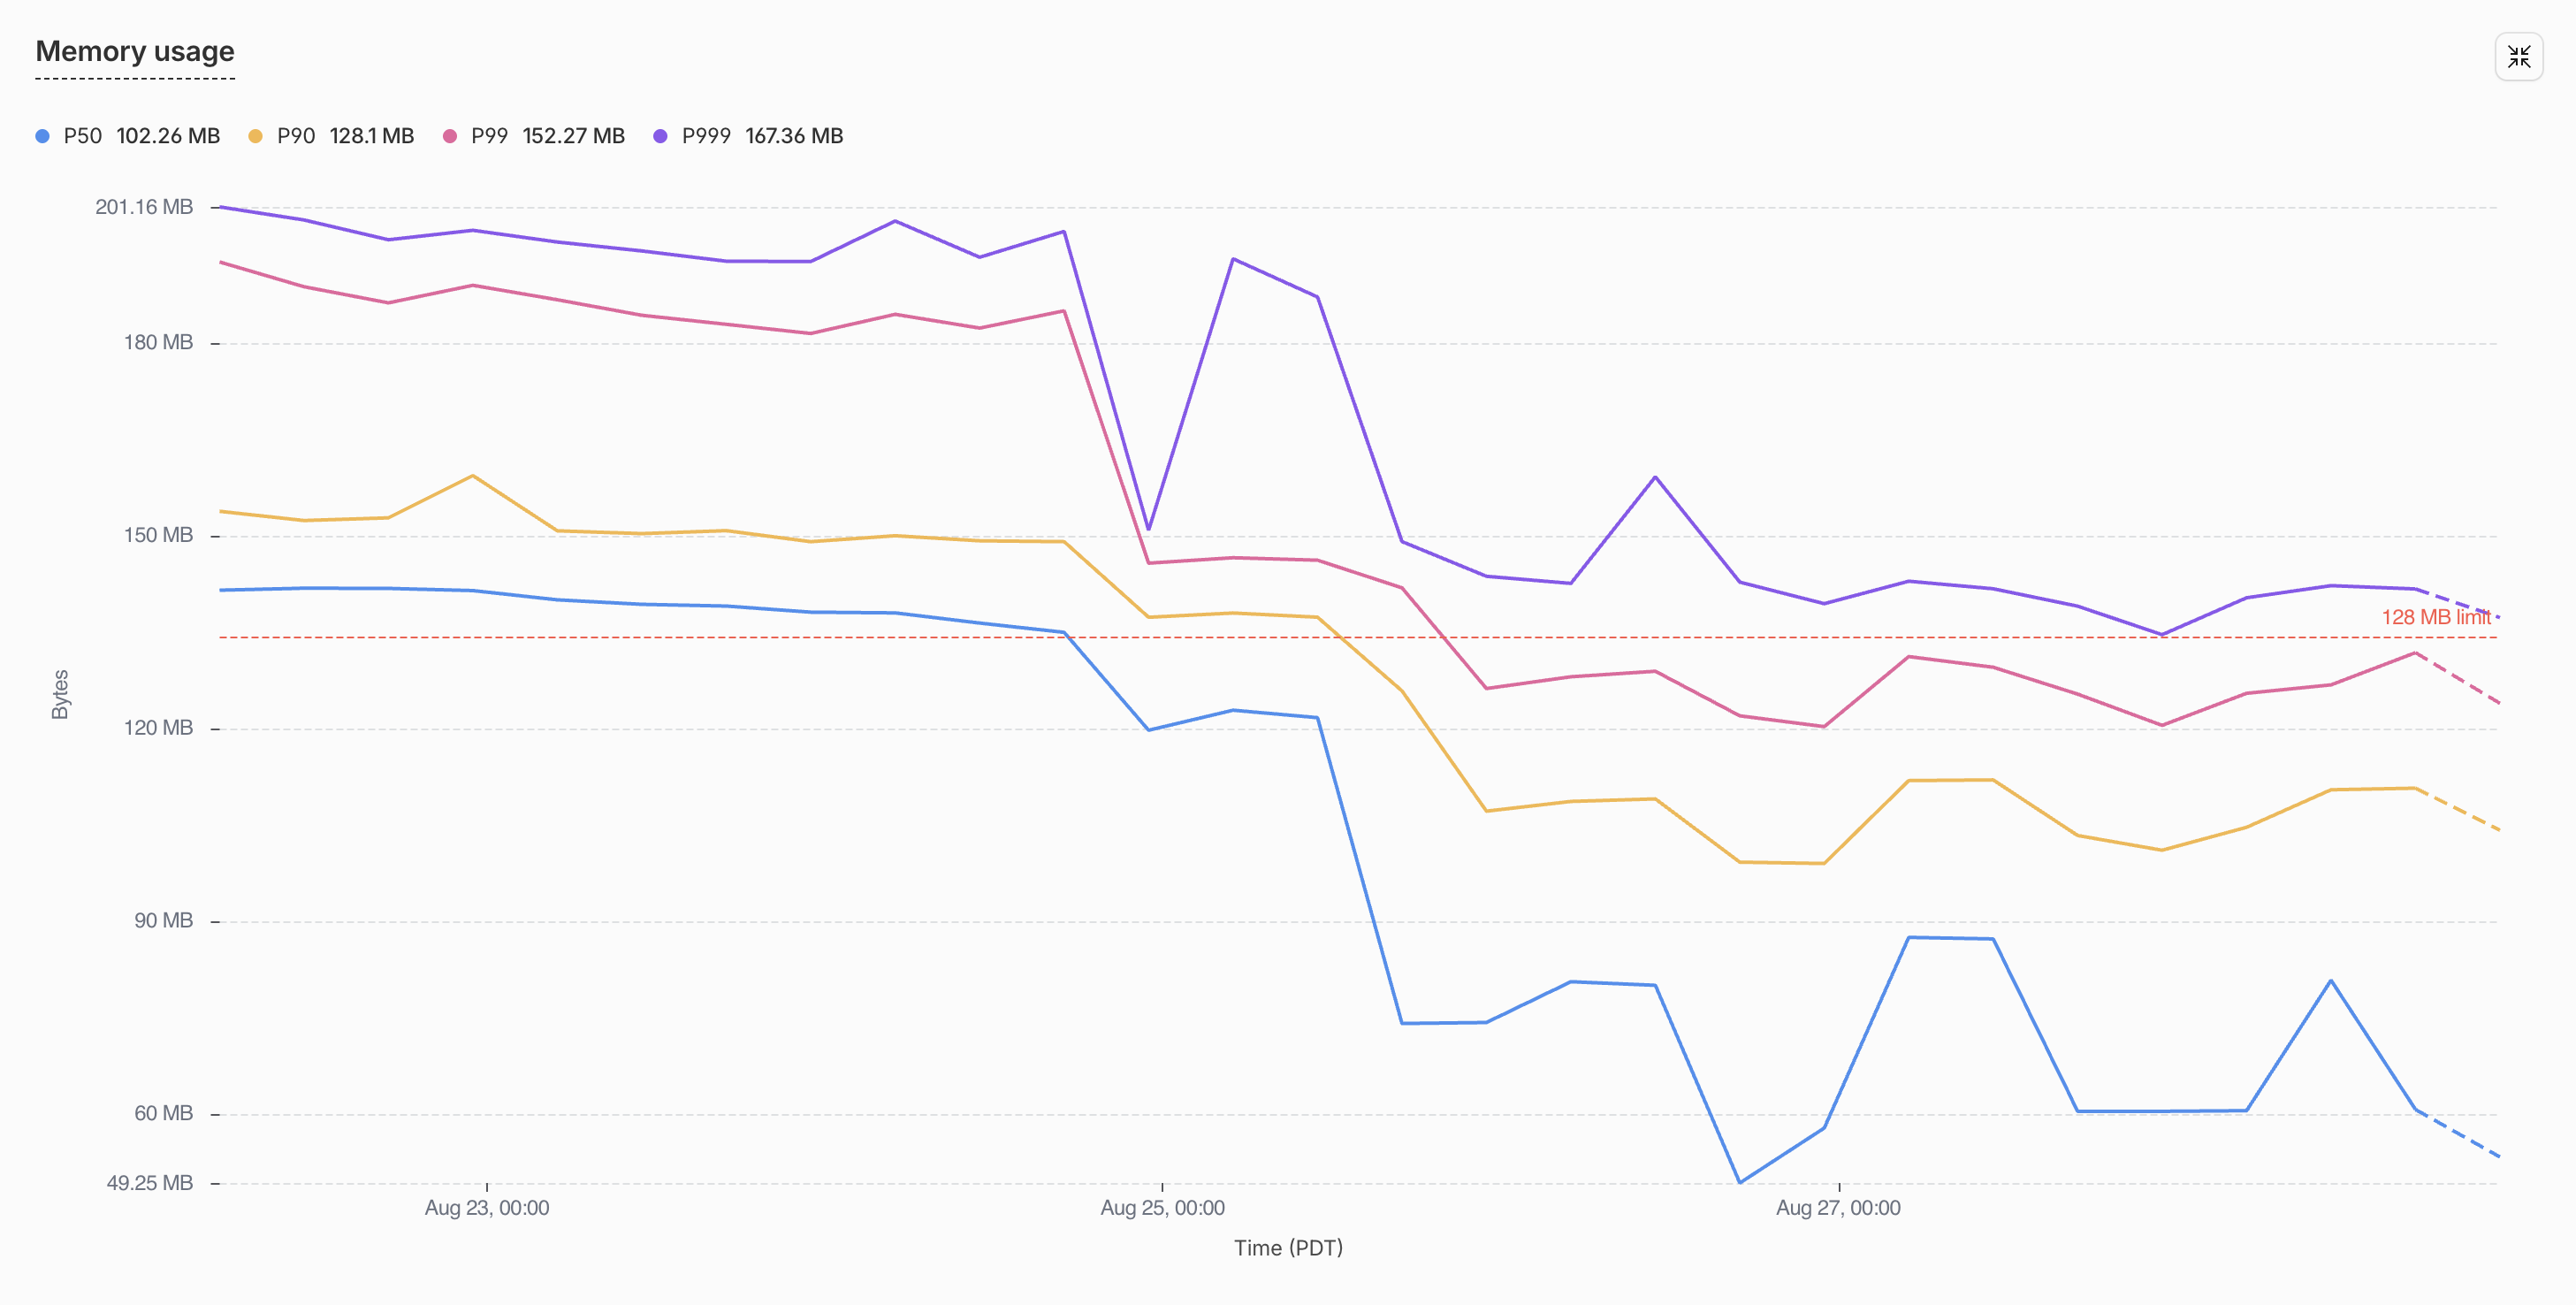
El isolate mediano, la línea azul de la figura 1, se mantuvo en unos 140 MB durante toda la semana, y el percentil 99 cerca de 190 MB. Ambas líneas están por encima de la línea discontinua de 128 MB, lo que significa que el isolate típico del namespace ya había pasado el punto en que Cloudflare tiene derecho a reiniciarlo, y solo se salvaba hasta que la siguiente asignación lo empujaba al otro lado. Lo que la gráfica no mostraba era ninguna relación con el tráfico. La línea era igual de plana en las horas tranquilas que en las ajetreadas, y ninguno de los aproximadamente 300 reinicios diarios venía con un stack trace, porque nunca era nuestro código el que lanzaba el error.
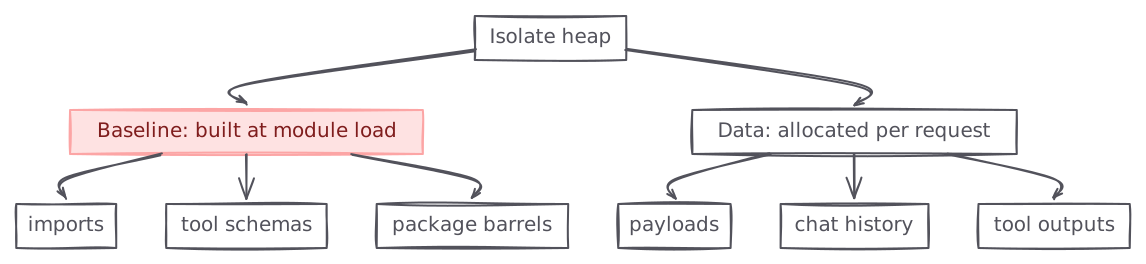
Miramos donde se esperaría mirar primero. Leímos los tamaños de los payloads, comprobamos cómo se truncaba el historial de chat y buscamos en la curva de memoria un patrón de solicitudes, y no encontramos nada que moviera la línea. Esa planitud resultó ser la pista importante. La memoria de un isolate es una de dos cosas: son datos, es decir, payloads de solicitudes, historial de chat, salidas de herramientas y cualquier otra cosa asignada mientras se sirve tráfico, o es base, es decir, los objetos que el propio código crea cuando se carga un módulo y mantiene vivos durante toda la vida del isolate, como imports, funciones y esquemas. Los datos suben y bajan con las solicitudes, mientras que la base está ahí antes de la primera solicitud y nunca desaparece, así que una gráfica alta y plana en reposo está describiendo la base. El problema tenía que estar en lo que enviábamos y no en lo que servíamos.
Por qué la memoria base es tan fácil de pasar por alto
La memoria base se esconde en dos sitios donde normalmente no miras.
El primero es el bundler. Damos por hecho que el tree shaking elimina el código que no usamos, y en su mayor parte lo hace, pero esbuild tiene reglas sobre cuándo puede podar y no son las reglas que adivinarías. Un paquete sin "sideEffects": false en su package.json nunca se poda en absoluto. Un export * dentro de un módulo evaluado de forma perezosa tampoco se poda nunca. Un import() dinámico de la raíz de un paquete marca cada export como usado. Volveremos a cada uno de estos en los arreglos, porque explican la mitad de los 130 MB.
// Three ways to keep every zod schema in a package alive in the isolate,
// none of which look like a mistake.

// The package has no "sideEffects": false, so nothing in it is pruned.
import { getWorkspaceStub } from "@scope/durable-workspaces";

// Inside a lazily evaluated module, export * is never pruned.
export * from "./zod";

// A namespace object marks every export as used, schemas included.
const pkg = await import("@scope/durable-workspaces");
El segundo es la biblioteca de esquemas. Los tipos parecen gratis porque desaparecen en tiempo de compilación, pero un esquema de zod no es un tipo, es un árbol de closures que se construye en el momento en que su módulo se evalúa. Un esquema de objeto de zod 4 de tamaño medio, una docena de campos con descripciones y refinamientos, cuesta ~134 KB de heap. Un simple z.string() cuesta ~12 KB. El objeto JSON schema plano equivalente cuesta unos cientos de bytes. Nada de eso está en el README.
// What each of these costs the moment its module evaluates.
const Params = z.object({                     // ~134 KB for a dozen fields like these
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});
const Name = z.string();                      // ~12 KB

const params = {                              // a few hundred bytes
  type: "object",
  properties: { owner: { type: "string" }, repo: { type: "string" } },
} as const;
No habíamos hecho nada exótico
Cada uno de nuestros problemas venía de un valor por defecto. Cada herramienta de agente declaraba su entrada con z.object() a nivel de módulo, porque así lo hace la documentación. Cada paquete interno tenía un barrel index.ts con export * from "./zod", porque es ordenado. Unos pocos caminos usaban await import("@scope/package") porque se supone que la carga perezosa es más barata. Cada una es una decisión razonable por sí sola. Juntas eran 130 MB, en un isolate con 128 para gastar.
// packages/tools/src/github/get-pull-request.ts, and 250 more like it
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// packages/thread-core/src/index.ts, and every other internal package
export * from "./zod";
export * from "./thread";

// packages/durable-threads/src/agent.ts
const { getWorkspaceStub } = await import("@scope/durable-workspaces");
Lo que nos estaba costando
Nuestro agente tiene más de 250 herramientas, que usa mediante code mode y workers dinámicos. Solo sus definiciones de zod costaban 78 MB de heap al cargar los módulos, más de la mitad del presupuesto del isolate, gastado en descripciones de argumentos antes de que ninguna de ellas se llamara. Cada herramienta que añadíamos costaba otros ~134 KB, se ejecutara alguna vez o no.
250+ tools × ~134 KB of zod each   ≈  78 MB   evaluated before the first request
128 MB isolate cap − 78 MB         =  50 MB   left for every thread's actual data
Los reinicios tampoco eran gratis. Cada exceededMemory tira a la basura un turno de agente en curso: un reintento, una segunda llamada al modelo, un usuario mirando un spinner. A ~300 al día eso deja de ser un incidente y se convierte en un impuesto permanente, y por la colocación conjunta lo pagaba cualquier objeto que estuviera en el isolate en ese momento.
Error: Durable Object's isolate exceeded its memory limit and was reset.Cómo lo encontramos: un profiler de heap para el bundle de producción
No podíamos perfilar producción, así que construimos un pequeño profiler que corre en local sobre el bundle exacto que corre en producción. Mide el coste de heap en V8 de evaluar cada módulo e imprime una tabla ordenada. Lo ejecutamos en bucle: perfilar, eliminar lo más alto de la clasificación, perfilar otra vez. La comprobación final de cada arreglo era un despliegue a producción comparado con las métricas de memoria de Cloudflare a ambos lados del marcador de despliegue.
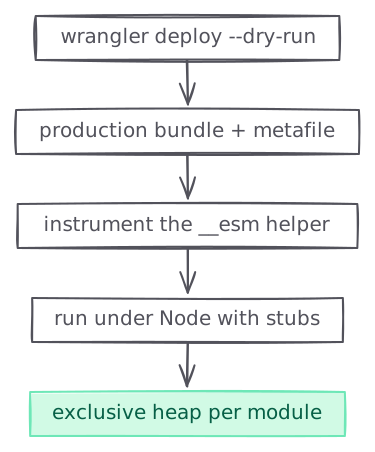
Tres ideas lo hacen funcionar:
- El mismo bundle.
wrangler deploy --dry-run --outdir --metafileemite el bundle exacto de esbuild que subiría un despliegue, más su grafo de módulos. Todo se mide sobre ese bundle. - Atribución por módulo. esbuild envuelve los módulos evaluados de forma perezosa en closures inicializadoras
__esm(...). Reescribimos ese único helper en el bundle construido para que cada inicialización de módulo registrev8.getHeapStatistics().used_heap_sizeantes y después de sí misma, con una pila de inicialización que separa el coste propio de un módulo (exclusivo) del de sus dependencias (inclusivo). El resultado es un conjunto de datos con forma de flamegraph. - Ejecuciones controladas. El bundle instrumentado corre bajo Node normal con un shim de cargador que resuelve los imports
cloudflare:*a stubs.
La receta completa, lista para pegar en un agente de programación, está al final de este artículo. Los costes unitarios de zod citados arriba salen de un microbenchmark ejecutado con el mismo harness.
Lo que mostró el primer perfil
| Fuente | Heap exclusivo |
|---|---|
packages/tools (más de 250 definiciones de herramientas de agente, zod) | 78.0 MB |
| Barrels de paquetes que reexportan módulos de esquemas zod (filas siguientes) | ~66 MB |
durable-workspaces (estado y programaciones del espacio de trabajo) | 15.6 MB |
thread-core (capa de datos de hilos) | 10.1 MB |
durable-automations (definiciones de automatizaciones) | 9.6 MB |
durable-threads (lista de hilos y actualizaciones en vivo) | 7.3 MB |
durable-automation (una ejecución de automatización) | 6.8 MB |
db (cliente de D1 y modelos) | 6.3 MB |
durable-skills (definiciones de skills) | 5.7 MB |
durable-autofixes (ramas y merges de autofix) | 4.9 MB |
| 12 paquetes más pequeños | ~9 MB |
La segunda fila es la sorprendente. Son esquemas que llegan al bundle solo a través de export * from "./zod" en barrels de paquetes. Nuestro código nunca los usaba, el tree shaker no podía eliminarlos, y costaban un tercio del límite de memoria, todo en módulos que nada llamaba nunca.
Arreglo A: definiciones de herramientas como datos, no como código
Cada definición de herramienta declaraba su esquema de entrada en zod y lo convertía a JSON schema en tiempo de ejecución, porque JSON schema es lo que se envía al modelo de todos modos. Estábamos construyendo ~134 KB de closures por herramienta para producir unos cientos de bytes de datos, así que escribimos los datos directamente.
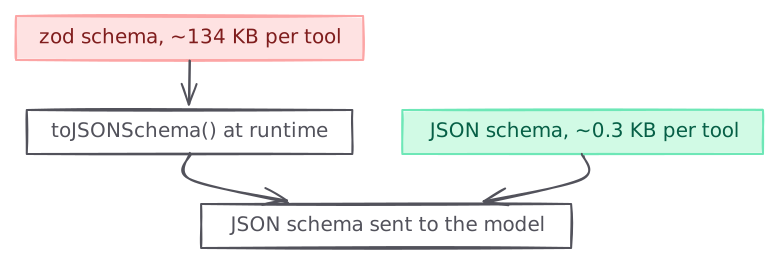
// before: ~134 KB of closures per tool, built at module load
export const parameters = z.object({
  owner: z.string().describe("Repository owner"),
  repo: z.string().describe("Repository name"),
  pullNumber: z.number().int().describe("PR number"),
});

// after: a few hundred bytes of data, and the type comes from the schema
export const parameters = defineParameters({
  type: "object",
  properties: {
    owner: { type: "string", description: "Repository owner" },
    repo: { type: "string", description: "Repository name" },
    pullNumber: { type: "number", description: "PR number" },
  },
  required: ["owner", "repo", "pullNumber"],
} as const);
export type Input = ParametersInput<typeof parameters>;
defineParameters es un envoltorio fino sobre jsonSchema() del AI SDK. ParametersInput es json-schema-to-ts haciendo la inferencia de tipos que antes hacía zod. La validación en tiempo de ejecución pasó a un validador de ~300 líneas que reproduce las propiedades de las que depende el ciclo del agente: claves desconocidas eliminadas, valores por defecto rellenados, uniones resueltas por discriminador y mensajes de error redactados para que el modelo pueda reparar su propia llamada a herramienta al reintentar.
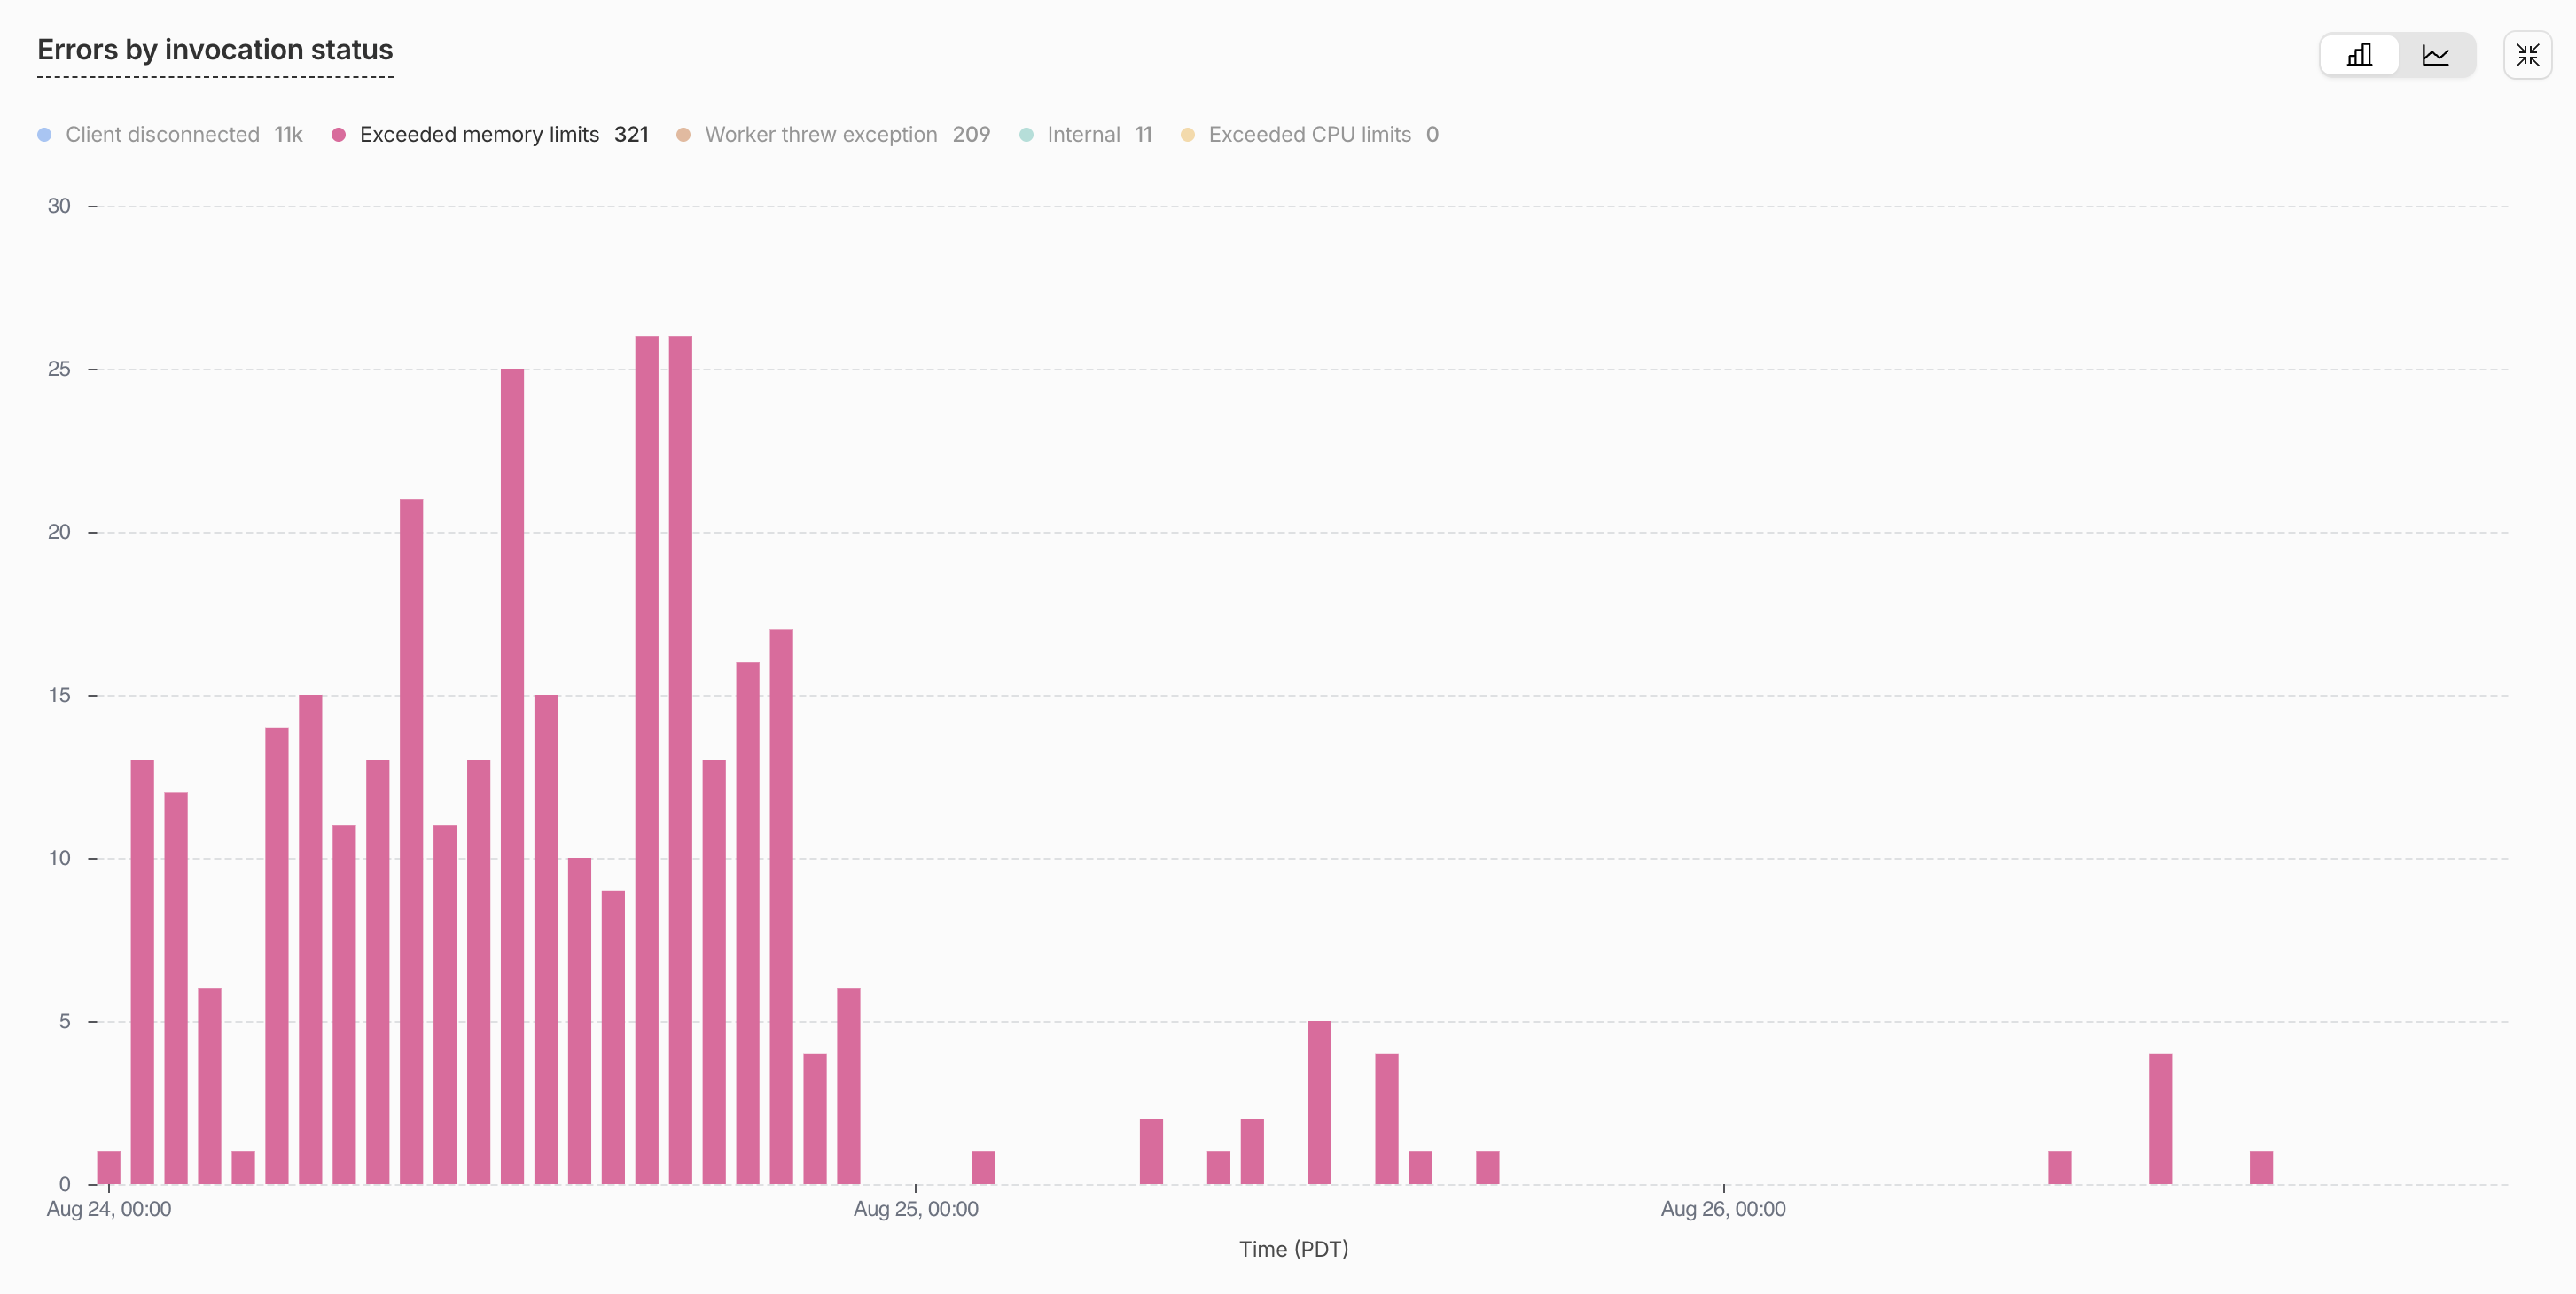
El heap de evaluación de módulos pasó de 218.6 a 154.0 MB en local, y packages/tools de 78 MB a 0.7 MB. En producción, los reinicios cayeron de 40-110 por hora a 0-6 por hora en el marcador de despliegue, y la memoria del isolate mediano de ~140 MB a ~120 MB.
Arreglo B: barrels que de verdad se pueden podar
Los ~66 MB restantes eran esquemas que el isolate nunca usaba. Tres comportamientos del bundler lo explican:
- Sin
"sideEffects": falseen elpackage.jsonde un paquete, esbuild no poda nada de él. - Incluso con la marca,
export * from "./zod"nunca se poda dentro de un módulo evaluado de forma perezosa, y cualquier cosa alcanzable mediante unimport()dinámico se evalúa de forma perezosa. Las reexportaciones con nombre (export { zFoo } from "./zod") se podan sin problema. await import("@scope/package")materializa el objeto namespace completo del paquete, marcando cada export como usado: esquemas, clases, todo.
Confirmamos cada uno de ellos con un fixture de cinco archivos construido con la versión de esbuild que wrangler incorpora: una entrada, un paquete con un barrel index.ts, un zod.ts con un esquema cuyo constructor anuncia cuándo se ejecuta, una clase do.ts que importa ese esquema y un intermediario perezoso entre ambos. La tabla registra si el constructor del esquema se ejecutó en la evaluación para cada combinación.
| La entrada importa el barrel mediante | Forma de reexportación del barrel | sideEffects: false | Esquema incluido |
|---|---|---|---|
| Import estático | export * | Sí | No |
| Import estático | export * | No | Sí |
import() dinámico del paquete | Cualquiera | Sí | Sí |
| Import estático desde un módulo cargado de forma perezosa | export * | Sí | Sí |
| Import estático desde un módulo cargado de forma perezosa | Lista con nombre | Sí | No |
| Cualquiera | Lista con nombre | No | Sí |
Las filas 3 y 4 son las dos que sorprenden a la gente, y juntas explicaban los ~66 MB. Esto es lo que nos estaba haciendo un solo barrel:
El arreglo es mecánico: "sideEffects": false en los más de 110 paquetes del espacio de trabajo, reescribir los export * de los barrels como listas de reexportación con nombre, y sustituir los await import("@scope/package") de raíces de paquetes por imports estáticos con nombre.
Una ablación sobre el bundle real de producción muestra que cada pieza es necesaria.
| Configuración | Heap tras la evaluación de módulos | Módulos de esquema en el bundle |
|---|---|---|
| Base (tras el arreglo A) | 154.0 MB | 77 |
sideEffects: false solo | 143.6 MB | 77 |
+ Imports estáticos, barrels de vuelta a export * (control) | 98.6 MB | 29 |
| + Listas de reexportación con nombre (arreglo completo) | 82.1 MB | 0 |
La fila de control es la interesante: incluso un grafo de imports totalmente estático conserva 29 módulos de esquema, así que las listas con nombre no son opcionales.
El estado final
| Heap a nivel de módulo (sonda local) | Memoria mediana en producción | Reinicios en producción | |
|---|---|---|---|
| Antes | 218.6 MB | ~140 MB | ~300/día |
| Tras A | 154.0 MB | ~120 MB | ~10/día |
| Tras A+B | 82.1 MB | ~70 MB | 0 |
Un Durable Object que descansaba por encima del límite de memoria de la plataforma ahora descansa en apenas la mitad, y los ~300 reinicios diarios han desaparecido.
Esto no es una marca de configuración
Reescribir más de 250 definiciones de herramientas de zod a JSON schema puro, y escribir un validador de 300 líneas para sustituir lo que zod hacía por nosotros, llevó unos días, incluso con agentes de programación. Añadir sideEffects: false a más de 100 paquetes y convertir cada export * en una lista con nombre generada es trabajo poco vistoso, y después hay que comprobar los tipos de todo el repositorio y arreglar lo que se rompa. La alternativa fácil es añadir un reintento y vivir con los reinicios, y muchos equipos lo hacen. Si tu Durable Object está cerca del límite en reposo, yo diría que la semana merece la pena, porque el límite no se mueve y tu número de herramientas solo va a crecer.
Las tres cosas que me habría gustado saber desde el primer día:
- Alto y plano en reposo significa base. Perfila lo que envías, no lo que sirves.
- El tree shaking tiene reglas.
sideEffects: false, reexportaciones con nombre, imports estáticos. Fállale a una y todo el paquete viene de acompañante. - Los esquemas son código, no tipos. Si el consumidor quiere JSON schema, escribe JSON schema.
Haz esto hoy para arreglar la memoria de tu Durable Object
El profiler son ~100 líneas sin más dependencias que Node y wrangler. Pega la receta de abajo en tu agente de programación en la raíz de cualquier repositorio que despliegue con wrangler, lee las diez primeras filas de la tabla que imprime y mira qué hay. Después baja por la lista: JSON schema puro para todo lo que el modelo reciba como JSON schema de todos modos, "sideEffects": false y reexportaciones con nombre para los barrels, imports estáticos para las raíces de paquetes.
Build a per-module heap profiler for my worker's production bundle.

1. Emit the exact production bundle and metafile:

   cd <worker-dir>
   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json

   If the worker's import graph is fully static, esbuild emits no lazy
   `__esm` wrappers and per-module attribution is impossible. In that case
   build from a probe-only entry that reaches the real entry through a
   dynamic import (and satisfies wrangler's Durable Object export check
   with a placeholder class):

   // probe-entry.ts
   export default { fetch: () => new Response("probe") };
   export class <YourDurableObjectClassName> {}
   export const probeLoad = () => import("<path-to-real-entry>");

   npx wrangler deploy --dry-run --env <stage> --config wrangler.jsonc \
     --outdir /tmp/heap-probe --metafile /tmp/heap-probe/meta.json probe-entry.ts

2. Instrument the bundle. Write instrument.mjs and run
   `node instrument.mjs /tmp/heap-probe`:

   import { readFileSync, writeFileSync } from "node:fs";
   import { join } from "node:path";

   const outDir = process.argv[2];
   const bundlePath = join(outDir, "probe-entry.js"); // or index.js
   const source = readFileSync(bundlePath, "utf-8");

   const esmHelperPattern = /var __esm = \(fn, res(?:, \w+)?\) => function __init\(\) \{[\s\S]*?\n\};\n/;
   if (!esmHelperPattern.test(source)) throw new Error("__esm helper not found; esbuild output shape changed");

   const instrumentedHelper = `var __probeInitStack = [];
   var __esm = (fn, res, err2) => function __init() {
     if (err2) throw err2[0];
     if (!fn) return res;
     const probe = globalThis.__moduleHeapProbe;
     if (!probe) {
       try { return (res = (0, fn[__getOwnPropNames(fn)[0]])(fn = 0)), res; }
       catch (e) { throw ((err2 = [e]), e); }
     }
     const moduleName = __getOwnPropNames(fn)[0];
     const frame = { child: 0 };
     const before = probe.heap();
     __probeInitStack.push(frame);
     try { return (res = (0, fn[moduleName])(fn = 0)), res; }
     catch (e) { throw ((err2 = [e]), e); }
     finally {
       const total = probe.heap() - before;
       __probeInitStack.pop();
       if (__probeInitStack.length > 0) __probeInitStack[__probeInitStack.length - 1].child += total;
       probe.record(moduleName, total - frame.child, total);
     }
   };
   `;
   writeFileSync(join(outDir, "instrumented.mjs"), source.replace(esmHelperPattern, instrumentedHelper));

3. Write a Node loader shim so worker-targeted code loads under Node.
   register.mjs resolves `cloudflare:*` to a stub module (an empty module
   exporting throwing placeholders for DurableObject, WorkerEntrypoint,
   env, etc.) via module.registerHooks; add a `load` hook for any
   non-JS rules in your wrangler config (for us: `.sql` files become
   text default exports, mirroring wrangler's Text rule).

4. Write probe.mjs and run it:

   node --expose-gc --import ./register.mjs probe.mjs /tmp/heap-probe

   import { join } from "node:path";
   import { pathToFileURL } from "node:url";
   import v8 from "node:v8";

   const outDir = process.argv[2];
   const records = [];
   globalThis.__moduleHeapProbe = {
     heap: () => v8.getHeapStatistics().used_heap_size,
     record: (moduleName, exclusive, total) => records.push({ moduleName, exclusive, total }),
   };
   const settle = async () => { await new Promise((r) => setTimeout(r, 0)); globalThis.gc(); globalThis.gc(); };
   const mb = (b) => (b / 1048576).toFixed(2);

   await settle();
   const bundle = await import(pathToFileURL(join(outDir, "instrumented.mjs")).href);
   if (bundle.probeLoad) await bundle.probeLoad();
   await settle();
   console.log(`heap after module evaluation: ${mb(v8.getHeapStatistics().used_heap_size)} MB`);

   for (const r of records.sort((a, b) => b.exclusive - a.exclusive).slice(0, 40))
     console.log(`${mb(r.exclusive).padStart(8)} MB  ${r.moduleName}`);

   const byPackage = new Map();
   for (const r of records) {
     const m = r.moduleName.match(/node_modules\/((?:@[^/]+\/)?[^/]+)|(packages\/[^/]+)/);
     const key = m ? (m[1] ? `npm:${m[1]}` : m[2]) : "other";
     byPackage.set(key, (byPackage.get(key) ?? 0) + r.exclusive);
   }
   for (const [k, v] of [...byPackage.entries()].sort((a, b) => b[1] - a[1]))
     if (v > 131072) console.log(`${mb(v).padStart(8)} MB  ${k}`);

5. Gotchas that will otherwise burn an afternoon:
   - The bundle's unenv polyfill replaces globalThis.process at init and its
     memoryUsage() reports zeros. Read v8.getHeapStatistics() instead.
   - Compare deltas between runs of this probe, never absolutes against
     production: Node's heap baseline differs from workerd's.
   - Modules evaluated eagerly at the top level (not wrapped in __esm) are
     invisible to attribution; the probe-entry trick in step 1 fixes that.
Si quieres que te hagan toda la auditoría, aquí tienes un skill para tu agente de programación:
Audit this repo's worker bundles for module-scope schema weight, and fix what you find. Work in this order and show me numbers at every step.

1. Baseline. Using the "profile module-scope heap" recipe, build the
   production bundle of our most memory-sensitive worker and produce the
   per-module and per-package exclusive-heap ranking. Report heap after
   module evaluation.

2. Identify schema weight. From the ranking and the esbuild metafile, list
   every module matching your schema conventions (zod/valibot/etc. modules,
   e.g. packages/*/zod*) that survived into the bundle, with bytes. For each,
   compute one import chain from the entry using the metafile's `imports`
   graph (BFS), so we know *why* it is in the bundle.

3. Classify each surviving schema module:
   a. Actually used at runtime by this worker: leave it, or move the boundary.
   b. Reached through `export *` in a package barrel: candidate for named lists.
   c. Reached through `await import("<package root>")`: candidate for a static
      named import.
   d. Reached because the package lacks `"sideEffects": false`: candidate flag.

4. Apply, in this order, re-profiling after each:
   a. Add `"sideEffects": false` to every internal package that has no
      import-time side effects. Audit first: grep package sources for
      top-level globalThis mutations, addEventListener, polyfill assignment.
      Any true side-effect file gets `"sideEffects": ["./that-file.ts"]`.
   b. Rewrite `export * from "./<schemas>"` in package barrels to explicit
      `export { ... }` / `export type { ... }` lists. Generate the lists with
      the TypeScript compiler API (walk ExportDeclarations recursively,
      classify value vs type), never by regex. Typecheck the repo after.
   c. Replace every value-position `await import("@scope/pkg")` of a bare
      package root with a static named import of the symbols actually used.
      Check the site is not lazy for a *different* reason first (circular
      imports, Node-only test loading, genuine cold-path npm dependency).

5. If tool/LLM definitions build schema-library objects at module scope,
   propose converting them to plain JSON schema with types via
   json-schema-to-ts, and estimate the saving from step 1's ranking before
   doing it.

6. Verify: re-profile (report the delta), typecheck, run the affected
   packages' tests, and dry-run build every worker. Then add a CI assertion
   that reads the metafile of the memory-sensitive worker and fails if any
   schema module survives tree shaking into it, printing the import chain.

7. After deploy, compare the platform memory metrics across the deploy
   marker and report before/after median and 99th percentile memory, and reset
   counts.
También hemos añadido este skill al propio Polylane, así que todos los usuarios de Polylane reciben de fábrica esta investigación profunda sobre la memoria de sus Durable Objects, sin nada que pegar.