

Underagenter er rett og slett feil
Explore with AI
Polylanes autofiks-agent ble opprinnelig bygget som en arbeidsflyt med flere underagenter, hver med ansvar for én enkelt oppgave:
- en triage for å sortere gjennom tusenvis av varsler og signaler
- en koordinator for å styre underagentene
- opptil femten underagenter for å undersøke alle mulige hypoteser for issuet
- og en kodeagent for til slutt å sende inn en pull request
Et bekreftet issue kunne føre til opptil 18 agenter og underagenter for undersøkelsen og fiksen. I dag gjøres det samme arbeidet av én enkelt agent.
Arbeidsflyten var et fornuftig design basert på det vi visste den gangen: små prompts, små verktøysett, en orkestrator som fraktet resultater mellom spesialister. Den var imidlertid ekstremt kostbar og vanskelig å drifte og resonnere rundt.
Hva er et issue?
Polylane skanner logger, metrikker og tracer fra hver skyressurs (Lambda-funksjon, Cloudflare Worker, Vercel-prosjekt, osv.) hos hver tilkoblede leverandør. For hver ressurs lagrer vi baselines på tvers av flere tidshorisonter, slik at vi kan fange opp sesongvariasjoner i dataene. Vi vurderer så skyressursens nåværende tilstand og sammenligner den med historiske data. Verdier som bryter baselinen, registreres som issues.
Issues kan også opprettes av varsler vi mottar fra observerbarhets- og feilsporingsløsninger.
Hvordan løser vi issues?
For å løse et issue må vi:
- Triagere: Samle inn data for å bekrefte eller avkrefte issuet.
- Undersøke: Vurdere flere hypoteser og fastslå rotårsaken.
- Åpne en pull request eller eskalere. Enten skrive en pull request for å løse issuet, eskalere til en ingeniør hvis fiksen ikke er en kodeendring, eller skrive en rapport som fremhever funnene og stoppe.
De aller fleste kjøringer avsluttes før en pull request eller en eskalering, når Polylane konkluderer med at issuet enten er en falsk positiv eller ufarlig.
Underagentarkitektur
Vår opprinnelige arkitektur var basert på flere underagenter.
Vi brukte en orkestratoragent for å koordinere arbeidet mellom flere underagenter. Underagenter ble instansiert for å undersøke hypoteser, og forsøkte å bevise eller avkrefte hver hypotese med forskjellige utgangspunkt (for eksempel ved å starte med loggene, eller ved å starte med kodebasen, osv.).
Funnene fra underagentene ble stemt over med enkel aritmetikk og oppsummert av en annen agent før de ble rullet opp til koordinatoragenten.
Konklusjonen for hver hypotese var en konfidensvektet avstemning på tvers av kjøringene dens.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Når alle hypotesene var undersøkt, og en rotårsak var identifisert, ville koordinatoren enten eskalere til en ingeniør eller skrive en plan for fiksen. Denne planen ble så overlevert til en kodende underagent for å implementere fiksen og sende inn pull requesten.
Hovedproblemet i denne arkitekturen er konteksttapet mellom underagentene. Hver agent sendte bare brøkdeler av konteksten sin opp eller ned, gjennom oppsummering, og både oppstrøms- og nedstrømsagenter måtte jevnlig gjøre om det samme arbeidet.
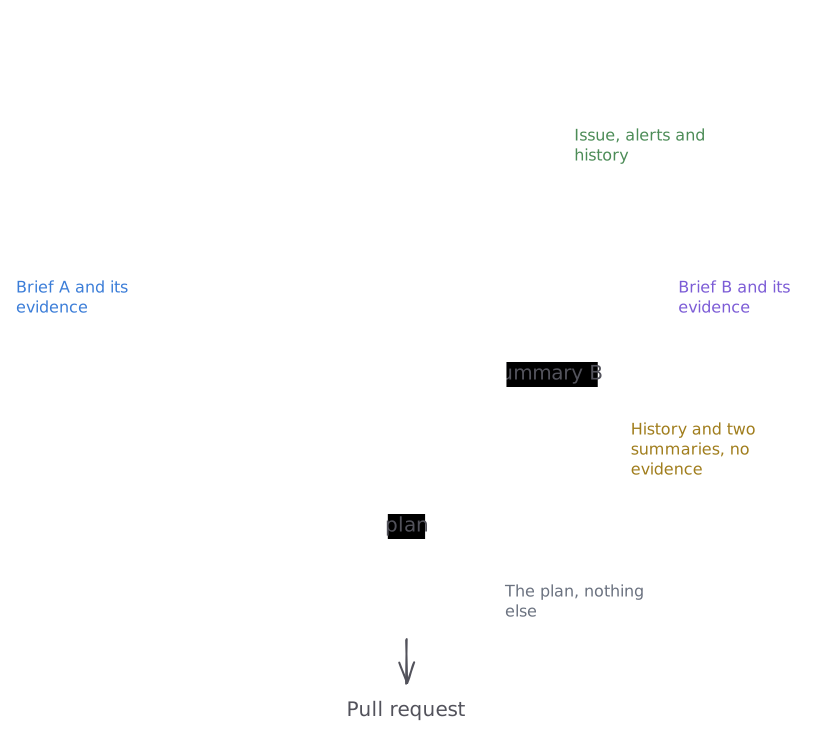
I tillegg hadde agenten som skrev fiksen, bare planen, og manglet kontekst om det opprinnelige issuet eller bevisene som var samlet inn under undersøkelsen. Dette førte til pull requests av lavere kvalitet, som ofte fokuserte på symptomer i stedet for rotårsaken.
Vi valgte denne arkitekturen primært fordi da vi først designet den i mars 2026, var ikke frontier-modellene alltid i stand til å kjøre en undersøkelse fra ende til annen, inkludert å skrive fiksen, og enkelt og greit, vår harness var heller ikke god nok.
Det ble stadig vanskeligere å bygge videre på dette fundamentet fordi:
- Feilsøking krevde mange tracer. Å resonnere rundt en undersøkelse fra ende til annen krevde å gå gjennom flere, noen ganger dusinvis av tracer
- Evalueringen var per steg. Hver underagent kunne evalueres individuelt og bestå, mens sluttresultatet var dårlig, fordi feilene lå i overleveringene.
Vi itererte på denne arkitekturen i flere måneder, forbedret hver agent individuelt og finjusterte promptene og overleveringene, men resultatene sto aldri i forhold til innsatsen. Det var kostbart, vanskelig å feilsøke, og pull requestene var ikke gode nok.
Én agent
- september erstattet vi arbeidsflyten med underagenter med én enkelt agent som gjør alt fra triage til pull request. Den samme agenten samler inn bevisene, undersøker alle hypotesene og sender inn pull requesten.
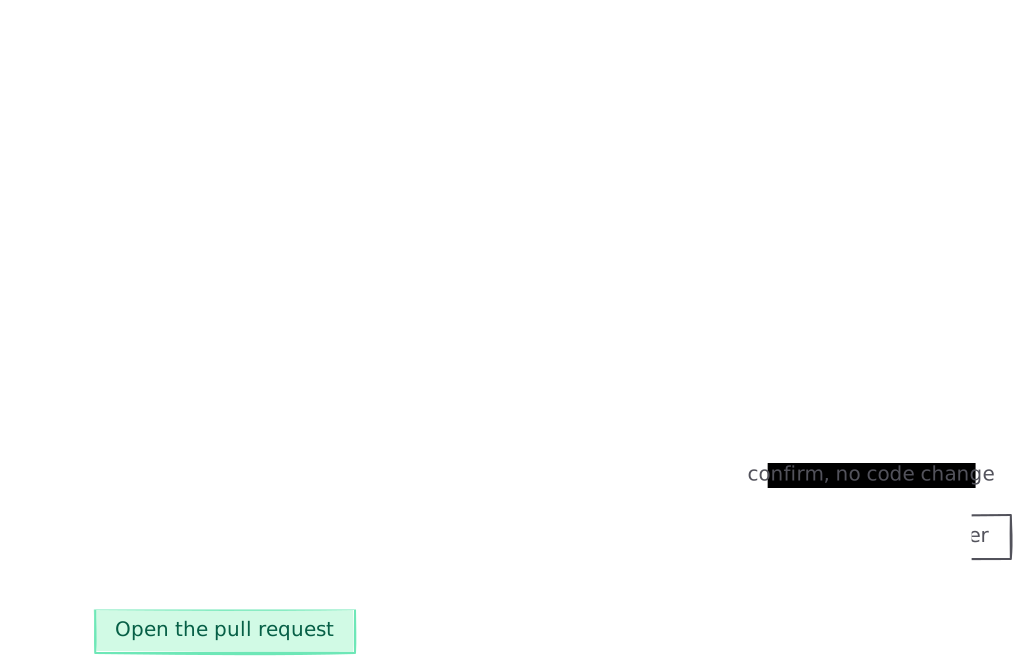
Vi slettet triage-agenten, koordinatoren, hypoteseagentene og autofiks-agenten, sammen med arbeidsflytene som fraktet resultater mellom dem og sperrene som lå foran pull requesten. De driftsmessige fordelene var umiddelbare: én trace å evaluere, og ingen oppsummeringer mellom underagenter.
Enda viktigere: kvaliteten på pull requestene ble bedre, og tiden mellom oppdagelse av et issue og åpning av pull requesten som fikser det, ble kraftig redusert. I løpet av måneden rundt overgangen gikk medianen fra 2.2 timer til 35 minutter, og p90 fra ni dager til under to timer. Under pipelinen lå et funn typisk i flere timer i en kjede av arbeidsflyter, hver ventende på den forrige. Under den enkelte agenten åpnes pull requesten bare minutter etter at issuet er oppdaget.
Vi åpner nå også langt flere pull requests. Da vi brukte underagenter, endte 0.6% av oppdagede issues i en pull request. Under den enkelte agenten er det 4.2%, og økende. Forskjellen ligger i feilmodusene. En pipeline med flere underagenter må overleve hver overlevering: triage må fremme funnet, koordinatoren må produsere hypoteser, fan-out-en må komme frem til en konklusjon, osv. Hver overlevering er en potensiell feilmodus.
Kostnaden per pull request falt også. Hver kjøring starter nå på den sterkere modellen, så et avvist funn koster mer enn det gjorde under pipelinen. Men gjennomsnittskostnaden per pull request gikk fra $111 til rundt $18 i løpet av de første ni dagene med den enkelte agenten. Dette fallet er ikke utelukkende et resultat av arkitekturendringen, ettersom vi aktivt itererer på alle aspekter av Polylane. Noe av det er den vanlige driften i et system under konstant iterasjon.
Alle verdiene bak de tre grafene, per UTC-dag
| Dag | Oppdagede issues med en pull request | Median | p90 | Forbruk per pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · én agent | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · til 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Ikke bygg underagenter
- Overleveringer taper mer enn de sparer. Hver oppsummering som sendes mellom agenter, er kontekst den neste agenten aldri vil ha. Agenten som samler inn bevisene, bør være agenten som handler på dem.
- Evaluer kjøringen, ikke agentene. Per-agent-evalueringer består mens systemet feiler, fordi feilene ligger mellom agentene.
- Behold én trace per kjøring. En feil beslutning spredt over et dusin tracer tar en ettermiddag å forklare. I én trace tar det et scroll.