

Subagentes estão simplesmente errados
Explore with AI
O agente de autofix do Polylane foi originalmente construído como um workflow de múltiplos subagentes, cada um responsável por uma única tarefa:
- uma triagem para filtrar milhares de alertas e sinais
- um coordenador para operar subagentes
- até quinze subagentes para investigar todas as hipóteses possíveis para a issue
- e um agente de programação para finalmente enviar uma pull request
Uma issue confirmada podia levar a até 18 agentes e subagentes para a investigação e a correção. Hoje o mesmo trabalho é feito por um único agente.
O workflow era um design sólido baseado no que sabíamos na época: prompts pequenos, conjuntos pequenos de ferramentas, um orquestrador para levar resultados entre especialistas. No entanto, era extremamente caro e difícil de operar e de entender.
O que é uma issue?
O Polylane varre logs, métricas e traces de cada recurso de nuvem (função Lambda, Cloudflare Worker, projeto Vercel etc.) em cada provedor conectado. Para cada recurso, armazenamos linhas de base em múltiplos horizontes, de forma a capturar a sazonalidade dos dados. Em seguida, avaliamos o estado atual do recurso de nuvem e o comparamos com dados históricos. Valores que rompem a linha de base são registrados como issues.
Issues também podem ser criadas por alertas recebidos de soluções de observabilidade e rastreamento de erros.
Como resolvemos issues?
Para resolver uma issue, precisamos:
- Triagem: coletar dados para confirmar ou rejeitar a issue.
- Investigar: avaliar múltiplas hipóteses e determinar a causa raiz.
- Abrir uma pull request ou escalonar. Escrever uma pull request para resolver a issue, escalonar para um engenheiro se a correção não for uma mudança de código, ou escrever um relatório destacando os achados e parar.
A grande maioria das execuções termina antes de uma pull request ou de um escalonamento, quando o Polylane conclui que a issue é um falso positivo ou é benigna.
Arquitetura de subagentes
Nossa arquitetura inicial era baseada em múltiplos subagentes.
Usávamos um agente orquestrador para coordenar o trabalho entre múltiplos subagentes. Subagentes eram instanciados para investigar hipóteses, tentando provar ou refutar cada hipótese a partir de diferentes pontos de partida (por exemplo, começando pelos logs, ou começando pelo código-fonte etc.).
Os achados dos subagentes eram votados com aritmética simples e resumidos por outro agente antes de serem consolidados no agente coordenador.
O veredito de cada hipótese era um voto ponderado por confiança entre suas passagens.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Depois que todas as hipóteses eram investigadas, se uma causa raiz fosse identificada, o coordenador escalonava para um engenheiro ou escrevia um plano para a correção. Esse plano era passado para um subagente de programação implementar a correção e enviar a pull request.
O principal problema dessa arquitetura é a perda de contexto entre os subagentes. Cada agente repassava para cima ou para baixo apenas frações do seu contexto, por meio de resumos, e tanto os agentes anteriores quanto os posteriores frequentemente tinham que refazer o mesmo trabalho.
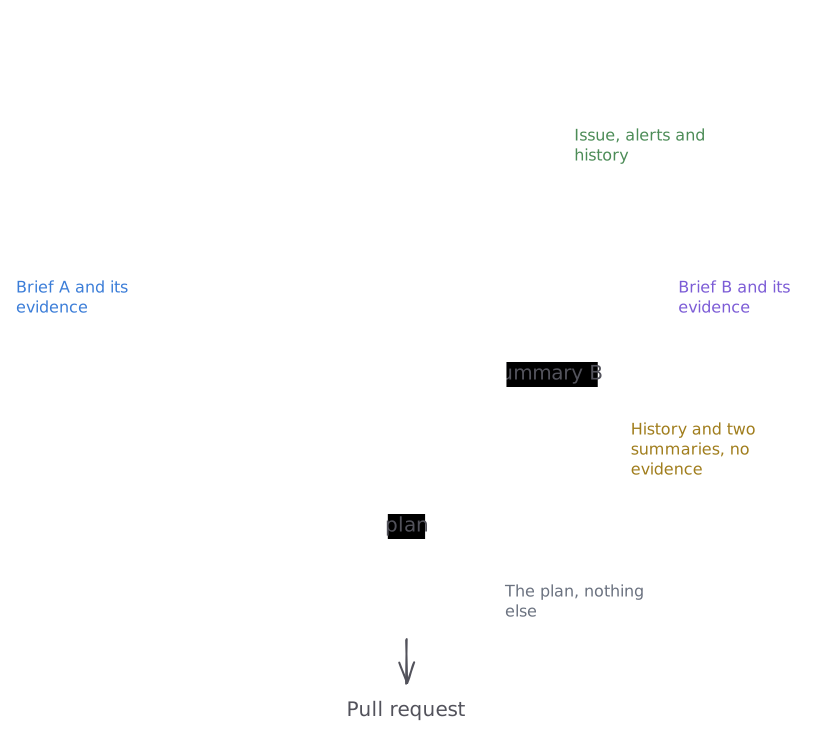
Além disso, o agente que escrevia a correção tinha apenas o plano, sem contexto sobre a issue original ou sobre as evidências coletadas na investigação. Isso resultava em pull requests de qualidade inferior, que muitas vezes focavam nos sintomas em vez da causa raiz.
Escolhemos essa arquitetura principalmente porque, quando a projetamos pela primeira vez em março de 2026, os modelos de fronteira nem sempre eram capazes de executar uma investigação de ponta a ponta, incluindo escrever a correção, e também, sinceramente, nosso harness não era tão bom.
Tornou-se cada vez mais difícil construir sobre essa base porque:
- O debugging exigia muitos traces. Entender uma investigação de ponta a ponta exigia analisar múltiplos traces, às vezes dezenas deles
- A avaliação era por etapa. Cada subagente podia ser avaliado individualmente e passar, enquanto o resultado final era ruim, porque as falhas viviam nos handoffs.
Iteramos nessa arquitetura por meses, melhorando cada agente individualmente e ajustando os prompts e os handoffs, mas os resultados nunca corresponderam ao esforço. Era caro, difícil de debugar, e as pull requests não eram boas o suficiente.
Agente único
Em 3 de setembro, substituímos o workflow de subagentes por um único agente que faz tudo, da triagem à pull request. O mesmo agente coleta as evidências, investiga todas as hipóteses e envia a pull request.
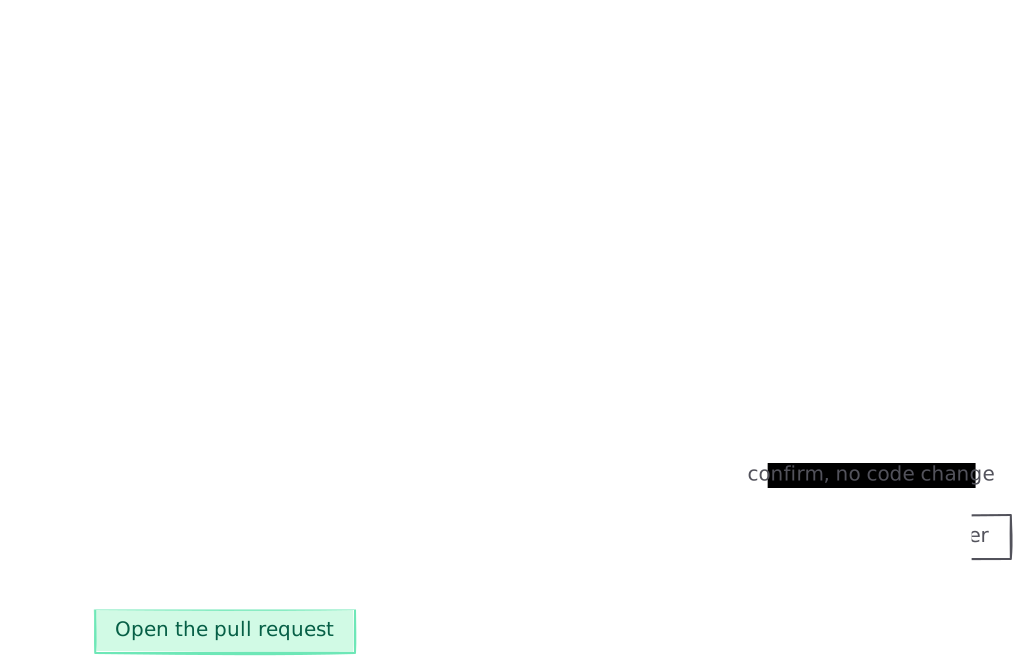
Eliminamos o agente de triagem, o coordenador, os agentes de hipótese e o agente de autofix, junto com os workflows que carregavam resultados entre eles e as barreiras que ficavam antes da pull request. Os benefícios operacionais foram imediatos: um único trace para avaliar, e nenhum resumo entre subagentes.
Mais importante, a qualidade das pull requests melhorou, e o tempo entre a detecção de uma issue e a abertura da pull request que a corrige diminuiu drasticamente. No mês em torno da transição, a mediana caiu de 2.2 horas para 35 minutos e o p90 caiu de nove dias para menos de duas horas. Na pipeline anterior, um achado normalmente ficava parado por várias horas numa cadeia de workflows, cada um esperando o anterior. Com o agente único, a pull request é aberta poucos minutos depois de a issue ser detectada.
Agora também abrimos muito mais pull requests. Quando usávamos subagentes, 0.6% das issues detectadas terminavam em uma pull request. Com o agente único, esse número é 4.2%, e continua subindo. A diferença está nos modos de falha. Uma pipeline com múltiplos subagentes precisa sobreviver a cada handoff: a triagem precisa promover o achado, o coordenador precisa produzir hipóteses, o fan-out precisa chegar a um veredito etc. Cada handoff é um modo de falha potencial.
O custo por pull request também caiu. Toda execução agora começa no modelo mais forte, então um achado descartado custa mais do que custava na pipeline anterior. Mas o custo médio por pull request foi de $111 para cerca de $18 nos primeiros nove dias do agente único. Essa queda não é resultado exclusivo da mudança de arquitetura, já que estamos iterando ativamente em todos os aspectos do Polylane. Parte dela é a deriva comum de um sistema em iteração constante.
Todos os valores por trás dos três gráficos, por dia UTC
| Dia | Issues detectadas com pull request | Mediana | p90 | Gasto por pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · agente único | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · até 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Não construa subagentes
- Handoffs perdem mais do que economizam. Cada resumo passado entre agentes é contexto que o próximo agente nunca terá. O agente que reúne as evidências deveria ser o agente que age sobre elas.
- Avalie a execução, não os agentes. Avaliações por agente passam enquanto o sistema falha, porque as falhas vivem entre os agentes.
- Mantenha um trace por execução. Uma decisão errada espalhada por uma dezena de traces leva uma tarde inteira para explicar. Em um único trace, leva um scroll.