

Underagenter er bare forkerte
Explore with AI
Polylanes autofix-agent blev oprindeligt bygget som en workflow af flere underagenter, hver med ansvar for én enkelt opgave:
- en triage til at sortere gennem tusindvis af alarmer og signaler
- en koordinator til at styre underagenter
- op til femten underagenter til at undersøge alle mulige hypoteser for issuet
- og en kodeagent til til sidst at indsende en pull request
Et bekræftet issue kunne føre til op til 18 agenter og underagenter til undersøgelsen og rettelsen. I dag udføres det samme arbejde af én enkelt agent.
Workflowet var et solidt design baseret på det, vi vidste på det tidspunkt: små prompts, små værktøjssæt, en orchestrator til at bære resultater mellem specialister. Det var dog ekstremt dyrt og svært at drifte og ræsonnere om.
Hvad er et issue?
Polylane scanner logs, metrikker og traces fra hver cloudressource (Lambda-funktion, Cloudflare Worker, Vercel-projekt osv.) hos hver forbundet udbyder. For hver ressource gemmer vi baselines på tværs af flere tidshorisonter, så vi kan fange sæsonudsving i dataene. Vi vurderer derefter cloudressourcens aktuelle tilstand og sammenligner den med historiske data. Værdier, der bryder baselinen, registreres som issues.
Issues kan også oprettes af alarmer, vi modtager fra observability- og error tracking-løsninger.
Hvordan løser vi issues?
For at løse et issue skal vi:
- Triage: Indsamle data for at bekræfte eller afvise issuet.
- Undersøge: Vurdere flere hypoteser og fastslå rodårsagen.
- Åbne en pull request eller eskalere. Enten skrive en pull request for at løse issuet, eskalere til en engineer, hvis rettelsen ikke er en kodeændring, eller skrive en rapport, der fremhæver fundene, og stoppe.
Langt de fleste kørsler afsluttes, før der åbnes en pull request eller eskaleres, når Polylane konkluderer, at issuet enten er en falsk positiv eller uskadeligt.
Underagentarkitektur
Vores oprindelige arkitektur var baseret på flere underagenter.
Vi brugte en orchestrator-agent til at koordinere arbejdet mellem flere underagenter. Underagenter blev instansieret til at undersøge hypoteser og forsøgte at be- eller afkræfte hver hypotese med forskellige udgangspunkter (for eksempel ved at starte med at kigge på logs, eller starte med kodebasen osv.).
Underagenternes fund blev stemt om med simpel aritmetik og opsummeret af en anden agent, før de blev rullet op til koordinatoragenten.
Vurderingen af hver hypotese var en konfidensvægtet afstemning på tværs af dens gennemløb.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Når alle hypoteser var undersøgt, ville koordinatoren, hvis en rodårsag var identificeret, enten eskalere til en engineer eller skrive en plan for rettelsen. Denne plan blev givet videre til en kodende underagent, som implementerede rettelsen og indsendte pull requesten.
Hovedproblemet i denne arkitektur er tabet af kontekst mellem underagenterne. Hver agent sendte kun brudstykker af sin kontekst op eller ned gennem opsummering, og både opstrøms- og nedstrømsagenter måtte jævnligt gøre det samme arbejde om.
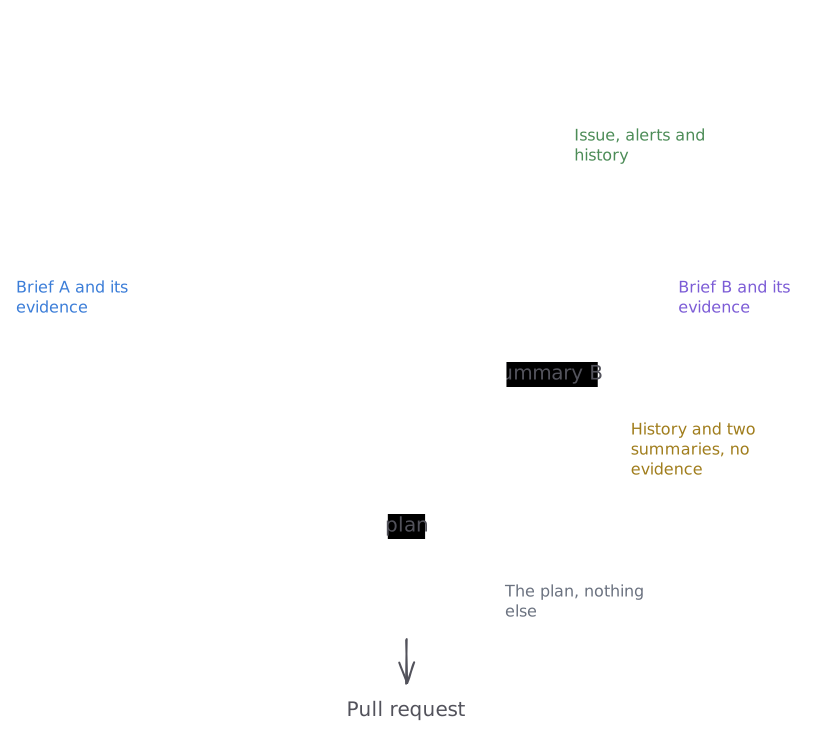
Desuden havde den agent, der skrev rettelsen, kun planen og manglede kontekst om det oprindelige issue eller de beviser, der var indsamlet under undersøgelsen. Det førte til pull requests af ringere kvalitet, som ofte fokuserede på symptomer frem for rodårsagen.
Vi valgte denne arkitektur primært, fordi frontier-modellerne, da vi først designede den i March 2026, ikke altid var i stand til at gennemføre en undersøgelse end-to-end, inklusive at skrive rettelsen, og også, helt enkelt, fordi vores harness ikke var særlig god.
Det blev stadig sværere at bygge videre på dette fundament, fordi:
- Debugging krævede mange traces. At ræsonnere om en end-to-end-undersøgelse krævede at kigge igennem flere, nogle gange snesevis af traces
- Evaluering foregik pr. trin. Hver underagent kunne evalueres individuelt og bestå, mens slutresultatet var dårligt, fordi fejlene lå i overdragelserne.
Vi itererede på denne arkitektur i månedsvis, forbedrede hver agent individuelt og finjusterede prompts og overdragelser, men resultaterne stod aldrig mål med indsatsen. Det var dyrt, svært at debugge, og pull requestsene var ikke gode nok.
Én agent
Sept 3 erstattede vi underagent-workflowet med én agent, der klarer alt fra triage til pull request. Den samme agent indsamler beviserne, undersøger alle hypoteserne og indsender pull requesten.
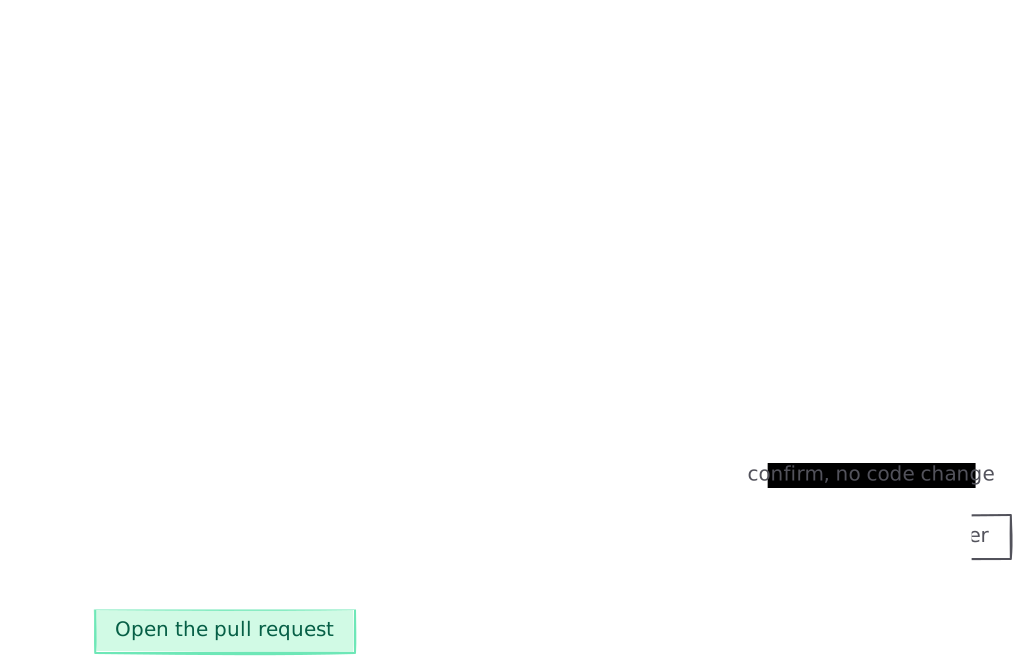
Vi slettede triage-agenten, koordinatoren, hypoteseagenterne og autofix-agenten sammen med de workflows, der bar resultater mellem dem, og de gates, der sad foran pull requesten. De driftsmæssige fordele var øjeblikkelige: én trace at evaluere, og ingen opsummeringer mellem underagenter.
Endnu vigtigere blev kvaliteten af pull requestsene bedre, og tiden mellem detektion af et issue og åbning af den pull request, der retter det, faldt drastisk. I løbet af måneden omkring omlægningen gik medianen fra 2.2 timer til 35 minutter, og p90 gik fra ni dage til under to timer. Under pipelinen lå et fund typisk i flere timer i en kæde af workflows, der hver ventede på den forrige. Under den ene agent åbnes pull requesten blot minutter efter, issuet er detekteret.
Vi åbner nu også langt flere pull requests. Da vi brugte underagenter, endte 0.6% af de detekterede issues i en pull request. Med den ene agent er det 4.2%, og stigende. Forskellen ligger i fejltilstandene. En pipeline med flere underagenter skal overleve hver eneste overdragelse: triage skal fremme fundet, koordinatoren skal producere hypoteser, fan-out’et skal nå frem til en vurdering, osv. Hver overdragelse er en potentiel fejltilstand.
Omkostningen pr. pull request faldt også. Hver kørsel starter nu på den stærkere model, så et afvist fund koster mere, end det gjorde under pipelinen. Men den gennemsnitlige omkostning pr. pull request gik fra $111 til omkring $18 i de første ni dage med den ene agent. Dette fald skyldes ikke udelukkende ændringen i arkitekturen, da vi aktivt itererer på alle aspekter af Polylane. Noget af det er den almindelige drift, man ser i et system under konstant iteration.
Alle værdier bag de tre grafer, pr. UTC-dag
| Dag | Detekterede issues med en pull request | Median | p90 | Forbrug pr. pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · én agent | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · til 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Byg ikke underagenter
- Overdragelser mister mere, end de sparer. Hver opsummering, der sendes mellem agenter, er kontekst, den næste agent aldrig vil have. Den agent, der indsamler beviserne, bør være den agent, der handler på dem.
- Evaluer kørslen, ikke agenterne. Evalueringer pr. agent består, mens systemet fejler, fordi fejlene ligger mellem agenterne.
- Behold én trace pr. kørsel. En forkert beslutning spredt ud over et dusin traces tager en eftermiddag at forklare. I én trace tager det et scroll.