

I sub-agenti sono semplicemente sbagliati
Explore with AI
L’agente autofix di Polylane era stato originariamente costruito come un workflow di più sub-agenti, ciascuno responsabile di un singolo compito:
- un triage per vagliare migliaia di alert e segnali
- un coordinatore per gestire i sub-agenti
- fino a quindici sub-agenti per indagare tutte le possibili ipotesi sull’issue
- e un agente di coding per inviare, alla fine, una pull request
Un’issue confermata poteva portare fino a 18 agenti e sub-agenti per l’indagine e la correzione. Oggi lo stesso lavoro viene svolto da un singolo agente.
Il workflow era una progettazione solida basata su quanto sapevamo all’epoca: prompt piccoli, set di strumenti ridotti, un orchestratore per trasferire i risultati tra gli specialisti. Era però estremamente costoso e difficile da gestire e da comprendere.
Cos’è un’issue?
Polylane analizza log, metriche e trace da ogni risorsa cloud (funzione Lambda, Cloudflare Worker, progetto Vercel, ecc.) su ogni provider collegato. Per ogni risorsa memorizziamo baseline su più orizzonti temporali, in modo da catturare la stagionalità nei dati. Valutiamo poi lo stato attuale della risorsa cloud e lo confrontiamo con i dati storici. I valori che superano la baseline vengono registrati come issue.
Le issue possono anche essere create dagli alert ricevuti da soluzioni di observability ed error tracking.
Come risolviamo le issue?
Per risolvere un’issue dobbiamo:
- Triage: raccogliere dati per confermare o respingere l’issue.
- Indagine: valutare più ipotesi e determinare la causa radice.
- Aprire una pull request o fare escalation. Scrivere una pull request per risolvere l’issue, fare escalation verso un engineer se la correzione non è una modifica al codice, oppure scrivere un report che evidenzia i risultati e fermarsi.
La stragrande maggioranza dei run termina prima di una pull request o di un’escalation, quando Polylane conclude che l’issue è un falso positivo o benigna.
Architettura a sub-agenti
La nostra architettura iniziale era basata su più sub-agenti.
Usavamo un agente orchestratore per coordinare il lavoro tra più sub-agenti. I sub-agenti venivano istanziati per indagare le ipotesi, cercando di dimostrare o confutare ciascuna ipotesi con punti di partenza diversi (per esempio partendo dai log, o partendo dalla codebase, ecc.).
I risultati dei sub-agenti venivano votati con semplice aritmetica e riassunti da un altro agente prima di essere trasmessi all’agente coordinatore.
Il verdetto di ogni ipotesi era un voto ponderato per confidenza tra i suoi pass.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Una volta indagate tutte le ipotesi, se veniva identificata una causa radice, il coordinatore faceva escalation verso un engineer oppure scriveva un piano per la correzione. Questo piano veniva poi passato a un sub-agente di coding per implementare la correzione e inviare la pull request.
Il problema principale di questa architettura è la perdita di contesto tra i sub-agenti. Ogni agente trasmetteva verso l’alto o verso il basso solo frazioni del proprio contesto, tramite riassunti, e sia gli agenti a monte che quelli a valle dovevano regolarmente rifare lo stesso lavoro.
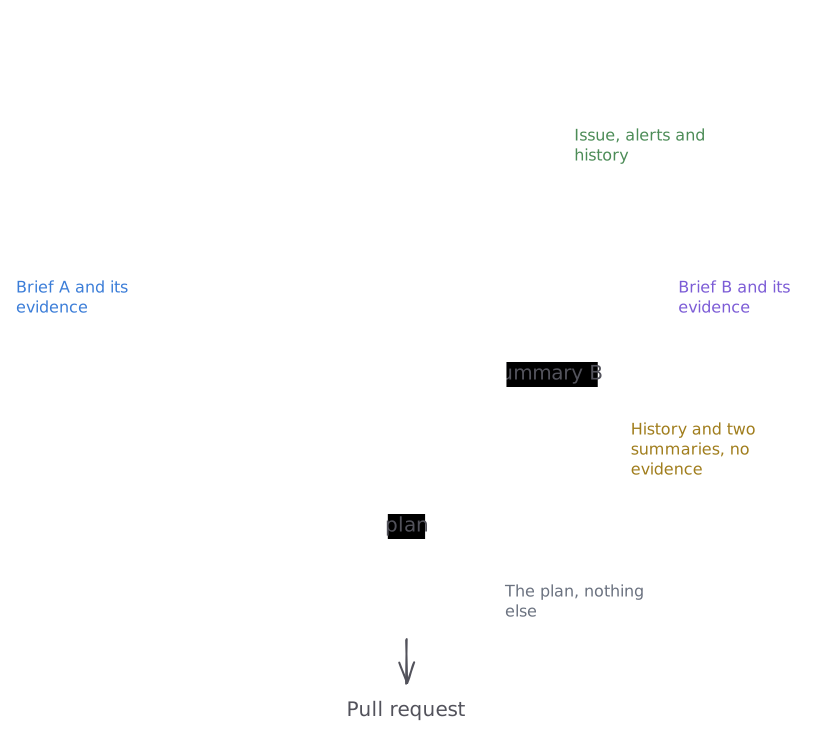
Inoltre, l’agente che scriveva la correzione disponeva solo del piano, senza contesto sull’issue originale o sulle prove raccolte durante l’indagine. Questo portava a pull request di qualità inferiore, spesso concentrate sui sintomi piuttosto che sulla causa radice.
Abbiamo scelto questa architettura soprattutto perché, quando l’abbiamo progettata per la prima volta a marzo 2026, i modelli più avanzati non erano sempre in grado di condurre un’indagine end-to-end, compresa la scrittura della correzione, e anche, semplicemente, il nostro harness non era abbastanza buono.
È diventato sempre più difficile costruire su queste fondamenta perché:
- Il debug richiedeva molte trace. Ragionare su un’indagine end-to-end richiedeva di analizzare più trace, a volte dozzine
- La valutazione era per fase. Ogni sub-agente poteva essere valutato individualmente e superare il test, mentre il risultato finale era scarso, perché i fallimenti si trovavano nei passaggi di consegne.
Abbiamo iterato su questa architettura per mesi, migliorando ogni agente individualmente e ottimizzando i prompt e i passaggi di consegne, ma i risultati non hanno mai eguagliato lo sforzo. Era costosa, difficile da debuggare, e le pull request non erano abbastanza buone.
Agente singolo
Il 3 settembre abbiamo sostituito il workflow a sub-agenti con un singolo agente che fa tutto, dal triage alla pull request. Lo stesso agente raccoglie le prove, indaga tutte le ipotesi e invia la pull request.
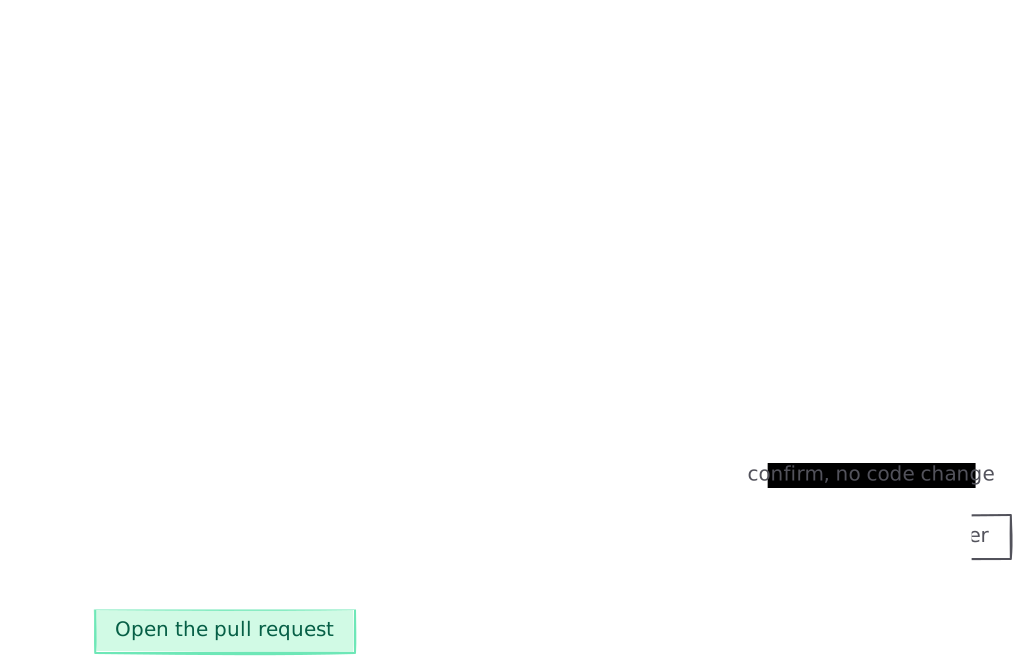
Abbiamo eliminato l’agente di triage, il coordinatore, gli agenti delle ipotesi e l’agente autofix, insieme ai workflow che trasportavano i risultati tra loro e ai gate che precedevano la pull request. I benefici operativi sono stati immediati: una sola trace da valutare, e nessun riassunto tra i sub-agenti.
Ancora più importante, la qualità delle pull request è migliorata, e il tempo tra il rilevamento di un’issue e l’apertura della pull request che la corregge è crollato. Nel mese intorno al passaggio, la mediana è passata da 2.2 ore a 35 minuti e il p90 da nove giorni a meno di due ore. Con la pipeline, un finding rimaneva tipicamente per diverse ore in una catena di workflow, ognuno in attesa del precedente. Con l’agente singolo, la pull request si apre pochi minuti dopo il rilevamento dell’issue.
Ora apriamo anche molte più pull request. Quando usavamo i sub-agenti, lo 0.6% delle issue rilevate finiva in una pull request. Con l’agente singolo è il 4.2%, e in crescita. La differenza sono le modalità di fallimento. Una pipeline con più sub-agenti deve sopravvivere a ogni passaggio di consegne: il triage deve promuovere il finding, il coordinatore deve produrre le ipotesi, il fan-out deve raggiungere un verdetto, ecc. Ogni passaggio di consegne è una potenziale modalità di fallimento.
Anche il costo per pull request è diminuito. Ogni run ora parte con il modello più potente, quindi un finding scartato costa più di quanto costasse con la pipeline. Ma il costo medio per pull request è passato da $111 a circa $18 nei primi nove giorni dell’agente singolo. Questo calo non è esclusivamente il risultato del cambio di architettura, dato che stiamo iterando attivamente su ogni aspetto di Polylane. Parte di esso è la normale deriva di un sistema in costante iterazione.
Ogni valore dietro i tre grafici, per giorno UTC
| Giorno | Issue rilevate con pull request | Mediana | p90 | Spesa per pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · un agente | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · fino alle 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Non costruire sub-agenti
- I passaggi di consegne perdono più di quanto salvino. Ogni riassunto passato tra gli agenti è contesto che l’agente successivo non avrà mai. L’agente che raccoglie le prove dovrebbe essere l’agente che agisce su di esse.
- Valuta il run, non gli agenti. Le valutazioni per singolo agente superano il test mentre il sistema fallisce, perché i fallimenti si trovano tra gli agenti.
- Mantieni una sola trace per run. Una decisione sbagliata distribuita su una dozzina di trace richiede un pomeriggio per essere spiegata. In una sola trace basta uno scroll.