

Los subagentes están simplemente equivocados
Explore with AI
El agente de autofix de Polylane se construyó originalmente como un flujo de trabajo de múltiples subagentes, cada uno responsable de una sola tarea:
- un triaje para clasificar miles de alertas y señales
- un coordinador para operar los subagentes
- hasta quince subagentes para investigar todas las hipótesis posibles del issue
- y un agente de programación para finalmente enviar un pull request
Un issue confirmado podía llevar hasta 18 agentes y subagentes para la investigación y el arreglo. Hoy el mismo trabajo lo hace un solo agente.
El flujo de trabajo era un diseño sólido basado en lo que sabíamos en ese momento: prompts pequeños, conjuntos de herramientas pequeños, un orquestador para transportar resultados entre especialistas. Sin embargo, era extremadamente costoso y difícil de operar y de razonar.
¿qué es un issue?
Polylane escanea logs, métricas y trazas de cada recurso de nube (Lambda Function, Cloudflare Worker, proyecto de Vercel, etc.) en cada proveedor conectado. Para cada recurso guardamos líneas base a lo largo de múltiples horizontes, de manera que podamos capturar la estacionalidad de los datos. Luego evaluamos el estado actual del recurso de nube y lo comparamos con datos históricos. Los valores que rompen la línea base se registran como issues.
Los issues también pueden crearse a partir de alertas que recibimos de soluciones de observabilidad y seguimiento de errores.
¿cómo resolvemos los issues?
Para resolver un issue, necesitamos:
- Triaje: recopilar datos para confirmar o rechazar el issue.
- Investigar: evaluar múltiples hipótesis y determinar la causa raíz.
- Abrir un pull request o escalar. Escribir un pull request para resolver el issue, escalar a un ingeniero si el arreglo no es un cambio de código, o escribir un informe que destaque los hallazgos y detenerse.
La gran mayoría de las ejecuciones terminan antes de un pull request o un escalado, cuando Polylane concluye que el issue es un falso positivo o benigno.
arquitectura de subagentes
Nuestra arquitectura inicial se basaba en múltiples subagentes.
Usábamos un agente orquestador para coordinar el trabajo entre múltiples subagentes. Se instanciaban subagentes para investigar hipótesis, tratando de probar o refutar cada hipótesis con distintos puntos de partida (por ejemplo, empezando por revisar los logs, o empezando por el código, etc.).
Los hallazgos de los subagentes se votaban con aritmética simple y los resumía otro agente antes de trasladarlos al agente coordinador.
El veredicto de cada hipótesis era un voto ponderado por confianza a lo largo de sus pasadas.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Una vez investigadas todas las hipótesis, si se identificaba una causa raíz, el coordinador escalaba a un ingeniero o escribía un plan para el arreglo. Este plan se entregaba a un subagente de programación para implementar el arreglo y enviar el pull request.
El principal problema de esta arquitectura es la pérdida de contexto entre subagentes. Cada agente transmitía hacia arriba o hacia abajo solo fracciones de su contexto, mediante resúmenes, y tanto los agentes anteriores como los posteriores tenían que rehacer regularmente el mismo trabajo.
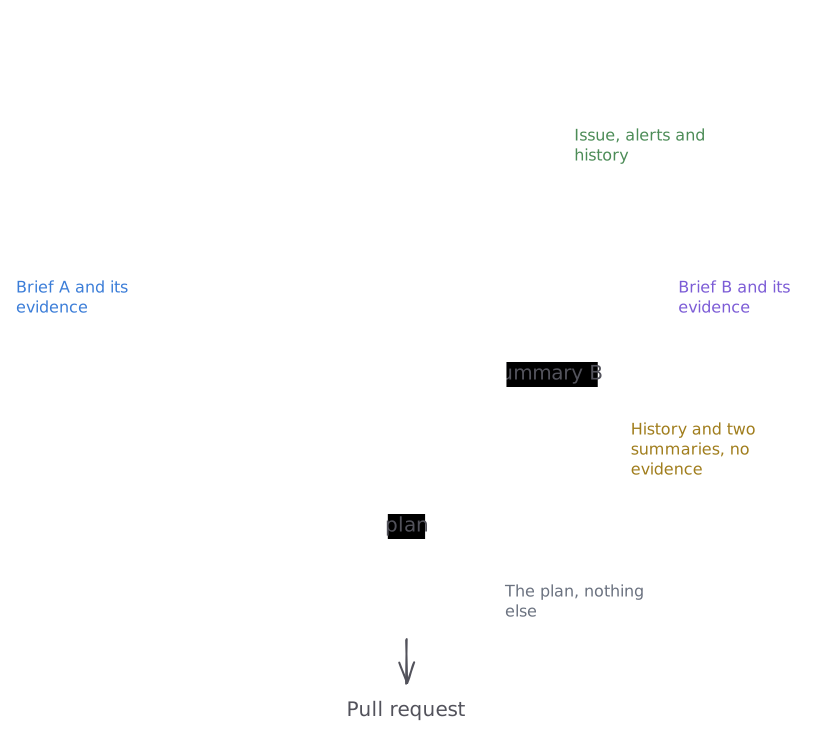
Además, el agente que escribía el arreglo solo tenía el plan, sin contexto sobre el issue original ni sobre la evidencia recopilada en la investigación. Esto llevaba a pull requests de baja calidad que a menudo se enfocaban en los síntomas en lugar de la causa raíz.
Elegimos esta arquitectura principalmente porque, cuando la diseñamos por primera vez en marzo de 2026, los modelos de frontera no siempre eran capaces de llevar a cabo una investigación de principio a fin, incluida la escritura del arreglo, y, sencillamente, nuestro harness tampoco era tan bueno.
Cada vez era más difícil construir sobre esta base, porque:
- Depurar requería muchas trazas. Razonar sobre una investigación de principio a fin requería revisar múltiples trazas, a veces docenas.
- La evaluación era por etapa. Cada subagente podía evaluarse individualmente y aprobar, mientras que el resultado final era pobre, porque los fallos vivían en los traspasos.
Iteramos sobre esta arquitectura durante meses, mejorando cada agente individualmente y ajustando los prompts y los traspasos, pero los resultados nunca estuvieron a la altura del esfuerzo. Era costoso, difícil de depurar, y los pull requests no eran suficientemente buenos.
un solo agente
El 3 de septiembre reemplazamos el flujo de trabajo de subagentes por un solo agente que hace todo, desde el triaje hasta el pull request. El mismo agente recopila la evidencia, investiga todas las hipótesis y envía el pull request.
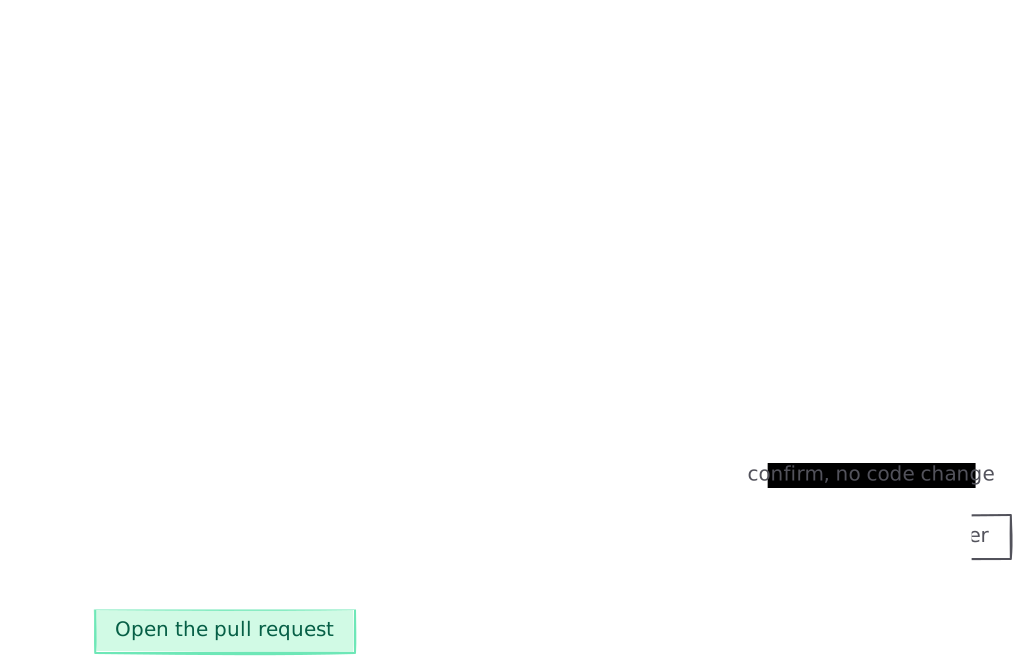
Eliminamos el agente de triaje, el coordinador, los agentes de hipótesis y el agente de autofix, junto con los flujos de trabajo que transportaban resultados entre ellos y las puertas de control que precedían al pull request. Los beneficios operativos fueron inmediatos: una sola traza para evaluar, y sin resúmenes entre subagentes.
Más importante aún, la calidad de los pull requests mejoró, y el tiempo entre detectar un issue y abrir el pull request que lo arregla se redujo drásticamente. Durante el mes en torno al cambio, la mediana pasó de 2.2 horas a 35 minutos y el p90 de nueve días a menos de dos horas. Con el pipeline, un hallazgo solía quedarse varias horas en una cadena de flujos de trabajo, cada uno esperando al anterior. Con el agente único, el pull request se abre solo minutos después de detectarse el issue.
Ahora también abrimos muchos más pull requests. Cuando usábamos subagentes, el 0.6% de los issues detectados terminaba en un pull request. Con el agente único es el 4.2%, y sigue subiendo. La diferencia está en los modos de fallo. Un pipeline con múltiples subagentes tiene que sobrevivir a cada traspaso: el triaje tiene que promover el hallazgo, el coordinador tiene que producir hipótesis, el fan-out tiene que llegar a un veredicto, etc. Cada traspaso es un posible modo de fallo.
El costo por pull request también bajó. Ahora cada ejecución comienza con el modelo más potente, así que un hallazgo descartado cuesta más de lo que costaba con el pipeline. Pero el costo promedio por pull request pasó de $111 a aproximadamente $18 en los primeros nueve días del agente único. Esta caída no es exclusivamente el resultado del cambio de arquitectura, ya que estamos iterando activamente en cada aspecto de Polylane. Parte de ella es la deriva normal de un sistema en iteración constante.
Todos los valores detrás de las tres gráficas, por día UTC
| Día | Issues detectados con pull request | Mediana | p90 | Gasto por pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · un agente | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · hasta las 16:00 | 8.2% | 30 min | 55 min | $2.88 |
no construyas subagentes
- Los traspasos pierden más de lo que ahorran. Cada resumen que pasa entre agentes es contexto que el siguiente agente nunca tendrá. El agente que recopila la evidencia debería ser el agente que actúa sobre ella.
- Evalúa la ejecución, no los agentes. Las evaluaciones por agente aprueban mientras el sistema falla, porque los fallos viven entre los agentes.
- Mantén una sola traza por ejecución. Una decisión equivocada repartida en una docena de trazas tarda una tarde en explicarse. En una sola traza basta con hacer scroll.