

Sub-agent เป็นแนวทางที่ผิด
Explore with AI
เอเจนต์ Autofix ของ Polylane เดิมทีถูกสร้างขึ้นเป็น workflow ของ sub-agent หลายตัว โดยแต่ละตัวรับผิดชอบงานเดียว:
- triage หนึ่งตัวสำหรับคัดกรอง alert และสัญญาณนับพันรายการ
- coordinator หนึ่งตัวสำหรับควบคุมการทำงานของ sub-agent
- sub-agent สูงสุด 15 ตัวสำหรับสืบสวนสมมติฐานที่เป็นไปได้ทั้งหมดสำหรับ issue
- และเอเจนต์เขียนโค้ดหนึ่งตัวสำหรับส่ง pull request ในท้ายที่สุด
issue ที่ได้รับการยืนยันอาจทำให้มีเอเจนต์และ sub-agent มากถึง 18 ตัวสำหรับการสืบสวนและการแก้ไข ทุกวันนี้งานเดียวกันนี้ทำโดยเอเจนต์ตัวเดียว
workflow นี้เป็นการออกแบบที่สมเหตุสมผลตามสิ่งที่เรารู้ในตอนนั้น: prompt ขนาดเล็ก ชุดเครื่องมือขนาดเล็ก และ orchestrator สำหรับส่งต่อผลลัพธ์ระหว่างผู้เชี่ยวชาญแต่ละด้าน อย่างไรก็ตาม มันมีค่าใช้จ่ายสูงมากและยากต่อการดำเนินงานและทำความเข้าใจ
Issue คืออะไร
Polylane สแกน log, metric และ trace จากทรัพยากรคลาวด์ทุกตัว (Lambda function, Cloudflare Worker, Vercel project และอื่นๆ) บนผู้ให้บริการที่เชื่อมต่อทุกราย สำหรับแต่ละทรัพยากรเราจะเก็บ baseline ในหลายช่วงเวลา เพื่อให้สามารถจับ seasonality ในข้อมูลได้ จากนั้นเราจะประเมินสถานะปัจจุบันของทรัพยากรคลาวด์และเปรียบเทียบกับข้อมูลในอดีต ค่าที่ทำลาย baseline จะถูกบันทึกเป็น issue
issue ยังสามารถถูกสร้างขึ้นจาก alert ที่เราได้รับจากโซลูชัน observability และ error tracking
เราแก้ไข issue อย่างไร
ในการแก้ไข issue เราต้อง:
- Triage: รวบรวมข้อมูลเพื่อยืนยันหรือปฏิเสธ issue
- สืบสวน: ประเมินสมมติฐานหลายข้อและหาสาเหตุที่แท้จริง
- เปิด pull request หรือ escalate เขียน pull request เพื่อแก้ไข issue, escalate ไปยังวิศวกรหากการแก้ไขไม่ใช่การเปลี่ยนแปลงโค้ด หรือเขียนรายงานสรุปสิ่งที่พบแล้วหยุด
การรันส่วนใหญ่จะจบลงก่อนถึงขั้นตอน pull request หรือ escalation เมื่อ Polylane สรุปว่า issue นั้นเป็น false positive หรือไม่มีอันตราย
สถาปัตยกรรมแบบ sub-agent
สถาปัตยกรรมเริ่มต้นของเราอิงอยู่กับ sub-agent หลายตัว
เราใช้ orchestrator agent เพื่อประสานงานระหว่าง sub-agent หลายตัว sub-agent จะถูกสร้างขึ้นมาเพื่อสืบสวนสมมติฐาน โดยพยายามพิสูจน์หรือหักล้างแต่ละสมมติฐานด้วยจุดเริ่มต้นที่ต่างกัน (เช่น เริ่มจากการดู log หรือเริ่มจาก codebase เป็นต้น)
ผลการค้นพบของ sub-agent จะถูกโหวตด้วยเลขคณิตอย่างง่ายและสรุปโดยเอเจนต์อีกตัวหนึ่ง ก่อนที่จะถูกรวบรวมส่งต่อไปยัง coordinator agent
คำตัดสินของแต่ละสมมติฐานเป็นการโหวตแบบถ่วงน้ำหนักด้วยความเชื่อมั่น (confidence) ในแต่ละ pass
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
เมื่อสมมติฐานทั้งหมดได้รับการสืบสวนแล้ว หากพบสาเหตุที่แท้จริง coordinator จะ escalate ไปยังวิศวกรหรือเขียนแผนสำหรับการแก้ไข แผนนี้จะถูกส่งต่อไปยัง coding sub-agent เพื่อนำไปปรับใช้และส่ง pull request
ปัญหาหลักของสถาปัตยกรรมนี้คือการสูญเสีย context ระหว่าง sub-agent แต่ละเอเจนต์ส่งต่อ context เพียงบางส่วนขึ้นหรือลงผ่านการสรุปความ (summarization) และทั้งเอเจนต์ต้นทางและปลายทางมักต้องทำงานเดิมซ้ำอยู่เสมอ
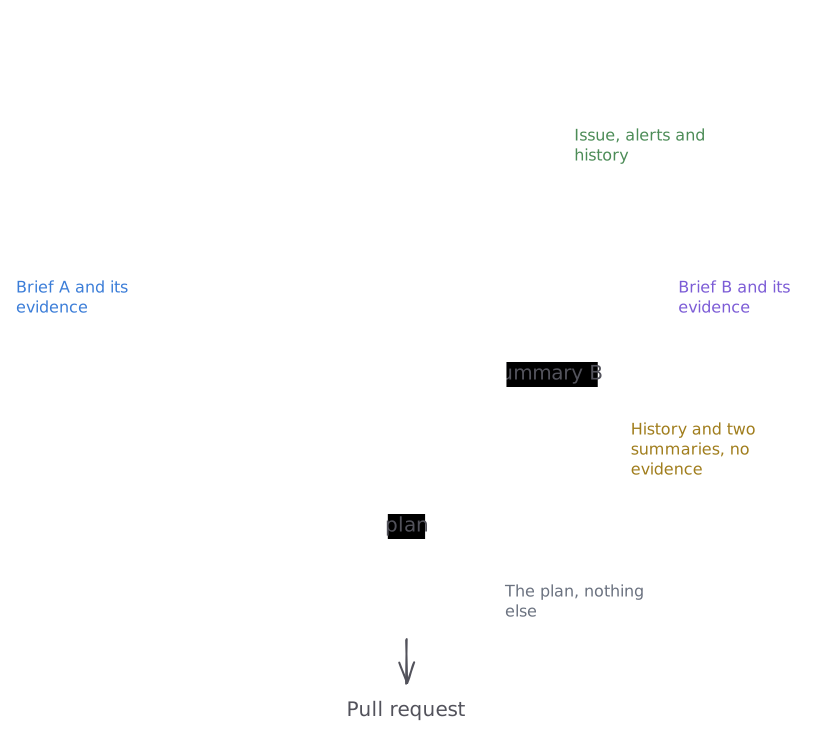
ยิ่งไปกว่านั้น เอเจนต์ที่เขียนการแก้ไขมีเพียงแผนเท่านั้น ขาด context เกี่ยวกับ issue ดั้งเดิมหรือหลักฐานที่รวบรวมได้ระหว่างการสืบสวน สิ่งนี้นำไปสู่ pull request คุณภาพต่ำกว่ามาตรฐานที่มักมุ่งเน้นไปที่อาการมากกว่าสาเหตุที่แท้จริง
เราเลือกสถาปัตยกรรมนี้เป็นหลักเพราะตอนที่เราออกแบบครั้งแรกในเดือนมีนาคม 2026 frontier model ยังไม่สามารถรันการสืบสวนแบบ end-to-end ได้เสมอไป รวมถึงการเขียนการแก้ไขด้วย และพูดตรงๆ ว่า harness ของเราก็ยังไม่ดีพอ
การพัฒนาต่อยอดบนพื้นฐานนี้ยากขึ้นเรื่อยๆ เพราะ:
- การ debug ต้องใช้ trace จำนวนมาก การให้เหตุผลเกี่ยวกับการสืบสวนแบบ end-to-end ต้องดู trace หลายรายการ บางครั้งมากถึงหลายสิบรายการ
- การประเมินผลทำเป็นรายขั้นตอน sub-agent แต่ละตัวสามารถถูกประเมินแยกกันและผ่านได้ ในขณะที่ผลลัพธ์สุดท้ายกลับแย่ เพราะความล้มเหลวเกิดขึ้นในขั้นตอนการส่งต่อ (handoff)
เราทำการปรับปรุงสถาปัตยกรรมนี้ต่อเนื่องเป็นเดือน โดยพัฒนาแต่ละเอเจนต์ทีละตัวและปรับแต่ง prompt และ handoff แต่ผลลัพธ์ไม่เคยคุ้มค่ากับความพยายามที่ลงไป มันมีค่าใช้จ่ายสูง debug ยาก และ pull request ก็ยังไม่ดีพอ
เอเจนต์ตัวเดียว
เมื่อวันที่ 3 กันยายน เราได้แทนที่ workflow แบบ sub-agent ด้วยเอเจนต์ตัวเดียวที่ทำทุกอย่างตั้งแต่ triage ไปจนถึง pull request เอเจนต์ตัวเดียวกันนี้รวบรวมหลักฐาน สืบสวนสมมติฐานทั้งหมด และส่ง pull request
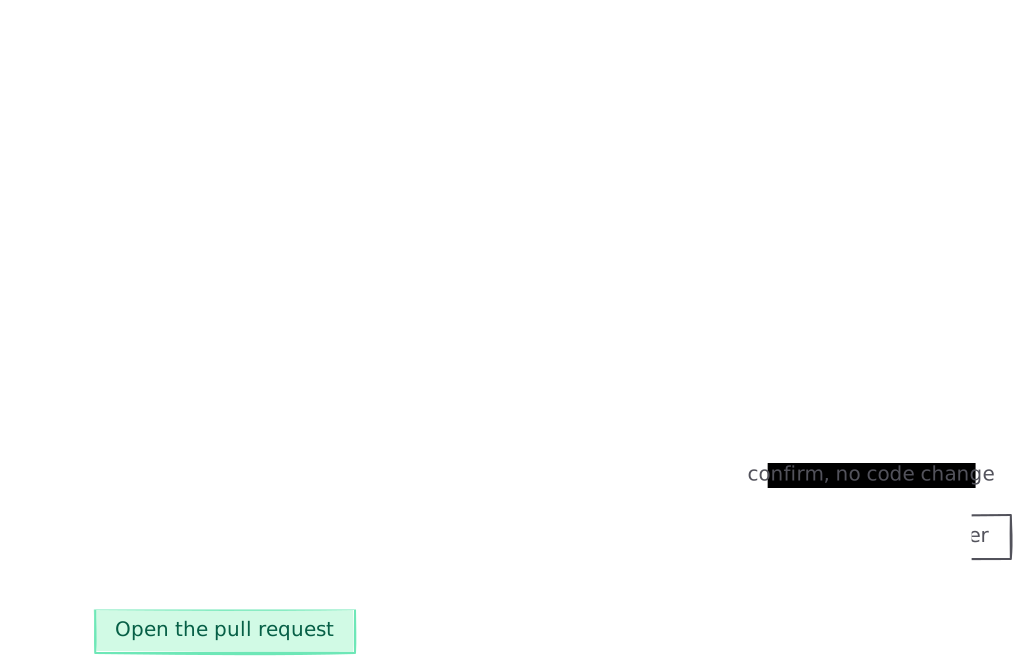
เราลบ triage agent, coordinator, hypothesis agent และ autofix agent ออกไปทั้งหมด พร้อมกับ workflow ที่ส่งต่อผลลัพธ์ระหว่างกันและด่านตรวจ (gate) ที่อยู่หน้า pull request ประโยชน์ด้านการดำเนินงานเห็นผลทันที: มี trace เดียวให้ประเมิน และไม่มีการสรุปความระหว่าง sub-agent อีกต่อไป
ที่สำคัญกว่านั้น คุณภาพของ pull request ดีขึ้น และเวลาระหว่างการตรวจพบ issue กับการเปิด pull request เพื่อแก้ไขก็ลดลงอย่างมาก ในช่วงเดือนรอบการเปลี่ยนผ่าน (cutover) ค่า median ลดลงจาก 2.2 ชั่วโมงเหลือ 35 นาที และ p90 ลดลงจาก 9 วันเหลือไม่ถึง 2 ชั่วโมง ภายใต้ pipeline เดิม ผลการค้นพบมักค้างอยู่หลายชั่วโมงในสายของ workflow ที่แต่ละขั้นตอนต้องรอขั้นตอนก่อนหน้า ภายใต้เอเจนต์ตัวเดียว pull request จะเปิดขึ้นภายในไม่กี่นาทีหลังตรวจพบ issue
ตอนนี้เรายังเปิด pull request มากขึ้นกว่าเดิมมาก เมื่อเราใช้ sub-agent มีเพียง 0.6% ของ issue ที่ตรวจพบที่จบลงด้วย pull request ภายใต้เอเจนต์ตัวเดียว ตัวเลขนี้อยู่ที่ 4.2% และกำลังเพิ่มขึ้น ความแตกต่างอยู่ที่รูปแบบความล้มเหลว (failure mode) pipeline ที่มี sub-agent หลายตัวต้องรอดผ่านทุกขั้นตอนการส่งต่อ (handoff): triage ต้องเลื่อนขั้นผลการค้นพบ coordinator ต้องสร้างสมมติฐาน fan-out ต้องได้คำตัดสิน และอื่นๆ แต่ละ handoff คือรูปแบบความล้มเหลวที่อาจเกิดขึ้นได้
ค่าใช้จ่ายต่อ pull request ก็ลดลงเช่นกัน ตอนนี้ทุกการรันเริ่มต้นด้วยโมเดลที่แข็งแกร่งกว่า ดังนั้นผลการค้นพบที่ถูกยกเลิกจึงมีค่าใช้จ่ายสูงกว่าตอนที่ใช้ pipeline แต่ค่าใช้จ่ายเฉลี่ยต่อ pull request ลดลงจาก $111 เหลือประมาณ $18 ในช่วง 9 วันแรกของเอเจนต์ตัวเดียว การลดลงนี้ไม่ได้เป็นผลมาจากการเปลี่ยนสถาปัตยกรรมเพียงอย่างเดียว เนื่องจากเรากำลังปรับปรุงทุกส่วนของ Polylane อยู่ตลอดเวลา ส่วนหนึ่งก็เป็นความคลาดเคลื่อนตามปกติของระบบที่มีการปรับปรุงอย่างต่อเนื่อง
ค่าทั้งหมดที่อยู่เบื้องหลังกราฟทั้งสาม แยกตามวันแบบ UTC
| วัน | Issue ที่ตรวจพบซึ่งมี pull request | ค่ามัธยฐาน | p90 | ค่าใช้จ่ายต่อ pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · เอเจนต์เดียว | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · ถึง 16:00 | 8.2% | 30 min | 55 min | $2.88 |
อย่าสร้าง sub-agent
- Handoff สูญเสียมากกว่าที่ประหยัดได้ ทุกการสรุปความที่ส่งต่อระหว่างเอเจนต์คือ context ที่เอเจนต์ถัดไปจะไม่มีวันได้รับ เอเจนต์ที่รวบรวมหลักฐานควรเป็นเอเจนต์ที่ลงมือทำด้วยหลักฐานนั้น
- ประเมินการรัน ไม่ใช่ประเมินเอเจนต์ การประเมินแบบรายเอเจนต์อาจผ่าน ในขณะที่ระบบโดยรวมล้มเหลว เพราะความล้มเหลวเกิดขึ้นระหว่างเอเจนต์แต่ละตัว
- เก็บ trace เดียวต่อหนึ่งการรัน การตัดสินใจที่ผิดพลาดซึ่งกระจายอยู่ในสิบกว่า trace ต้องใช้เวลาทั้งบ่ายในการอธิบาย ในขณะที่ trace เดียวใช้แค่เลื่อนดู