

Subagenty są po prostu błędne
Explore with AI
Agent Autofix w Polylane pierwotnie był zbudowany jako przepływ złożony z wielu subagentów, z których każdy odpowiadał za jedno zadanie:
- agent triażu przesiewający tysiące alertów i sygnałów
- koordynator zarządzający subagentami
- do piętnastu subagentów badających wszystkie możliwe hipotezy dotyczące problemu
- oraz agent kodujący, który ostatecznie otwiera pull request
Potwierdzony problem mógł uruchomić nawet 18 agentów i subagentów zaangażowanych w dochodzenie i poprawkę. Dziś tę samą pracę wykonuje jeden agent.
Ten przepływ był rozsądnym rozwiązaniem, biorąc pod uwagę ówczesną wiedzę: małe prompty, małe zestawy narzędzi, orkiestrator przekazujący wyniki między specjalistami. Był jednak niezwykle kosztowny oraz trudny w obsłudze i analizie.
Czym jest problem?
Polylane skanuje logi, metryki i ślady z każdego zasobu chmurowego (funkcja Lambda, Cloudflare Worker, projekt Vercel itd.) u każdego podłączonego dostawcy. Dla każdego zasobu przechowujemy baseline’y obejmujące wiele horyzontów czasowych, dzięki czemu możemy uchwycić sezonowość w danych. Następnie oceniamy bieżący stan zasobu chmurowego i porównujemy go z danymi historycznymi. Wartości, które przekraczają baseline, są rejestrowane jako problemy.
Problemy mogą też powstawać z alertów otrzymywanych z rozwiązań do obserwowalności i śledzenia błędów.
Jak rozwiązujemy problemy?
Aby rozwiązać problem, musimy:
- Triaż: zbierz dane, żeby potwierdzić lub odrzucić problem.
- Zbadaj: oceń wiele hipotez i ustal przyczynę źródłową.
- Otwórz pull request albo eskaluj. Napisz pull request, który rozwiąże problem, eskaluj do inżyniera, jeśli poprawka nie jest zmianą kodu, albo napisz raport z ustaleniami i zakończ.
Zdecydowana większość przebiegów kończy się jeszcze przed pull requestem czy eskalacją, gdy Polylane uzna, że problem jest fałszywym alarmem albo jest niegroźny.
Architektura oparta na subagentach
Nasza pierwotna architektura opierała się na wielu subagentach.
Używaliśmy agenta orkiestrującego do koordynowania pracy wielu subagentów. Subagenty tworzono, aby badały hipotezy, próbując potwierdzić lub obalić każdą z nich z różnych punktów startowych (na przykład zaczynając od przeglądu logów albo od kodu bazowego).
Ustalenia subagentów poddawano prostemu głosowaniu arytmetycznemu i podsumowywano przez kolejnego agenta, zanim trafiały do agenta koordynującego.
Werdykt dla każdej hipotezy powstawał z głosowania ważonego pewnością w poszczególnych przebiegach.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Gdy zbadano już wszystkie hipotezy, jeśli udało się ustalić przyczynę źródłową, koordynator eskalował do inżyniera albo pisał plan poprawki. Ten plan trafiał do kodującego subagenta, który wdrażał poprawkę i otwierał pull request.
Głównym problemem tej architektury jest utrata kontekstu między subagentami. Każdy agent przekazywał w górę lub w dół tylko fragmenty swojego kontekstu, w formie podsumowań, przez co agenci na obu końcach regularnie musieli powtarzać tę samą pracę.
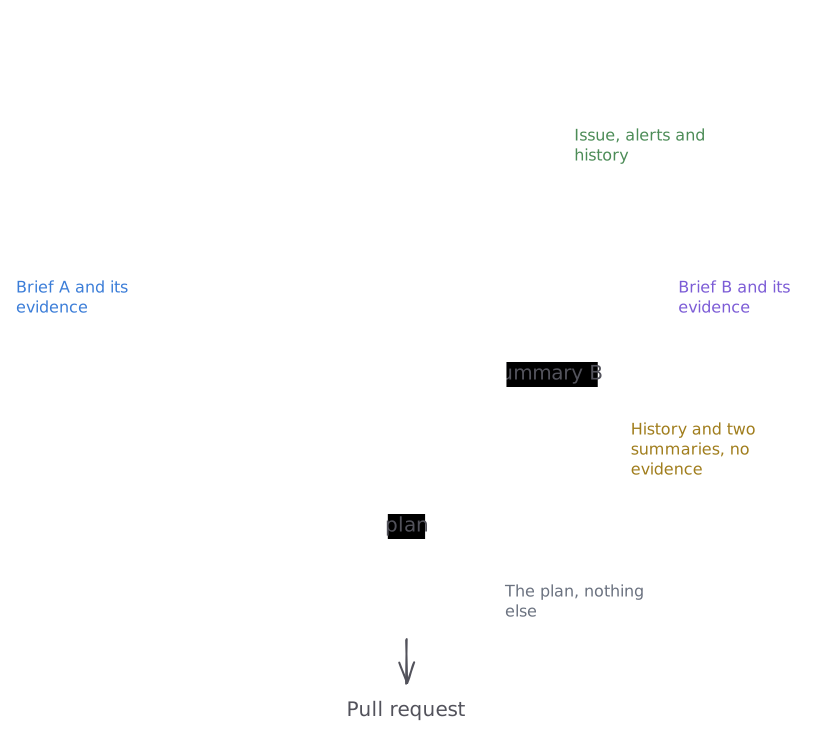
Co więcej, agent piszący poprawkę dysponował wyłącznie planem, bez kontekstu na temat pierwotnego problemu czy dowodów zebranych podczas dochodzenia. Prowadziło to do słabszych pull requestów, które często skupiały się na objawach, a nie na przyczynie źródłowej.
Wybraliśmy tę architekturę przede wszystkim dlatego, że kiedy projektowaliśmy ją po raz pierwszy w marcu 2026 roku, najbardziej zaawansowane modele nie zawsze potrafiły przeprowadzić dochodzenie od początku do końca, łącznie z napisaniem poprawki, a poza tym, mówiąc wprost, nasz harness nie był wtedy zbyt dobry.
Budowanie na tym fundamencie stawało się coraz trudniejsze, ponieważ:
- Debugowanie wymagało wielu śladów. Prześledzenie całego dochodzenia od początku do końca wymagało przejrzenia wielu, czasem kilkudziesięciu śladów.
- Ewaluacja odbywała się etapami. Każdy subagent mógł zostać oceniony osobno i przejść ocenę pozytywnie, mimo że wynik końcowy był słaby, bo błędy tkwiły w przekazaniach między agentami.
Iterowaliśmy nad tą architekturą przez miesiące, ulepszając każdego agenta z osobna i dopracowując prompty oraz przekazania, ale efekty nigdy nie były proporcjonalne do włożonego wysiłku. Było to kosztowne, trudne do debugowania, a pull requesty nie były wystarczająco dobre.
Jeden agent
3 września zastąpiliśmy przepływ oparty na subagentach jednym agentem, który robi wszystko: od triażu aż po pull request. Ten sam agent zbiera dowody, bada wszystkie hipotezy i otwiera pull request.
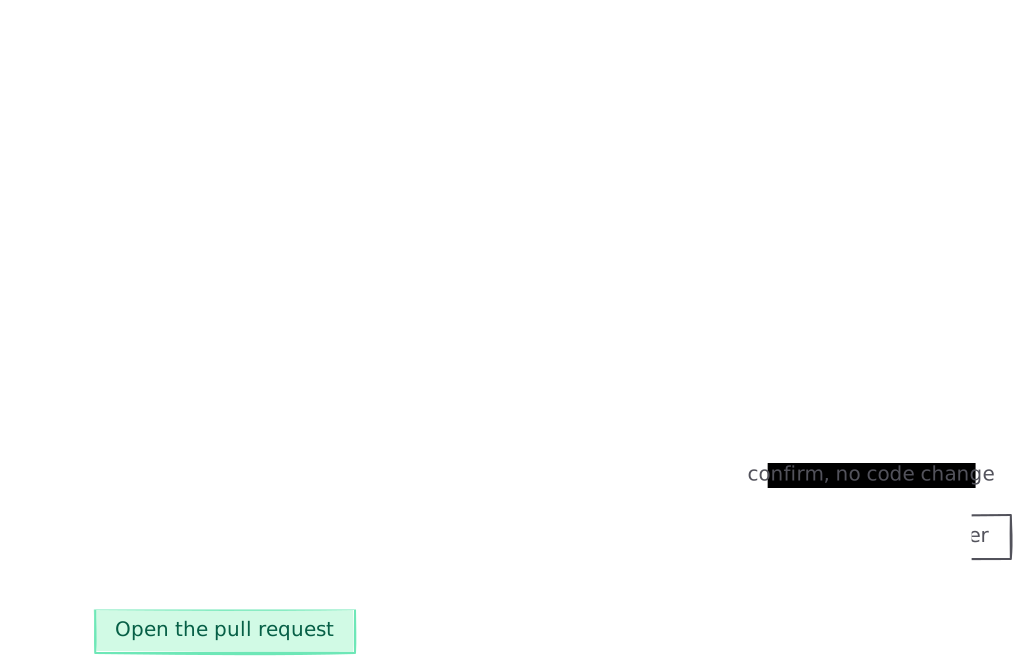
Usunęliśmy agenta triażu, koordynatora, agentów hipotez oraz agenta Autofix, razem z przepływami przekazującymi wyniki między nimi i bramkami stojącymi przed pull requestem. Korzyści operacyjne pojawiły się natychmiast: jeden ślad do oceny i brak podsumowań między subagentami.
Co ważniejsze, poprawiła się jakość pull requestów, a czas między wykryciem problemu a otwarciem pull requesta, który go naprawia, gwałtownie się skrócił. W miesiącu wokół tej zmiany mediana spadła z 2.2 godziny do 35 minut, a p90 z dziewięciu dni do mniej niż dwóch godzin. W pipeline ustalenie zwykle czekało wiele godzin w łańcuchu przepływów, z których każdy czekał na poprzedni. Przy jednym agencie pull request otwiera się już kilka minut po wykryciu problemu.
Teraz otwieramy też dużo więcej pull requestów. Gdy korzystaliśmy z subagentów, 0.6% wykrytych problemów kończyło się pull requestem. Przy jednym agencie jest to 4.2%, i ten odsetek rośnie. Różnica leży w trybach awarii. Pipeline z wieloma subagentami musi przetrwać każde przekazanie: triaż musi przepuścić ustalenie dalej, koordynator musi wygenerować hipotezy, fan-out musi dojść do werdyktu itd. Każde przekazanie to potencjalny tryb awarii.
Koszt na pull request też spadł. Każdy przebieg teraz zaczyna się na mocniejszym modelu, więc odrzucone ustalenie kosztuje więcej niż w pipeline. Mimo to średni koszt na pull request spadł z $111 do około $18 w ciągu pierwszych dziewięciu dni działania jednego agenta. Ten spadek nie wynika wyłącznie ze zmiany architektury, bo aktywnie iterujemy nad każdym aspektem Polylane. Część z niego to zwykły dryf systemu poddawanego ciągłej iteracji.
Wszystkie wartości stojące za trzema wykresami, w podziale na dni UTC
| Dzień | Wykryte problemy z pull requestem | Mediana | p90 | Wydatek na pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · jeden agent | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · do 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Nie buduj subagentów
- Przekazania tracą więcej, niż oszczędzają. Każde podsumowanie przekazywane między agentami to kontekst, którego kolejny agent już nigdy nie pozna. Agent, który zbiera dowody, powinien być tym, który na ich podstawie działa.
- Oceniaj przebieg, nie agentów. Ewaluacje poszczególnych agentów mogą przechodzić pozytywnie, podczas gdy cały system zawodzi, bo błędy tkwią między agentami.
- Trzymaj jeden ślad na przebieg. Błędną decyzję rozproszoną po kilkunastu śladach trzeba tłumaczyć całe popołudnie. W jednym śladzie wystarczy przewinięcie.