

Sub-agents are just wrong
Explore with AI
Polylane 的 autofix 代理原本是由多個子代理組成的工作流程建構而成,每個子代理各自負責一項任務:
- 一個分流代理,用來從數千個警示與訊號中篩選
- 一個協調代理,用來操控子代理
- 最多十五個子代理,用來調查問題所有可能的假設
- 以及一個程式碼代理,最終提交 pull request
一個已確認的問題,調查與修復可能會動用到多達 18 個代理與子代理。如今,同樣的工作由單一代理完成。
這個工作流程在當時我們所知的條件下,是個合理的設計:小型提示、小型工具集、由一個協調者在專家之間傳遞結果。但它的營運成本極高,也非常難以操作與推敲。
什麼是問題?
Polylane 掃描每個已連接供應商上,每個雲端資源(Lambda function、Cloudflare Worker、Vercel 專案等)的日誌、指標與追蹤。針對每個資源,我們會儲存跨多個時間範圍的基準線,藉此捕捉資料中的季節性變化。接著我們會評估雲端資源目前的狀態,並與歷史資料比對。凡是超出基準線的數值,都會被記錄為問題。
問題也可能是由我們從可觀測性與錯誤追蹤解決方案收到的警示所建立。
我們如何解決問題?
要解決一個問題,我們需要:
- **分流:**蒐集資料以確認或駁回這個問題。
- **調查:**評估多個假設並判定根本原因。
- **開啟 pull request 或升級。**若能修復,就寫出 pull request 解決問題;若修復不是程式碼變更,則升級給工程師;否則寫出一份報告說明調查結果並結束。
絕大多數的執行會在開出 pull request 或升級之前就結束,因為 Polylane 判定該問題是誤判或屬於無害情況。
子代理架構
我們最初的架構是以多個子代理為基礎。
我們使用一個協調代理,在多個子代理之間協調工作。子代理會被實例化來調查各種假設,嘗試從不同的起點證明或推翻每個假設(例如從日誌開始,或從程式碼庫開始等)。
子代理的調查結果會以簡單的算術方式投票,並由另一個代理彙整摘要,再彙報給協調代理。
每個假設的判定,都是根據多次執行結果加權信心值後的投票。
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
一旦所有假設都調查完畢,若找出根本原因,協調代理會選擇升級給工程師,或寫出一份修復計畫。這份計畫會交給程式碼子代理來實作修復並提交 pull request。
這個架構的主要問題在於子代理之間的情境流失。每個代理透過摘要,只把片段情境向上或向下傳遞,上游與下游的代理常常需要重做相同的工作。
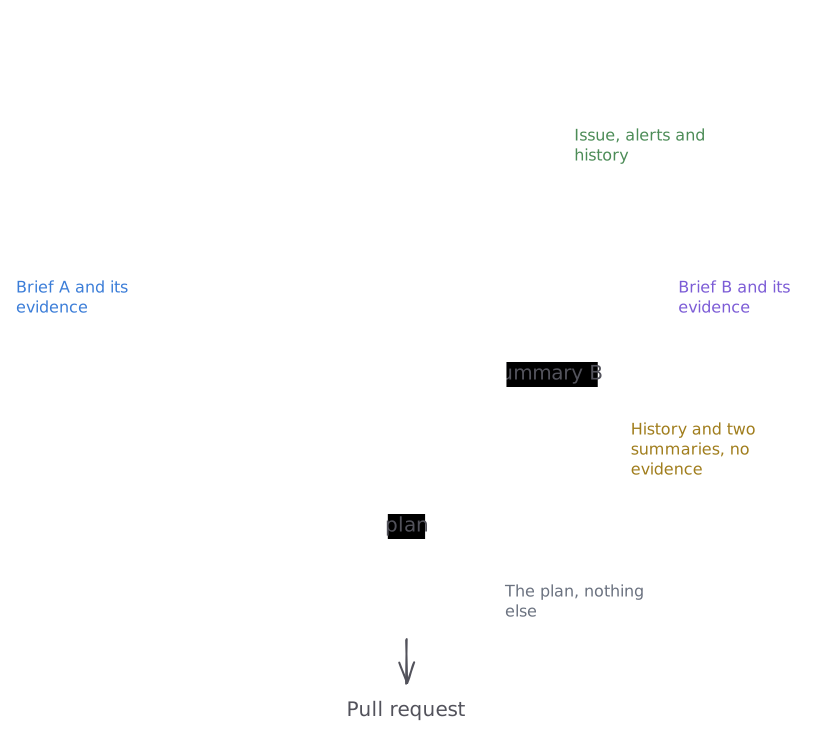
此外,負責寫出修復的代理,手上只有那份計畫,缺乏原始問題或調查中蒐集到的證據等情境。這導致 pull request 品質不佳,往往只針對症狀,而非根本原因。
我們一開始選擇這個架構,主要是因為在 2026 年 3 月首次設計時,前沿模型並非總能端到端完成一次調查,包含寫出修復方案,而且坦白說,我們當時的執行機制也還沒那麼成熟。
在這個基礎上繼續建構,變得越來越困難,因為:
- **除錯需要查看許多追蹤紀錄。**要推敲一次端到端的調查,往往需要查看多個,有時甚至是數十個追蹤紀錄
- **評估是逐階段進行的。**每個子代理可以個別通過評估,但最終結果卻很差,因為問題就出在交接環節。
我們針對這個架構迭代了好幾個月,逐一改進每個代理,並調整提示與交接方式,但成果始終配不上所付出的努力。它成本高昂、難以除錯,pull request 的品質也不夠好。
單一代理
9 月 3 日,我們把子代理工作流程換成單一代理,從分流到 pull request 全部由它完成。同一個代理蒐集證據、調查所有假設,並提交 pull request。
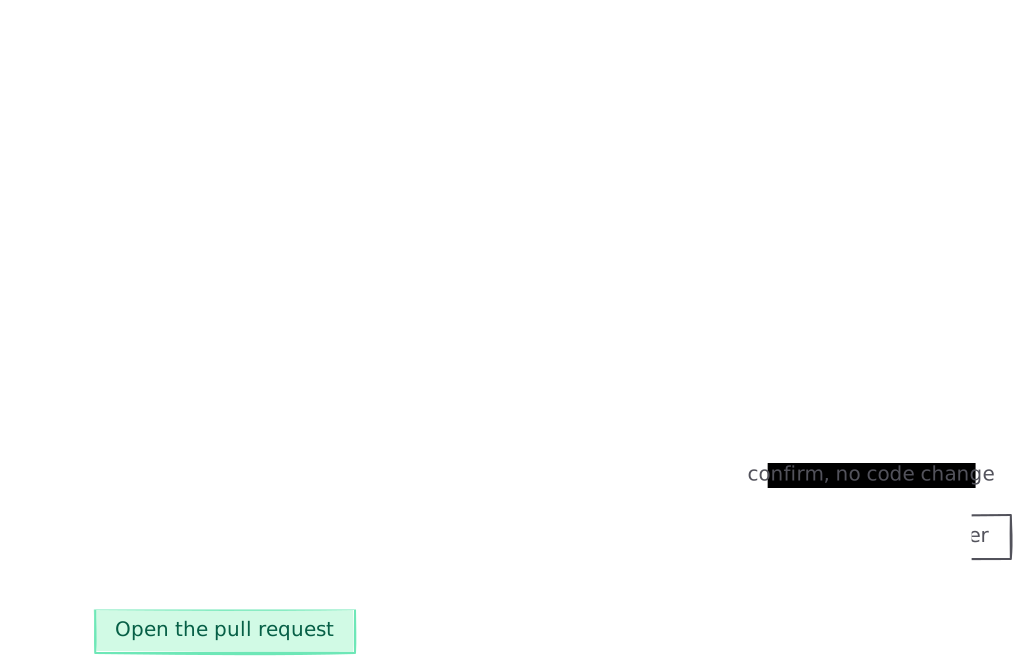
我們刪除了分流代理、協調代理、假設子代理,以及 autofix 代理,連同在它們之間傳遞結果的工作流程,還有擋在 pull request 前面的關卡也一併移除。營運上的效益立即浮現:只需評估一條追蹤紀錄,子代理之間也不再有摘要。
更重要的是,pull request 的品質提升了,從偵測到問題到開出修復用的 pull request 之間的時間也大幅縮短。在轉換前後那個月,中位數從 2.2 小時降到 35 分鐘,p90 則從九天降到不到兩小時。在舊管線下,一項發現通常會在一連串彼此等待的工作流程中卡上數小時。在單一代理下,pull request 在偵測到問題後幾分鐘內就會開出。
現在我們開出的 pull request 也多得多。當我們使用子代理時,被偵測到的問題中只有 0.6% 最終開出 pull request。換成單一代理後,這個比例是 4.2%,而且還在上升。差別在於失敗模式。一個由多個子代理組成的管線,必須撐過每一個交接環節:分流要能把發現往上推、協調代理要能產出假設、扇出調查要能達成判定,以此類推。每一次交接都是潛在的失敗點。
每個 pull request 的成本也隨之下降。現在每次執行都是從更強的模型開始,所以一個被駁回的發現,成本比在舊管線下更高。儘管如此,單一代理上線後的前九天,平均每個 pull request 的成本從 $111 降到約 $18。這個下降並非完全是架構改變的結果,因為我們也持續在 Polylane 的各個面向上迭代。其中一部分只是系統在持續迭代下的一般變化。
三張圖表背後的所有數值,依 UTC 日期
| 日期 | 有 pull request 的已偵測問題 | 中位數 | p90 | 每個 pull request 的花費 |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · 單一代理 | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · 至 16:00 | 8.2% | 30 min | 55 min | $2.88 |
不要建構子代理
- **交接環節損失的比省下的多。**每一份在代理之間傳遞的摘要,都是下一個代理永遠拿不到的情境。蒐集證據的代理,就該是採取行動的那個代理。
- **評估整次執行,而不是評估各個代理。**逐一評估代理可以通過,但整個系統卻可能失敗,因為問題就出在代理之間。
- **每次執行只保留一條追蹤紀錄。**一個錯誤的決策若分散在十幾條追蹤紀錄裡,要花一個下午才能解釋清楚。若只有一條追蹤紀錄,滑一下就看完了。