

Sub-agents are just wrong
Explore with AI
Autofix agent Polylane спочатку був побудований як workflow з кількох субагентів, кожен з яких відповідав за одне завдання:
- тріаж, щоб розібрати тисячі алертів і сигналів
- координатор, що керує субагентами
- до п’ятнадцяти субагентів, щоб дослідити всі можливі гіпотези щодо проблеми
- і агент кодування, який зрештою подає pull request
Підтверджена проблема могла спричинити до 18 агентів і субагентів для розслідування та виправлення. Сьогодні ту саму роботу виконує один агент.
Цей workflow був обґрунтованим рішенням, виходячи з того, що ми знали на той час: невеликі промпти, невеликі набори інструментів, оркестратор, що переносить результати між спеціалізованими агентами. Однак це було надзвичайно дорого і складно експлуатувати та осмислювати.
Що таке проблема?
Polylane сканує логи, метрики та трейси з кожного хмарного ресурсу (Lambda-функція, Cloudflare Worker, проєкт Vercel тощо) на кожному підключеному провайдері. Для кожного ресурсу ми зберігаємо базові рівні на кількох горизонтах, щоб фіксувати сезонність у даних. Потім ми оцінюємо поточний стан хмарного ресурсу та порівнюємо його з історичними даними. Значення, що виходять за межі базового рівня, фіксуються як проблеми.
Проблеми також можуть створюватися алертами, які ми отримуємо від рішень спостережуваності та відстеження помилок.
Як ми вирішуємо проблеми?
Щоб вирішити проблему, нам потрібно:
- Тріаж: зібрати дані, щоб підтвердити або відхилити проблему.
- Розслідувати: оцінити кілька гіпотез і визначити першопричину.
- Відкрити pull request або ескалувати. Або написати pull request, щоб вирішити проблему, або ескалувати до інженера, якщо виправлення не є зміною коду, або написати звіт з описом висновків і зупинитися.
Переважна більшість запусків завершується до pull request або ескалації, коли Polylane доходить висновку, що проблема є або хибним спрацюванням, або нешкідливою.
Архітектура з субагентами
Наша початкова архітектура базувалася на кількох субагентах.
Ми використовували агента-оркестратора, щоб координувати роботу між кількома субагентами. Субагенти створювалися для дослідження гіпотез, намагаючись довести або спростувати кожну гіпотезу з різних вихідних точок (наприклад, починаючи з логів або починаючи з кодової бази тощо).
Висновки субагентів голосувалися за допомогою простої арифметики і узагальнювалися ще одним агентом, перш ніж передаватися координатору.
Висновок щодо кожної гіпотези був голосуванням з вагою за впевненістю по всіх проходах.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Після того, як усі гіпотези були досліджені, якщо першопричину було визначено, координатор або ескалував до інженера, або писав план виправлення. Цей план передавався субагенту кодування, щоб реалізувати виправлення та подати pull request.
Головна проблема цієї архітектури полягала у втраті контексту між субагентами. Кожен агент передавав вгору або вниз лише частини свого контексту через узагальнення, і як агенти вище, так і нижче за потоком регулярно мусили переробляти ту саму роботу.
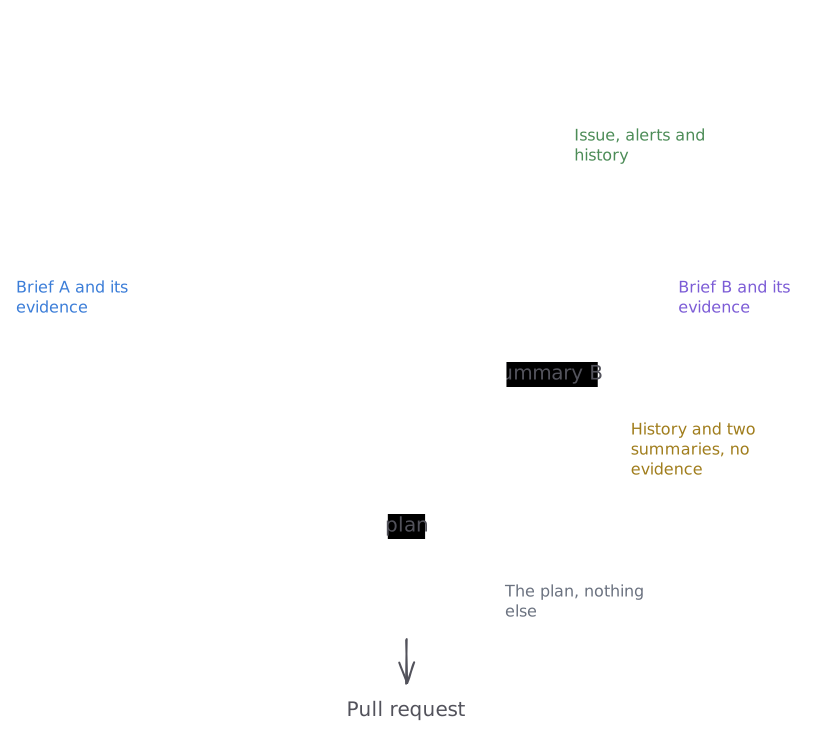
Крім того, агент, що писав виправлення, мав лише план, без контексту про початкову проблему чи докази, зібрані під час розслідування. Це призводило до посередніх pull request, які часто фокусувалися на симптомах, а не на першопричині.
Ми обрали цю архітектуру насамперед тому, що коли ми вперше проєктували її в березні 2026 року, провідні моделі не завжди були здатні провести розслідування наскрізь, включно з написанням виправлення, а також, чесно кажучи, наш харнес тоді був не таким уже й хорошим.
Ставало дедалі важче будувати на цьому фундаменті, тому що:
- Дебаг вимагав багатьох трейсів. Осмислення наскрізного розслідування вимагало перегляду кількох, іноді десятків трейсів.
- Оцінка була посегментною. Кожен субагент можна було оцінити окремо, і він проходив перевірку, тоді як кінцевий результат був поганим, бо збої жили саме в передачах.
Ми ітерували цю архітектуру місяцями, покращуючи кожного агента окремо і допрацьовуючи промпти та передачі, але результати ніколи не відповідали затраченим зусиллям. Це було дорого, важко дебажити, а pull request виходили недостатньо якісними.
Один агент
3 вересня ми замінили workflow з субагентами одним агентом, який робить усе: від тріажу до pull request. Той самий агент збирає докази, досліджує всі гіпотези і подає pull request.
Ми видалили агента тріажу, координатора, агентів гіпотез та autofix agent разом з workflow, що переносили результати між ними, і бар’єрами, які стояли перед pull request. Операційні переваги виявилися одразу: один трейс для оцінки і жодних узагальнень між субагентами.
Що важливіше, якість pull request покращилася, а час між виявленням проблеми та відкриттям pull request, що її виправляє, різко скоротився. За місяць навколо переходу медіана впала з 2,2 години до 35 хвилин, а p90 з дев’яти днів до менш ніж двох годин. За конвеєрної схеми знахідка зазвичай простоювала кілька годин у ланцюжку workflow, кожен з яких чекав на попередній. При одному агенті pull request відкривається лише через кілька хвилин після виявлення проблеми.
Тепер ми також відкриваємо значно більше pull request. Коли ми використовували субагентів, лише 0,6% виявлених проблем закінчувалися pull request. При одному агенті це 4,2%, і показник зростає. Різниця в режимах відмов. Конвеєр з кількома субагентами має пережити кожну передачу: тріаж має підтвердити знахідку, координатор має сформувати гіпотези, розгалуження має дійти до висновку тощо. Кожна передача є потенційним режимом відмови.
Вартість на один pull request також знизилася. Тепер кожен запуск стартує на потужнішій моделі, тож відхилена знахідка коштує більше, ніж за конвеєрної схеми. Однак середня вартість на один pull request впала зі $111 до приблизно $18 за перші дев’ять днів роботи одного агента. Це падіння не є винятково результатом зміни архітектури, оскільки ми активно ітеруємо над кожним аспектом Polylane. Частина цього це звичайний дрейф системи під постійною ітерацією.
Усі значення за трьома графіками, за днями UTC
| День | Виявлені проблеми з pull request | Медіана | p90 | Витрати на pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · один агент | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · до 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Не будуйте субагентів
- Передачі втрачають більше, ніж заощаджують. Кожне узагальнення, передане між агентами, це контекст, якого наступний агент вже ніколи не матиме. Агент, що збирає докази, має бути тим самим агентом, що діє на їх основі.
- Оцінюйте запуск, а не агентів. Пооб’єктні оцінки проходять, поки система в цілому дає збій, бо збої живуть саме між агентами.
- Зберігайте один трейс на запуск. Хибне рішення, розкидане по десятку трейсів, вимагає пояснення на цілий вечір. В одному трейсі досить прокрутки.