

Sub-agents are just wrong
Explore with AI
Polylane의 autofix 에이전트는 원래 각각 하나의 작업을 담당하는 여러 서브 에이전트로 이루어진 워크플로우로 만들어졌습니다.
- 수천 건의 경보와 시그널을 걸러내는 트리아지
- 서브 에이전트를 운영하는 코디네이터
- 이슈에 대한 가능한 모든 가설을 조사하는 최대 15개의 서브 에이전트
- 최종적으로 풀 리퀘스트를 제출하는 코딩 에이전트
확인된 이슈 하나에 조사와 수정을 위해 최대 18개의 에이전트와 서브 에이전트가 동원되기도 했습니다. 지금은 같은 작업을 단 하나의 에이전트가 처리합니다.
이 워크플로우는 당시 저희가 알고 있던 지식을 바탕으로 한 합리적인 설계였습니다. 작은 프롬프트, 작은 도구 세트, 그리고 각 전문 에이전트 사이에 결과를 전달하는 오케스트레이터. 하지만 운영하고 이해하기에 비용이 매우 많이 들고 어려웠습니다.
이슈란 무엇인가
Polylane은 연결된 모든 제공자의 모든 클라우드 리소스(Lambda function, Cloudflare Worker, Vercel project 등)에서 로그, 메트릭, 트레이스를 스캔합니다. 각 리소스에 대해 데이터의 계절성을 포착할 수 있도록 여러 시간대에 걸친 기준선을 저장합니다. 그런 다음 클라우드 리소스의 현재 상태를 평가하고 과거 데이터와 비교합니다. 기준선을 벗어나는 값은 이슈로 기록됩니다.
이슈는 관측성 및 오류 추적 솔루션에서 받은 경보로도 생성될 수 있습니다.
이슈는 어떻게 해결하는가
이슈를 해결하려면 다음이 필요합니다.
- 트리아지: 이슈를 확인하거나 기각하기 위한 데이터를 수집합니다.
- 조사: 여러 가설을 평가하고 근본 원인을 판단합니다.
- 풀 리퀘스트를 열거나 에스컬레이션합니다. 이슈를 해결하는 풀 리퀘스트를 작성하거나, 코드 변경이 아닌 수정이 필요하면 엔지니어에게 에스컬레이션하거나, 발견 사항을 정리한 리포트를 작성하고 종료합니다.
대부분의 실행은 Polylane이 이슈를 오탐이거나 문제없음으로 판단할 때, 풀 리퀘스트나 에스컬레이션 이전에 종료됩니다.
서브 에이전트 아키텍처
초기 아키텍처는 여러 서브 에이전트를 기반으로 했습니다.
저희는 오케스트레이터 에이전트를 사용해 여러 서브 에이전트 간의 작업을 조율했습니다. 서브 에이전트는 가설을 조사하도록 생성되었고, 서로 다른 출발점(예를 들어 로그부터 보거나, 코드베이스부터 보는 등)에서 각 가설을 입증하거나 반증하려 시도했습니다.
서브 에이전트의 발견 사항은 단순한 산술 투표로 집계되고, 코디네이터 에이전트에 취합되기 전에 다른 에이전트가 요약했습니다.
각 가설의 판정은 여러 패스에 걸친 신뢰도 가중 투표였습니다.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
모든 가설이 조사된 후, 근본 원인이 확인되면 코디네이터는 엔지니어에게 에스컬레이션하거나 수정 계획을 작성했습니다. 이 계획은 수정을 구현하고 풀 리퀘스트를 제출하는 코딩 서브 에이전트로 전달되었습니다.
이 아키텍처의 주된 문제는 서브 에이전트 간의 컨텍스트 손실이었습니다. 각 에이전트는 요약을 거쳐 컨텍스트의 일부만 위아래로 전달했고, 상류와 하류의 에이전트 모두 같은 작업을 다시 해야 하는 경우가 잦았습니다.
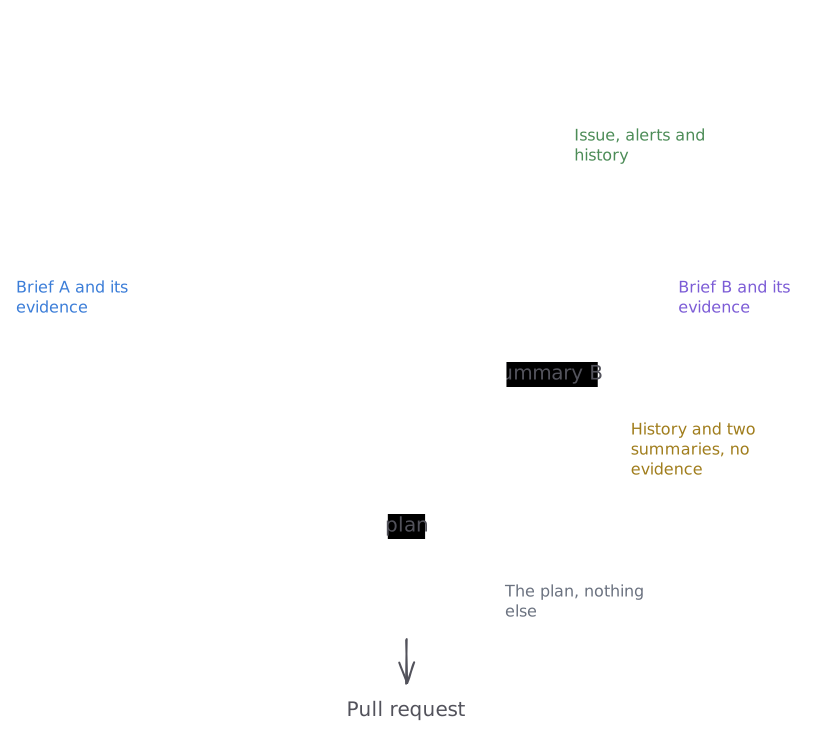
게다가 수정을 작성하는 에이전트는 계획만 가지고 있었고, 원래 이슈나 조사 과정에서 수집된 증거에 대한 컨텍스트가 없었습니다. 이는 근본 원인보다 증상에 초점을 맞춘 부실한 풀 리퀘스트로 이어졌습니다.
저희가 이 아키텍처를 선택한 주된 이유는 2026년 3월 처음 설계할 당시, 최전선 모델들이 수정 작성을 포함한 조사를 처음부터 끝까지 자체적으로 수행할 수 있는 경우가 항상은 아니었고, 솔직히 말해 저희의 하네스도 그렇게 좋지 않았기 때문입니다.
이 기반 위에서 개발을 이어가기가 점점 더 어려워진 이유는 다음과 같습니다.
- 디버깅에 여러 트레이스가 필요했습니다. 하나의 조사를 처음부터 끝까지 추론하려면 때로는 수십 개에 이르는 여러 트레이스를 살펴봐야 했습니다.
- 평가가 단계별로 이루어졌습니다. 각 서브 에이전트는 개별적으로 평가하면 통과했지만, 실패가 인수인계 지점에서 발생했기 때문에 최종 결과는 좋지 않았습니다.
저희는 이 아키텍처를 몇 달에 걸쳐 개선하며 각 에이전트를 개별적으로 다듬고 프롬프트와 인수인계를 조정했지만, 결과는 들인 노력에 미치지 못했습니다. 비용이 많이 들고 디버깅이 어려웠으며, 풀 리퀘스트의 품질도 충분하지 않았습니다.
단일 에이전트
9월 3일, 저희는 서브 에이전트 워크플로우를 트리아지부터 풀 리퀘스트까지 모든 것을 처리하는 단일 에이전트로 교체했습니다. 같은 에이전트가 증거를 수집하고, 모든 가설을 조사하고, 풀 리퀘스트를 제출합니다.
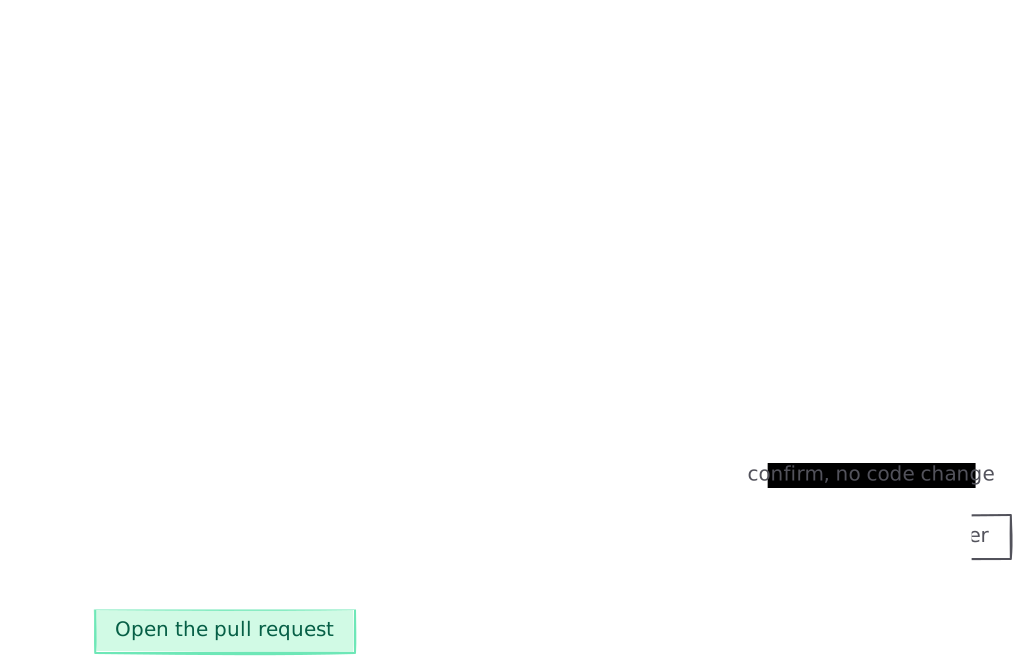
저희는 트리아지 에이전트, 코디네이터, 가설 에이전트, autofix 에이전트를 삭제했고, 이들 사이에 결과를 전달하던 워크플로우와 풀 리퀘스트 앞단에 있던 게이트도 함께 없앴습니다. 운영상의 이점은 즉각적이었습니다. 평가할 트레이스가 하나뿐이고, 서브 에이전트 사이의 요약도 사라졌습니다.
더 중요한 것은 풀 리퀘스트의 품질이 개선되었고, 이슈를 감지한 시점부터 이를 수정하는 풀 리퀘스트를 여는 시점까지의 시간이 크게 줄었다는 점입니다. 전환 시점 전후 한 달간, 중앙값은 2.2시간에서 35분으로, p90은 9일에서 2시간 이내로 떨어졌습니다. 파이프라인 방식에서는 하나의 발견 사항이 여러 워크플로우의 연쇄 속에서 각각 이전 단계를 기다리며 몇 시간씩 머무는 경우가 일반적이었습니다. 단일 에이전트 방식에서는 이슈가 감지된 지 불과 몇 분 만에 풀 리퀘스트가 열립니다.
지금은 훨씬 더 많은 풀 리퀘스트를 열고 있습니다. 서브 에이전트를 사용할 때는 감지된 이슈의 0.6%가 풀 리퀘스트로 이어졌습니다. 단일 에이전트에서는 4.2%이며, 계속 늘고 있습니다. 차이는 실패 방식에 있습니다. 여러 서브 에이전트로 이루어진 파이프라인은 모든 인수인계 지점에서 살아남아야 합니다. 트리아지는 발견 사항을 승격시켜야 하고, 코디네이터는 가설을 만들어야 하고, 팬아웃은 판정에 도달해야 하는 식입니다. 각 인수인계 지점은 잠재적인 실패 지점입니다.
풀 리퀘스트당 비용도 줄었습니다. 이제 모든 실행이 더 강력한 모델로 시작되기 때문에, 기각되는 발견 사항 하나에 드는 비용은 파이프라인 방식 때보다 오히려 커졌습니다. 하지만 풀 리퀘스트당 평균 비용은 단일 에이전트 도입 첫 9일 동안 $111에서 약 $18로 떨어졌습니다. 이 하락이 전적으로 아키텍처 변경의 결과는 아닙니다. 저희는 Polylane의 모든 측면을 계속해서 개선하고 있고, 그중 일부는 지속적으로 반복 개선 중인 시스템의 통상적인 변동에 지나지 않습니다.
세 차트의 기반이 된 모든 값, UTC 날짜 기준
| 날짜 | 풀 리퀘스트로 이어진 감지 이슈 | 중앙값 | p90 | 풀 리퀘스트당 비용 |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · 단일 에이전트 | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · 16:00까지 | 8.2% | 30 min | 55 min | $2.88 |
서브 에이전트를 만들지 마세요
- 인수인계는 얻는 것보다 잃는 것이 많습니다. 에이전트 사이에 전달되는 요약 하나하나가 다음 에이전트에게는 영영 주어지지 않을 컨텍스트입니다. 증거를 수집하는 에이전트가 곧 그 증거로 행동하는 에이전트여야 합니다.
- 에이전트가 아니라 실행 전체를 평가하세요. 에이전트별 평가는 통과하는데 시스템은 실패하는 경우가 있습니다. 실패가 에이전트 사이의 공간에 있기 때문입니다.
- 실행당 트레이스는 하나로 유지하세요. 열두 개의 트레이스에 흩어진 잘못된 결정을 설명하려면 오후 시간이 통째로 듭니다. 트레이스가 하나라면 스크롤 한 번이면 됩니다.