

Les sous-agents, c'est une erreur
Explore with AI
L’agent autofix de Polylane a été conçu à l’origine comme un workflow de plusieurs sous-agents, chacun responsable d’une seule tâche :
- un triage pour trier des milliers d’alertes et de signaux
- un coordinateur pour piloter les sous-agents
- jusqu’à quinze sous-agents pour enquêter sur toutes les hypothèses possibles de l’issue
- et un agent de codage pour finalement soumettre une pull request
Une issue confirmée pouvait mobiliser jusqu’à 18 agents et sous-agents pour l’enquête et le correctif. Aujourd’hui, le même travail est effectué par un seul agent.
Ce workflow était une conception saine compte tenu de ce que nous savions à l’époque : des prompts courts, des jeux d’outils restreints, un orchestrateur pour faire circuler les résultats entre spécialistes. Il était cependant extrêmement coûteux, difficile à opérer et à raisonner.
Qu’est-ce qu’une issue\u00A0?
Polylane analyse les logs, métriques et traces de chaque ressource cloud (fonction Lambda, Cloudflare Worker, projet Vercel, etc.) sur chaque fournisseur connecté. Pour chaque ressource, nous stockons des baselines sur plusieurs horizons, afin de capturer la saisonnalité des données. Nous évaluons ensuite l’état actuel de la ressource cloud et le comparons aux données historiques. Les valeurs qui sortent de la baseline sont enregistrées comme des issues.
Des issues peuvent également être créées par des alertes reçues de solutions d’observabilité et de suivi d’erreurs.
Comment résolvons-nous les issues\u00A0?
Pour résoudre une issue, nous devons\u00A0:
- Triage\u00A0: rassembler les données pour confirmer ou rejeter l’issue.
- Enquêter\u00A0: évaluer plusieurs hypothèses et déterminer la cause racine.
- Ouvrir une pull request ou escalader. Soit rédiger une pull request pour résoudre l’issue, soit escalader vers un ingénieur si le correctif n’est pas un changement de code, soit rédiger un rapport mettant en avant les constats et s’arrêter.
La grande majorité des runs se terminent avant une pull request ou une escalade, lorsque Polylane conclut que l’issue est soit un faux positif, soit bénigne.
Architecture à sous-agents
Notre architecture initiale reposait sur plusieurs sous-agents.
Nous utilisions un agent orchestrateur pour coordonner le travail entre plusieurs sous-agents. Des sous-agents étaient instanciés pour enquêter sur les hypothèses, en essayant de prouver ou d’infirmer chaque hypothèse à partir de points de départ différents (par exemple en commençant par les logs, ou en commençant par la base de code, etc.).
Les constats des sous-agents faisaient l’objet d’un vote arithmétique simple et étaient résumés par un autre agent avant d’être remontés à l’agent coordinateur.
Le verdict de chaque hypothèse résultait d’un vote pondéré par la confiance sur l’ensemble de ses passes.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Une fois toutes les hypothèses examinées, si une cause racine était identifiée, le coordinateur escaladait vers un ingénieur ou rédigeait un plan de correctif. Ce plan était ensuite transmis à un sous-agent de codage chargé de mettre en œuvre le correctif et de soumettre la pull request.
Le principal problème de cette architecture est la perte de contexte entre les sous-agents. Chaque agent ne faisait remonter ou descendre que des fractions de son contexte, par le biais de résumés, et les agents en amont comme en aval devaient régulièrement refaire le même travail.
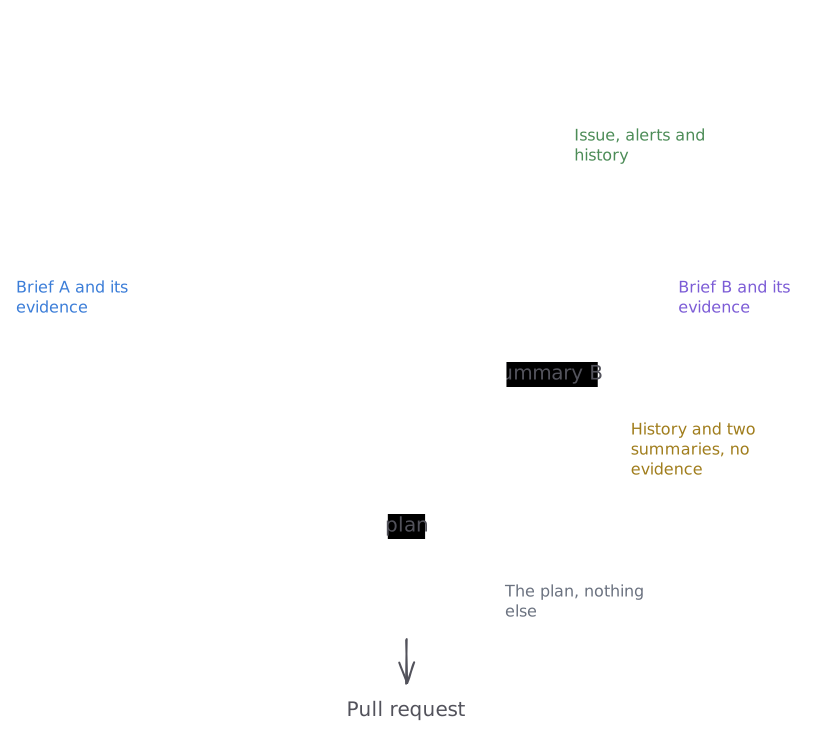
De plus, l’agent qui rédigeait le correctif ne disposait que du plan, sans contexte sur l’issue d’origine ni sur les preuves collectées durant l’enquête. Cela conduisait à des pull requests médiocres, souvent centrées sur les symptômes plutôt que sur la cause racine.
Nous avons choisi cette architecture principalement parce que, lorsque nous l’avons conçue pour la première fois en mars 2026, les modèles de pointe n’étaient pas toujours capables de mener une enquête de bout en bout, y compris la rédaction du correctif, et aussi, tout simplement, parce que notre harness n’était pas si bon.
Il devenait de plus en plus difficile de construire sur cette base, parce que\u00A0:
- Le débogage nécessitait de nombreuses traces. Raisonner sur une enquête de bout en bout demandait de parcourir plusieurs traces, parfois des dizaines
- L’évaluation se faisait par étape. Chaque sous-agent pouvait être évalué individuellement et validé, alors que le résultat final était médiocre, parce que les échecs se situaient dans les passations.
Nous avons itéré sur cette architecture pendant des mois, en améliorant chaque agent individuellement et en ajustant les prompts et les passations, mais les résultats n’ont jamais été à la hauteur de l’effort. C’était coûteux, difficile à déboguer, et les pull requests n’étaient pas assez bonnes.
Agent unique
Le 3 septembre, nous avons remplacé le workflow à sous-agents par un agent unique qui fait tout, du triage à la pull request. Le même agent collecte les preuves, enquête sur toutes les hypothèses et soumet la pull request.
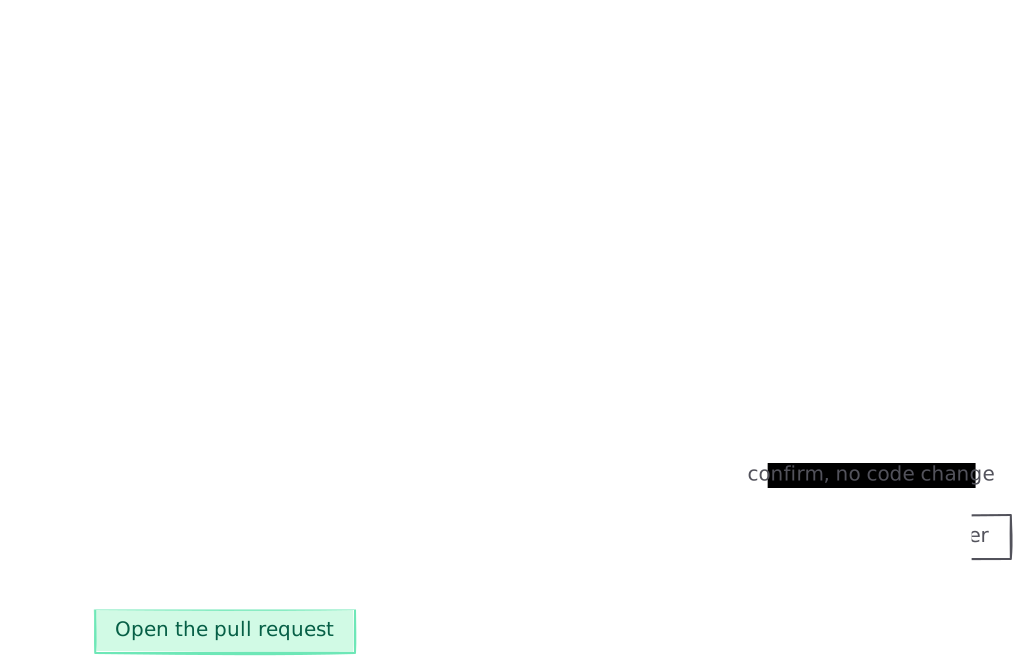
Nous avons supprimé l’agent de triage, le coordinateur, les agents d’hypothèses et l’agent autofix, ainsi que les workflows qui faisaient circuler les résultats entre eux et les gates placées avant la pull request. Les bénéfices opérationnels ont été immédiats\u00A0: une seule trace à évaluer, et aucun résumé entre les sous-agents.
Plus important encore, la qualité des pull requests s’est améliorée, et le temps entre la détection d’une issue et l’ouverture de la pull request qui la corrige s’est effondré. Sur le mois autour du basculement, la médiane est passée de 2.2 heures à 35 minutes, et le p90 de neuf jours à moins de deux heures. Sous l’ancien pipeline, un constat restait typiquement plusieurs heures dans une chaîne de workflows, chacun attendant le précédent. Avec l’agent unique, la pull request s’ouvre quelques minutes seulement après la détection de l’issue.
Nous ouvrons aussi désormais beaucoup plus de pull requests. Lorsque nous utilisions des sous-agents, 0.6\u00A0% des issues détectées aboutissaient à une pull request. Avec l’agent unique, c’est 4.2\u00A0%, et ça continue d’augmenter. La différence tient aux modes de défaillance. Un pipeline à plusieurs sous-agents doit survivre à chaque passation\u00A0: le triage doit faire remonter le constat, le coordinateur doit produire des hypothèses, le fan-out doit aboutir à un verdict, etc. Chaque passation est un mode de défaillance potentiel.
Le coût par pull request a également baissé. Chaque run démarre désormais sur le modèle le plus puissant, si bien qu’un constat rejeté coûte plus cher qu’avec l’ancien pipeline. Mais le coût moyen par pull request est passé de $111 à environ $18 au cours des neuf premiers jours de l’agent unique. Cette baisse n’est pas exclusivement le résultat du changement d’architecture, dans la mesure où nous itérons activement sur tous les aspects de Polylane. Une partie relève de la dérive ordinaire d’un système en itération constante.
Toutes les valeurs derrière les trois graphiques, par jour UTC
| Jour | Issues détectées avec une pull request | Médiane | p90 | Dépense par pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · agent unique | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · jusqu'à 16 h 00 | 8.2% | 30 min | 55 min | $2.88 |
Ne construis pas de sous-agents
- Les passations perdent plus qu’elles ne font gagner. Chaque résumé transmis entre agents est du contexte que l’agent suivant n’aura jamais. L’agent qui rassemble les preuves devrait être celui qui agit dessus.
- Évalue le run, pas les agents. Les évaluations par agent sont validées alors que le système échoue, parce que les échecs se situent entre les agents.
- Garde une seule trace par run. Une mauvaise décision répartie sur une dizaine de traces prend un après-midi à expliquer. Dans une seule trace, il suffit de faire défiler.