

Sub-agents are just wrong
Explore with AI
Агент autofix в Polylane изначально строился как workflow из нескольких субагентов, каждый из которых отвечал за одну задачу:
- триаж, который разбирает тысячи алертов и сигналов
- координатор, управляющий субагентами
- до пятнадцати субагентов, исследующих все возможные гипотезы по проблеме
- и кодинг-агент, который в итоге отправляет pull request
Подтверждённая проблема могла задействовать до 18 агентов и субагентов для расследования и исправления. Сегодня ту же работу выполняет один агент.
Такой workflow был разумным решением, исходя из того, что мы знали на тот момент: небольшие промпты, небольшие наборы инструментов, оркестратор, переносящий результаты между специализированными агентами. Однако он был крайне дорогим, сложным в эксплуатации и трудным для анализа.
Что такое проблема (issue)?
Polylane сканирует логи, метрики и трейсы каждого облачного ресурса (Lambda-функция, Cloudflare Worker, проект Vercel и т. д.) у каждого подключённого провайдера. Для каждого ресурса мы храним базовые уровни на нескольких горизонтах, чтобы учитывать сезонность в данных. Затем мы оцениваем текущее состояние облачного ресурса и сравниваем его с историческими данными. Значения, выходящие за пределы базового уровня, фиксируются как проблемы.
Проблемы также могут создаваться алертами, которые мы получаем от решений для наблюдаемости и отслеживания ошибок.
Как мы решаем проблемы?
Чтобы решить проблему, нужно:
- Провести триаж: собрать данные, чтобы подтвердить или отклонить проблему.
- Расследовать: оценить несколько гипотез и определить первопричину.
- Открыть pull request или эскалировать. Либо написать pull request для решения проблемы, либо эскалировать инженеру, если исправление не сводится к изменению кода, либо составить отчёт с выводами и остановиться.
Подавляющее большинство прогонов завершается до pull request или эскалации, когда Polylane приходит к выводу, что проблема либо ложноположительная, либо безобидная.
Архитектура с субагентами
Изначальная архитектура строилась на нескольких субагентах.
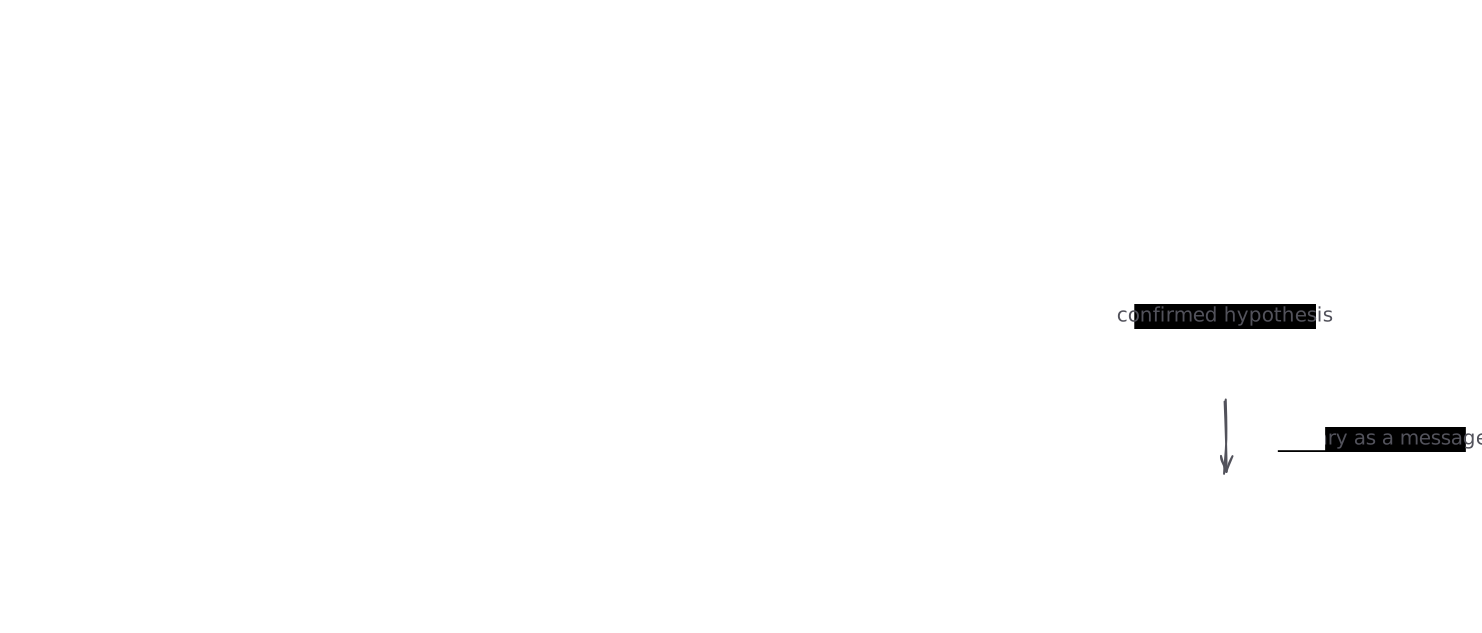
Мы использовали агента-оркестратора, чтобы координировать работу между несколькими субагентами. Субагенты создавались для проверки гипотез, пытаясь подтвердить или опровергнуть каждую гипотезу с разных стартовых точек (например, начиная с изучения логов, или начиная с кодовой базы и т. д.).
Находки субагентов взвешивались простой арифметикой и обобщались другим агентом, прежде чем передаваться агенту-координатору.
Вердикт по каждой гипотезе представлял собой голосование, взвешенное по уверенности, по всем проходам.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Как только все гипотезы были исследованы, если первопричина была установлена, координатор либо эскалировал инженеру, либо составлял план исправления. Этот план передавался кодинг-субагенту, чтобы реализовать исправление и отправить pull request.
Главная проблема этой архитектуры — потеря контекста между субагентами. Каждый агент передавал вверх или вниз лишь фрагменты своего контекста через суммаризацию, и агентам как выше, так и ниже по цепочке регулярно приходилось переделывать одну и ту же работу.
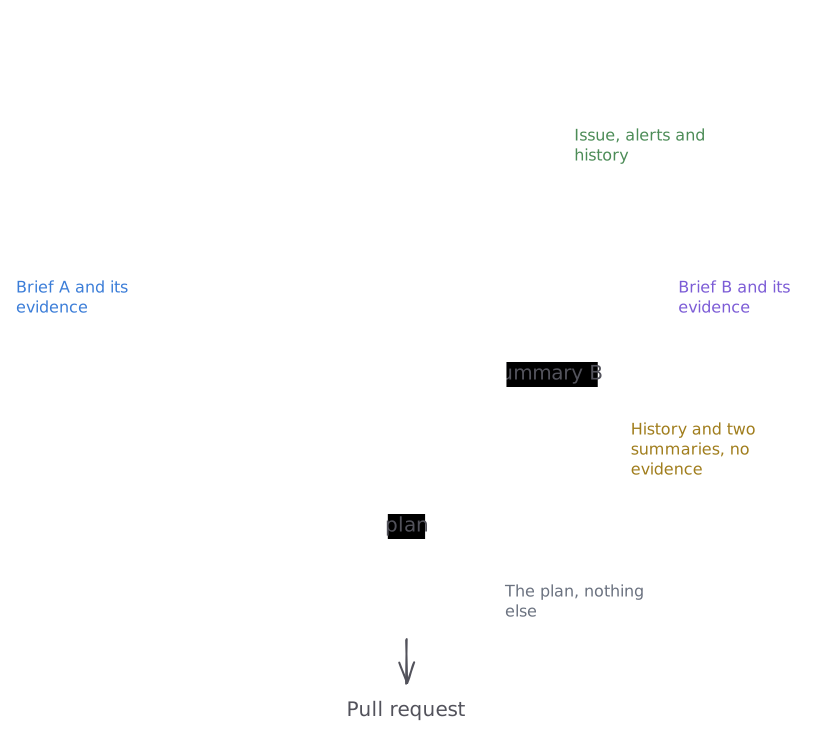
Более того, агент, писавший исправление, располагал только планом, без контекста об исходной проблеме или доказательствах, собранных в ходе расследования. Это приводило к посредственным pull request’ам, которые часто были сосредоточены на симптомах, а не на первопричине.
Мы выбрали эту архитектуру в первую очередь потому, что когда мы впервые проектировали её в марте 2026 года, флагманские модели не всегда были способны провести расследование от начала до конца, включая написание исправления, да и, откровенно говоря, наша обвязка (harness) была не так хороша.
Строить на этом фундаменте становилось всё сложнее по следующим причинам:
- Отладка требовала множества трейсов. Чтобы рассуждать о расследовании от начала до конца, нужно было просматривать несколько, порой десятки трейсов.
- Оценка была пооэтапной. Каждый субагент можно было оценить отдельно и получить успешный результат, при этом итог оставался слабым, потому что сбои происходили именно на передачах между агентами.
Мы месяцами дорабатывали эту архитектуру, улучшая каждого агента по отдельности и настраивая промпты и передачи, но результаты никогда не соответствовали затраченным усилиям. Это было дорого, сложно отлаживать, а pull request’ы получались недостаточно хорошими.
Единый агент
3 сентября мы заменили workflow с субагентами на единого агента, который делает всё: от триажа до pull request. Один и тот же агент собирает доказательства, исследует все гипотезы и отправляет pull request.
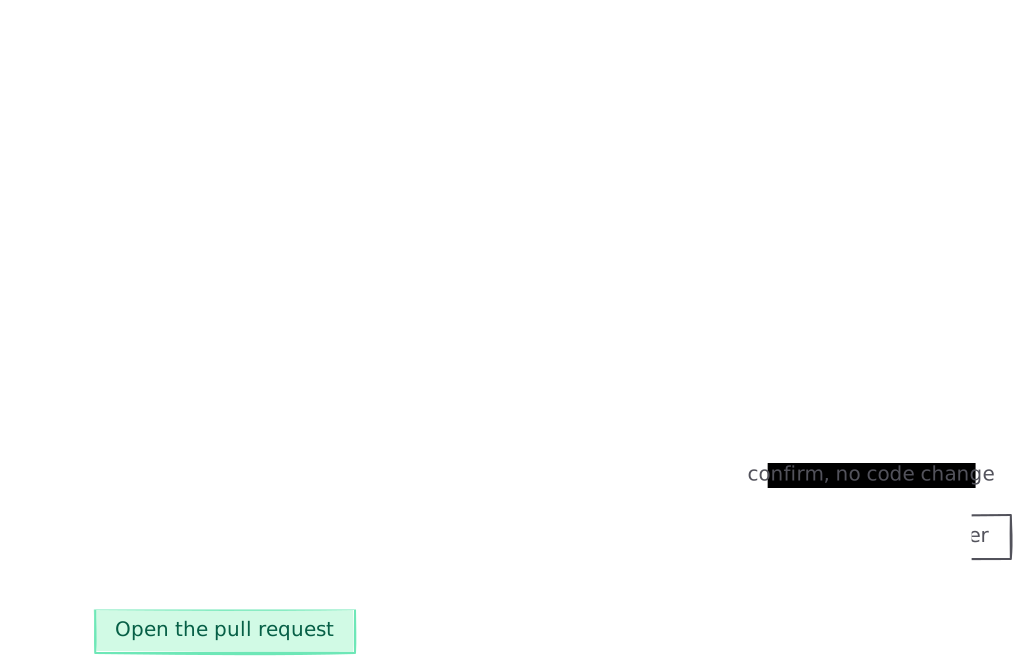
Мы удалили агента триажа, координатора, агентов-гипотез и агента autofix, вместе с workflow, переносившими результаты между ними, и гейтами, стоявшими перед pull request. Эксплуатационные преимущества проявились сразу: один трейс для оценки и никаких сводок между субагентами.
Что важнее, качество pull request’ов выросло, а время между обнаружением проблемы и открытием исправляющего её pull request резко сократилось. За месяц вокруг перехода медиана снизилась с 2,2 часа до 35 минут, а p90 — с девяти дней до менее чем двух часов. При конвейерной архитектуре находка обычно «зависала» на многие часы в цепочке workflow, где каждый ждал предыдущего. При едином агенте pull request открывается спустя всего несколько минут после обнаружения проблемы.
Теперь мы также открываем гораздо больше pull request’ов. Когда мы использовали субагентов, 0,6% обнаруженных проблем заканчивались pull request’ом. При едином агенте это 4,2%, и доля растёт. Разница в режимах отказа. Конвейер с несколькими субагентами должен пережить каждую передачу: триаж должен продвинуть находку, координатор должен сформировать гипотезы, fan-out должен прийти к вердикту и т. д. Каждая передача — потенциальная точка отказа.
Стоимость на один pull request также снизилась. Теперь каждый прогон начинается на более мощной модели, поэтому отклонённая находка обходится дороже, чем при конвейере. Тем не менее средняя стоимость на pull request упала со $111 до примерно $18 за первые девять дней работы единого агента. Это снижение не связано исключительно с изменением архитектуры, поскольку мы активно дорабатываем каждый аспект Polylane. Часть этого — обычный дрейф системы, находящейся в постоянной итерации.
Все значения за тремя графиками, по дням UTC
| День | Обнаруженные проблемы с pull request | Медиана | p90 | Затраты на pull request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · единый агент | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · до 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Не стройте субагентов
- На передачах теряется больше, чем выигрывается. Каждая сводка, передаваемая между агентами, это контекст, которого никогда не будет у следующего агента. Агент, собирающий доказательства, должен быть тем же агентом, который действует на их основе.
- Оценивайте прогон, а не агентов. Оценки по отдельным агентам проходят успешно, пока система в целом даёт сбой, потому что сбои происходят именно между агентами.
- Держите один трейс на прогон. Неверное решение, размазанное по десятку трейсов, объяснить можно за полдня. В одном трейсе для этого хватит прокрутки.