

Sub-Agents sind einfach falsch
Explore with AI
Polylanes Autofix-Agent war ursprünglich als Workflow aus mehreren Sub-Agents aufgebaut, jeder zuständig für eine einzelne Aufgabe:
- eine Triage, um Tausende von Alerts und Signalen zu sichten
- ein Coordinator, der die Sub-Agents steuert
- bis zu fünfzehn Sub-Agents, um alle möglichen Hypothesen zum Problem zu untersuchen
- und ein Coding-Agent, der schließlich einen Pull Request einreicht
Ein bestätigtes Issue konnte bis zu 18 Agents und Sub-Agents für die Untersuchung und den Fix nach sich ziehen. Heute erledigt dieselbe Arbeit ein einziger Agent.
Der Workflow war ein sinnvolles Design auf Basis dessen, was wir zu der Zeit wussten: kleine Prompts, kleine Tool-Sets, ein Orchestrator, der Ergebnisse zwischen Spezialisten trägt. Er war jedoch extrem teuer und schwer zu betreiben und nachzuvollziehen.
Was ist ein Issue?
Polylane scannt Logs, Metriken und Traces von jeder Cloud-Ressource (Lambda-Funktion, Cloudflare Worker, Vercel-Projekt usw.) bei jedem verbundenen Provider. Für jede Ressource speichern wir Baselines über mehrere Zeithorizonte, sodass wir Saisonalität in den Daten erfassen können. Anschließend bewerten wir den aktuellen Zustand der Cloud-Ressource und vergleichen ihn mit historischen Daten. Werte, die die Baseline durchbrechen, werden als Issues erfasst.
Issues können auch durch Alerts entstehen, die wir von Observability- und Error-Tracking-Lösungen erhalten.
Wie lösen wir Issues?
Um ein Issue zu lösen, müssen wir:
- Triage: Daten sammeln, um das Issue zu bestätigen oder zu verwerfen.
- Untersuchen: Mehrere Hypothesen bewerten und den Root Cause bestimmen.
- Einen Pull Request öffnen oder eskalieren. Entweder einen Pull Request schreiben, der das Issue löst, an einen Engineer eskalieren, wenn der Fix keine Codeänderung ist, oder einen Bericht mit den Erkenntnissen schreiben und stoppen.
Die überwiegende Mehrheit der Runs endet vor einem Pull Request oder einer Eskalation, wenn Polylane zu dem Schluss kommt, dass das Issue entweder ein False Positive oder harmlos ist.
Sub-Agents-Architektur
Unsere ursprüngliche Architektur basierte auf mehreren Sub-Agents.
Wir nutzten einen Orchestrator-Agent, um die Arbeit zwischen mehreren Sub-Agents zu koordinieren. Sub-Agents wurden instanziiert, um Hypothesen zu untersuchen und sie mit unterschiedlichen Ausgangspunkten zu beweisen oder zu widerlegen (zum Beispiel beginnend mit den Logs oder beginnend mit der Codebase usw.).
Die Erkenntnisse der Sub-Agents wurden mit einfacher Arithmetik abgestimmt und von einem weiteren Agent zusammengefasst, bevor sie an den Coordinator-Agent weitergereicht wurden.
Das Urteil jeder Hypothese war eine konfidenzgewichtete Abstimmung über ihre Durchläufe.
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
Sobald alle Hypothesen untersucht waren, hat der Coordinator, falls ein Root Cause identifiziert wurde, entweder an einen Engineer eskaliert oder einen Plan für den Fix geschrieben. Dieser Plan wurde an einen Coding-Sub-Agent übergeben, um den Fix umzusetzen und den Pull Request einzureichen.
Das Hauptproblem dieser Architektur ist der Kontextverlust zwischen den Sub-Agents. Jeder Agent gab nur Bruchteile seines Kontexts nach oben oder unten weiter, durch Zusammenfassung, und sowohl vor- als auch nachgelagerte Agents mussten regelmäßig dieselbe Arbeit wiederholen.
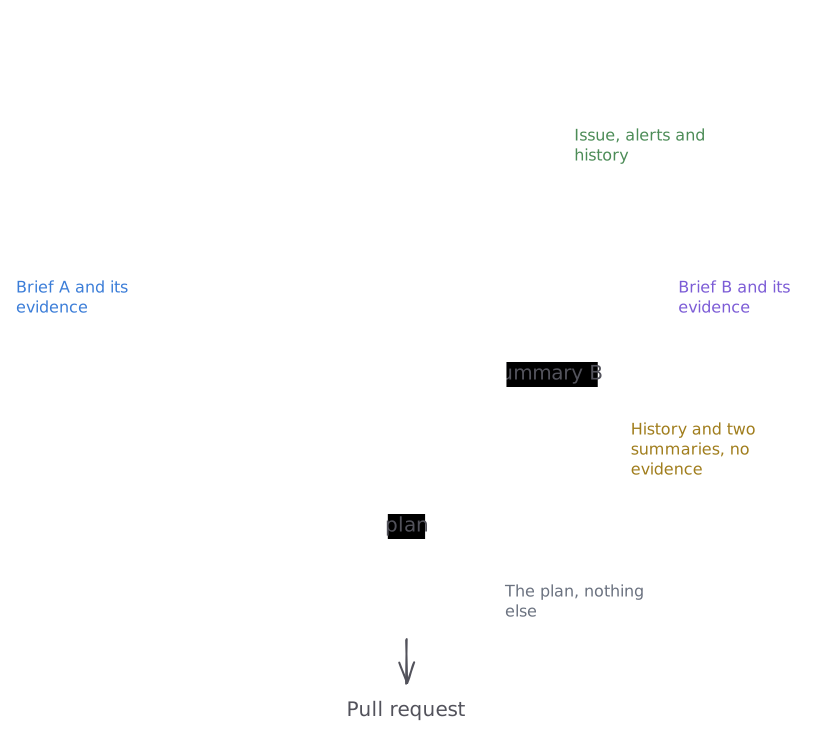
Zudem hatte der Agent, der den Fix schrieb, nur den Plan zur Verfügung, ohne Kontext zum ursprünglichen Issue oder den in der Untersuchung gesammelten Beweisen. Das führte zu mittelmäßigen Pull Requests, die sich häufig auf Symptome statt auf den Root Cause konzentrierten.
Wir haben uns für diese Architektur vor allem deshalb entschieden, weil die führenden Modelle, als wir sie im März 2026 entworfen haben, nicht immer in der Lage waren, eine Untersuchung von Anfang bis Ende durchzuführen, einschließlich des Schreibens des Fixes, und ganz einfach gesagt, unser Harness war auch noch nicht so gut.
Es wurde zunehmend schwerer, auf dieser Grundlage weiterzubauen, weil:
- Debugging viele Traces erforderte. Um eine End-to-End-Untersuchung nachzuvollziehen, mussten mehrere, teils Dutzende von Traces durchgesehen werden.
- Evaluation pro Stufe erfolgte. Jeder Sub-Agent konnte einzeln evaluiert werden und bestehen, während das Endergebnis schlecht war, weil die Fehler in den Übergaben lagen.
Wir haben diese Architektur monatelang iteriert, jeden Agent einzeln verbessert und an Prompts und Übergaben gefeilt, aber die Ergebnisse haben den Aufwand nie gerechtfertigt. Es war teuer, schwer zu debuggen, und die Pull Requests waren nicht gut genug.
Ein einzelner Agent
Am 3. September haben wir den Sub-Agents-Workflow durch einen einzigen Agent ersetzt, der alles von der Triage bis zum Pull Request übernimmt. Derselbe Agent sammelt die Beweise, untersucht alle Hypothesen und reicht den Pull Request ein.
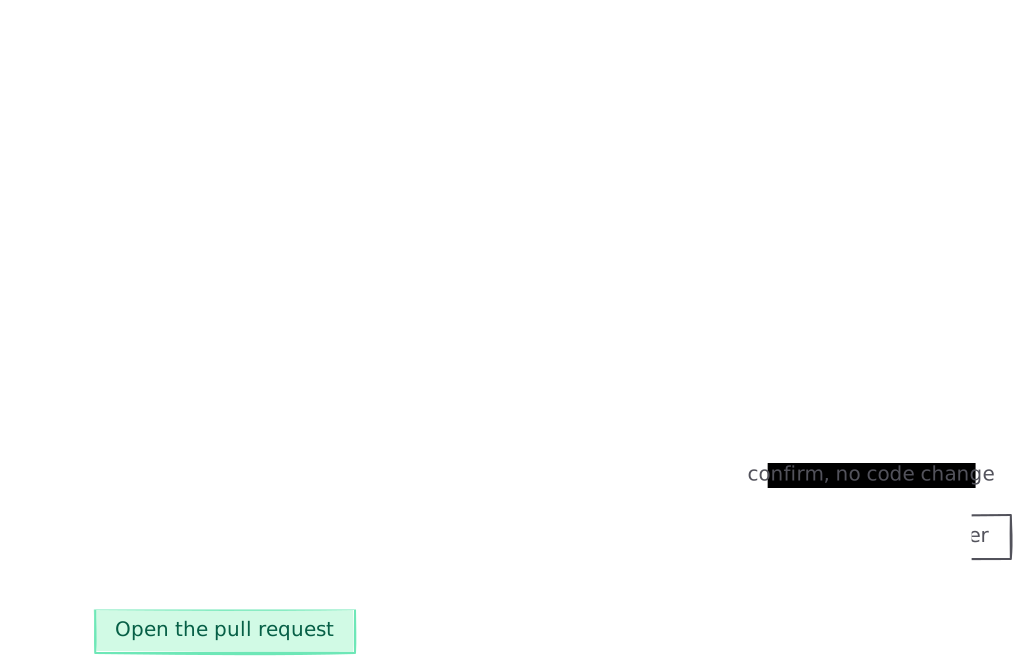
Wir haben den Triage-Agent, den Coordinator, die Hypothesen-Agents und den Autofix-Agent gelöscht, zusammen mit den Workflows, die Ergebnisse zwischen ihnen transportierten, und den Gates, die vor dem Pull Request standen. Die betrieblichen Vorteile zeigten sich sofort: ein Trace zum Auswerten, keine Zusammenfassungen zwischen Sub-Agents mehr.
Wichtiger noch: Die Qualität der Pull Requests hat sich verbessert, und die Zeit zwischen der Erkennung eines Issues und der Eröffnung des Pull Requests, der es behebt, ist deutlich gesunken. Im Monat rund um den Wechsel sank der Median von 2,2 Stunden auf 35 Minuten und das p90 von neun Tagen auf unter zwei Stunden. Unter der Pipeline blieb ein Finding typischerweise mehrere Stunden lang in einer Kette von Workflows liegen, jeder wartend auf den vorherigen. Beim einzelnen Agent öffnet sich der Pull Request nur Minuten nach der Erkennung des Issues.
Wir eröffnen jetzt auch deutlich mehr Pull Requests. Als wir Sub-Agents einsetzten, endeten 0,6 % der erkannten Issues in einem Pull Request. Beim einzelnen Agent sind es 4,2 %, Tendenz steigend. Der Unterschied liegt in den Fehlermodi. Eine Pipeline mit mehreren Sub-Agents muss jede Übergabe überstehen: Die Triage muss das Finding weiterreichen, der Coordinator muss Hypothesen erzeugen, der Fan-out muss zu einem Urteil kommen usw. Jede Übergabe ist ein potenzieller Fehlermodus.
Auch die Kosten pro Pull Request sind gesunken. Jeder Run startet jetzt mit dem stärkeren Modell, sodass ein verworfenes Finding mehr kostet als unter der Pipeline. Aber die durchschnittlichen Kosten pro Pull Request sind in den ersten neun Tagen des einzelnen Agents von $111 auf etwa $18 gefallen. Dieser Rückgang ist nicht ausschließlich das Ergebnis der Architekturänderung, da wir aktiv an jedem Aspekt von Polylane iterieren. Ein Teil davon ist die gewöhnliche Drift eines Systems unter ständiger Iteration.
Alle Werte hinter den drei Diagrammen, nach UTC-Tag
| Tag | Erkannte Issues mit Pull Request | Median | p90 | Kosten pro Pull Request |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · ein Agent | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · bis 16:00 | 8.2% | 30 min | 55 min | $2.88 |
Baue keine Sub-Agents
- Übergaben verlieren mehr, als sie sparen. Jede Zusammenfassung, die zwischen Agents weitergegeben wird, ist Kontext, den der nächste Agent nie haben wird. Der Agent, der die Beweise sammelt, sollte der Agent sein, der danach handelt.
- Bewerte den Run, nicht die Agents. Evaluationen pro Agent bestehen, während das System versagt, weil die Fehler zwischen den Agents liegen.
- Behalte einen Trace pro Run. Eine falsche Entscheidung, verteilt über ein Dutzend Traces, braucht einen Nachmittag, um erklärt zu werden. In einem Trace reicht ein Scrollen.