

サブエージェントはただ間違っている
Explore with AI
PolylaneのAutofixエージェントはもともと、複数のサブエージェントによるワークフローとして構築されており、それぞれが単一のタスクを担当していました。
- 数千のアラートやシグナルを選別するトリアージ
- サブエージェントを操作するコーディネーター
- イシューについて考えられるすべての仮説を調査する、最大15のサブエージェント
- そして最終的にプルリクエストを提出するコーディングエージェント
確認されたイシュー1件につき、調査と修正のために最大18のエージェントおよびサブエージェントが動くことがありました。現在は同じ作業を単一のエージェントが行っています。
このワークフローは、当時分かっていたことに基づいた妥当な設計でした。小さなプロンプト、小さなツールセット、そして専門エージェント間で結果を運ぶオーケストレーターです。しかし、運用と検証には非常にコストがかかり、困難でした。
イシューとは何か
Polylaneは、接続されているすべてのプロバイダー上のあらゆるクラウドリソース(Lambda function、Cloudflare Worker、Vercelプロジェクトなど)から、ログ、メトリクス、トレースをスキャンします。各リソースについて複数の期間にわたるベースラインを保存し、データの季節性を捉えられるようにしています。そのうえで、クラウドリソースの現在の状態を評価し、過去のデータと比較します。ベースラインを外れた値はイシューとして記録されます。
イシューは、オブザーバビリティやエラートラッキングのソリューションから受け取るアラートによっても作成されます。
イシューをどう解決するか
イシューを解決するには、次のことが必要です。
- トリアージ: データを収集し、イシューを確認または却下します。
- 調査: 複数の仮説を評価し、根本原因を特定します。
- プルリクエストを作成するか、エスカレーションする: イシューを解決するプルリクエストを作成するか、修正がコード変更でない場合はエンジニアにエスカレーションするか、または調査結果をまとめたレポートを書いて終了します。
大多数の実行は、Polylaneがそのイシューを誤検知または良性と判断した時点で、プルリクエストやエスカレーションに至る前に終了します。
サブエージェントアーキテクチャ
最初のアーキテクチャは、複数のサブエージェントに基づいていました。
複数のサブエージェント間の作業を調整するために、オーケストレーターエージェントを使用していました。サブエージェントは仮説を調査するためにインスタンス化され、異なる出発点(たとえばログから調べ始める、あるいはコードベースから調べ始めるなど)で各仮説を証明または反証しようとしました。
サブエージェントの調査結果は、単純な算術で投票され、別のエージェントによって要約されたうえで、コーディネーターエージェントに集約されていました。
各仮説の判定は、その実行パスにわたる信頼度で重み付けした投票によって決まりました。
const CONFIDENCE_RANK = { definitive: 4, strong: 3, moderate: 2, weak: 1, speculative: 0 };

function aggregatePassVerdicts(passes: PassResult[]): Verdict {
  const weights: Record<string, number> = {};
  const counts: Record<string, number> = {};
  for (const p of passes) {
    weights[p.verdict] = (weights[p.verdict] ?? 0) + CONFIDENCE_RANK[p.confidence];
    counts[p.verdict] = (counts[p.verdict] ?? 0) + 1;
  }
  const totalWeight = Object.values(weights).reduce((a, b) => a + b, 0);
  const [winner, winnerWeight] = Object.entries(weights).sort((a, b) => b[1] - a[1])[0];

  const countMajority = counts[winner] > passes.length / 2;
  const weightMajority = winnerWeight > totalWeight / 2;
  if (!countMajority && !weightMajority) {
    return { verdict: "inconclusive", confidence: "weak", summary: `No consensus across ${passes.length} passes.` };
  }

  const majority = passes.filter((p) => p.verdict === winner);
  const confidence = majority.reduce((min, p) => (CONFIDENCE_RANK[p.confidence] < CONFIDENCE_RANK[min] ? p.confidence : min), majority[0].confidence);
  const lead = majority.reduce((best, p) => (CONFIDENCE_RANK[p.confidence] > CONFIDENCE_RANK[best.confidence] ? p : best));
  return { verdict: winner, confidence, summary: lead.summary };
}
すべての仮説を調査し終え、根本原因が特定された場合、コーディネーターはエンジニアにエスカレーションするか、修正のプランを作成していました。このプランはコーディングサブエージェントに渡され、修正を実装してプルリクエストを提出していました。
このアーキテクチャの主な問題は、サブエージェント間でコンテキストが失われることでした。各エージェントは要約を通じて、自身のコンテキストのごく一部だけを上流や下流にやり取りしており、上流・下流の両方のエージェントが同じ作業をやり直さなければならないことが頻繁にありました。
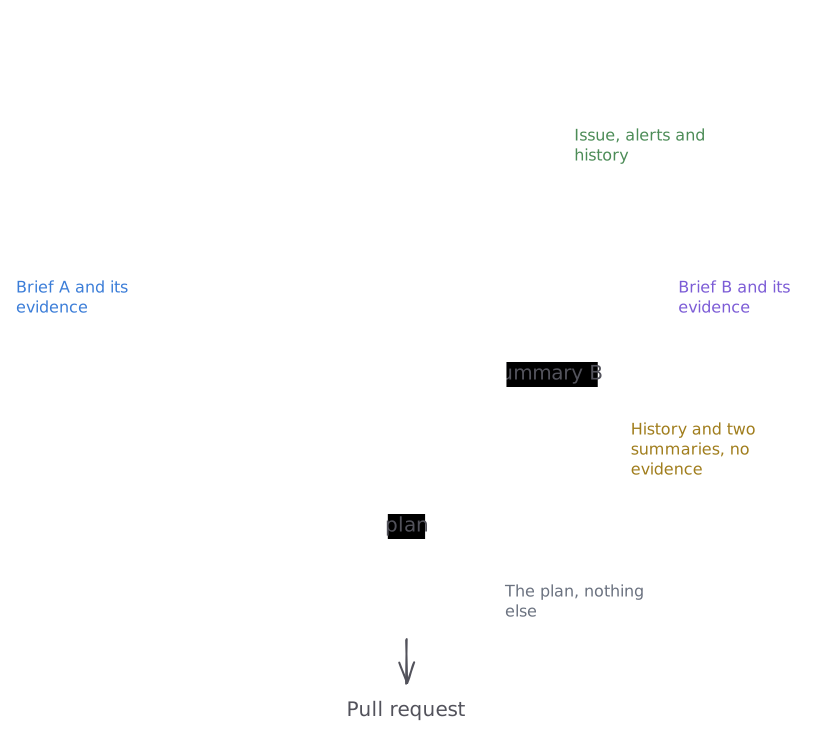
さらに、修正を書くエージェントはプランしか持っておらず、元のイシューや調査で収集された証拠についてのコンテキストを欠いていました。これにより、根本原因ではなく症状に焦点を当てた、質の低いプルリクエストにつながることがよくありました。
このアーキテクチャを選んだ主な理由は、2026年3月に最初に設計した当時、フロンティアモデルが修正の記述まで含めたエンドツーエンドの調査を常にこなせるとは限らなかったこと、そして率直に言って、私たちのハーネスがそれほど優れていなかったことです。
この基盤の上に構築を続けることは、次の理由でますます難しくなっていきました。
- デバッグには多くのトレースが必要でした。 エンドツーエンドの調査を検証するには、複数の、時には数十のトレースに目を通す必要がありました。
- 評価は段階ごとに行われていました。 各サブエージェントは個別に評価すれば合格することができましたが、失敗は引き継ぎの部分に潜んでいたため、最終結果は不十分でした。
私たちはこのアーキテクチャを何か月も改良し続け、各エージェントを個別に改善し、プロンプトや引き継ぎを調整しました。しかし、結果はかけた労力に見合いませんでした。コストがかかり、デバッグが難しく、プルリクエストの質も十分ではありませんでした。
シングルエージェント
9月3日、私たちはサブエージェントによるワークフローを、トリアージからプルリクエストまですべてをこなす単一のエージェントに置き換えました。同じエージェントが証拠を収集し、すべての仮説を調査し、プルリクエストを提出します。
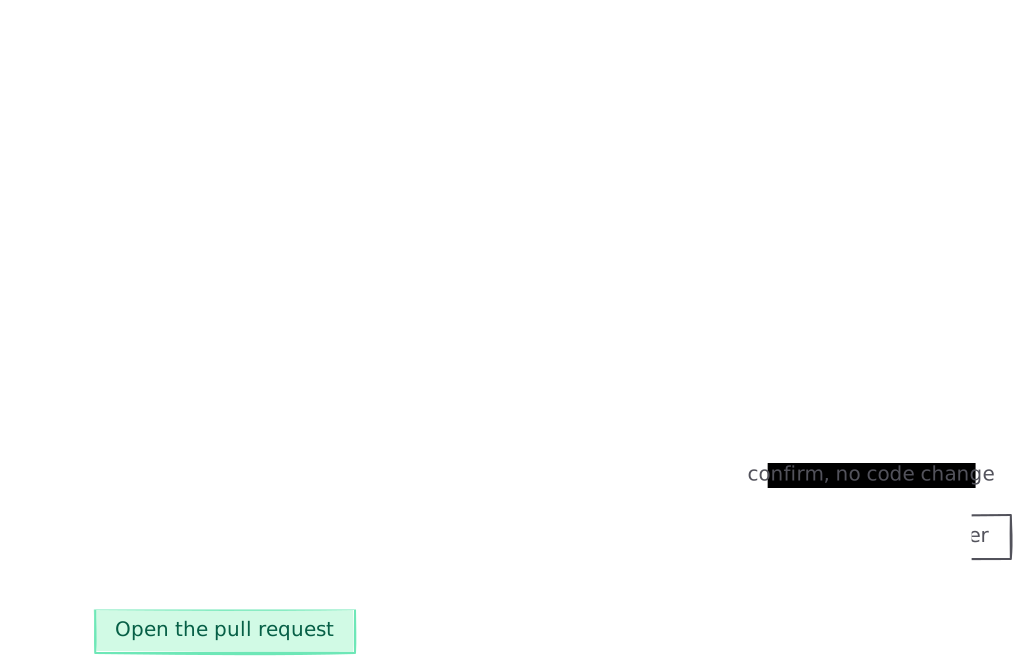
私たちはトリアージエージェント、コーディネーター、仮説エージェント、そしてAutofixエージェントを、それらの間で結果を運んでいたワークフローや、プルリクエストの手前にあったゲートとともに削除しました。運用上のメリットはすぐに現れました。評価すべきトレースが1本になり、サブエージェント間の要約もなくなりました。
さらに重要なことに、プルリクエストの品質が向上し、イシューを検出してからそれを修正するプルリクエストを開くまでの時間が大幅に短縮されました。切り替えの前後1か月間で、中央値は2.2時間から35分に、p90は9日から2時間未満になりました。パイプラインのもとでは、1つの検出結果が一連のワークフローの中で数時間滞留するのが一般的で、それぞれが前の工程の完了を待っていました。シングルエージェントのもとでは、イシューの検出から数分でプルリクエストが開きます。
現在は、プルリクエストの開かれる数もはるかに増えています。サブエージェントを使っていた頃は、検出されたイシューのうちプルリクエストに至ったのは0.6%でした。シングルエージェントのもとでは4.2%となり、さらに上昇を続けています。この違いは失敗の起き方の違いによるものです。複数のサブエージェントによるパイプラインは、すべての引き継ぎを乗り越える必要があります。トリアージは検出結果を次に進める必要があり、コーディネーターは仮説を生成する必要があり、ファンアウトは判定に到達する必要がある、といった具合です。それぞれの引き継ぎが、失敗の起こりうる箇所になります。
プルリクエストあたりのコストも下がりました。現在はすべての実行がより強力なモデルから開始するため、却下される検出結果1件あたりのコストはパイプラインの頃より高くなっています。しかし、プルリクエスト1件あたりの平均コストは、シングルエージェント導入から最初の9日間で$111から約$18になりました。この低下は、アーキテクチャの変更だけによるものではありません。私たちはPolylaneのあらゆる側面を絶えず改良し続けているためです。一部は、継続的な改良のもとにあるシステムの通常の変動によるものです。
3つのチャートの元になったすべての値(UTC日別)
| 日付 | プルリクエストに至った検出イシュー | 中央値 | p90 | プルリクエストあたりの支出 |
|---|---|---|---|---|
| 14 Aug | 1.9% | 2.3 h | 2.7 h | $144 |
| 15 Aug | 1.1% | 5.6 h | 5.9 h | $270 |
| 16 Aug | 2.3% | 1.2 h | 4.2 d | $121 |
| 17 Aug | 1.5% | 38 min | 4.5 d | $120 |
| 18 Aug | 0.9% | 20 min | 27 min | $57 |
| 19 Aug | 0.7% | 49 min | 12.2 h | $157 |
| 20 Aug | 0.7% | 1 h | 35.9 h | $202 |
| 21 Aug | 0.8% | 44.2 h | 4.2 d | $211 |
| 22 Aug | 0.8% | 7.7 d | 10.4 d | $563 |
| 23 Aug | 1.3% | 32 min | 35.3 h | $205 |
| 24 Aug | 0.6% | 2.5 d | 5.6 d | $90 |
| 25 Aug | 1.4% | 1.5 h | 13.4 h | $43 |
| 26 Aug | 0.3% | 1.5 h | 2.1 h | $45 |
| 27 Aug | 0.7% | 1.9 h | 2.5 h | $58 |
| 28 Aug | 1% | 11.7 d | 14.1 d | $49 |
| 29 Aug | 1.5% | 26.1 h | 10.4 d | $32 |
| 30 Aug | 0.5% | 2 d | 2.8 d | $51 |
| 31 Aug | 0.2% | 9 d | 10.4 d | $77 |
| 1 Sep | 0.1% | 4.2 d | 4.2 d | $169 |
| 2 Sep | 0.1% | 6.7 d | 6.7 d | $93 |
| 3 Sep · シングルエージェント | 0.4% | 29 min | 2.6 d | $69 |
| 4 Sep | 2.4% | 23 min | 5.4 h | $25 |
| 5 Sep | 2.9% | 34 min | 3.4 d | $15 |
| 6 Sep | 1.4% | 34 min | 43.7 h | $23 |
| 7 Sep | 1.8% | 32 min | 4.5 h | $16 |
| 8 Sep | 4% | 41 min | 19.4 h | $26 |
| 9 Sep | 7.6% | 34 min | 1.2 h | $15 |
| 10 Sep | 5% | 34 min | 1.3 h | $17 |
| 11 Sep | 5.4% | 56 min | 2.1 h | $12 |
| 12 Sep | 9.1% | 35 min | 1.3 h | $3.46 |
| 13 Sep · 16:00まで | 8.2% | 30 min | 55 min | $2.88 |
サブエージェントを作ってはいけない
- 引き継ぎは、得るものより失うものの方が多くなります。 エージェント間で渡される要約はすべて、次のエージェントが決して持つことのないコンテキストです。証拠を集めるエージェントこそが、それに基づいて行動するエージェントであるべきです。
- エージェントではなく、実行全体を評価します。 エージェントごとの評価は合格しても、失敗はエージェントとエージェントの間に潜んでいるため、システム全体としては失敗することがあります。
- 1回の実行につき、トレースは1本に保ちます。 誤った判断が十数本のトレースに散らばっていると、それを説明するのに半日かかります。1本のトレースなら、スクロールするだけで済みます。