

كيف نمنع الكود الرديء من الوصول إلى الإنتاج
Explore with AI
من المحتمل أنك تبني مصنع برمجيات أو تستأجر واحدًا من مزوّد. لديك نظام يأخذك من prompt إلى طلب pull request. يتعامل هذا النظام مع الاختبارات، وlinting، والتنسيق، ومراجعات الكود التلقائية.
لكنك ما زلت من دون إجابة عن السؤال الأهم: هل هذا التغيير جاهز للانتقال إلى الإنتاج؟.
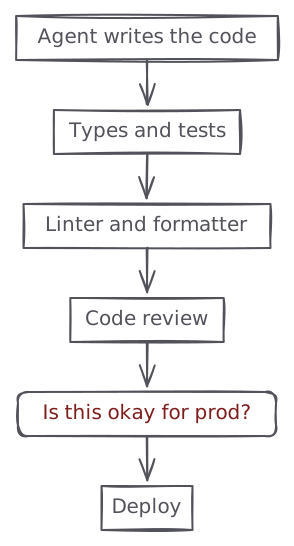
كل فحوصاتك الحالية تنظر إلى diff، لكن لا شيء في مصنعك يعرف أي شيء عن نظام الإنتاج الذي سيصل diff إليه. لا شيء يمكنه فعليًا منع الكود الرديء من الوصول إلى الإنتاج.
بنينا هذه القدرة داخل Polylane وهذا المنشور يتناول التفاصيل التقنية لكيفية تنفيذها.
كيف يعمل
السؤال الوحيد الذي يجب أن يجيب عنه هذا النظام هو:
هل سيكون لهذا التغيير، بعد دمجه ونشره، تأثير سلبي على الإنتاج؟
لا يهمنا فعليًا الأمور المعتادة التي يفحصها وكيل مراجعة الكود، مثل النمط، وتسمية المتغيرات، وتغطية الاختبارات، وغيرها. وقررنا الإجابة عن هذا السؤال في مرحلة طلب pull request، جنبًا إلى جنب مع كل اختباراتك الحالية.
في النهاية، يعلّق Polylane على طلب pull request برسالة بسيطة “go” / “no-go” مع الإثباتات من تحقيقه.
التدفق بسيط إلى حد ما:
- هل يلمس طلب pull request هذا ملفات قد تؤثر على الإنتاج؟
- ما هي الموارد السحابية التي قد تتأثر؟
- جمع السياق حول الحالة الحالية للإنتاج لتلك الموارد
- تقييم أنماط فشل محتملة متعددة قد يُدخلها هذا التغيير
- التنبؤ بكيفية تغيّر الإنتاج مع نشر هذه التغييرات
- تنبيه المطوّرين إلى أنماط الفشل المحتملة الأكثر ترجيحًا
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
يعتمد هذا كله على Context graph الذي نبنيه باستمرار ليربط كل الموارد السحابية في حساباتك السحابية المتعددة.
تجميع السياق
Context graph الخاص بنا هو المفتاح لجعل هذا يعمل، فهو يبني سجلًا لكل مواردك السحابية، وكل مستوداتك، وفرقك، وغيرها. على سبيل المثال، عقدة حوسبة مثل دالة Lambda تكون متصلة بقاعدة البيانات التي تقرأ منها وبالطابور الذي يُشغّلها. نضيف أيضًا المستودعات إلى المخطط. يتم ذلك بالنظر إلى ملفات manifest المعتادة في المستودع، مثل ملفات terraform، أو ملفات Cloudformation، أو ملفات Wrangler. هذا يتيح الربط بين المستودعات والموارد السحابية.
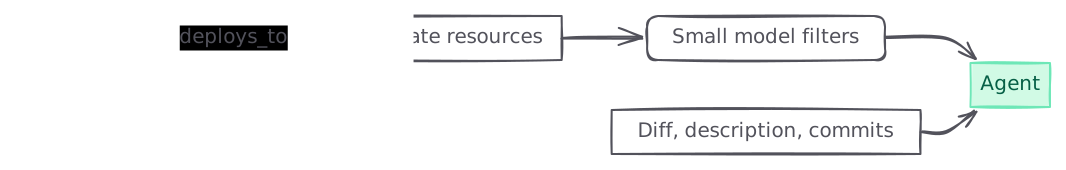
عندما يُقدَّم طلب pull request إلى المستودع، نتبع المسارات على Context graph لجمع كل الموارد السحابية التي قد تتأثر بالتغيير. نستخدم نماذج صغيرة لتصفية الموارد لأنه قد يكون هناك عدد كبير من الموارد المنشورة من نفس المستودع. نُمرّر هذا السياق إلى الوكيل جنبًا إلى جنب مع diff، ووصف PR، وcommits الموجودة في PR.
نُمرّر أيضًا diff عبر مجموعة من الاستدلالات (heuristics) المحدَّدة لتوجيه انتباه الوكيل بسرعة نحو الأمور التي يُرجَّح عادةً أن يكون لها تأثير سلبي على الإنتاج:
- ترحيل (migration) يجب تطبيقه يدويًا، أو بترتيب معيّن بالنسبة إلى عملية النشر
CREATE INDEXمن دونCONCURRENTLY، أوADD COLUMN ... NOT NULLمن دون قيمة افتراضية، وكلاهما يأخذ قفلًا (lock) على الجدول طوال المدة- نقطة نهاية (endpoint) تُحذف بينما لا تزال النسخة المنشورة حاليًا تقرأها
- كود يبدأ بقراءة متغيّر بيئة، أو سر (secret)، أو binding لا يوفّره أي شيء في diff
هذه توصيات، توجّه الوكيل نحو مخاطر النشر المحتملة.
مسارات الفشل
بالاستناد إلى السياق المذكور أعلاه، يضع النموذج أنماط فشل متنوعة قد يُدخلها diff الجديد في الإنتاج، ثم يذهب ليحقق في كل واحد منها.
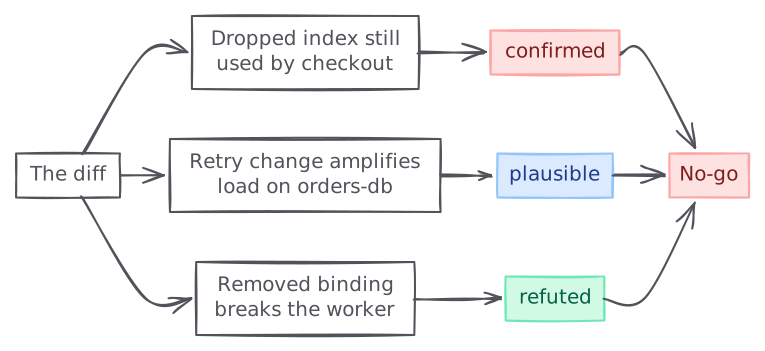
مخرجه هو سجل (ledger) لمسارات الفشل. المسار هو سلسلة سببية واحدة تبدأ من مُحرِّك (trigger)، وتمر عبر الكود المُغيَّر، وتنتهي بتدهور يمكن رصده في مقياس معيّن، وكل حلقة فيه تحمل استشهادًا: ملف وسطر، أو قالب سجل مع عدده، أو قراءة مقياس، أو مفتاح تهيئة، أو حافة في المخطط (graph edge).
يحاول الوكيل التحقق من كل مسار ونفيه في الوقت نفسه قبل الوصول إلى حكم. ينتهي كل مسار في واحدة من ثلاث حالات:
confirmedعندما يتم تأكيد المسار مقابل الإنتاج.plausibleعندما تكون السلسلة واضحة، لكن حلقة واحدة أو أكثر لم يكن ممكنًا إلا “تخمينها” من دون بيانات قياس عن بُعد تؤكدها.refutedعندما توفّر بيانات القياس عن بُعد من الإنتاج أدلة كافية على أن حدوث هذا المسار في الإنتاج غير مرجَّح.
نتبع نهجًا متحفّظًا، وأي مسار confirmed يقود إلى تقييم فاشل.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
التنبؤ بالتأثير
نُعطي الوكيل أداة للتنبؤ بالسلاسل الزمنية (timeseries) بالاستناد إلى البيانات التاريخية مع إدخال عوامل خارجية محتملة.
لنقل أن مسارًا يزعم أن تغييرًا ما يُقلّص المهلة الزمنية (timeout) إلى نصفها على مسار يعيد المحاولة. أهمية ذلك تعتمد على حركة المرور (traffic)، وحركة المرور ليست عددًا واحدًا فعليًا، بل لها شكل. طابور يبقى عند عمق 60% ويستمر عليه أمر جيد. نفس الطابور عند 60% لكنه يتصاعد كل أسبوع وضع مختلف تمامًا، وقراءة آخر ساعة من المقاييس لن تخبرك أي حالة تنظر إليها.
لذلك قبل أن يكتب الوكيل حكم مسار ما، يسحب السلاسل التاريخية للموارد المتأثرة ويتنبأ بها معًا. نستضيف حاليًا نموذج Toto-2.0-22m بأنفسنا.
سبب استخدام نموذج متعدد المتغيرات مخصص بدلًا من prompt آخر هو أن السلاسل ليست مستقلة. معدل الطلبات، ومعدل الأخطاء، والكمون (latency)، وعمق الطابور على مورد واحد تتحرك معًا، والتنبؤ بكل واحدة منها بمفردها يُهدر الارتباط الذي يجعل التنبؤ ذا قيمة. كل سلسلة في الاستدعاء تشترك في مجموعة انتباه (attention group) واحدة.
هذه هي القدرة الأكثر تجريبية التي أضفناها مؤخرًا، وما زلنا نقيس تأثيرها. لكنها تنجح بالفعل في اختبار vibes-eval.
قيد الكمون (latency)
تشغيل تقييم تأثير الإنتاج في تدفق طلب pull request يعني أنه يجب أن يكون سريعًا. لا أحد يريد خطوة تضيف 15 دقيقة إلى pipeline خاص بـ CI. على سبيل المثال، في مستودعاتنا الخاصة هذا التقييم خطوة CI مطلوبة، وإذا كان بطيئًا، تتعطّل دورة تطوير البرمجيات (SDLC) بالكامل عندنا.
لدينا في الأساس ميزانية زمنية من دقيقتين إلى ثلاث دقائق لإنتاج تقييم تأثير دقيق. أي شيء يتجاوز ذلك غير مقبول في pipeline خاص بـ CI/CD.
كان نموذجنا الأولي الأول يفشل تمامًا في تحقيق هذا القيد. كان الوسيط عندنا قريبًا من 7 دقائق، وكان شائعًا أن نرى جولات تستغرق حتى 20 دقيقة.
أصبح الهدف هو معرفة كيفية تقليل عدد خطوات النموذج للوصول بالتدفق الكامل إلى أقل من 3 دقائق. كنا نُشغّل عادةً من 30 إلى 40 خطوة نموذج متتالية، وفي أسوأ السيناريوهات حتى نحو 600 خطوة، تستهلك كل واحدة منها 17 ثانية من ميزانيتنا، وكانت الغالبية العظمى من مخرجاتها عبارة عن رموز استدلال (reasoning tokens).
أجرينا عدة تغييرات على مدى الأسابيع الثلاثة الماضية، بتأثيرات متفاوتة على الأداء. هذه أهمها.
تحديد ميزانية للخطوات وإخبار الوكيل بها
أدخلنا ميزانية للخطوات، محدَّدة بحد أقصى 30 خطوة لكل جولة وكيل، ونُخبر النموذج بوضوح بعدد الخطوات التي استهلكها في كل خطوة. وضع العدد في prompt يتيح للنموذج التخطيط حوله، وهو ما تبيّن أنه أهم من العدد نفسه.
بدء مراجعات جديدة بدلًا من دمجها في المراجعة الحالية
يستمر طلب pull request النموذجي في تلقّي commits جديدة بعد فتحه. في النموذج الأولي الأول، كنا ندمج diff الجديد بالكامل في محادثة المراجعة نفسها كرسالة توجيه من المستخدم. كان هذا التوجيه يُشوّش النموذج بشدة، ويؤدي إلى قراءة ملفات كان قد فحصها بالفعل، وإعادة تشغيل استعلامات قياس عن بُعد كان قد أنجزها من قبل.
الآن، أي commit جديد يُلغي جولة التقييم السابقة ويبدأ محادثة جديدة تمامًا. يبدو ذلك غير منطقي، لكنه أدى في النهاية إلى تقليل الكمون للمراجعات الكاملة.
إعادة استخدام العمل السابق
عندما يصل commit جديد إلى طلب pull request بعد اكتمال مراجعة بالفعل، كنا نبدأ بتقييم تأثير جديد من الصفر بطريقة بسيطة.
أدخلنا القدرة على إعادة استخدام التقييم السابق، وتشغيل تقييم جديد على diff الأصغر بين الـ commit-ين المتتاليين.
نشرنا هذه التغييرات طوال شهر سبتمبر، وحسّنا الكمون تدريجيًا، والآن يبقى الكمون ضمن الميزانية بسهولة.
هل هذا مهم فعلًا؟
ما الفائدة من استهلاك كل هذه الرموز (tokens) إن لم نر أي نتائج ذات معنى؟ مقياس نجاحنا هو عدد الحوادث التي نمنعها أسبوعيًا لكل عميل من عملائنا. الحادثة الممنوعة هي طلب pull request حيث:
- نُشير إلى خطر محتمل على الإنتاج
- يدفع مهندس واحدًا أو أكثر من الـ commits
- يستنتج تقييم جديد أن الخطر المحتمل قد خُفِّف
- يُدمج طلب pull request
هذا رقم كبير بالفعل، ونتوقع أن يستمر في النمو. نحن نُكرّر باستمرار العمل ونُشغّل evals لتحسين أداء وجودة وكيلنا.