

Wie wir verhindern, dass Slop in Prod landet
Explore with AI
Du baust wahrscheinlich entweder gerade eine Softwarefabrik oder mietest eine bei einem Anbieter. Du hast ein System, das dich von einem Prompt zu einem Pull Request bringt. Es kümmert sich um Tests, Linting, Formatierung und automatisierte Code-Reviews.
Aber du hast immer noch keine Antwort auf die wichtigste Frage: Ist diese Änderung bereit für Prod?.
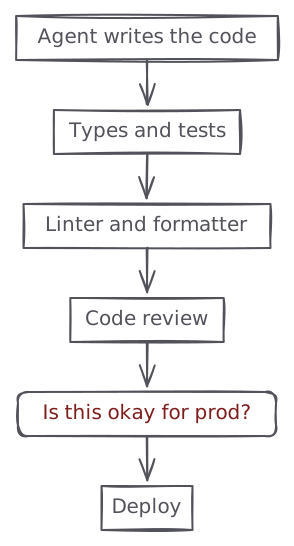
All deine aktuellen Checks schauen sich den Diff an, aber nichts in deiner Fabrik weiß etwas über das Produktionssystem, auf das der Diff gleich losgelassen wird. Nichts kann wirklich verhindern, dass Slop in Prod landet.
Wir haben diese Fähigkeit in Polylane eingebaut, und in diesem Beitrag geht es um die technischen Details der Umsetzung.
So funktioniert es
Die eine Frage, die dieses System beantworten soll, lautet:
Hätte diese Änderung, einmal gemerged und deployt, negative Auswirkungen auf die Produktion?
Uns interessieren die typischen Dinge, die ein Code-Review-Agent prüfen würde – Stil, Namensgebung, Testabdeckung und so weiter – eigentlich nicht. Wir haben uns entschieden, diese Frage auf Ebene des Pull Requests zu beantworten, zusätzlich zu all deinen bestehenden Tests.
Am Ende kommentiert Polylane den Pull Request mit einer einfachen „Go“- / „No-Go“-Nachricht samt den Belegen aus seiner Untersuchung.
Der Ablauf ist recht einfach:
- Berührt dieser Pull Request Dateien, die die Produktion betreffen könnten?
- Welche Cloud-Ressourcen sind potenziell betroffen?
- Kontext über den aktuellen Zustand der Produktion für diese Ressourcen sammeln
- Mehrere mögliche Fehlermodi bewerten, die diese Änderung einführen könnte
- Vorhersagen, wie sich die Produktion mit diesen Änderungen verändern könnte
- Entwickler über die wahrscheinlichen potenziellen Fehlermodi informieren
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Das alles beruht auf dem Context graph, den wir kontinuierlich aufbauen und der alle Cloud-Ressourcen in deinen verschiedenen Cloud-Accounts miteinander verbindet.
Den Kontext zusammenstellen
Unser Context graph ist der Schlüssel dafür, dass das funktioniert. Er baut eine Registry aller deiner Cloud-Ressourcen, aller deiner Repositories, Teams usw. auf. Ein Compute-Node wie eine Lambda-Funktion ist zum Beispiel mit der Datenbank verbunden, aus der sie liest, und der Queue, die sie auslöst. Wir fügen dem Graphen auch Repositories hinzu. Das geschieht, indem wir uns die typischen Manifest-Dateien im Repository ansehen, zum Beispiel Terraform-Dateien, Cloudformation-Dateien oder Wrangler-Dateien. Das ermöglicht die Verbindung zwischen Repositories und Cloud-Ressourcen.
Wenn ein Pull Request an das Repository übermittelt wird, folgen wir den Pfaden im Context graph, um alle Cloud-Ressourcen zu sammeln, die von der Änderung potenziell betroffen sind. Wir nutzen ein kleines Modell, um die Ressourcen zu filtern, da aus demselben Repository eine große Zahl von Ressourcen deployt sein kann. Diesen Kontext geben wir zusammen mit dem Diff, der PR-Beschreibung und den Commits im PR an den Agenten weiter.
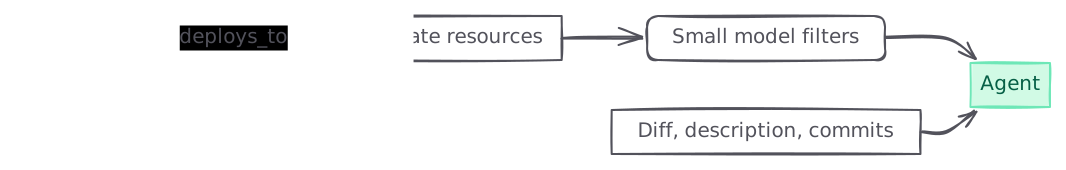
Außerdem schicken wir den Diff durch eine Reihe deterministischer Heuristiken, um die Aufmerksamkeit des Agenten schnell auf Dinge zu lenken, die üblicherweise negative Auswirkungen auf die Produktion haben können:
- eine Migration, die von Hand oder in einer bestimmten Reihenfolge relativ zum Deploy angewendet werden muss
CREATE INDEXohneCONCURRENTLY, oderADD COLUMN ... NOT NULLohne Default – beides sperrt die Tabelle für die Dauer der Operation- ein Endpoint, der entfernt wird, während die aktuell deployte Version ihn noch liest
- Code, der beginnt, eine Umgebungsvariable, ein Secret oder ein Binding zu lesen, das nichts im Diff bereitstellt
Das sind Empfehlungen, die den Agenten auf wahrscheinliche Deployment-Risiken lenken.
Fehler-Trajektorien
Mit dem oben bereitgestellten Kontext entwickelt das Modell verschiedene Fehlermodi, die der neue Diff in der Produktion verursachen könnte, und untersucht jeden davon.
Die Ausgabe ist ein Register von Fehler-Trajektorien. Eine Trajektorie ist eine kausale Kette von einem Auslöser über den geänderten Code bis zu einer beobachtbaren Verschlechterung einer bestimmten Metrik, und jedes Glied darin trägt einen Beleg: eine Datei und Zeile, eine Log-Vorlage mit ihrer Anzahl, einen Metrikwert, einen Config-Key, eine Kante im Graphen.
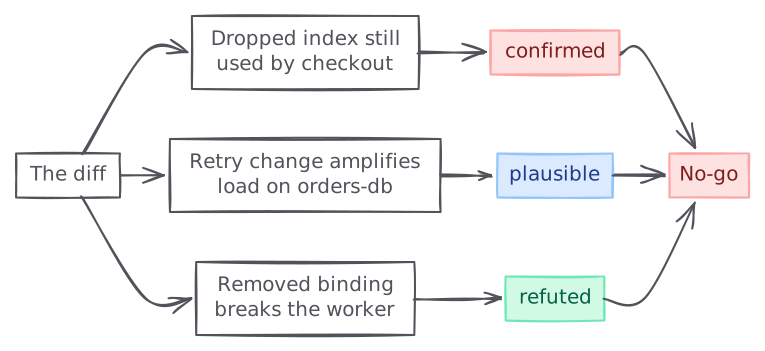
Der Agent versucht, jede Trajektorie sowohl zu bestätigen als auch zu widerlegen, bevor er zu einem Verdict kommt. Jede endet in einem von drei Zuständen:
confirmed, wenn die Trajektorie gegen die Produktion bestätigt wurde.plausible, wenn die Kette konkret ist, aber ein oder mehrere Glieder nur „geraten“ werden konnten, ohne Telemetriedaten zur Bestätigung.refuted, wenn Telemetriedaten aus der Produktion genug Belege liefern, dass diese Trajektorie in der Produktion unwahrscheinlich ist.
Wir gehen konservativ vor: Jede confirmed-Trajektorie führt zu einem gescheiterten Assessment.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Die Auswirkungen vorhersagen
Wir geben dem Agenten ein Tool, um Zeitreihen auf Basis historischer Daten vorherzusagen, wobei mögliche externe Faktoren eingespeist werden.
Nehmen wir an, eine Trajektorie behauptet, eine Änderung halbiere das Timeout auf einem Pfad mit Retries. Ob das eine Rolle spielt, hängt vom Traffic ab, und Traffic ist eigentlich keine einzelne Zahl, sondern hat eine Form. Eine Queue, die bei 60 % Füllstand liegt und dort bleibt, ist unproblematisch. Dieselbe Queue bei 60 %, aber jede Woche weiter steigend, ist eine andere Situation – und wenn du nur die letzte Stunde an Metriken liest, siehst du nicht, welche der beiden es ist.
Bevor der Agent also das Verdict für eine Trajektorie entwirft, zieht er die historischen Zeitreihen für die betroffenen Ressourcen und sagt sie gemeinsam vorher. Wir hosten aktuell selbst das Toto-2.0-22m-Modell.
Der Grund für ein dediziertes multivariates Modell statt eines weiteren Prompts ist, dass die Zeitreihen nicht unabhängig sind. Request-Rate, Fehlerrate, Latenz und Queue-Tiefe einer Ressource bewegen sich gemeinsam, und jede einzeln vorherzusagen verwirft genau die Korrelation, die die Vorhersage wertvoll macht. Jede Zeitreihe in einem Aufruf teilt sich eine Attention-Gruppe.
Das ist die experimentellste Fähigkeit, die wir kürzlich hinzugefügt haben, und wir messen ihre Wirkung noch. Aber sie besteht bereits den Vibes-Eval.
Die Latenzbeschränkung
Das Production-Impact-Assessment im Pull-Request-Flow laufen zu lassen bedeutet, dass es schnell sein muss. Niemand will einen Schritt, der der CI-Pipeline 15 Minuten hinzufügt. In unseren eigenen Repositories ist dieses Assessment zum Beispiel ein verpflichtender CI-Schritt – wenn es langsam ist, gerät unser gesamter SDLC ins Stocken.
Im Grunde haben wir ein Budget von 2 bis 3 Minuten, um ein präzises Impact-Assessment zu erstellen. Alles darüber hinaus ist in einer CI/CD-Pipeline nicht akzeptabel.
Unser erster Prototyp hat diese Vorgabe komplett verfehlt. Unser Median lag bei fast 7 Minuten, und es war nicht ungewöhnlich, dass Läufe bis zu 20 Minuten dauerten.
Das Ziel war, herauszufinden, wie wir die Anzahl der Modellschritte reduzieren können, um den gesamten Flow unter 3 Minuten zu bringen. Typischerweise liefen 30 bis 40 sequenzielle Modellschritte, im schlimmsten Fall bis zu fast 600 Schritte, jeder davon verbrauchte 17 Sekunden unseres Budgets, und der Großteil der Ausgabe waren Reasoning-Tokens.
In den letzten 3 Wochen haben wir einige Änderungen vorgenommen, mit unterschiedlicher Wirkung auf die Performance. Hier sind die wichtigsten.
Ein Step-Budget festlegen und dem Agenten mitteilen
Wir haben ein Step-Budget eingeführt, gedeckelt auf 30 Schritte pro Agenten-Turn, und teilen dem Modell bei jedem Schritt klar mit, wie viele Schritte es bereits verbraucht hat. Die Anzahl im Prompt zu nennen erlaubt es dem Modell, danach zu planen – das erweist sich als wichtiger als die Zahl selbst.
Neue Reviews starten, statt sie in die bestehende einzufalten
Ein typischer Pull Request bekommt immer wieder neue Commits, nachdem er geöffnet wurde. Im ersten Prototyp haben wir den gesamten neuen Diff als steuernde Nutzernachricht in denselben Review-Thread eingefaltet. Diese Steuerung verwirrte das Modell erheblich und führte dazu, dass es Dateien erneut las, die es bereits untersucht hatte, und Telemetrie-Abfragen erneut ausführte, die es bereits abgeschlossen hatte.
Jetzt bricht ein neuer Commit den vorherigen Assessment-Lauf ab und startet einen komplett neuen Thread. Das wirkt zunächst kontraintuitiv, hat aber letztlich die Latenz für vollständige Reviews gesenkt.
Vorherige Arbeit wiederverwenden
Wenn ein neuer Commit im Pull Request eintrifft, nachdem ein Review bereits abgeschlossen war, haben wir früher naiv ein komplett neues Impact-Assessment gestartet.
Wir haben die Möglichkeit eingeführt, das vorherige Assessment wiederzuverwenden und ein neues Assessment nur für den kleineren Diff zwischen den beiden aufeinanderfolgenden Commits auszulösen.
Wir haben diese Änderungen im Laufe des Septembers ausgerollt und die Latenz nach und nach verbessert – sie liegt inzwischen komfortabel innerhalb des Budgets.
Macht das überhaupt einen Unterschied?
Was bringt es, all diese Tokens zu verbrennen, wenn wir keine sinnvollen Ergebnisse sehen? Unsere Erfolgsmetrik ist die Anzahl der Incidents, die wir pro Woche für jeden unserer Kunden verhindern. Ein verhinderter Incident ist ein Pull Request, bei dem:
- wir ein potenzielles Risiko für die Produktion markieren
- ein Engineer einen oder mehrere Commits pusht
- ein neues Assessment zu dem Schluss kommt, dass das potenzielle Risiko entschärft ist
- der Pull Request gemerged wird
Das ist bereits ziemlich beachtlich, und wir erwarten, dass es weiter wächst. Wir iterieren kontinuierlich und führen Evals durch, um die Performance und Qualität unseres Agenten zu verbessern.