

슬롭이 프로덕션에 배포되지 않도록 막는 방법
Explore with AI
여러분은 아마 소프트웨어 팩토리를 직접 구축하고 있거나, 제공업체에서 임대해 쓰고 있을 것입니다. 프롬프트에서 풀 리퀘스트까지 이어지는 시스템을 갖추고 있고, 이 시스템은 테스트, 린팅, 포매팅, 자동화된 코드 리뷰를 처리합니다.
하지만 가장 중요한 질문, 이 변경 사항이 프로덕션에 나가도 되는가?에는 아직 답이 없습니다.
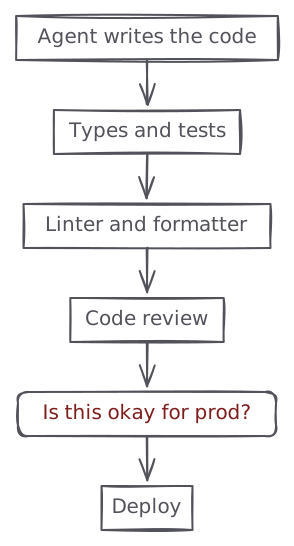
지금 있는 모든 검사는 diff만 들여다볼 뿐, 팩토리 안 그 무엇도 diff가 곧 반영될 프로덕션 시스템에 대해서는 알지 못합니다. 그러니 실제로 슬롭이 프로덕션에 배포되는 것을 막을 방법이 없습니다.
저희는 이 기능을 Polylane 안에 만들었고, 이 글은 어떻게 구현했는지에 대한 기술적인 세부 사항을 다룹니다.
동작 방식
이 시스템이 답해야 할 단 하나의 질문은 다음과 같습니다:
이 변경 사항이 병합되어 배포되면, 프로덕션에 부정적인 영향을 미칠까요?
코드 리뷰 에이전트가 흔히 검사하는 스타일, 네이밍, 테스트 커버리지 같은 것들에는 크게 신경 쓰지 않습니다. 그리고 저희는 이 질문에 기존의 모든 테스트와 나란히, 풀 리퀘스트 단계에서 답하기로 결정했습니다.
결국 Polylane은 풀 리퀘스트에 조사 결과 증거와 함께 단순한 “go” / “no-go” 메시지로 코멘트를 남깁니다.
흐름은 꽤 단순합니다:
- 이 풀 리퀘스트가 프로덕션에 영향을 줄 수 있는 파일을 건드리고 있는가?
- 어떤 클라우드 리소스가 영향을 받을 가능성이 있는가?
- 해당 리소스들의 현재 프로덕션 상태에 대한 컨텍스트 수집
- 이 변경 사항이 일으킬 수 있는 여러 잠재적 실패 모드 평가
- 이 변경 사항이 배포되면 프로덕션이 어떻게 바뀔지 예측
- 있을 법한 잠재적 실패 모드를 개발자에게 알림
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
이 모든 것은 여러 클라우드 계정에 있는 모든 클라우드 리소스를 연결하며 저희가 지속적으로 구축하는 context graph에 기반합니다.
컨텍스트 조립하기
저희의 context graph는 이 기능이 동작하는 데 핵심적인 역할을 합니다. 이 그래프는 모든 클라우드 리소스, 모든 리포지토리, 팀 등에 대한 레지스트리를 구축합니다. 예를 들어 Lambda function 같은 컴퓨트 노드는 자신이 읽는 데이터베이스, 그리고 자신을 트리거하는 큐와 연결됩니다. 저희는 리포지토리도 그래프에 추가합니다. 이는 리포지토리 안에 있는 일반적인 매니페스트 파일, 예를 들어 terraform 파일, Cloudformation 파일, Wrangler 파일을 살펴봄으로써 이루어집니다. 이를 통해 리포지토리와 클라우드 리소스 사이의 연결이 가능해집니다.
풀 리퀘스트가 리포지토리에 제출되면, 저희는 context graph 상의 경로를 따라가며 이 변경 사항으로 영향을 받을 가능성이 있는 모든 클라우드 리소스를 수집합니다. 같은 리포지토리에서 배포되는 리소스가 많을 수 있기 때문에, 작은 모델을 사용해 리소스를 걸러냅니다. 이렇게 얻은 컨텍스트를 diff, PR 설명, PR의 커밋과 함께 에이전트에 전달합니다.
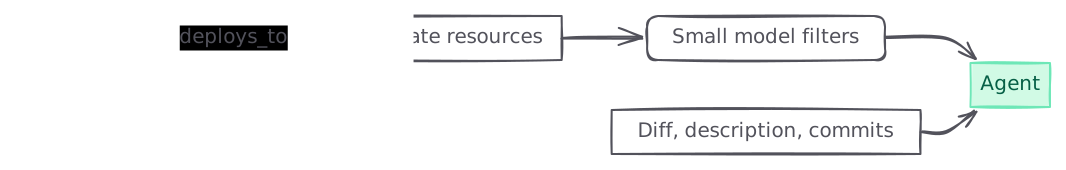
또한 저희는 diff를 일련의 결정론적 휴리스틱에 통과시켜, 보통 프로덕션에 부정적인 영향을 미칠 가능성이 높은 것들로 에이전트의 주의를 빠르게 유도합니다:
- 수동으로 적용해야 하거나, 배포와 관련해 특정 순서로 적용해야 하는 마이그레이션
CONCURRENTLY없이 실행되는CREATE INDEX, 또는 기본값 없이 실행되는ADD COLUMN ... NOT NULL. 둘 다 실행되는 동안 테이블에 락을 겁니다- 현재 배포된 버전이 여전히 읽고 있는 엔드포인트가 제거되는 경우
- diff의 어떤 부분도 프로비저닝하지 않는 환경 변수, 시크릿, 바인딩을 읽기 시작하는 코드
이는 권장 사항으로, 에이전트가 잠재적인 배포 위험 쪽으로 주의를 기울이도록 유도합니다.
실패 궤적
위에서 제공된 컨텍스트를 바탕으로, 모델은 새 diff가 프로덕션에 일으킬 수 있는 다양한 실패 모드를 떠올리고 각각을 직접 조사합니다.
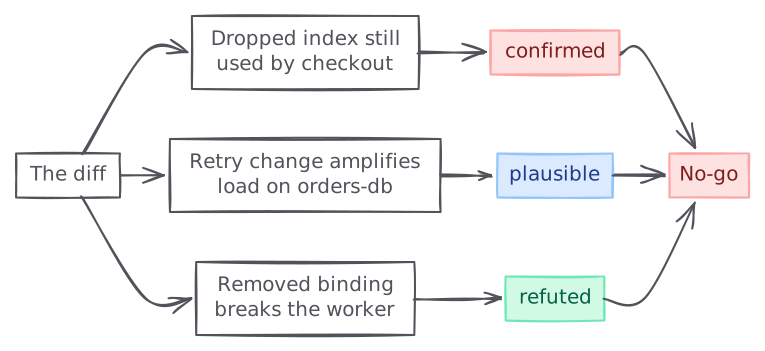
그 결과물은 실패 궤적(failure trajectory)들의 원장입니다. 하나의 궤적은 트리거에서 시작해 변경된 코드를 거쳐 특정 메트릭에서 관측 가능한 저하로 이어지는 하나의 인과 사슬이며, 그 안의 모든 연결 고리에는 근거가 붙습니다. 파일과 라인, 개수를 동반한 로그 템플릿, 메트릭 읽기 값, 설정 키, 그래프 엣지 등입니다.
에이전트는 판정을 내리기 전에 각 궤적을 검증하는 동시에 반증하려 시도합니다. 각 궤적은 다음 세 가지 상태 중 하나로 끝납니다:
- 궤적이 프로덕션에 대해 확인된 경우
confirmed - 사슬은 구체적이지만, 한두 개의 연결 고리를 확인할 텔레메트리 데이터가 없어 “추측”할 수밖에 없는 경우
plausible - 프로덕션 텔레메트리 데이터가 이 궤적이 프로덕션에서 발생할 가능성이 낮다는 충분한 근거를 제공하는 경우
refuted
저희는 보수적인 접근 방식을 취하며, confirmed 궤적이 하나라도 있으면 평가는 실패로 처리됩니다.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
영향 예측하기
저희는 에이전트에게 과거 데이터를 바탕으로 잠재적인 외부 요인을 반영해 타임시리즈를 예측하는 도구를 제공합니다.
예를 들어 어떤 궤적이 특정 변경으로 인해 재시도하는 경로의 타임아웃이 절반으로 줄어든다고 주장한다고 합시다. 이것이 실제로 문제가 되는지는 트래픽에 달려 있고, 트래픽은 사실 하나의 숫자가 아니라 형태를 가집니다. 큐가 60% 깊이에 머물러 있다면 괜찮습니다. 같은 큐가 60%이지만 매주 계속 올라가고 있다면 상황이 다르고, 최근 한 시간의 메트릭만 봐서는 둘 중 어느 쪽인지 알 수 없습니다.
그래서 에이전트는 궤적의 판정을 내리기 전에, 영향을 받는 리소스들의 과거 시계열을 가져와 함께 예측합니다. 저희는 현재 Toto-2.0-22m model을 자체 호스팅하고 있습니다.
또 다른 프롬프트가 아니라 전용 다변량 모델을 쓰는 이유는 시리즈들이 서로 독립적이지 않기 때문입니다. 한 리소스의 요청 비율, 에러 비율, 지연 시간, 큐 깊이는 함께 움직이며, 각각을 따로 예측하면 예측을 가치 있게 만드는 상관관계를 버리게 됩니다. 한 번의 호출에 포함된 모든 시리즈는 하나의 어텐션 그룹을 공유합니다.
이는 저희가 최근 추가한 것 중 가장 실험적인 기능이며, 아직 그 영향을 측정하는 중입니다. 하지만 이미 vibes-eval은 통과했습니다.
지연 시간 제약
풀 리퀘스트 플로우 안에서 프로덕션 영향 평가를 실행한다는 것은 반드시 빨라야 한다는 뜻입니다. CI 파이프라인에 15분을 추가하는 단계를 원하는 사람은 없습니다. 예를 들어 저희 자체 리포지토리에서는 이 평가가 필수 CI 단계이기 때문에, 느리면 전체 SDLC가 지연됩니다.
정확한 영향 평가를 만들어내는 데 저희에게 주어진 예산은 사실상 2~3분입니다. 그 이상은 CI/CD 파이프라인에서 받아들여질 수 없습니다.
저희의 첫 프로토타입은 이 제약을 완전히 충족하지 못했습니다. 중앙값이 거의 7분이었고, 20분까지 걸리는 실행도 흔했습니다.
목표는 전체 흐름을 3분 이내로 줄이기 위해 모델 스텝 수를 어떻게 줄일지 알아내는 것이 되었습니다. 저희는 보통 30~40개의 순차적인 모델 스텝을 실행했고, 최악의 경우에는 거의 600개에 달하는 스텝이 각각 17초씩 예산을 소모했으며, 그 출력의 대부분은 추론 토큰이었습니다.
지난 3주 동안 성능에 다양한 영향을 미친 여러 변경을 적용했습니다. 그중 가장 중요한 것들을 소개합니다.
스텝 예산을 설정하고 에이전트에 전달하기
저희는 에이전트 턴당 30스텝으로 제한된 스텝 예산을 도입했고, 모델에게 매 스텝마다 지금까지 몇 스텝을 소모했는지 명확히 전달합니다. 이 개수를 프롬프트에 넣어두면 모델이 그에 맞춰 계획을 세울 수 있는데, 이것이 개수 자체보다 더 중요하다는 것이 드러났습니다.
기존 리뷰에 접어 넣는 대신 새 리뷰를 시작하기
일반적인 풀 리퀘스트는 열린 후에도 계속 새 커밋이 추가됩니다. 첫 프로토타입에서는 새 diff 전체를 같은 리뷰 스레드 안에 유도용 사용자 메시지로 접어 넣었습니다. 이 유도 메시지는 모델을 크게 혼란스럽게 만들어, 이미 살펴본 파일을 다시 읽고 이미 끝낸 텔레메트리 쿼리를 다시 실행하게 만들었습니다.
이제는 새 커밋이 들어오면 이전 평가 실행을 취소하고 완전히 새로운 스레드를 시작합니다. 직관에 반하는 것처럼 보이지만, 결과적으로 완전한 리뷰의 지연 시간을 낮췄습니다.
이전 작업 재사용하기
리뷰가 이미 완료된 뒤 풀 리퀘스트에 새 커밋이 들어오면, 예전에는 단순하게 새로운 영향 평가를 처음부터 다시 시작했습니다.
저희는 이전 평가를 재사용하고, 연속된 두 커밋 사이의 더 작은 diff에 대해서만 새로운 평가를 트리거하는 기능을 도입했습니다.
저희는 9월 내내 이 변경들을 배포했고, 지연 시간을 점진적으로 개선해 이제는 예산 안에 여유 있게 들어옵니다.
이게 정말 중요할까요?
의미 있는 결과가 없다면 이 모든 토큰을 태우는 게 무슨 의미가 있을까요? 저희의 성공 지표는 고객마다 매주 예방하는 인시던트의 수입니다. 예방된 인시던트란 다음과 같은 풀 리퀘스트를 말합니다:
- 저희가 프로덕션에 대한 잠재적 위험을 표시합니다
- 엔지니어가 하나 이상의 커밋을 푸시합니다
- 새로운 평가에서 그 잠재적 위험이 완화되었다고 결론짓습니다
- 풀 리퀘스트가 병합됩니다
이는 이미 상당히 의미 있는 수치이며, 앞으로 계속 늘어날 것으로 예상합니다. 저희는 에이전트의 성능과 품질을 개선하기 위해 지속적으로 반복 작업을 하고 평가를 실행하고 있습니다.