

Come impediamo allo slop di arrivare in produzione
Explore with AI
Probabilmente stai costruendo una software factory oppure ne stai affittando una da un provider. Hai un sistema che ti porta da un prompt a una pull request. Gestisce test, linting, formattazione e code review automatizzate.
Ma non hai ancora una risposta alla domanda più importante: questa modifica va bene per andare in produzione?.
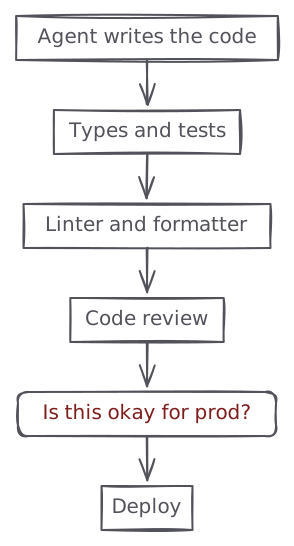
Tutti i tuoi controlli attuali guardano il diff, ma niente nella tua factory sa qualcosa sul sistema di produzione su cui il diff sta per finire. Niente può davvero impedire allo slop di arrivare in produzione.
Abbiamo costruito questa capacità dentro Polylane e questo articolo riguarda i dettagli tecnici di come l’abbiamo implementata.
Come funziona
La domanda a cui questo sistema deve rispondere è:
Questa modifica, una volta fatto il merge e il deploy, avrebbe un impatto negativo sulla produzione?
Non ci interessano davvero le cose tipiche che un agente di code review controllerebbe, come lo stile, la denominazione, la coverage dei test, ecc. E abbiamo deciso di rispondere a questa domanda nella fase della pull request, insieme a tutti i tuoi test esistenti.
Alla fine, Polylane commenta la pull request con un semplice messaggio “go” / “no-go” con le prove della sua indagine.
Il flusso è piuttosto semplice:
- Questa pull request tocca file che potrebbero avere un impatto sulla produzione?
- Quali risorse cloud sono potenzialmente colpite?
- Raccogliere il contesto sullo stato attuale della produzione per quelle risorse
- Valutare più potenziali modalità di guasto che questa modifica potrebbe introdurre
- Prevedere come la produzione potrebbe cambiare con queste modifiche distribuite
- Avvisare gli sviluppatori delle probabili modalità di guasto potenziali
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Tutto questo si basa sul context graph che costruiamo continuamente collegando tutte le risorse cloud nei tuoi vari account cloud.
Assemblare il contesto
Il nostro context graph è fondamentale per far funzionare tutto questo: costruisce un registro di tutte le tue risorse cloud, tutti i tuoi repository, team, ecc. Per esempio, un nodo di calcolo come una funzione Lambda è collegato al database da cui legge e alla coda che lo attiva. Aggiungiamo anche i repository al grafo. Questo viene fatto osservando i tipici file manifest nel repository, per esempio i file terraform, i file Cloudformation o i file Wrangler. Questo consente la connessione tra i repository e le risorse cloud.
Quando una pull request viene inviata al repository, seguiamo i percorsi sul context graph per raccogliere tutte le risorse cloud potenzialmente interessate dalla modifica. Usiamo un piccolo modello per filtrare le risorse, dato che potrebbero essercene un gran numero distribuite dallo stesso repository. Passiamo questo contesto insieme al diff, alla descrizione della PR e ai commit della PR all’agente.
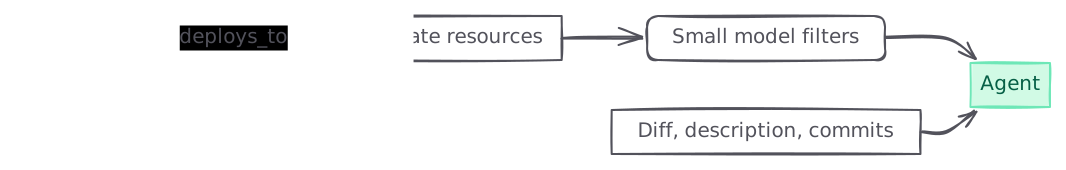
Passiamo anche il diff attraverso una serie di euristiche deterministiche per guidare rapidamente l’attenzione dell’agente verso le cose che di solito hanno probabilmente un impatto negativo sulla produzione:
- una migrazione che deve essere applicata manualmente, o in un ordine particolare rispetto al deploy
CREATE INDEXsenzaCONCURRENTLY, oppureADD COLUMN ... NOT NULLsenza un valore predefinito, entrambi i quali bloccano la tabella per tutta la durata dell’operazione- un endpoint che viene rimosso mentre la versione attualmente distribuita lo legge ancora
- codice che inizia a leggere una variabile d’ambiente, un secret o un binding che niente nel diff predispone
Queste sono raccomandazioni, che orientano l’agente verso probabili rischi di deployment.
Traiettorie di guasto
Con il contesto fornito sopra, il modello elabora varie modalità di guasto che il nuovo diff potrebbe introdurre in produzione e va a indagarle una per una.
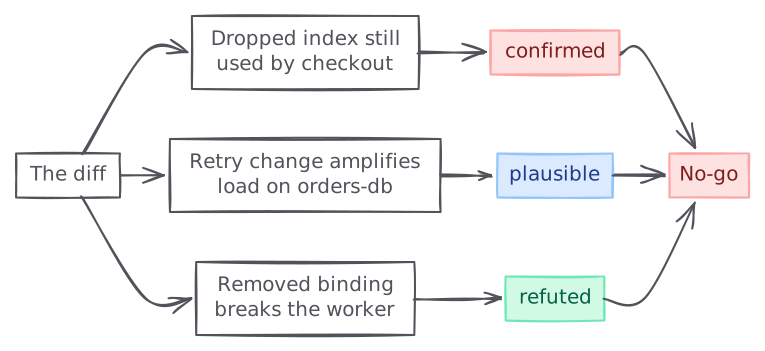
Il suo output è un registro di traiettorie di guasto. Una traiettoria è una catena causale che va da un trigger, attraverso il codice modificato, fino a un degrado osservabile su una metrica specifica, e ogni anello della catena porta una citazione: un file e una riga, un template di log con il suo conteggio, una lettura di metrica, una chiave di configurazione, un arco del grafo.
L’agente cerca sia di confermare sia di smentire ogni traiettoria prima di arrivare a un verdetto. Ognuna termina in uno di tre stati:
confirmedquando la traiettoria è stata confermata a fronte della produzione.plausiblequando la catena è concreta ma uno o più anelli hanno potuto solo essere “ipotizzati”, senza dati di telemetria a confermarli.refutedquando i dati di telemetria di produzione hanno fornito prove sufficienti che questa traiettoria è improbabile che avvenga in produzione.
Adottiamo un approccio conservativo: qualsiasi traiettoria confirmed porta a una valutazione fallita.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Prevedere l’impatto
Diamo all’agente uno strumento per prevedere serie temporali basate su dati storici, iniettando potenziali fattori esterni.
Supponiamo che una traiettoria affermi che una modifica dimezza il timeout su un percorso che effettua retry. Se questo conta davvero dipende dal traffico, e il traffico non è davvero un singolo numero, ha una forma. Una coda che sta al 60% di profondità e ci resta va bene. La stessa coda al 60% ma in crescita ogni settimana è una situazione diversa, e leggere l’ultima ora di metriche non ti dirà quale delle due stai osservando.
Quindi, prima che l’agente redigga il verdetto di una traiettoria, recupera le serie storiche per le risorse interessate e le prevede insieme. Attualmente ospitiamo autonomamente il modello Toto-2.0-22m.
Il motivo per cui usiamo un modello multivariato dedicato invece di un altro prompt è che le serie non sono indipendenti. Il request rate, l’error rate, la latenza e la profondità della coda su una risorsa si muovono insieme, e prevedere ciascuna separatamente butta via la correlazione che rende la previsione utile. Ogni serie in una chiamata condivide un unico gruppo di attenzione.
Questa è la capacità più sperimentale che abbiamo aggiunto di recente, e ne stiamo ancora misurando l’impatto. Ma passa già la vibes-eval.
Il vincolo di latenza
Eseguire la valutazione dell’impatto sulla produzione nel flusso della pull request significa che deve essere veloce. Nessuno vuole uno step che aggiunge 15 minuti alla propria pipeline CI. Per esempio, sui nostri stessi repository questa valutazione è uno step CI obbligatorio: se è lenta, tutto il nostro SDLC si blocca.
In pratica abbiamo un budget di 2-3 minuti per produrre una valutazione d’impatto accurata. Qualsiasi cosa oltre non è accettabile in una pipeline CI/CD.
Il nostro primo prototipo falliva completamente questo vincolo. La nostra mediana era di quasi 7 minuti ed era comune vedere run che arrivavano fino a 20 minuti.
L’obiettivo è diventato capire come ridurre il numero di step del modello per portare l’intero flusso sotto i 3 minuti. Tipicamente eseguivamo da 30 a 40 step sequenziali del modello, e negli scenari peggiori fino a quasi 600 step, ciascuno dei quali consumava 17 secondi del nostro budget, e la stragrande maggioranza del loro output erano token di reasoning.
Abbiamo fatto parecchi cambiamenti nelle ultime 3 settimane, con impatti diversi sulle performance. Ecco i più significativi.
Impostare un budget di step e comunicarlo all’agente
Abbiamo introdotto un budget di step, limitato a 30 step per turno dell’agente, e comunichiamo chiaramente al modello quanti step ha consumato a ogni step. Inserire il conteggio nel prompt permette al modello di pianificare di conseguenza, il che si rivela più importante del numero stesso.
Iniziare nuove review invece di integrarle in quella esistente
Una tipica pull request continua a ricevere nuovi commit dopo l’apertura. Nel primo prototipo, integravamo l’intero nuovo diff nello stesso thread di review come un messaggio utente di orientamento. Questo orientamento confondeva molto il modello e lo portava a rileggere file che aveva già esaminato e a rieseguire query di telemetria che aveva già completato.
Ora, un nuovo commit annulla la run di valutazione precedente e ne avvia una completamente nuova in un thread nuovo. Sembra controintuitivo, ma alla fine ha ridotto la latenza per le review complete.
Riutilizzare il lavoro precedente
Quando un nuovo commit arriva nella pull request dopo che una review era già stata completata, ingenuamente avviavamo una nuova valutazione dell’impatto da zero.
Abbiamo introdotto la possibilità di riutilizzare la valutazione precedente, e di avviare una nuova valutazione sul diff più piccolo tra i due commit consecutivi.
Abbiamo distribuito queste modifiche durante tutto il mese di settembre e abbiamo migliorato gradualmente la latenza, che ora rientra comodamente nel budget.
Ha davvero importanza?
A cosa serve bruciare tutti questi token se non vediamo risultati significativi? La nostra metrica di successo è il numero di incidenti che preveniamo ogni settimana per ciascuno dei nostri clienti. Un incidente prevenuto è una pull request in cui:
- segnaliamo un potenziale rischio per la produzione
- un engineer effettua il push di uno o più commit
- una nuova valutazione conclude che il rischio potenziale è stato mitigato
- la pull request viene sottoposta a merge
Questo è già piuttosto significativo e ci aspettiamo che continui a crescere. Stiamo continuamente iterando ed eseguendo eval per migliorare le performance e la qualità del nostro agente.