

Jak nie dopuszczamy słabego kodu do produkcji
Explore with AI
Prawdopodobnie budujesz własną fabrykę oprogramowania albo wynajmujesz ją od dostawcy. Masz system, który prowadzi cię od promptu do pull requestu. Obsługuje testy, linting, formatowanie i automatyczne przeglądy kodu.
Ale wciąż nie masz odpowiedzi na najważniejsze pytanie: czy ta zmiana może trafić na produkcję?.
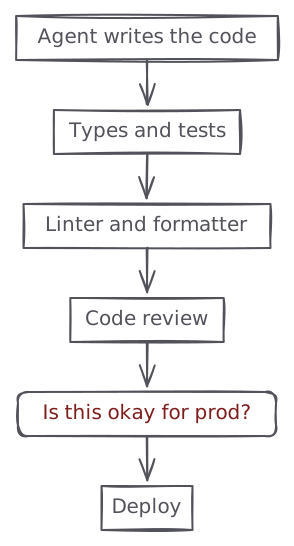
Wszystkie twoje obecne kontrole patrzą na diff, ale nic w twojej fabryce nie wie nic o systemie produkcyjnym, na który ten diff zaraz trafi. Nic naprawdę nie zapobiega temu, by słaby kod trafił na produkcję.
Zbudowaliśmy tę funkcję wewnątrz Polylane, a ten wpis opisuje szczegóły techniczne tego, jak ją wdrożyliśmy.
Jak to działa
Jedyne pytanie, na które ten system powinien odpowiedzieć, to:
Czy ta zmiana, po scaleniu i wdrożeniu, będzie miała negatywny wpływ na produkcję?
Tak naprawdę nie zależy nam na typowych rzeczach, które sprawdzałby agent do przeglądu kodu, takich jak styl, nazewnictwo, pokrycie testami itd. Postanowiliśmy odpowiadać na to pytanie już na etapie pull requestu, obok wszystkich twoich istniejących testów.
Ostatecznie Polylane dodaje komentarz do pull requestu z prostym werdyktem „go” / „no-go” wraz z dowodami z przeprowadzonego dochodzenia.
Przebieg jest dość prosty:
- Czy ten pull request dotyka plików, które mogą wpłynąć na produkcję?
- Które zasoby chmurowe są potencjalnie zagrożone?
- Zbierz kontekst o aktualnym stanie produkcji dla tych zasobów
- Oceń wiele potencjalnych trybów awarii, które ta zmiana może wprowadzić
- Przewiduj, jak produkcja może się zmienić po wdrożeniu tych zmian
- Ostrzeż programistów o prawdopodobnych potencjalnych trybach awarii
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Wszystko to opiera się na grafie kontekstu, który nieustannie budujemy, łącząc wszystkie zasoby chmurowe w twoich różnych kontach chmurowych.
Budowanie kontekstu
Nasz graf kontekstu jest kluczowy, by to działało: buduje rejestr wszystkich twoich zasobów chmurowych, wszystkich repozytoriów, zespołów itd. Na przykład węzeł obliczeniowy, taki jak funkcja Lambda, jest połączony z bazą danych, z której czyta, oraz kolejką, która go wyzwala. Dodajemy do grafu również repozytoria. Robimy to, analizując typowe pliki manifestów w repozytorium, na przykład pliki terraform, pliki Cloudformation czy pliki Wrangler. To umożliwia połączenie repozytoriów z zasobami chmurowymi.
Kiedy pull request trafia do repozytorium, podążamy ścieżkami w grafie kontekstu, by zebrać wszystkie zasoby chmurowe potencjalnie dotknięte tą zmianą. Używamy małych modeli do filtrowania zasobów, ponieważ z tego samego repozytorium może być wdrażana duża ich liczba. Przekazujemy ten kontekst wraz z diffem, opisem PR-a i commitami z PR-a agentowi.
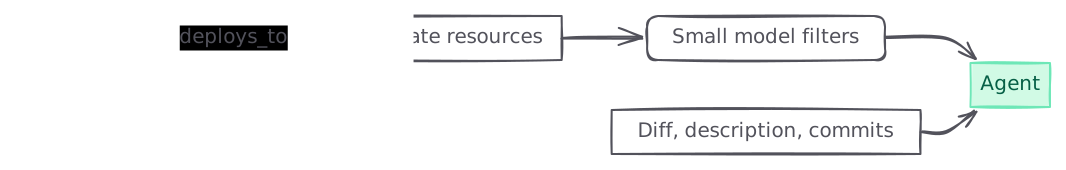
Przepuszczamy też diff przez zestaw deterministycznych heurystyk, które szybko kierują uwagę agenta na rzeczy, które zwykle mogą mieć negatywny wpływ na produkcję:
- migracja, którą trzeba zastosować ręcznie albo w określonej kolejności względem wdrożenia
CREATE INDEXbezCONCURRENTLY, alboADD COLUMN ... NOT NULLbez wartości domyślnej, co w obu przypadkach blokuje tabelę na cały czas trwania operacji- usuwany endpoint, mimo że obecnie wdrożona wersja wciąż z niego czyta
- kod, który zaczyna odczytywać zmienną środowiskową, sekret albo binding, którego nic w diffie nie tworzy
To są rekomendacje, które kierują agenta w stronę prawdopodobnych ryzyk wdrożenia.
Trajektorie awarii
Mając powyższy kontekst, model wymyśla różne tryby awarii, które nowy diff może wprowadzić na produkcji, i bada każdy z nich.
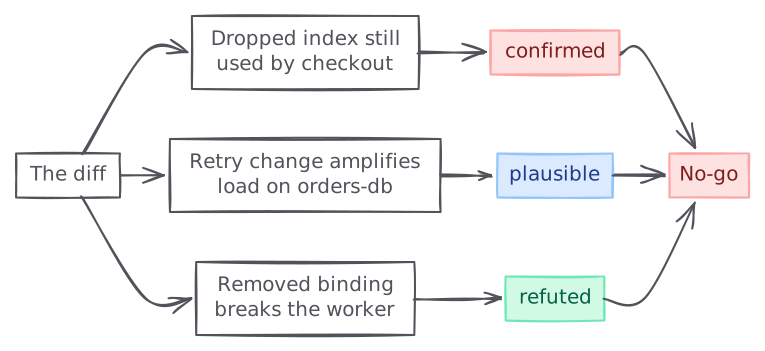
Jego wynikiem jest rejestr trajektorii awarii. Trajektoria to jeden łańcuch przyczynowy: od wyzwalacza, przez zmieniony kod, aż po obserwowalną degradację konkretnej metryki, a każde jego ogniwo niesie ze sobą cytat: plik i linię, szablon logu wraz z jego liczbą wystąpień, odczyt metryki, klucz konfiguracji, krawędź grafu.
Agent stara się zarówno potwierdzić, jak i obalić każdą trajektorię, zanim wyda werdykt. Każda kończy się jednym z trzech stanów:
confirmed, gdy trajektoria została potwierdzona względem produkcji.plausible, gdy łańcuch jest konkretny, ale jedno lub więcej ogniw dało się jedynie „odgadnąć”, bez danych telemetrycznych, które by je potwierdziły.refuted, gdy dane telemetryczne z produkcji dostarczyły wystarczających dowodów, że ta trajektoria jest mało prawdopodobna na produkcji.
Przyjmujemy podejście konserwatywne: każda trajektoria confirmed prowadzi do negatywnej oceny.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Prognozowanie wpływu
Dajemy agentowi narzędzie do prognozowania szeregów czasowych na podstawie danych historycznych, z możliwością uwzględnienia potencjalnych czynników zewnętrznych.
Powiedzmy, że trajektoria twierdzi, że jakaś zmiana zmniejsza o połowę timeout na ścieżce, która wykonuje ponowne próby. To, czy ma to znaczenie, zależy od ruchu, a ruch to nie pojedyncza liczba, tylko kształt. Kolejka utrzymująca się na poziomie 60% głębokości jest w porządku. Ta sama kolejka na poziomie 60%, ale rosnąca z tygodnia na tydzień, to zupełnie inna sytuacja, a odczyt metryk z ostatniej godziny nie powie ci, z którą z nich masz do czynienia.
Dlatego zanim agent sformułuje werdykt dla trajektorii, pobiera historyczne szeregi dla dotkniętych zasobów i prognozuje je razem. Obecnie hostujemy samodzielnie model Toto-2.0-22m.
Powód, dla którego używamy dedykowanego modelu wielowymiarowego zamiast kolejnego prompta, jest taki, że te szeregi nie są niezależne. Współczynnik żądań, współczynnik błędów, opóźnienie i głębokość kolejki dla jednego zasobu zmieniają się razem, a prognozowanie każdego z osobna odrzuca korelację, która sprawia, że prognoza w ogóle ma sens. Każdy szereg w jednym wywołaniu dzieli tę samą grupę uwagi.
To najbardziej eksperymentalna funkcja, którą ostatnio dodaliśmy, i wciąż mierzymy jej wpływ. Ale już przechodzi vibes-eval.
Ograniczenie opóźnienia
Uruchamianie oceny wpływu na produkcję w ramach przepływu pull requesta oznacza, że musi być szybkie. Nikt nie chce kroku, który dodaje 15 minut do pipeline’u CI. Na przykład w naszych własnych repozytoriach ta ocena jest wymaganym krokiem CI: jeśli jest wolna, cały nasz SDLC się zatyka.
Zasadniczo mamy budżet 2 do 3 minut na wygenerowanie dokładnej oceny wpływu. Wszystko powyżej tego jest nie do zaakceptowania w pipeline CI/CD.
Nasz pierwszy prototyp kompletnie nie spełniał tego ograniczenia. Mediana wynosiła prawie 7 minut, a nierzadko zdarzały się przebiegi trwające nawet 20 minut.
Celem stało się znalezienie sposobu na zmniejszenie liczby kroków modelu, tak by cały przepływ zmieścił się poniżej 3 minut. Zazwyczaj wykonywaliśmy 30 do 40 sekwencyjnych kroków modelu, a w najgorszych scenariuszach nawet blisko 600 kroków, z których każdy zużywał 17 sekund naszego budżetu, a zdecydowana większość ich wyniku stanowiły tokeny rozumowania.
W ciągu ostatnich 3 tygodni wprowadziliśmy sporo zmian o różnym wpływie na wydajność. Oto najważniejsze z nich.
Ustalenie budżetu kroków i komunikowanie go agentowi
Wprowadziliśmy budżet kroków, ograniczony do 30 kroków na turę agenta, i przy każdym kroku jasno komunikujemy modelowi, ile kroków już zużył. Umieszczenie licznika w prompcie pozwala modelowi zaplanować działania z jego uwzględnieniem, co okazuje się mieć większe znaczenie niż sama liczba.
Zaczynanie nowych przeglądów zamiast dokładania do istniejącego
Typowy pull request wciąż otrzymuje nowe commity po otwarciu. W pierwszym prototypie wciągaliśmy cały nowy diff do tego samego wątku przeglądu jako sterującą wiadomość użytkownika. Takie sterowanie mocno myliło model i prowadziło do ponownego czytania plików, które już zbadał, oraz ponownego uruchamiania zapytań telemetrycznych, które już wykonał.
Teraz nowy commit anuluje poprzedni przebieg oceny i zaczyna zupełnie nowy wątek. Wydaje się to nieintuicyjne, ale ostatecznie obniżyło opóźnienie dla kompletnych przeglądów.
Ponowne wykorzystanie wcześniejszej pracy
Kiedy w pull requeście pojawiał się nowy commit po tym, jak przegląd był już zakończony, naiwnie zaczynaliśmy nową ocenę wpływu od zera.
Wprowadziliśmy możliwość ponownego wykorzystania poprzedniej oceny i uruchamiania nowej oceny tylko dla mniejszego diffu między dwoma kolejnymi commitami.
Wdrażaliśmy te zmiany przez cały wrzesień, stopniowo poprawiając opóźnienie, które teraz wygodnie mieści się w budżecie.
Czy to w ogóle ma znaczenie?
Jaki jest sens spalania tych wszystkich tokenów, jeśli nie widzimy żadnych znaczących rezultatów? Naszą miarą sukcesu jest liczba incydentów, którym zapobiegamy tygodniowo u każdego z naszych klientów. Zapobiegnięty incydent to pull request, w którym:
- oznaczamy potencjalne ryzyko dla produkcji
- inżynier wypycha jeden lub więcej commitów
- nowa ocena stwierdza, że potencjalne ryzyko zostało złagodzone
- pull request zostaje scalony
To już całkiem sporo i spodziewamy się, że ta liczba będzie dalej rosnąć. Nieustannie iterujemy i uruchamiamy ewaluacje, by poprawiać wydajność i jakość naszego agenta.