

「スロップ」を本番環境に到達させない方法
Explore with AI
おそらく、ソフトウェアファクトリーを自社で構築しているか、プロバイダーからリースしているかのどちらかでしょう。プロンプトからプルリクエストまでを担うシステムがあり、テスト、リンティング、フォーマット、自動コードレビューを処理します。
しかし、最も重要な問い、この変更は本番環境に出しても大丈夫か、にはまだ答えがありません。
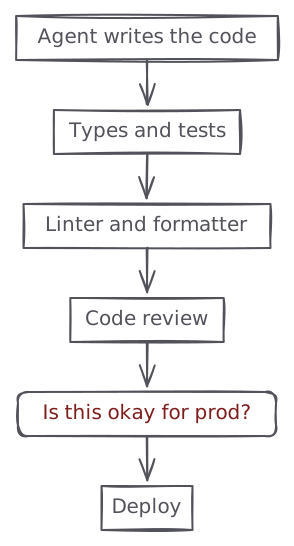
既存のチェックはすべて差分を見ていますが、ファクトリー内のどこにも、その差分がこれから適用される本番システムについて把握しているものはありません。スロップが本番環境に到達するのを実際に防ぐものは何もないのです。
私たちはこの機能をPolylaneの中に構築しました。この記事では、その実装方法の技術的な詳細について説明します。
仕組み
このシステムが答えるべき唯一の問いは、次のとおりです。
この変更は、マージされてデプロイされた場合、本番環境に悪影響を及ぼすでしょうか。
コードレビューエージェントが通常チェックするような、スタイル、命名、テストカバレッジなどには、私たちはあまり関心がありません。そして、この問いにはプルリクエストの段階で、既存のすべてのテストと並行して答えることにしました。
最終的に、Polylaneは調査の証拠とともに、シンプルな「go」または「no-go」のメッセージをプルリクエストにコメントします。
流れは至ってシンプルです。
- このプルリクエストは、本番環境に影響を与える可能性のあるファイルに触れているか
- どのクラウドリソースが影響を受ける可能性があるか
- それらのリソースについて、本番環境の現在の状態に関するコンテキストを収集する
- この変更が引き起こしうる複数の潜在的な障害モードを評価する
- これらの変更がデプロイされた場合に本番環境がどう変化しうるかを予測する
- 起こりうる障害モードについて開発者に警告する
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
これはすべて、様々なクラウドアカウント内のあらゆるクラウドリソースを結びつけながら継続的に構築しているContext graphに依存しています。
コンテキストの構築
私たちのContext graphがこれを可能にする鍵であり、あらゆるクラウドリソース、リポジトリ、チームなどのレジストリを構築します。例えば、Lambda Functionのようなコンピュートノードは、それが読み取るデータベースや、それをトリガーするキューと結びついています。リポジトリもグラフに追加します。これは、リポジトリ内にある典型的なマニフェストファイル、例えばTerraformファイル、CloudFormationファイル、Wranglerファイルなどを調べることで行われます。これにより、リポジトリとクラウドリソースの間の結びつきが可能になります。
プルリクエストがリポジトリに送信されると、Context graph上のパスをたどり、その変更によって影響を受ける可能性のあるすべてのクラウドリソースを収集します。同じリポジトリからデプロイされるリソースが大量にある場合があるため、小規模なモデルを使ってリソースを絞り込みます。このコンテキストを、差分、PRの説明、PR内のコミットとあわせてエージェントに渡します。
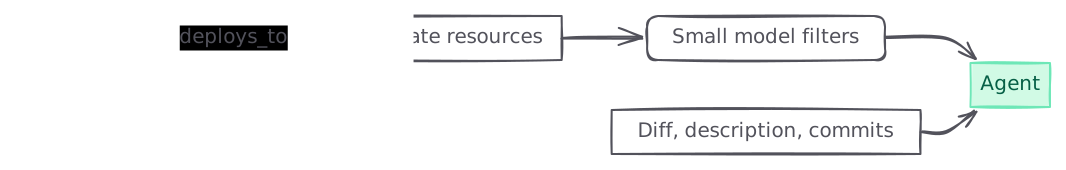
また、差分を一連の決定的なヒューリスティックにも通し、通常本番環境に悪影響を及ぼしやすい事柄へエージェントの注意を素早く向けさせます。
- 手動で適用する必要がある、あるいはデプロイに対して特定の順序で適用する必要があるマイグレーション
CONCURRENTLYを伴わないCREATE INDEXや、デフォルト値のないADD COLUMN ... NOT NULL。どちらもその間テーブルにロックをかけます- 現在デプロイされているバージョンがまだ読み取っているエンドポイントが削除されること
- 差分の中で何もプロビジョニングしていない環境変数、シークレット、またはバインディングを読み取り始めるコード
これらはあくまで推奨事項であり、エージェントを起こりうるデプロイのリスクへと導くものです。
障害のトラジェクトリー
上記のコンテキストを踏まえ、モデルは新しい差分が本番環境にもたらしうる様々な障害モードを考え出し、それぞれを調査します。
その出力は、障害のトラジェクトリーの台帳です。トラジェクトリーとは、トリガーから変更されたコードを経て、特定のメトリクスにおける観測可能な劣化に至る、1本の因果の連鎖です。その中のすべてのリンクには、ファイルと行、件数付きのログテンプレート、メトリクスの読み取り値、設定キー、グラフのエッジといった引用が付いています。
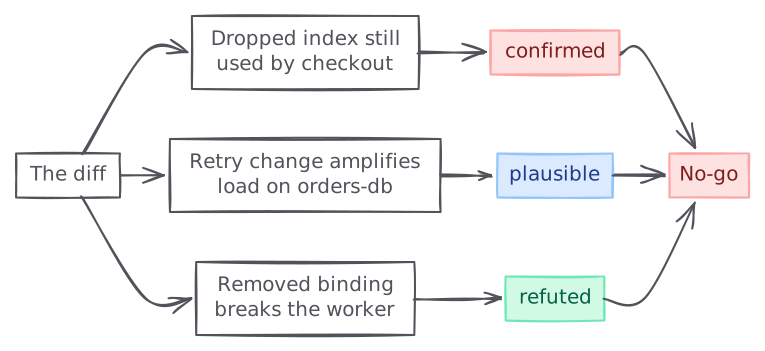
エージェントは判定を下す前に、それぞれのトラジェクトリーを検証し、また反証しようと試みます。各トラジェクトリーは3つの状態のいずれかで終わります。
- トラジェクトリーが本番環境に対して確認された場合の
confirmed。 - 連鎖は具体的だが、1つまたは複数のリンクを確認するテレメトリーデータがなく、「推測」するしかなかった場合の
plausible。 - 本番環境のテレメトリーデータが、このトラジェクトリーが本番環境で発生する可能性が低いことを示す十分な証拠を提供した場合の
refuted。
私たちは保守的なアプローチを取っており、confirmedのトラジェクトリーが1つでもあれば、評価は失敗となります。
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
影響の予測
エージェントには、潜在的な外部要因を注入しながら、過去のデータに基づいて時系列を予測するツールを与えています。
例えば、あるトラジェクトリーが、ある変更によってリトライするパスのタイムアウトが半減すると主張しているとします。それが重要かどうかはトラフィック次第であり、トラフィックは単一の数値ではなく、形を持っています。キューの深さが60%で安定している分には問題ありません。同じキューが60%でも、毎週上昇し続けているなら話は別です。直近1時間のメトリクスを見ただけでは、どちらの状況なのかは分かりません。
そのため、エージェントはトラジェクトリーの判定案を作成する前に、影響を受けるリソースの過去の系列を取得し、まとめて予測します。現在はToto-2.0-22mモデルを自前でホストしています。
別のプロンプトではなく専用の多変量モデルを使う理由は、系列が独立していないためです。1つのリソースにおけるリクエストレート、エラーレート、レイテンシー、キューの深さは連動して動くため、それぞれを個別に予測すると、予測を意味あるものにしている相関を捨ててしまうことになります。1回の呼び出しに含まれるすべての系列は、1つのアテンショングループを共有します。
これは最近追加した中で最も実験的な機能であり、その効果はまだ計測中です。しかし、すでに「vibes-eval」には合格しています。
レイテンシーの制約
プルリクエストのフロー内で本番環境への影響評価を実行するということは、それが高速でなければならないということです。CIパイプラインに15分も追加するステップを望む人はいません。例えば、私たち自身のリポジトリでは、この評価は必須のCIステップとなっており、遅ければSDLC全体が滞ってしまいます。
正確な影響評価を出すための予算は、実質2分から3分です。それを超えるものはCI/CDパイプラインでは許容できません。
最初のプロトタイプは、この制約を完全に満たせていませんでした。中央値は7分近くあり、実行に20分もかかることも珍しくありませんでした。
目標は、フロー全体を3分以内に収めるために、モデルのステップ数をいかに減らすかを見極めることになりました。通常は30から40の逐次的なモデルステップを実行しており、最悪のケースではほぼ600ステップに達することもありました。各ステップは予算のうち17秒を消費し、その出力の大部分は推論トークンでした。
過去3週間でかなりの数の変更を加え、パフォーマンスへの影響も様々でした。ここでは特に大きなものを紹介します。
ステップ予算を設定し、エージェントに伝える
エージェントのターンごとに30ステップを上限とするステップ予算を導入し、モデルには各ステップで自身が消費したステップ数を明確に伝えるようにしました。プロンプトにその数を含めることで、モデルはそれを見越して計画を立てられるようになり、これは数値そのものよりも重要だと分かりました。
既存のレビューに畳み込むのではなく、新しいレビューを開始する
典型的なプルリクエストでは、開いた後も新しいコミットが追加され続けます。最初のプロトタイプでは、新しい差分全体を、ステアリング用のユーザーメッセージとして同じレビュースレッドに畳み込んでいました。このステアリングはモデルを大きく混乱させ、すでに調べたファイルを再度読み込んだり、すでに完了したテレメトリークエリを再実行したりする原因になっていました。
現在では、新しいコミットが来ると前回の評価実行をキャンセルし、まったく新しいスレッドを開始します。直感に反するように思えますが、最終的にはレビュー全体のレイテンシーを引き下げる結果になりました。
以前の作業を再利用する
レビューがすでに完了した後にプルリクエストへ新しいコミットが加わると、以前は単純にゼロから新しい影響評価を開始していました。
以前の評価を再利用し、連続する2つのコミット間のより小さな差分に対して新しい評価をトリガーする機能を導入しました。
これらの変更を9月を通してデプロイし、レイテンシーを徐々に改善してきました。現在ではレイテンシーは予算内に余裕を持って収まっています。
これは本当に効果があるのか
意味のある結果が得られないのなら、これほど大量のトークンを消費する意味がどこにあるでしょうか。私たちの成功指標は、各顧客について週あたりに防いだインシデントの数です。防がれたインシデントとは、次のようなプルリクエストです。
- 本番環境への潜在的なリスクにフラグを立てる
- エンジニアが1つまたは複数のコミットをプッシュする
- 新しい評価により、その潜在的なリスクが軽減されたと結論づけられる
- プルリクエストがマージされる
これはすでにかなり大きな数字であり、今後も伸び続けると見込んでいます。私たちは継続的に反復し、評価を実行して、エージェントのパフォーマンスと品質の向上に取り組んでいます。