

เราป้องกัน slop ไม่ให้หลุดขึ้น prod ได้อย่างไร
Explore with AI
คุณอาจกำลังสร้าง software factory ของตัวเอง หรือไม่ก็เช่าใช้จากผู้ให้บริการ คุณมีระบบที่พาคุณจาก prompt ไปจนถึง pull request มันจัดการเรื่อง test, linting, การจัดรูปแบบโค้ด และการรีวิวโค้ดแบบอัตโนมัติ
แต่คุณก็ยังไม่มีคำตอบสำหรับคำถามที่สำคัญที่สุด: การเปลี่ยนแปลงนี้พร้อมขึ้น prod แล้วหรือยัง?
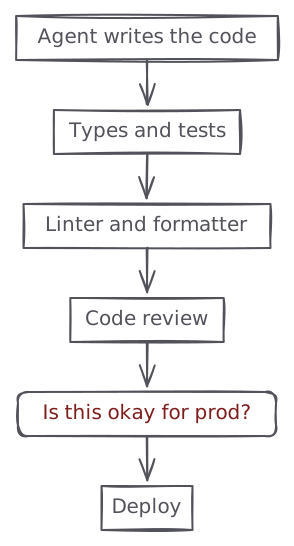
check ทั้งหมดที่คุณมีอยู่ในปัจจุบันมองแค่ diff แต่ไม่มีอะไรใน factory ของคุณที่รู้อะไรเลยเกี่ยวกับระบบ production ที่ diff นี้กำลังจะไปลงจริง ๆ แล้วไม่มีอะไรที่ป้องกัน slop ไม่ให้หลุดขึ้น prod ได้อย่างแท้จริง
เราสร้างความสามารถนี้ไว้ใน Polylane และโพสต์นี้จะพูดถึงรายละเอียดทางเทคนิคว่าเราทำมันขึ้นมาได้อย่างไร
วิธีการทำงาน
คำถามเดียวที่ระบบนี้ควรตอบได้คือ:
การเปลี่ยนแปลงนี้ เมื่อ merge และ deploy แล้ว จะส่งผลกระทบในทางลบต่อ production หรือไม่?
เราไม่ได้สนใจสิ่งทั่วไปที่เอเจนต์รีวิวโค้ดมักตรวจสอบ เช่น style, การตั้งชื่อ, test coverage และอื่น ๆ และเราตัดสินใจตอบคำถามนี้ที่ขั้นตอน pull request ควบคู่ไปกับ test ที่คุณมีอยู่แล้วทั้งหมด
ท้ายที่สุดแล้ว Polylane จะ comment บน pull request ด้วยข้อความ “go” / “no-go” ง่าย ๆ พร้อมหลักฐานจากการสืบสวนของมัน
flow นี้ค่อนข้างเรียบง่าย:
- pull request นี้แตะไฟล์ที่อาจส่งผลต่อ production หรือไม่?
- ทรัพยากรคลาวด์ใดบ้างที่อาจได้รับผลกระทบ?
- รวบรวม context เกี่ยวกับสถานะปัจจุบันของ production สำหรับทรัพยากรเหล่านั้น
- ประเมิน failure mode ที่เป็นไปได้หลายรูปแบบที่การเปลี่ยนแปลงนี้อาจก่อให้เกิดขึ้น
- พยากรณ์ว่า production อาจเปลี่ยนแปลงอย่างไรเมื่อ deploy การเปลี่ยนแปลงเหล่านี้
- แจ้งเตือนนักพัฒนาถึง failure mode ที่มีแนวโน้มจะเกิดขึ้น
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
ทั้งหมดนี้อาศัย context graph ที่เราสร้างขึ้นอย่างต่อเนื่องเพื่อเชื่อมโยงทรัพยากรคลาวด์ทั้งหมดในบัญชีคลาวด์ต่าง ๆ ของคุณ
การประกอบ context
context graph ของเราเป็นกุญแจสำคัญที่ทำให้สิ่งนี้ทำงานได้ มันสร้าง registry ของทรัพยากรคลาวด์ทั้งหมด repository ทั้งหมด ทีมต่าง ๆ และอื่น ๆ ของคุณ ตัวอย่างเช่น compute node อย่าง Lambda function จะเชื่อมโยงกับฐานข้อมูลที่มันอ่านข้อมูล และ queue ที่ trigger มัน เรายังเพิ่ม repository เข้าไปในกราฟด้วย ทำได้โดยการดู manifest file ทั่วไปใน repository เช่นไฟล์ terraform ไฟล์ Cloudformation หรือไฟล์ Wrangler สิ่งนี้ทำให้เกิดการเชื่อมโยงระหว่าง repository กับทรัพยากรคลาวด์
เมื่อมีการส่ง pull request เข้ามาที่ repository เราจะตาม path บน context graph เพื่อรวบรวมทรัพยากรคลาวด์ทั้งหมดที่อาจได้รับผลกระทบจากการเปลี่ยนแปลงนี้ เราใช้โมเดลขนาดเล็กในการกรองทรัพยากรเหล่านี้ เนื่องจากอาจมีทรัพยากรจำนวนมากที่ deploy มาจาก repository เดียวกัน เราส่ง context นี้พร้อมกับ diff คำอธิบาย PR และ commit ใน PR ไปให้เอเจนต์
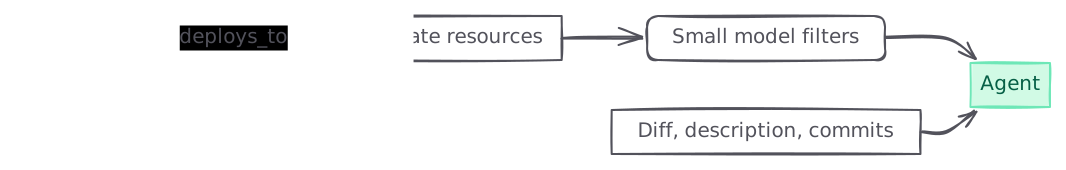
เรายังส่ง diff ผ่านชุด heuristic แบบ deterministic เพื่อชี้นำความสนใจของเอเจนต์ไปยังสิ่งที่มักจะส่งผลกระทบในทางลบต่อ production ได้อย่างรวดเร็ว:
- migration ที่ต้องรันด้วยมือ หรือต้องรันตามลำดับที่เฉพาะเจาะจงสัมพันธ์กับ deploy
CREATE INDEXโดยไม่มีCONCURRENTLYหรือADD COLUMN ... NOT NULLที่ไม่มีค่า default ซึ่งทั้งสองแบบจะล็อกตารางตลอดระยะเวลาที่ทำงาน- endpoint ที่ถูกลบออกไปในขณะที่เวอร์ชันที่ deploy อยู่ในปัจจุบันยังคงอ่านมันอยู่
- โค้ดที่เริ่มอ่าน environment variable, secret หรือ binding ที่ไม่มีอะไรใน diff จัดเตรียมไว้ให้
สิ่งเหล่านี้เป็นคำแนะนำที่ชี้นำเอเจนต์ไปยังความเสี่ยงที่อาจเกิดขึ้นจากการ deploy
เส้นทางความล้มเหลว
จาก context ที่ให้ไว้ข้างต้น โมเดลจะคิดหา failure mode ต่าง ๆ ที่ diff ใหม่นี้อาจก่อให้เกิดขึ้นใน production แล้วไปสืบสวนแต่ละอัน
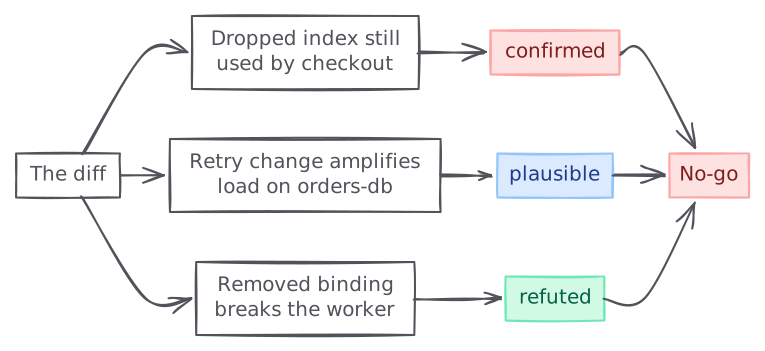
ผลลัพธ์ของมันคือบัญชีรายการของเส้นทางความล้มเหลว เส้นทางหนึ่งคือห่วงโซ่เชิงเหตุผลหนึ่งเส้น ที่เริ่มจาก trigger ผ่านโค้ดที่ถูกเปลี่ยนแปลง ไปจนถึงความเสื่อมถอยที่สังเกตเห็นได้ใน metric หนึ่งตัว และทุกจุดเชื่อมโยงในเส้นทางนั้นมีการอ้างอิงกำกับ: ไฟล์และบรรทัด, log template พร้อมจำนวนครั้งที่เกิด, ค่าที่อ่านได้จาก metric, config key, เส้นเชื่อมในกราฟ
เอเจนต์จะพยายามทั้งยืนยันและหักล้างแต่ละเส้นทางก่อนที่จะสรุปเป็นคำตัดสิน แต่ละเส้นทางจะจบลงในสถานะใดสถานะหนึ่งจากสามสถานะนี้:
confirmedเมื่อเส้นทางนั้นได้รับการยืนยันกับ production แล้วplausibleเมื่อห่วงโซ่นั้นชัดเจน แต่มีจุดเชื่อมโยงหนึ่งจุดหรือมากกว่านั้นที่ทำได้เพียง “เดา” โดยไม่มีข้อมูล telemetry มายืนยันrefutedเมื่อข้อมูล telemetry จาก production มีหลักฐานเพียงพอว่าเส้นทางนี้ไม่น่าจะเกิดขึ้นใน production
เราใช้แนวทางที่ระมัดระวัง และเส้นทางที่เป็น confirmed ใด ๆ จะนำไปสู่ผลการประเมินที่ไม่ผ่าน
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
การพยากรณ์ผลกระทบ
เราให้เครื่องมือแก่เอเจนต์สำหรับพยากรณ์ timeseries โดยอิงจากข้อมูลย้อนหลัง พร้อมกับการใส่ปัจจัยภายนอกที่อาจเกิดขึ้น
สมมติว่าเส้นทางหนึ่งอ้างว่าการเปลี่ยนแปลงบางอย่างลด timeout ลงครึ่งหนึ่งบน path ที่มีการ retry ว่าสิ่งนี้สำคัญหรือไม่ขึ้นอยู่กับ traffic และ traffic ไม่ใช่แค่ตัวเลขตัวเดียว มันมีรูปทรงของมันเอง queue ที่อยู่ที่ความลึก 60% แล้วคงที่อยู่แบบนั้นถือว่าไม่มีปัญหา แต่ queue เดียวกันที่ 60% แต่เพิ่มขึ้นทุกสัปดาห์เป็นสถานการณ์ที่ต่างออกไป และการอ่าน metric แค่ชั่วโมงล่าสุดจะไม่บอกคุณว่ากำลังเจอสถานการณ์ไหนอยู่
ดังนั้นก่อนที่เอเจนต์จะร่างคำตัดสินของเส้นทางหนึ่ง มันจะดึงข้อมูล series ย้อนหลังของทรัพยากรที่ได้รับผลกระทบ แล้วพยากรณ์รวมกัน ปัจจุบันเรา self-host Toto-2.0-22m model
เหตุผลที่เราใช้โมเดล multivariate โดยเฉพาะแทนที่จะใช้ prompt อีกอันหนึ่งก็คือ series เหล่านี้ไม่ได้เป็นอิสระต่อกัน request rate, error rate, latency และ queue depth บนทรัพยากรเดียวกันเคลื่อนไหวไปด้วยกัน และการพยากรณ์แต่ละตัวแยกกันจะทิ้งความสัมพันธ์ที่ทำให้การพยากรณ์นั้นมีค่าไป ทุก series ใน call เดียวกันจะใช้ attention group เดียวกัน
นี่คือความสามารถที่มีลักษณะทดลองมากที่สุดที่เราเพิ่งเพิ่มเข้ามา และเรายังคงวัดผลกระทบของมันอยู่ แต่มันก็ผ่าน vibes-eval ไปแล้ว
ข้อจำกัดด้าน latency
การรัน production impact assessment ใน flow ของ pull request หมายความว่ามันต้องเร็ว ไม่มีใครอยากได้ขั้นตอนที่เพิ่มเวลาอีก 15 นาทีให้กับ CI pipeline ของตัวเอง ยกตัวอย่างเช่น ใน repository ของเราเอง การประเมินนี้เป็นขั้นตอน CI ที่จำเป็น ถ้ามันช้า SDLC ทั้งหมดของเราก็จะติดขัด
โดยพื้นฐานแล้วเรามีงบเวลา 2 ถึง 3 นาทีในการสร้างการประเมินผลกระทบที่แม่นยำ อะไรก็ตามที่เกินกว่านั้นถือว่ายอมรับไม่ได้ใน CI/CD pipeline
prototype แรกของเราล้มเหลวต่อข้อจำกัดนี้อย่างสิ้นเชิง median ของเราอยู่ที่เกือบ 7 นาที และเป็นเรื่องปกติที่จะเห็น run บางอันใช้เวลาถึง 20 นาที
เป้าหมายจึงกลายเป็นการหาวิธีลดจำนวน step ของโมเดลลง เพื่อให้ flow ทั้งหมดใช้เวลาไม่เกิน 3 นาที โดยทั่วไปเรารัน step ของโมเดลแบบต่อเนื่องกัน 30 ถึง 40 step และในกรณีที่แย่ที่สุดอาจสูงถึงเกือบ 600 step แต่ละ step ใช้เวลา 17 วินาทีจากงบเวลาของเรา และผลลัพธ์ส่วนใหญ่ของมันคือ reasoning token
เราทำการเปลี่ยนแปลงหลายอย่างตลอด 3 สัปดาห์ที่ผ่านมา ซึ่งส่งผลต่อ performance ในระดับที่แตกต่างกัน ต่อไปนี้คือการเปลี่ยนแปลงที่สำคัญที่สุด
การกำหนดงบ step และสื่อสารให้เอเจนต์ทราบ
เราได้กำหนดงบ step โดยจำกัดไว้ที่ 30 step ต่อ turn ของเอเจนต์ และเราสื่อสารให้โมเดลทราบอย่างชัดเจนว่ามันใช้ step ไปแล้วกี่ step ในทุก ๆ step การใส่จำนวนนี้ไว้ใน prompt ทำให้โมเดลวางแผนรอบตัวเลขนี้ได้ ซึ่งกลายเป็นว่าสำคัญกว่าตัวเลขเองเสียอีก
เริ่มการรีวิวใหม่แทนที่จะรวมเข้ากับการรีวิวเดิม
pull request ทั่วไปมักจะได้รับ commit ใหม่เพิ่มเข้ามาเรื่อย ๆ หลังจากถูกเปิดขึ้น ใน prototype แรก เราจะรวม diff ใหม่ทั้งหมดเข้าไปใน review thread เดียวกัน ในรูปแบบข้อความ steering จากผู้ใช้ การ steer แบบนี้ทำให้โมเดลสับสนอย่างมาก และนำไปสู่การอ่านไฟล์ที่มันตรวจสอบไปแล้ว และรัน telemetry query ที่มันทำเสร็จไปแล้วซ้ำอีกครั้ง
ตอนนี้ commit ใหม่จะยกเลิกการรันประเมินก่อนหน้า และเริ่มเธรดใหม่ทั้งหมด ฟังดูขัดกับสัญชาตญาณ แต่ท้ายที่สุดแล้วมันช่วยลด latency ของการรีวิวที่สมบูรณ์ลงได้
การนำงานก่อนหน้ากลับมาใช้ใหม่
เมื่อมี commit ใหม่เข้ามาใน pull request หลังจากการรีวิวเสร็จสิ้นไปแล้ว แต่ก่อนเราจะเริ่มการประเมินผลกระทบใหม่ตั้งแต่ต้นแบบไม่ได้คิดอะไรมาก
เราได้เพิ่มความสามารถในการนำการประเมินก่อนหน้ากลับมาใช้ใหม่ และ trigger การประเมินใหม่บน diff ที่เล็กกว่าระหว่าง commit สองอันที่ติดกัน
เรา deploy การเปลี่ยนแปลงเหล่านี้ตลอดเดือนกันยายน และค่อย ๆ ปรับปรุง latency ให้ดีขึ้น จนตอนนี้ latency อยู่ในงบเวลาได้อย่างสบาย ๆ
สิ่งนี้สำคัญจริงหรือไม่?
การเผา token เหล่านี้ทั้งหมดจะมีประโยชน์อะไรถ้าเราไม่เห็นผลลัพธ์ที่มีความหมาย? metric ความสำเร็จของเราคือจำนวน incident ที่เราป้องกันได้ต่อสัปดาห์สำหรับลูกค้าแต่ละราย incident ที่ถูกป้องกันได้คือ pull request ที่:
- เราตั้งข้อสังเกตความเสี่ยงที่อาจเกิดขึ้นต่อ production
- วิศวกร push commit หนึ่งหรือหลาย commit
- การประเมินใหม่สรุปว่าความเสี่ยงที่อาจเกิดขึ้นนั้นได้รับการบรรเทาแล้ว
- pull request นั้นถูก merge
ตัวเลขนี้ถือว่ามีนัยสำคัญพอสมควรแล้ว และเราคาดว่ามันจะเติบโตขึ้นเรื่อย ๆ เรากำลัง iterate และรัน eval อย่างต่อเนื่องเพื่อปรับปรุง performance และคุณภาพของเอเจนต์ของเรา