

Hvordan vi hindrer at slop havner i produksjon
Explore with AI
Du bygger sannsynligvis enten en programvarefabrikk eller leier en fra en leverandør. Du har et system som tar deg fra en prompt til en pull request. Det håndterer tester, linting, formatering og automatiserte kodegjennomganger.
Men du har fortsatt ikke svar på det viktigste spørsmålet: er denne endringen trygg å sende til produksjon?.
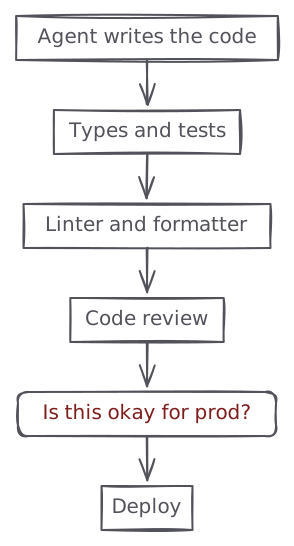
Alle sjekkene du har i dag ser på diffen, men ingenting i fabrikken din vet noe om produksjonssystemet diffen skal inn i. Ingenting kan egentlig hindre at slop havner i produksjon.
Vi bygde denne funksjonen inn i Polylane, og dette innlegget handler om de tekniske detaljene i hvordan vi implementerte den.
Slik fungerer det
Det ene spørsmålet dette systemet skal svare på, er:
Ville denne endringen, når den er slått sammen og deployet, hatt en negativ innvirkning på produksjonen?
Vi bryr oss egentlig ikke om de typiske tingene en kodegjennomgangsagent ville sjekket, som stil, navngiving, testdekning osv. Og vi bestemte oss for å svare på dette spørsmålet på pull request-stadiet, side om side med alle testene dine fra før.
Til slutt kommenterer Polylane på pull requesten med en enkel «go» / «no-go»-melding, sammen med belegget fra undersøkelsen.
Flyten er ganske enkel:
- Rører denne pull requesten filer som kan påvirke produksjonen?
- Hvilke skyressurser er potensielt påvirket?
- Samle kontekst om nåværende tilstand i produksjon for disse ressursene
- Vurder flere potensielle feilmodus denne endringen kan introdusere
- Forutsi hvordan produksjonen kan endre seg når disse endringene er deployet
- Varsle utviklere om de sannsynlige potensielle feilmodusene
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
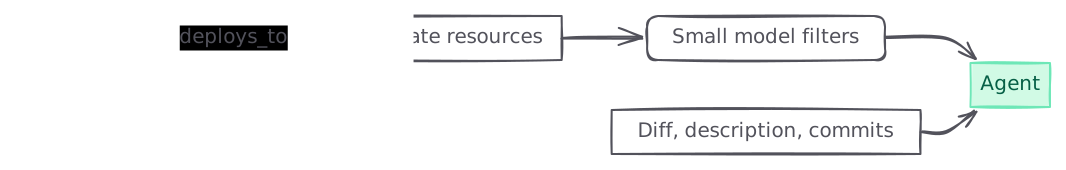
Alt dette er avhengig av kontekstgrafen vi kontinuerlig bygger, som kobler sammen alle skyressursene i de ulike skykontoene dine.
Sette sammen konteksten
Kontekstgrafen vår er nøkkelen til at dette fungerer. Den bygger et register over alle skyressursene dine, alle repositoriene dine, team og så videre. En compute-node som en Lambda-funksjon er for eksempel koblet til databasen den leser fra og køen som trigger den. Vi legger også repositorier til grafen. Dette gjøres ved å se på de typiske manifestfilene i repositoryet, for eksempel terraform-filer, Cloudformation-filer eller Wrangler-filer. Dette gjør det mulig å koble repositorier til skyressurser.
Når en pull request sendes inn til repositoryet, følger vi stiene i kontekstgrafen for å samle inn alle skyressursene som potensielt er påvirket av endringen. Vi bruker en liten modell til å filtrere gjennom ressursene, siden det kan være et stort antall ressurser deployet fra samme repository. Vi sender denne konteksten sammen med diffen, PR-beskrivelsen og commitene i PR-en til agenten.
Vi sender også diffen gjennom et sett med deterministiske heuristikker for raskt å styre agentens oppmerksomhet mot ting som vanligvis er sannsynlige å ha negativ innvirkning på produksjonen:
- en migrasjon som må kjøres for hånd, eller i en bestemt rekkefølge i forhold til deployen
CREATE INDEXutenCONCURRENTLY, ellerADD COLUMN ... NOT NULLuten standardverdi, som begge låser tabellen for varigheten- et endepunkt som fjernes mens den nåværende deployede versjonen fortsatt leser det
- kode som begynner å lese en miljøvariabel, hemmelighet eller binding som ingenting i diffen provisjonerer
Dette er anbefalinger som styrer agenten mot sannsynlige deployrisikoer.
Feiltrajektorier
Med konteksten gitt ovenfor, kommer modellen opp med ulike feilmodus den nye diffen kan introdusere i produksjon, og undersøker hver av dem.
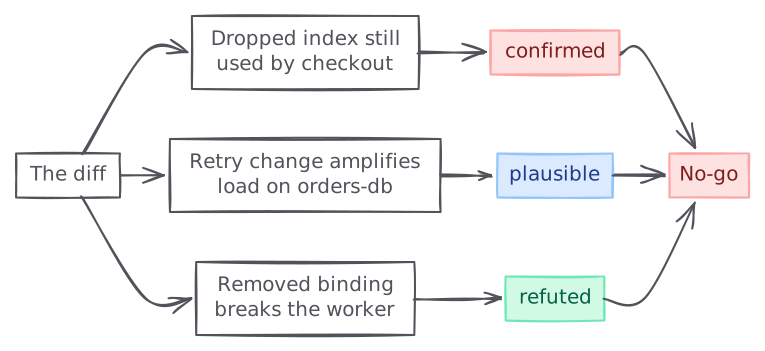
Resultatet er en oversikt over feiltrajektorier. En trajektorie er en kausal kjede fra en trigger, gjennom den endrede koden, til en observerbar forringelse i en bestemt metrikk, og hver lenke i den har en referanse: en fil og linje, en loggmal med telling, en metrikkverdi, en konfigurasjonsnøkkel, en kant i grafen.
Agenten prøver både å bekrefte og avkrefte hver trajektorie før den kommer til en konklusjon. Hver ender i en av tre tilstander:
confirmednår trajektorien er bekreftet mot produksjon.plausiblenår kjeden er konkret, men en eller flere lenker bare kunne «gjettes» uten telemetridata som bekreftet det.refutednår telemetridata fra produksjon ga nok bevis til at denne trajektorien er lite sannsynlig å skje i produksjon.
Vi tar en konservativ tilnærming, og enhver confirmed-trajektorie fører til en avvist vurdering.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Forutsi konsekvensen
Vi gir agenten et verktøy til å forutsi tidsserier basert på historiske data, med mulighet til å injisere potensielle eksterne faktorer.
Si at en trajektorie hevder at en endring halverer timeouten på en sti som gjør nye forsøk. Om det spiller noen rolle, avhenger av trafikken, og trafikk er egentlig ikke et enkelt tall, den har en form. En kø som ligger på 60 % dybde og blir værende der, er greit. Den samme køen på 60 %, men som klatrer hver uke, er en annen situasjon, og å lese den siste timen med metrikker vil ikke fortelle deg hvilken av dem du ser på.
Så før agenten utkaster konklusjonen for en trajektorie, henter den den historiske serien for de påvirkede ressursene og forutsier dem sammen. Vi selv-hoster for øyeblikket Toto-2.0-22m-modellen.
Grunnen til at vi bruker en dedikert multivariat modell fremfor enda en prompt, er at seriene ikke er uavhengige. Forespørselsrate, feilrate, ventetid og kødybde for én ressurs beveger seg sammen, og å forutsi hver for seg kaster bort korrelasjonen som gjør prognosen verdt å ha. Hver serie i et kall deler én attention-gruppe.
Dette er den mest eksperimentelle funksjonen vi nylig har lagt til, og vi måler fortsatt innvirkningen. Men den består allerede vibes-evalen.
Latensbegrensningen
Å kjøre produksjonskonsekvensvurderingen i pull request-flyten betyr at den må være rask. Ingen vil ha et steg som legger til 15 minutter i CI-pipelinen sin. På våre egne repositorier er for eksempel denne vurderingen et påkrevd CI-steg. Er den treg, stopper hele SDLC-en vår opp.
Vi har i praksis et budsjett på 2 til 3 minutter for å produsere en nøyaktig konsekvensvurdering. Alt utover det er ikke akseptabelt i en CI/CD-pipeline.
Vår første prototype feilet fullstendig på denne begrensningen. Medianen vår var på nesten 7 minutter, og det var vanlig å se kjøringer ta opptil 20 minutter.
Målet ble å finne ut hvordan vi kunne redusere antallet modellsteg for å få hele flyten under 3 minutter. Vi kjørte typisk 30 til 40 sekvensielle modellsteg, og i verste fall opptil nesten 600 steg, hvert forbrukende 17 sekunder av budsjettet vårt, og størstedelen av outputen deres var reasoning-tokens.
Vi gjorde en rekke endringer i løpet av de siste 3 ukene, med ulik innvirkning på ytelsen. Her er de mest betydningsfulle.
Sette et stegbudsjett og kommunisere det til agenten
Vi innførte et stegbudsjett, satt til maks 30 steg per agentrunde, og vi kommuniserer tydelig til modellen hvor mange steg den har brukt på hvert steg. Å sette antallet i prompten lar modellen planlegge rundt det, noe som viser seg å bety mer enn selve tallet.
Starte nye gjennomganger i stedet for å flette inn i den eksisterende
En typisk pull request fortsetter å få nye commits etter at den er åpnet. I den første prototypen flettet vi hele den nye diffen inn i den samme gjennomgangstråden som en styrende brukermelding. Denne styringen forvirret modellen kraftig og førte til at den leste filer den allerede hadde undersøkt, og kjørte telemetrispørringer på nytt som den allerede hadde fullført.
Nå avbryter en ny commit den forrige vurderingskjøringen og starter en helt ny tråd. Det virker kontraintuitivt, men det senket til slutt latensen for komplette gjennomganger.
Gjenbruke tidligere arbeid
Når en ny commit havner i pull requesten etter at en gjennomgang allerede var fullført, pleide vi naivt å starte en ny konsekvensvurdering fra bunnen av.
Vi innførte muligheten til å gjenbruke den forrige vurderingen, og utløse en ny vurdering på den mindre diffen mellom de to påfølgende commitene.
Vi deployet disse endringene gjennom september og har gradvis forbedret latensen, og latensen ligger nå komfortabelt innenfor budsjettet.
Betyr dette egentlig noe?
Hva er poenget med å brenne alle disse tokenene hvis vi ikke ser noen meningsfulle resultater? Suksessmetrikken vår er antall hendelser vi forhindrer per uke for hver av kundene våre. En forhindret hendelse er en pull request der:
- vi flagger en potensiell risiko for produksjonen
- en ingeniør pusher én eller flere commits
- en ny vurdering konkluderer med at den potensielle risikoen er redusert
- pull requesten blir slått sammen
Dette er allerede ganske betydelig, og vi forventer at det vil fortsette å vokse. Vi itererer kontinuerlig og kjører evalueringer for å forbedre ytelsen og kvaliteten på agenten vår.