

我們如何防止劣質程式碼上線到生產環境
Explore with AI
你現在可能正在打造一套軟體工廠,或是向某個供應商租用一套。你擁有一套系統,能從一個 prompt 直接產出一個 pull request。它會處理測試、linting、格式化,以及自動化的程式碼審查。
但你仍然沒有回答最重要的問題:這個變更真的可以上線到生產環境嗎?。
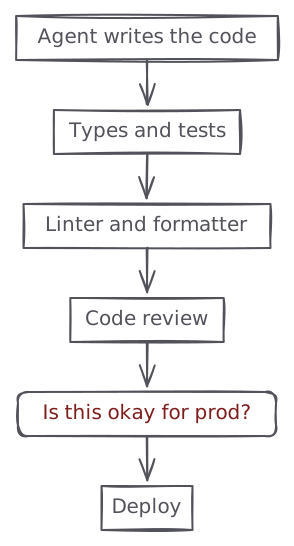
你現有的所有檢查都只看 diff 本身,但你的工廠裡沒有任何一環真正了解這個 diff 即將落地的生產系統。沒有任何機制能真正防止劣質程式碼流入生產環境。
我們把這項能力打造進 Polylane 之中,這篇文章要談的就是我們如何實作它的技術細節。
運作方式
這套系統該回答的唯一問題是:
這個變更一旦合併並部署之後,會不會對生產環境造成負面影響?
我們並不在乎一般程式碼審查代理會檢查的那些事,例如風格、命名、測試涵蓋率等等。我們決定在 pull request 階段回答這個問題,與你現有的所有測試並行。
最終,Polylane 會在 pull request 留言,給出簡單的「go」/「no-go」訊息,並附上調查得到的證據。
整體流程相當簡單:
- 這個 pull request 是否觸及可能影響生產環境的檔案?
- 哪些雲端資源可能受到影響?
- 蒐集這些資源目前在生產環境中的狀態情境
- 評估這個變更可能引入的多種潛在故障模式
- 預測這些變更部署後生產環境可能出現的變化
- 提醒開發者可能出現的潛在故障模式
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
這一切都仰賴我們持續建置的 Context graph,它會串連起你各個雲端帳戶中的所有雲端資源。
組裝情境資訊
我們的 Context graph 是讓這一切運作起來的關鍵,它會建立一份登錄清單,涵蓋你所有的雲端資源、所有儲存庫、團隊等等。舉例來說,像 Lambda 函式這樣的運算節點,會連結到它讀取的資料庫,以及觸發它的佇列。我們也會把儲存庫加進圖中,作法是檢視儲存庫裡典型的 manifest 檔案,例如 terraform 檔案、Cloudformation 檔案或 Wrangler 檔案。這樣就能建立起儲存庫與雲端資源之間的連結。
當一個 pull request 被提交到儲存庫時,我們會沿著 Context graph 上的路徑,蒐集所有可能受這個變更影響的雲端資源。因為同一個儲存庫底下部署的資源數量可能非常多,我們會用一個小模型來篩選這些資源。接著我們會把這份情境資訊,連同 diff、PR 描述以及 PR 中的提交,一起傳給代理。
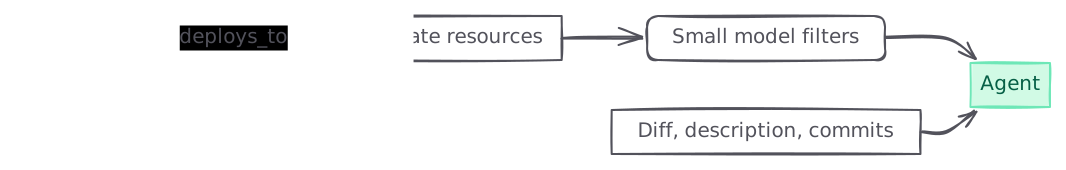
我們也會讓 diff 通過一組確定性的啟發式規則,快速引導代理把注意力放在通常容易對生產環境造成負面影響的地方:
- 必須手動套用的資料庫遷移,或是必須依照特定順序相對於部署來執行的遷移
- 沒有加上
CONCURRENTLY的CREATE INDEX,或是沒有預設值的ADD COLUMN ... NOT NULL,這兩者都會在執行期間鎖住該資料表 - 某個端點被移除了,但目前部署中的版本仍在讀取它
- 程式碼開始讀取某個環境變數、密鑰或綁定,但 diff 裡完全沒有配置它
這些只是建議,用來引導代理去注意可能的部署風險。
故障軌跡
有了上述提供的情境資訊,模型會提出這個新 diff 可能在生產環境中引入的各種故障模式,並逐一進行調查。
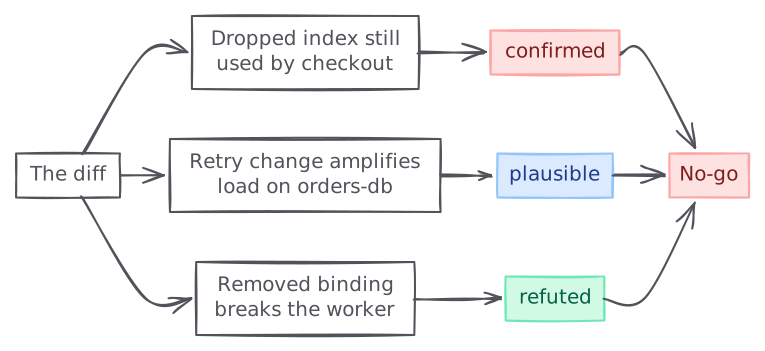
它的輸出是一份故障軌跡的清單。一條軌跡代表一條因果鏈,從某個觸發點開始,經過變更後的程式碼,一路連到某個指標上可觀察到的劣化,而鏈中的每一個環節都附帶引用來源:一個檔案與行號、一則附帶次數的日誌樣板、一次指標讀數、一個設定鍵,或是圖中的一條邊。
代理會嘗試同時驗證與推翻每一條軌跡,之後才做出判定。每一條軌跡最終會落在以下三種狀態之一:
confirmed:這條軌跡已經在生產環境中獲得確認。plausible:整條鏈是具體的,但其中一或多個環節只能靠「猜測」,沒有遙測資料可以確認。refuted:生產環境的遙測資料提供了足夠證據,顯示這條軌跡在生產環境中不太可能發生。
我們採取保守的做法,只要有任何一條 confirmed 的軌跡,整份評估就會判定為失敗。
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
預測影響
我們給代理一個工具,可以根據歷史資料來預測時間序列,並注入可能的外部因素。
假設某條軌跡宣稱某個變更把某條會重試的路徑的逾時時間砍半。這重不重要,取決於流量,而流量並不是單一一個數字,它有自己的形狀。一個佇列深度停在 60% 且維持不變是沒問題的。同樣是 60%,但每週都在攀升的佇列,情況就完全不同,而只看最近一小時的指標,你根本分不清眼前是哪一種情況。
所以在代理針對一條軌跡草擬判定之前,它會先拉出受影響資源的歷史序列,並把它們放在一起做預測。我們目前自行架設了 Toto-2.0-22m model。
之所以使用專門的多變量模型,而不是再多加一個 prompt,是因為這些序列彼此並不獨立。同一個資源上的請求率、錯誤率、延遲與佇列深度會一起變動,如果各自獨立預測,就會丟失讓這份預測真正有價值的相關性。每一次呼叫中的所有序列,都共用同一個注意力群組。
這是我們最近加入、最具實驗性質的能力,我們仍在衡量它的實際影響。不過它已經通過了我們的 vibes-eval(憑感覺判斷是否可靠的測試)。
延遲限制
把生產環境影響評估放進 pull request 流程裡,代表它必須夠快。沒有人希望一個步驟讓 CI 管線多花 15 分鐘。舉例來說,在我們自己的儲存庫裡,這項評估是 CI 的必要步驟,只要它變慢,我們整個 SDLC 就會被拖慢。
我們基本上只有 2 到 3 分鐘的預算,用來產出準確的影響評估。超過這個時間,在 CI/CD 管線裡就是不能接受的。
我們的第一版原型完全達不到這個限制。中位數接近 7 分鐘,而且常常看到有些執行要花到 20 分鐘。
目標變成要想辦法減少模型步驟數,把整個流程壓到 3 分鐘以內。我們原本典型會跑 30 到 40 個循序的模型步驟,最糟的情況甚至接近 600 步,每一步都會消耗我們預算裡的 17 秒,而這些輸出裡絕大多數都是推理 token。
過去 3 週我們做了不少變更,對效能造成程度不一的影響。以下是其中最重要的幾項。
設定步驟預算,並告知代理
我們引入了一個步驟預算,每個代理回合上限為 30 步,並且在每一步都清楚告訴模型它已經用掉了多少步。把這個計數放進 prompt 裡,能讓模型據此規劃,而這件事本身,其實比預算數字大小更重要。
開啟新的審查,而不是併入既有的審查
一個典型的 pull request 在開啟後,會持續收到新的提交。在第一版原型裡,我們會把整個新的 diff,以一則引導用的使用者訊息,併入同一個審查對話串裡。這種引導方式會嚴重讓模型混亂,導致它重新讀取已經檢視過的檔案,並重複執行已經跑過的遙測查詢。
現在,一個新的提交會取消前一次的評估執行,並開啟一個全新的對話串。這聽起來有點違反直覺,但最終確實降低了完整審查的延遲。
重複使用先前的結果
當一個審查已經完成,之後又有新的提交進到這個 pull request 時,我們過去的做法是很單純地從頭開始一次全新的影響評估。
我們新增了重複使用先前評估結果的能力,只針對前後兩次連續提交之間較小的 diff,觸發一次新的評估。
我們在整個 9 月陸續部署了這些變更,延遲逐步改善,目前已經穩穩落在預算之內。
這真的有差嗎?
如果看不到有意義的成果,燒掉這麼多 token 又有什麼意義?我們衡量成功的指標,是每週為每一位客戶防止掉的事件數量。一個被防止的事件,指的是這樣的一個 pull request:
- 我們標記出對生產環境的潛在風險
- 工程師推送一次或多次提交
- 新的一次評估判定該潛在風險已經被緩解
- 這個 pull request 被合併
這已經相當可觀,而且我們預期這個數字會持續成長。我們會持續反覆迭代並執行評估,來提升代理的效能與品質。