

我们如何防止劣质代码进入生产环境
Explore with AI
你很可能正在自建一套软件工厂,或者从某个提供商那里租用一套。你有一套系统,能把你从一条提示词带到一个拉取请求。它会处理测试、代码检查、格式化,以及自动化代码审查。
但你仍然没有回答那个最重要的问题:这个变更能不能上生产环境?
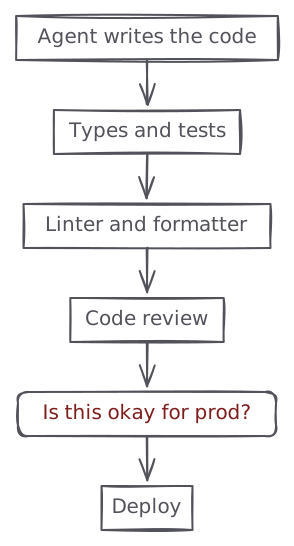
你现在所有的检查都只看diff,但你的工厂里没有任何一环真正了解这个diff即将落地的生产系统。没有什么能真正阻止劣质代码进入生产环境。
我们在Polylane内部构建了这项能力,这篇文章将介绍我们实现它的技术细节。
工作原理
这套系统应该回答的唯一问题是:
这个变更一旦合并并部署,是否会对生产环境产生负面影响?
我们并不关心一个代码审查智能体通常会检查的那些东西,比如风格、命名、测试覆盖率等等。我们决定在拉取请求阶段回答这个问题,与你现有的所有测试一起进行。
最终,Polylane会在拉取请求上留下一条简单的“go”/“no-go”评论,并附上调查过程中的凭据。
整个流程相当简单:
- 这个拉取请求是否改动了可能影响生产环境的文件?
- 哪些云资源可能受到影响?
- 收集这些资源当前生产状态的上下文
- 评估这次变更可能引入的多种潜在故障模式
- 预测这些变更部署后生产环境可能发生的变化
- 就可能出现的潜在故障模式向开发者发出告警
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
这一切都依赖于我们持续构建的context graph,它将你各个云账户中的所有云资源连接起来。
组装上下文
我们的context graph是让这一切成为可能的关键,它构建了一份注册表,记录你所有的云资源、所有的仓库、团队等等。举例来说,一个计算节点,比如Lambda函数,会与它读取的数据库、以及触发它的队列相连接。我们也会把仓库加入到图中,方法是查看仓库里那些典型的清单文件,比如terraform文件、Cloudformation文件或者Wrangler文件。这样就实现了仓库与云资源之间的连接。
当一个拉取请求提交到仓库时,我们会沿着context graph上的路径,收集这次变更可能影响到的所有云资源。由于同一个仓库可能部署了大量资源,我们会用一个小模型对这些资源进行过滤。然后我们把这份上下文,连同diff、PR描述和PR中的提交,一起传给智能体。
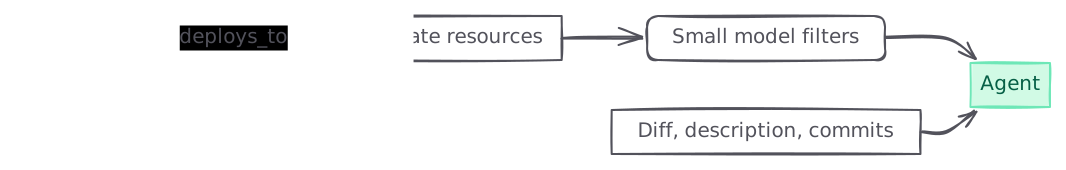
我们还会让diff经过一组确定性的启发式规则,快速把智能体的注意力引导到那些通常可能对生产环境产生负面影响的地方:
- 需要手动执行、或者必须相对部署按特定顺序执行的迁移
- 不带
CONCURRENTLY的CREATE INDEX,或者没有默认值的ADD COLUMN ... NOT NULL,这两者都会在执行期间对表加锁 - 一个端点被移除,而当前部署的版本仍在读取它
- 代码开始读取某个环境变量、secret或binding,而diff中并没有为它做任何配置
这些只是建议,用来引导智能体去关注可能存在的部署风险。
故障轨迹
基于上面提供的上下文,模型会构想出这次新diff可能给生产环境带来的各种故障模式,并逐一进行调查。
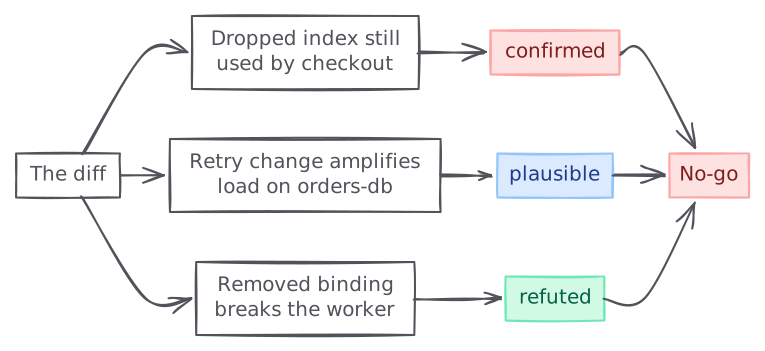
它的输出是一份故障轨迹的清单。一条轨迹,就是一条因果链:从某个触发因素开始,经过被改动的代码,最终导致某个具体指标出现可观测的劣化,链条上的每一环都带有引用:一个文件和行号、一个带计数的日志模板、一次指标读数、一个配置键、一条图中的边。
在给出判定之前,智能体会尝试对每一条轨迹既做验证又做证伪。每条轨迹最终会落在以下三种状态之一:
confirmed(已确认):轨迹已经在生产环境中得到确认。plausible(可能):链条具体明确,但其中一环或多环只能靠“猜测”得出,没有遥测数据加以确认。refuted(已证伪):生产环境的遥测数据提供了足够的证据,表明这条轨迹在生产环境中不太可能发生。
我们采取保守的策略,任何一条confirmed轨迹都会导致评估判定为失败。
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
预测影响
我们给智能体提供了一个工具,用来基于历史数据预测时间序列,并可以注入潜在的外部因素。
假设某条轨迹声称,某个变更把一条会重试的路径上的超时时间减半了。这件事重不重要,取决于流量,而流量并不是一个单一的数字,它有自己的形状。一个队列深度稳定停在60%是没问题的。同样是60%,但每周都在攀升的队列,情况就完全不同了,只看最近一小时的指标,你分辨不出你面对的是哪一种情况。
所以在智能体为一条轨迹起草判定之前,它会拉取受影响资源的历史序列,并把它们放在一起进行预测。我们目前自行托管Toto-2.0-22m model。
之所以用一个专门的多变量模型,而不是再写一个提示词,是因为这些序列并不是相互独立的。同一个资源上的请求速率、错误率、延迟和队列深度会一起变化,如果把它们分开单独预测,就会丢失让这次预测真正有价值的相关性。一次调用中的每一条序列都共享同一个注意力组。
这是我们最近新增的、最具实验性的能力,我们仍在评估它的实际效果。不过它已经通过了“vibes-eval”。
延迟约束
在拉取请求流程中运行生产影响评估,意味着它必须够快。没有人希望自己的CI流水线因为多出这一步而增加15分钟。举例来说,在我们自己的仓库里,这项评估是一个必需的CI步骤,如果它很慢,我们整个SDLC都会被拖慢。
我们基本上只有2到3分钟的预算,用来产出一份准确的影响评估。超过这个时间,在CI/CD流水线里就无法接受。
我们的第一版原型完全达不到这个约束。中位数将近7分钟,运行耗时高达20分钟的情况也很常见。
目标变成了:想办法减少模型步骤的数量,把整个流程压缩到3分钟以内。我们通常会连续运行30到40个模型步骤,最坏情况下甚至接近600步,每一步都要消耗我们预算里的17秒,而这些步骤的输出,绝大部分都是推理token。
过去3周里,我们做了不少改动,对性能的影响各不相同。下面是其中最重要的几项。
设定步骤预算,并把它告知智能体
我们引入了一个步骤预算,每个智能体轮次上限为30步,并且在每一步都清楚地告诉模型它已经消耗了多少步。把这个计数放进提示词里,能让模型据此做规划,事实证明,这比数字本身更重要。
开启新的审查,而不是并入已有的审查
一个典型的拉取请求在打开之后,会不断收到新的提交。在第一版原型中,我们会把整个新的diff作为一条引导性的用户消息,并入同一条审查线程。这种引导会让模型产生很大的困惑,导致它重新读取已经检查过的文件,重新运行已经完成过的遥测查询。
现在,一个新的提交会取消上一次的评估运行,并开启一条全新的线程。这看起来有悖直觉,但最终却降低了完整审查的延迟。
复用之前的工作
当一次审查已经完成之后,如果拉取请求里又有新的提交进来,我们过去的做法是简单粗暴地从头开始一次新的影响评估。
我们引入了复用上一次评估的能力,只针对前后两次提交之间那个更小的diff,触发一次新的评估。
我们在整个9月陆续部署了这些改动,延迟被逐步改善,如今已经稳稳落在预算之内。
这一切真的有意义吗?
如果看不到任何有意义的结果,烧掉这么多token又有什么意义呢?我们的成功指标,是每周为每个客户避免的故障数量。一次被避免的故障,指的是这样一个拉取请求:
- 我们标记出一个可能影响生产环境的风险
- 工程师推送一次或多次提交
- 新的评估得出结论,认为这个潜在风险已经得到缓解
- 该拉取请求被合并
这个数字已经相当可观,而且我们预计它会继续增长。我们仍在持续迭代,并不断运行评估,以提升我们智能体的性能和质量。