

Cómo evitamos que el slop llegue a producción
Explore with AI
Probablemente estés construyendo una fábrica de software o alquilando una a un proveedor. Tienes un sistema que te lleva de un prompt a un pull request. Se encarga de los tests, el linting, el formato y las revisiones de código automatizadas.
Pero todavía no tienes respuesta a la pregunta más importante: ¿este cambio está bien para ir a prod?.
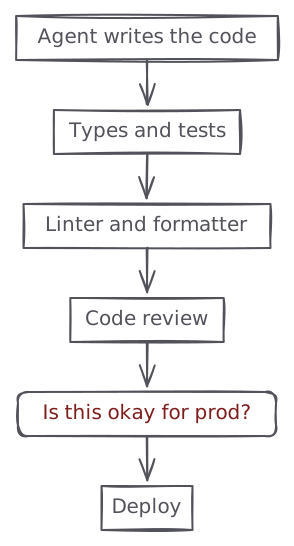
Todas tus comprobaciones actuales miran el diff, pero nada en tu fábrica sabe nada sobre el sistema de producción en el que ese diff está por aterrizar. Nada puede realmente evitar que el slop llegue a prod.
Construimos esta capacidad dentro de Polylane y este post trata sobre los detalles técnicos de cómo la implementamos.
Cómo funciona
La única pregunta que este sistema debería responder es:
¿Este cambio, una vez fusionado y desplegado, tendría un impacto negativo en producción?
No nos importan mucho las cosas típicas que comprobaría un agente de revisión de código, como el estilo, los nombres, la cobertura de tests, etc. Y decidimos responder esta pregunta en la etapa del pull request, junto con todos tus tests existentes.
En última instancia, Polylane comenta en el pull request con un simple mensaje de “go” / “no-go” junto con las pruebas de su investigación.
El flujo es bastante simple:
- ¿Este pull request toca archivos que puedan afectar a producción?
- ¿Qué recursos de nube podrían verse afectados?
- Reunir contexto sobre el estado actual de producción para esos recursos
- Evaluar varios modos de fallo potenciales que este cambio podría introducir
- Pronosticar cómo podría cambiar producción con estos cambios desplegados
- Alertar a los desarrolladores de los posibles modos de fallo probables
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Todo esto se apoya en el context graph que construimos continuamente conectando todos los recursos de nube en tus diferentes cuentas de nube.
Ensamblando el contexto
Nuestro context graph es clave para que esto funcione: construye un registro de todos tus recursos de nube, todos tus repositorios, equipos, etc. Por ejemplo, un nodo de cómputo como una Lambda function está conectado a la base de datos de la que lee y a la cola que la dispara. También añadimos repositorios al grafo. Esto se hace revisando los archivos de manifiesto típicos del repositorio, por ejemplo archivos de terraform, archivos de Cloudformation o archivos de Wrangler. Esto habilita la conexión entre repositorios y recursos de nube.
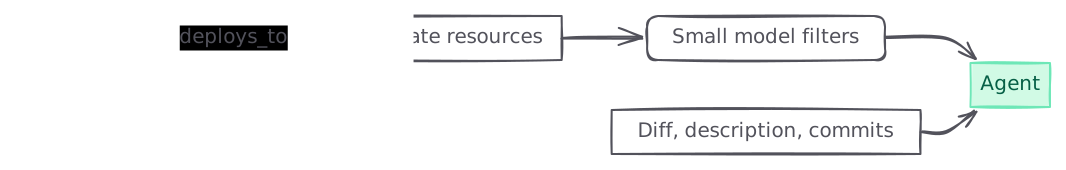
Cuando se envía un pull request al repositorio, seguimos los caminos en el context graph para reunir todos los recursos de nube potencialmente afectados por el cambio. Usamos un modelo pequeño para filtrar los recursos, ya que puede haber una gran cantidad de recursos desplegados desde el mismo repositorio. Pasamos este contexto junto con el diff, la descripción del PR y los commits del PR al agente.
También pasamos el diff por un conjunto de heurísticas deterministas para guiar rápidamente la atención del agente hacia cosas que normalmente tienden a tener un impacto negativo en producción:
- una migración que debe aplicarse a mano, o en un orden particular respecto al despliegue
CREATE INDEXsinCONCURRENTLY, oADD COLUMN ... NOT NULLsin valor por defecto, ambos casos bloquean la tabla durante todo el proceso- un endpoint que se elimina mientras la versión actualmente desplegada todavía lo lee
- código que empieza a leer una variable de entorno, un secreto o un binding que nada en el diff provisiona
Estas son recomendaciones que orientan al agente hacia posibles riesgos de despliegue.
Trayectorias de fallo
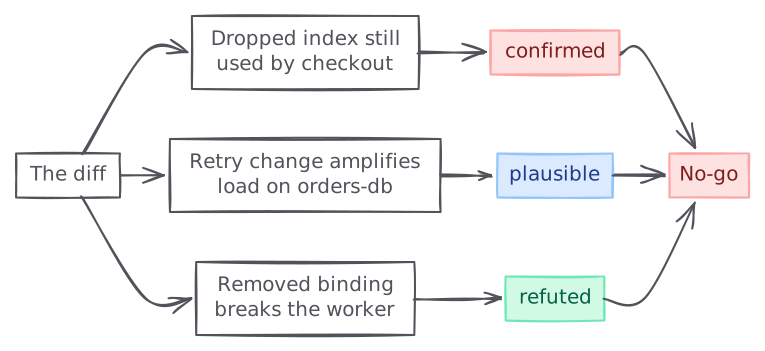
Con el contexto que se proporciona arriba, el modelo propone varios modos de fallo que el nuevo diff podría introducir en producción, y va e investiga cada uno.
Su salida es un registro de trayectorias de fallo. Una trayectoria es una cadena causal que va desde un disparador, a través del código modificado, hasta una degradación observable en una métrica específica, y cada eslabón lleva una cita: un archivo y una línea, una plantilla de log con su recuento, una lectura de métrica, una clave de configuración, una arista del grafo.
El agente intenta tanto validar como invalidar cada trayectoria antes de llegar a un veredicto. Cada una termina en uno de tres estados:
confirmedcuando la trayectoria se confirmó contra producción.plausiblecuando la cadena es concreta pero uno o varios eslabones solo pudieron “suponerse” sin datos de telemetría que lo confirmen.refutedcuando los datos de telemetría de producción aportaron suficiente evidencia de que esta trayectoria es poco probable que ocurra en producción.
Adoptamos un enfoque conservador, y cualquier trayectoria confirmed lleva a una evaluación fallida.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Pronosticando el impacto
Le damos al agente una herramienta para pronosticar series de tiempo a partir de datos históricos, inyectando posibles factores externos.
Supongamos que una trayectoria afirma que cierto cambio reduce a la mitad el timeout en una ruta que reintenta. Que esto importe depende del tráfico, y el tráfico no es realmente un solo número, tiene una forma. Una cola que se mantiene en un 60% de profundidad y se queda ahí está bien. La misma cola al 60% pero subiendo cada semana es una situación distinta, y leer la última hora de métricas no te dirá cuál de las dos estás viendo.
Así que antes de que el agente redacte el veredicto de una trayectoria, extrae las series históricas de los recursos afectados y las pronostica en conjunto. Actualmente alojamos nosotros mismos el modelo Toto-2.0-22m.
La razón de usar un modelo multivariado dedicado en lugar de otro prompt es que las series no son independientes. La tasa de peticiones, la tasa de errores, la latencia y la profundidad de la cola en un mismo recurso se mueven juntas, y pronosticar cada una por separado descarta la correlación que hace que el pronóstico valga la pena. Cada serie de una llamada comparte un mismo grupo de atención.
Esta es la capacidad más experimental que agregamos recientemente, y todavía estamos midiendo su impacto. Pero ya pasa la vibes-eval.
La restricción de latencia
Ejecutar la evaluación de impacto en producción dentro del flujo del pull request significa que tiene que ser rápida. Nadie quiere un paso que añada 15 minutos a su pipeline de CI. Por ejemplo, en nuestros propios repositorios esta evaluación es un paso obligatorio de CI: si es lenta, todo nuestro SDLC se atasca.
Básicamente tenemos un presupuesto de 2 a 3 minutos para producir una evaluación de impacto precisa. Cualquier cosa que supere eso no es aceptable en un pipeline de CI/CD.
Nuestro primer prototipo fallaba por completo esta restricción. Nuestra mediana rondaba los 7 minutos, y era común ver ejecuciones que tomaban hasta 20 minutos.
El objetivo pasó a ser averiguar cómo reducir la cantidad de pasos del modelo para lograr que todo el flujo bajara de 3 minutos. Normalmente ejecutábamos entre 30 y 40 pasos secuenciales del modelo, y en los peores casos hasta casi 600 pasos, cada uno consumiendo 17 segundos de nuestro presupuesto, y la gran mayoría de su salida eran tokens de razonamiento.
Hicimos bastantes cambios en las últimas 3 semanas, con distintos impactos en el rendimiento. Estos son los más significativos.
Establecer un presupuesto de pasos y comunicárselo al agente
Introdujimos un presupuesto de pasos, limitado a 30 pasos por turno del agente, y en cada paso comunicamos claramente al modelo cuántos pasos ha consumido. Poner el recuento en el prompt le permite al modelo planificar en torno a él, y eso resulta importar más que el número en sí.
Empezar revisiones nuevas en lugar de plegarlas en la existente
Un pull request típico sigue recibiendo nuevos commits después de abrirse. En el primer prototipo, plegábamos todo el diff nuevo en el mismo hilo de revisión como un mensaje de usuario que redirigía el rumbo. Esa redirección confundía muchísimo al modelo y lo llevaba a leer archivos que ya había examinado y a volver a ejecutar consultas de telemetría que ya había completado.
Ahora, un commit nuevo cancela la ejecución de evaluación anterior y empieza un hilo completamente nuevo. Parece contraintuitivo, pero al final redujo la latencia de las revisiones completas.
Reutilizar el trabajo previo
Cuando un commit nuevo llega al pull request después de que una revisión ya se completó, antes empezábamos ingenuamente una nueva evaluación de impacto desde cero.
Introdujimos la capacidad de reutilizar la evaluación anterior, y de disparar una nueva evaluación sobre el diff más pequeño entre los dos commits consecutivos.
Desplegamos estos cambios a lo largo de septiembre y fuimos mejorando la latencia de forma gradual, hasta que ahora se ubica cómodamente dentro del presupuesto.
¿Esto realmente importa?
¿Cuál es el punto de quemar todos estos tokens si no vemos resultados significativos? Nuestra métrica de éxito es la cantidad de incidentes que evitamos por semana para cada uno de nuestros clientes. Un incidente evitado es un pull request donde:
- señalamos un riesgo potencial para producción
- un ingeniero envía uno o varios commits
- una nueva evaluación concluye que el riesgo potencial está mitigado
- el pull request se fusiona
Esto ya es bastante significativo y esperamos que siga creciendo. Iteramos de forma continua y ejecutamos evals para mejorar el rendimiento y la calidad de nuestro agente.