

Üretime baştan savma kodun gitmesini nasıl önlüyoruz
Explore with AI
Muhtemelen ya kendi yazılım fabrikanı kuruyorsun ya da bir sağlayıcıdan kiralıyorsun. Seni bir prompttan pull request’e götüren bir sistemin var. Bu sistem testleri, linting’i, biçimlendirmeyi ve otomatik kod incelemelerini hallediyor.
Ama en önemli soruya hâlâ bir cevabın yok: bu değişiklik üretime gitmek için uygun mu?.
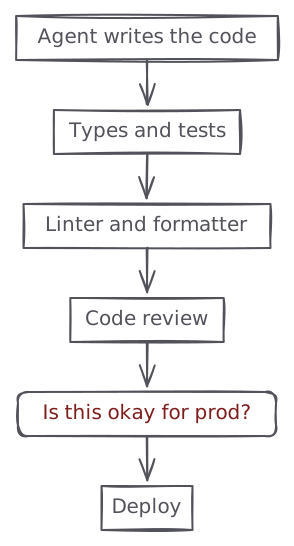
Şu anki tüm kontrollerin diff’e bakıyor, ama fabrikandaki hiçbir şey diff’in ineceği üretim sistemi hakkında bir şey bilmiyor. Hiçbir şey baştan savma kodun üretime gitmesini gerçekten engelleyemiyor.
Bu özelliği Polylane içinde geliştirdik, bu yazı da bunu nasıl uyguladığımızın teknik detaylarını anlatıyor.
Nasıl çalışıyor
Bu sistemin cevaplaması gereken tek soru şu:
Bu değişiklik birleştirilip dağıtıldığında üretime olumsuz bir etkisi olur mu?
Bir kod inceleme ajanının kontrol edeceği stil, isimlendirme, test kapsamı gibi tipik şeyleri gerçekten önemsemiyoruz. Bu soruyu, mevcut tüm testlerinin yanı sıra, pull request aşamasında cevaplamaya karar verdik.
Sonuçta Polylane, incelemesinin kanıtlarıyla birlikte pull request’e basit bir “git” / “gitme” mesajı yazıyor.
Akış oldukça basit:
- Bu pull request üretimi etkileyebilecek dosyalara dokunuyor mu?
- Hangi bulut kaynakları potansiyel olarak etkileniyor?
- Bu kaynaklar için üretimin mevcut durumuna dair bağlam topla
- Bu değişikliğin ortaya çıkarabileceği birden fazla olası hata modunu değerlendir
- Bu değişiklikler dağıtıldığında üretimin nasıl değişebileceğini öngör
- Geliştiricileri olası hata modları konusunda uyar
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Bunların hepsi, çeşitli bulut hesaplarındaki tüm bulut kaynaklarını birbirine bağlayarak sürekli oluşturduğumuz bağlam grafiğine dayanıyor.
Bağlamı bir araya getirmek
Bağlam grafiğimiz bunun çalışmasının anahtarı, tüm bulut kaynaklarının, tüm depolarının, ekiplerinin vb. bir kaydını oluşturuyor. Örneğin, Lambda fonksiyonu gibi bir hesaplama düğümü, okuduğu veritabanına ve onu tetikleyen kuyruğa bağlanır. Depoları da grafiğe ekliyoruz. Bu, depodaki tipik manifest dosyalarına bakılarak yapılıyor, örneğin terraform dosyaları, Cloudformation dosyaları veya Wrangler dosyaları. Bu, depolar ile bulut kaynakları arasındaki bağlantıyı sağlıyor.
Depoya bir pull request gönderildiğinde, değişiklikten potansiyel olarak etkilenen tüm bulut kaynaklarını toplamak için bağlam grafiğindeki yolları takip ediyoruz. Aynı depodan dağıtılan çok sayıda kaynak olabileceğinden, kaynakları filtrelemek için küçük bir model kullanıyoruz. Bu bağlamı, diff, PR açıklaması ve PR’daki commitlerle birlikte ajana veriyoruz.
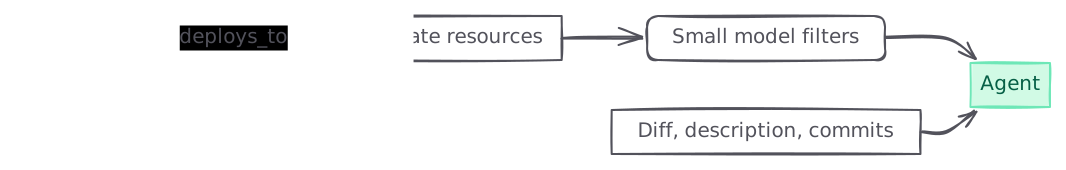
Ayrıca diff’i, ajanın dikkatini genellikle üretime olumsuz etkisi olması muhtemel şeylere hızlıca yöneltmek için bir dizi deterministik sezgisel kuraldan geçiriyoruz:
- elle uygulanması gereken veya dağıtıma göre belirli bir sırada uygulanması gereken bir migration
CONCURRENTLYolmadanCREATE INDEXveya varsayılan değeri olmadanADD COLUMN ... NOT NULL, ikisi de süre boyunca tabloyu kilitler- şu anda dağıtılmış sürüm hâlâ okurken kaldırılan bir endpoint
- diff’te hiçbir şeyin sağlamadığı bir ortam değişkenini, secret’ı veya binding’i okumaya başlayan kod
Bunlar, ajanı muhtemel dağıtım risklerine yönlendiren önerilerdir.
Hata yörüngeleri
Yukarıda sağlanan bağlamla model, yeni diff’in üretimde ortaya çıkarabileceği çeşitli hata modlarını belirliyor ve her birini araştırıyor.
Çıktısı bir hata yörüngeleri kaydıdır. Bir yörünge, bir tetikleyiciden değişen kod üzerinden belirli bir metrikteki gözlemlenebilir bir bozulmaya kadar uzanan tek bir nedensel zincirdir ve içindeki her bağlantı bir kanıt taşır: bir dosya ve satır, sayısıyla birlikte bir günlük şablonu, bir metrik okuması, bir config anahtarı, bir grafik kenarı.
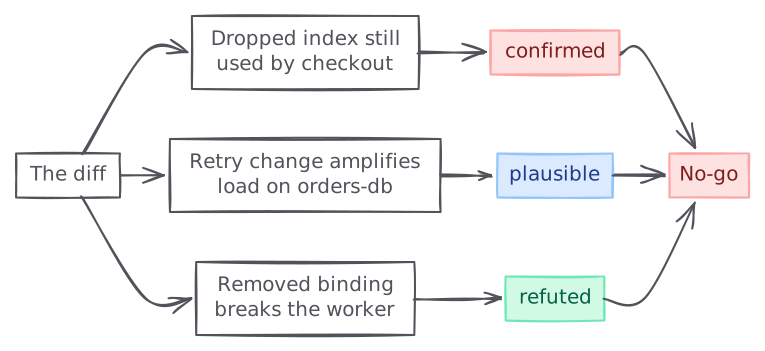
Ajan, bir karara varmadan önce her yörüngeyi hem doğrulamaya hem de çürütmeye çalışır. Her biri şu üç durumdan birinde sonuçlanır:
confirmed: yörünge üretime karşı doğrulandığında.plausible: zincir somut olduğunda ama bir veya birden fazla bağlantı, onu doğrulayacak telemetri verisi olmadan yalnızca “tahmin” edilebildiğinde.refuted: üretim telemetri verisi, bu yörüngenin üretimde gerçekleşme olasılığının düşük olduğuna dair yeterli kanıt sağladığında.
Muhafazakâr bir yaklaşım benimsiyoruz ve herhangi bir confirmed yörünge, değerlendirmenin başarısız olmasına yol açıyor.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Etkiyi öngörmek
Ajana, olası dış faktörleri de dahil ederek geçmiş verilere dayanarak zaman serilerini öngörmesi için bir araç veriyoruz.
Diyelim ki bir yörünge, bir değişikliğin retry yapılan bir yoldaki timeout’u yarıya indirdiğini iddia ediyor. Bunun önemli olup olmadığı trafiğe bağlı, ve trafik aslında tek bir sayı değil, bir şekli var. %60 derinlikte duran ve öyle kalan bir kuyruk sorun değil. Aynı kuyruk %60’ta ama her hafta yükseliyorsa durum farklıdır, ve son bir saatlik metrikleri okumak sana hangisine baktığını söylemez.
Bu yüzden ajan bir yörüngenin kararını taslak haline getirmeden önce, etkilenen kaynaklar için geçmiş serileri çekiyor ve bunları birlikte öngörüyor. Şu anda Toto-2.0-22m modelini kendimiz barındırıyoruz.
Başka bir prompt yerine özel bir çok değişkenli model kullanmamızın nedeni, serilerin birbirinden bağımsız olmaması. Bir kaynaktaki istek oranı, hata oranı, gecikme ve kuyruk derinliği birlikte hareket eder, ve her birini ayrı ayrı öngörmek, öngörüyü değerli kılan korelasyonu ortadan kaldırır. Bir çağrıdaki her seri aynı attention grubunu paylaşır.
Bu, yakın zamanda eklediğimiz en deneysel özellik ve etkisini hâlâ ölçüyoruz. Ama şimdiden vibes-eval’ı geçiyor.
Gecikme kısıtı
Üretim etki değerlendirmesini pull request akışında çalıştırmak, bunun hızlı olması gerektiği anlamına geliyor. Kimse CI pipeline’ına 15 dakika ekleyen bir adım istemez. Örneğin, kendi depolarımızda bu değerlendirme zorunlu bir CI adımı, yavaş olursa tüm SDLC’miz tıkanıyor.
Doğru bir etki değerlendirmesi üretmek için esasen 2 ile 3 dakika arasında bir bütçemiz var. Bunun ötesindeki her şey bir CI/CD pipeline’ında kabul edilemez.
İlk prototipimiz bu kısıtı tamamen karşılayamıyordu. Medyanımız neredeyse 7 dakikaydı ve çalıştırmaların 20 dakikaya kadar sürdüğünü görmek yaygındı.
Amaç, tüm akışı 3 dakikanın altına indirmek için model adımlarının sayısını nasıl azaltacağımızı bulmak oldu. Tipik olarak 30 ila 40 sıralı model adımı çalıştırıyorduk, en kötü senaryolarda ise neredeyse 600 adıma kadar çıkıyordu, her biri bütçemizden 17 saniye harcıyordu ve çıktılarının büyük çoğunluğu reasoning token’ıydı.
Son 3 haftada, performans üzerinde çeşitli etkileri olan epey değişiklik yaptık. İşte en önemlileri.
Bir adım bütçesi belirlemek ve bunu ajana bildirmek
Ajan turu başına 30 adımla sınırlı bir adım bütçesi getirdik ve her adımda modele kaç adım tükettiğini açıkça bildiriyoruz. Sayıyı prompt’a koymak, modelin buna göre plan yapmasını sağlıyor, ve bunun sayının kendisinden daha önemli olduğu ortaya çıktı.
Mevcut incelemeye eklemek yerine yeni incelemeler başlatmak
Tipik bir pull request açıldıktan sonra yeni commitler almaya devam eder. İlk prototipte, yeni diff’in tamamını aynı inceleme thread’ine yönlendirici bir kullanıcı mesajı olarak ekliyorduk. Bu yönlendirme modeli büyük ölçüde karıştırıyor ve zaten incelediği dosyaları tekrar okumasına ve zaten tamamladığı telemetri sorgularını yeniden çalıştırmasına yol açıyordu.
Şimdi, yeni bir commit önceki değerlendirme çalıştırmasını iptal ediyor ve tamamen yeni bir thread başlatıyor. Sezgilere aykırı görünse de, sonuçta tam incelemeler için gecikmeyi düşürdü.
Önceki işi yeniden kullanmak
Bir inceleme zaten tamamlandıktan sonra pull request’e yeni bir commit geldiğinde, saf bir şekilde sıfırdan yeni bir etki değerlendirmesi başlatıyorduk.
Önceki değerlendirmeyi yeniden kullanma ve iki ardışık commit arasındaki daha küçük diff üzerinde yeni bir değerlendirme tetikleme yeteneğini ekledik.
Bu değişiklikleri Eylül boyunca dağıttık ve gecikmeyi kademeli olarak iyileştirdik, gecikme artık bütçenin rahatlıkla içinde kalıyor.
Bunun bir önemi var mı?
Anlamlı sonuçlar görmüyorsak tüm bu token’ları harcamanın ne anlamı var? Başarı metriğimiz, her bir müşterimiz için haftada önlediğimiz olay sayısı. Önlenen bir olay, şu şekilde bir pull request’tir:
- üretime yönelik potansiyel bir riski işaretliyoruz
- bir mühendis bir veya birden fazla commit push ediyor
- yeni bir değerlendirme, potansiyel riskin giderildiği sonucuna varıyor
- pull request birleştiriliyor
Bu şimdiden oldukça önemli ve büyümeye devam etmesini bekliyoruz. Ajanımızın performansını ve kalitesini artırmak için sürekli iterasyon yapıyor ve eval’lar çalıştırıyoruz.