

Как мы не даём слопу попасть в prod
Explore with AI
Вы, вероятно, либо строите программную фабрику, либо арендуете её у провайдера. У вас есть система, которая проводит вас от промпта до pull request. Она занимается тестами, линтингом, форматированием и автоматическими код-ревью.
Но у вас всё ещё нет ответа на самый важный вопрос: можно ли пускать это изменение в prod?
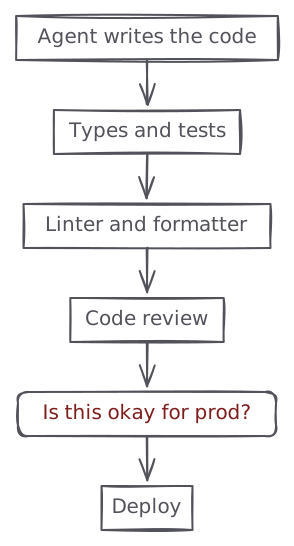
Все ваши текущие проверки смотрят на diff, но ничто в вашей фабрике ничего не знает о production-системе, на которую вот-вот попадёт этот diff. По сути, ничто не может помешать слопу попасть в prod.
Мы реализовали эту возможность внутри Polylane, и этот пост посвящён техническим деталям того, как мы это сделали.
Как это работает
Единственный вопрос, на который должна отвечать эта система:
Окажет ли это изменение, после merge и деплоя, негативное влияние на production?
Нас не особо волнуют типичные вещи, которые проверяет агент код-ревью: стиль, именование, покрытие тестами и так далее. Мы решили отвечать на этот вопрос на этапе pull request, наряду со всеми вашими существующими тестами.
В итоге Polylane оставляет комментарий к pull request с простым сообщением «go» / «no-go» и доказательствами из своего расследования.
Процесс довольно простой:
- Затрагивает ли этот pull request файлы, которые могут повлиять на production?
- Какие облачные ресурсы потенциально затронуты?
- Собрать контекст о текущем состоянии production для этих ресурсов
- Оценить несколько потенциальных сценариев сбоя, которые может внести это изменение
- Спрогнозировать, как может измениться production после деплоя этих изменений
- Уведомить разработчиков о вероятных потенциальных сценариях сбоя
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Всё это опирается на Context graph, который мы непрерывно строим, связывая все облачные ресурсы в ваших различных облачных аккаунтах.
Сборка контекста
Наш Context graph — ключевая часть того, как это работает: он строит реестр всех ваших облачных ресурсов, всех ваших репозиториев, команд и так далее. Например, вычислительный узел, такой как функция Lambda, связан с базой данных, из которой он читает, и с очередью, которая его запускает. Мы также добавляем репозитории в граф. Это делается путём анализа типичных манифестных файлов в репозитории, например terraform-файлов, Cloudformation-файлов или Wrangler-файлов. Это обеспечивает связь между репозиториями и облачными ресурсами.
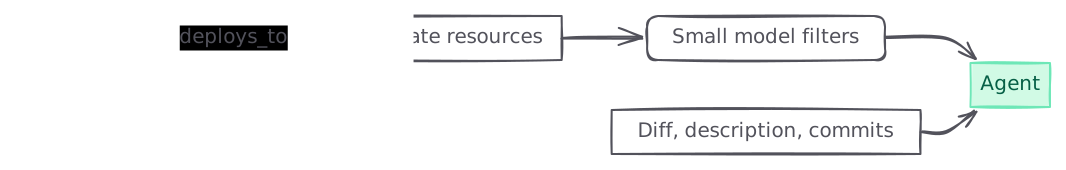
Когда pull request отправляется в репозиторий, мы проходим по путям в Context graph, чтобы собрать все облачные ресурсы, потенциально затронутые изменением. Мы используем небольшую модель для фильтрации ресурсов, поскольку из одного репозитория может деплоиться большое количество ресурсов. Мы передаём этот контекст вместе с diff, описанием PR и коммитами в PR агенту.
Мы также пропускаем diff через набор детерминированных эвристик, чтобы быстро направить внимание агента на вещи, которые обычно негативно влияют на production:
- миграция, которую нужно применять вручную или в определённом порядке относительно деплоя
CREATE INDEXбезCONCURRENTLYилиADD COLUMN ... NOT NULLбез значения по умолчанию: оба варианта блокируют таблицу на время выполнения- эндпоинт удаляется, пока текущая задеплоенная версия всё ещё обращается к нему
- код начинает читать переменную окружения, secret или binding, которые ничего в diff не создаёт
Это рекомендации, которые направляют агента к вероятным рискам деплоя.
Траектории сбоя
Располагая описанным выше контекстом, модель формирует различные сценарии сбоя, которые новый diff может внести в production, и по очереди исследует каждый из них.
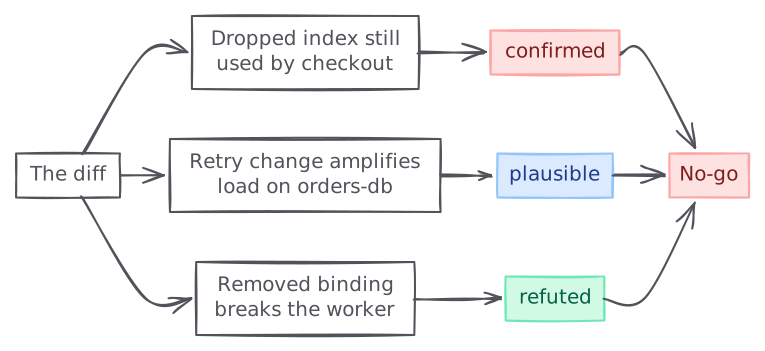
Результат работы — реестр траекторий сбоя. Траектория — это одна причинно-следственная цепочка от триггера через изменённый код к наблюдаемой деградации конкретной метрики, и у каждого звена в ней есть ссылка на источник: файл и строка, шаблон лога с количеством вхождений, показание метрики, ключ конфигурации, ребро графа.
Агент пытается и подтвердить, и опровергнуть каждую траекторию, прежде чем вынести вердикт. Каждая заканчивается в одном из трёх состояний:
confirmed, когда траектория подтверждена данными production.plausible, когда цепочка конкретна, но одно или несколько звеньев можно было только «угадать» без телеметрии, подтверждающей их.refuted, когда данные телеметрии production дают достаточно оснований считать, что эта траектория вряд ли произойдёт в production.
Мы придерживаемся консервативного подхода: любая траектория confirmed приводит к провалу оценки.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Прогнозирование влияния
Мы даём агенту инструмент для прогнозирования временных рядов на основе исторических данных с возможностью учитывать потенциальные внешние факторы.
Допустим, траектория утверждает, что изменение вдвое сокращает таймаут на пути с повторными попытками. Важно ли это, зависит от трафика, а трафик не сводится к одному числу: у него есть форма. Если очередь стабильно держится на глубине 60%, это нормально. Но если та же очередь держится на 60% и растёт каждую неделю, ситуация уже другая, и чтение метрик за последний час не покажет, с какой из них вы имеете дело.
Поэтому прежде чем агент набрасывает вердикт по траектории, он забирает исторические ряды для затронутых ресурсов и прогнозирует их вместе. Сейчас мы самостоятельно хостим модель Toto-2.0-22m.
Причина, по которой мы используем отдельную многомерную модель, а не ещё один промпт, в том, что ряды не независимы. Частота запросов, частота ошибок, задержка и глубина очереди на одном ресурсе движутся вместе, и прогнозирование каждого из них по отдельности отбрасывает корреляцию, ради которой вообще стоит строить прогноз. Все ряды в одном вызове разделяют одну attention-группу.
Это самая экспериментальная возможность, которую мы недавно добавили, и мы всё ещё измеряем её влияние. Но она уже проходит vibes-eval.
Ограничение по задержке
Запуск оценки влияния на production в потоке pull request означает, что она должна быть быстрой. Никто не хочет шага, который добавляет 15 минут к пайплайну CI. Например, на наших собственных репозиториях эта оценка — обязательный шаг CI, и если он медленный, весь наш SDLC начинает буксовать.
По сути, у нас есть бюджет в 2-3 минуты на то, чтобы выдать точную оценку влияния. Всё, что дольше, неприемлемо в пайплайне CI/CD.
Наш первый прототип полностью проваливал это ограничение. Медиана была почти 7 минут, и нередко прогоны занимали до 20 минут.
Задача свелась к тому, чтобы сократить число шагов модели и уложить весь процесс в 3 минуты. Обычно мы выполняли от 30 до 40 последовательных шагов модели, а в худшем случае почти 600, каждый из которых съедал по 17 секунд бюджета, и подавляющее большинство их вывода приходилось на reasoning-токены.
За последние 3 недели мы внесли немало изменений, которые по-разному повлияли на производительность. Вот самые значимые из них.
Установка бюджета шагов и информирование о нём агента
Мы ввели бюджет шагов, ограниченный 30 шагами на ход агента, и на каждом шаге явно сообщаем модели, сколько шагов она уже израсходовала. То, что счётчик передаётся прямо в промпте, позволяет модели планировать свои действия вокруг него, и это оказывается важнее самого числа.
Начинать новое ревью вместо продолжения существующего
Типичный pull request продолжает получать новые коммиты после открытия. В первом прототипе мы добавляли весь новый diff в тот же тред ревью в виде направляющего сообщения пользователя. Такое направление сильно сбивало модель с толку и приводило к тому, что она заново читала уже изученные файлы и повторно выполняла уже завершённые запросы к телеметрии.
Теперь новый коммит отменяет предыдущий запуск оценки и запускает совершенно новый тред. Это выглядит нелогично, но в итоге снизило задержку для полных ревью.
Повторное использование предыдущей работы
Раньше, когда в pull request прилетал новый коммит после уже завершённого ревью, мы наивно запускали новую оценку влияния с нуля.
Мы добавили возможность переиспользовать предыдущую оценку и запускать новую оценку только по меньшему diff между двумя последовательными коммитами.
Мы выкатывали эти изменения на протяжении всего сентября, постепенно улучшая задержку, и теперь она уверенно укладывается в бюджет.
Это вообще имеет значение?
Какой смысл сжигать все эти токены, если мы не видим значимых результатов? Метрикой успеха для нас служит число инцидентов, которые мы предотвращаем каждую неделю для каждого клиента. Предотвращённым инцидентом мы считаем pull request, в котором:
- мы отмечаем потенциальный риск для production
- инженер пушит один или несколько коммитов
- новая оценка приходит к выводу, что потенциальный риск устранён
- pull request мержится
Это уже довольно значимо, и мы ожидаем, что этот показатель продолжит расти. Мы непрерывно итерируем и проводим evals, чтобы улучшать производительность и качество нашего агента.