

Як ми не даємо мотлоху потрапити в продакшн
Explore with AI
Ви, ймовірно, або будуєте фабрику програмного забезпечення, або орендуєте її в провайдера. У вас є система, яка проводить вас від промпту до pull request. Вона обробляє тести, лінтинг, форматування та автоматизовані рев’ю коду.
Але у вас усе ще немає відповіді на найважливіше питання: чи можна цю зміну випускати в продакшн?.
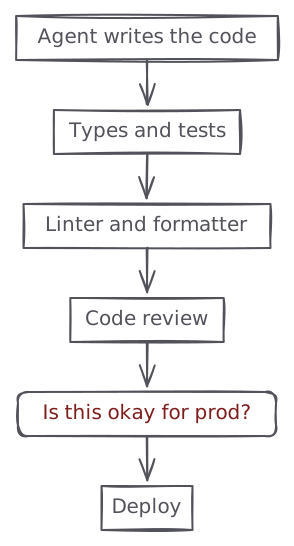
Усі ваші поточні перевірки дивляться на diff, але ніщо у вашій фабриці не знає нічого про продакшн-систему, на яку цей diff незабаром потрапить. Ніщо насправді не може завадити мотлоху потрапити в продакшн.
Ми реалізували цю можливість у Polylane, і цей пост про технічні деталі того, як ми це зробили.
Як це працює
Єдине питання, на яке ця система має відповісти:
Чи матиме ця зміна, після злиття та розгортання, негативний вплив на продакшн?
Нас насправді не цікавлять типові речі, які перевіряє агент рев’ю коду, такі як стиль, назви, покриття тестами тощо. І ми вирішили відповідати на це питання на етапі pull request, поряд з усіма вашими існуючими тестами.
Зрештою, Polylane залишає коментар до pull request із простим повідомленням «go» / «no-go» та доказами зі свого розслідування.
Процес доволі простий:
- Чи торкається цей pull request файлів, які можуть вплинути на продакшн?
- Які хмарні ресурси потенційно зачеплені?
- Зібрати контекст про поточний стан продакшну для цих ресурсів
- Оцінити кілька потенційних режимів збою, які може спричинити ця зміна
- Спрогнозувати, як продакшн може змінитися після розгортання цих змін
- Попередити розробників про ймовірні потенційні режими збою
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Усе це спирається на контекстний граф, який ми безперервно будуємо, з’єднуючи всі хмарні ресурси у ваших різних хмарних облікових записах.
Збирання контексту
Наш контекстний граф є ключовим для роботи цієї системи: він будує реєстр усіх ваших хмарних ресурсів, усіх ваших репозиторіїв, команд тощо. Наприклад, обчислювальний вузол, такий як функція Lambda, з’єднаний з базою даних, з якої він читає, і черга, яка його запускає. Ми також додаємо репозиторії до графа. Це робиться шляхом аналізу типових файлів-маніфестів у репозиторії, наприклад файлів terraform, Cloudformation чи Wrangler. Це уможливлює зв’язок між репозиторіями та хмарними ресурсами.
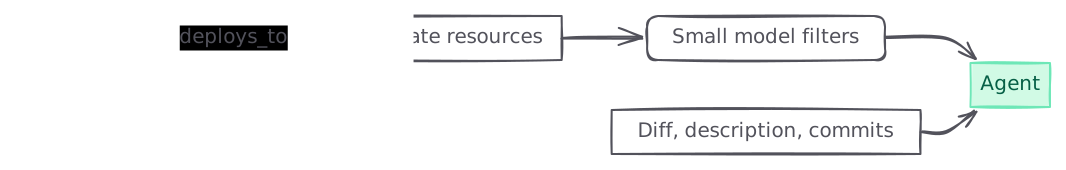
Коли pull request надсилається до репозиторію, ми проходимо шляхами контекстного графа, щоб зібрати всі хмарні ресурси, потенційно зачеплені зміною. Ми використовуємо малу модель для фільтрації ресурсів, оскільки з одного репозиторію може розгортатися велика кількість ресурсів. Ми передаємо агенту цей контекст разом із diff, описом PR та комітами в PR.
Ми також пропускаємо diff через набір детерміністичних евристик, щоб швидко спрямувати увагу агента на речі, які зазвичай можуть негативно вплинути на продакшн:
- міграція, яку потрібно застосувати вручну або у певному порядку відносно розгортання
CREATE INDEXбезCONCURRENTLY, абоADD COLUMN ... NOT NULLбез значення за замовчуванням: обидва варіанти блокують таблицю на весь час виконання- ендпоінт, який видаляється, тоді як поточна розгорнута версія його все ще читає
- код, який починає читати змінну середовища, секрет або binding, які нічого в diff не створює
Це рекомендації, які спрямовують агента до ймовірних ризиків розгортання.
Траєкторії збою
З урахуванням наданого вище контексту модель формулює різні режими збою, які новий diff може внести в продакшн, і розслідує кожен з них.
Її результат: реєстр траєкторій збою. Траєкторія є одним причинно-наслідковим ланцюгом від тригера через змінений код до спостережуваного погіршення конкретної метрики, і кожна ланка в ньому має посилання: файл і рядок, шаблон логу з його кількістю, значення метрики, ключ конфігурації, ребро графа.
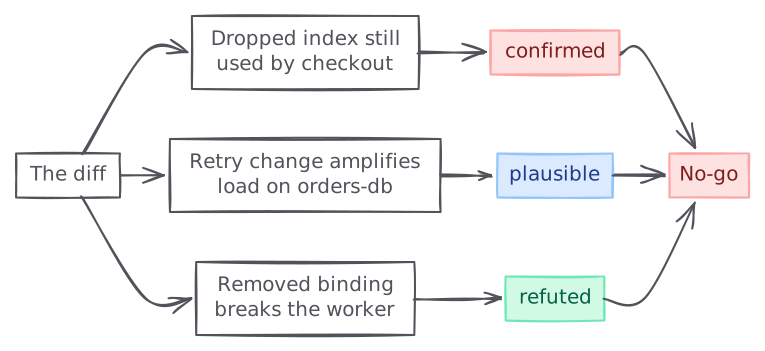
Перед тим як дійти висновку, агент намагається як підтвердити, так і спростувати кожну траєкторію. Кожна завершується одним із трьох станів:
confirmed, коли траєкторію підтверджено на основі продакшну.plausible, коли ланцюг конкретний, але одну або кілька ланок можна було лише «припустити» без даних телеметрії, що це підтверджують.refuted, коли дані телеметрії продакшну надали достатньо доказів, що ця траєкторія навряд чи станеться в продакшні.
Ми дотримуємося консервативного підходу, і будь-яка траєкторія confirmed призводить до негативної оцінки.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Прогнозування впливу
Ми надаємо агенту інструмент для прогнозування часових рядів на основі історичних даних із врахуванням потенційних зовнішніх факторів.
Скажімо, траєкторія стверджує, що якась зміна вдвічі зменшує таймаут на шляху, де відбуваються повторні спроби. Чи це має значення, залежить від трафіку, а трафік насправді не одне число, у нього є форма. Черга, яка тримається на рівні 60% заповненості й лишається там, це нормально. Та ж черга на рівні 60%, але яка зростає щотижня, це вже інша ситуація, і читання метрик за останню годину не скаже вам, яку саме ситуацію ви бачите.
Тож перед тим як агент формулює висновок щодо траєкторії, він отримує історичні ряди для зачеплених ресурсів і прогнозує їх разом. Наразі ми самостійно хостимо модель Toto-2.0-22m.
Причина використання окремої багатовимірної моделі, а не ще одного промпту, у тому, що ряди не є незалежними. Частота запитів, частота помилок, латентність і глибина черги для одного ресурсу рухаються разом, і прогнозування кожного окремо відкидає кореляцію, яка робить прогноз цінним. Усі ряди в одному викликі спільно використовують одну групу уваги.
Це найбільш експериментальна можливість, яку ми недавно додали, і ми досі вимірюємо її вплив. Але вона вже проходить vibes-eval.
Обмеження латентності
Запуск оцінки впливу на продакшн у процесі pull request означає, що вона має бути швидкою. Нікому не потрібен крок, який додає 15 хвилин до CI-пайплайну. Наприклад, у наших власних репозиторіях ця оцінка є обов’язковим кроком CI, і якщо вона повільна, весь наш SDLC застрягає.
У нас фактично є бюджет від 2 до 3 хвилин, щоб отримати точну оцінку впливу. Усе, що виходить за ці межі, неприйнятне в CI/CD-пайплайні.
Наш перший прототип повністю не вкладався в це обмеження. Наша медіана становила майже 7 хвилин, і було звичним бачити запуски, що тривали до 20 хвилин.
Метою стало з’ясувати, як зменшити кількість кроків моделі, щоб увести весь процес у межі 3 хвилин. Зазвичай ми виконували від 30 до 40 послідовних кроків моделі, а в найгірших сценаріях до майже 600 кроків, кожен з яких споживав 17 секунд нашого бюджету, і переважна більшість їхнього виводу становили токени міркування.
За останні 3 тижні ми внесли чимало змін із різним впливом на продуктивність. Ось найважливіші з них.
Встановлення бюджету кроків і повідомлення про нього агенту
Ми впровадили бюджет кроків, обмежений 30 кроками на хід агента, і на кожному кроці чітко повідомляємо моделі, скільки кроків вона вже витратила. Розміщення лічильника в промпті дозволяє моделі планувати навколо нього, і виявляється, що це має більше значення, ніж саме число.
Запуск нових рев’ю замість додавання до наявного
Типовий pull request продовжує отримувати нові коміти після відкриття. У першому прототипі ми додавали весь новий diff у той самий тред рев’ю як спрямовуюче повідомлення користувача. Це спрямування сильно збивало модель з пантелику і призводило до повторного читання файлів, які вона вже перевірила, і повторного запуску запитів телеметрії, які вона вже виконала.
Тепер новий коміт скасовує попередній запуск оцінки і запускає повністю новий тред. Це може здатися нелогічним, але в результаті це знизило латентність повних рев’ю.
Повторне використання попередньої роботи
Коли новий коміт з’являється в pull request після того, як рев’ю вже було завершено, раніше ми наївно починали нову оцінку впливу з нуля.
Ми впровадили можливість повторно використовувати попередню оцінку і запускати нову оцінку лише для меншого diff між двома послідовними комітами.
Ми розгортали ці зміни протягом вересня і поступово покращували латентність, і тепер латентність комфортно вкладається в бюджет.
Чи це взагалі має значення?
Який сенс спалювати всі ці токени, якщо ми не бачимо жодних значущих результатів? Наша метрика успіху це кількість інцидентів, які ми запобігаємо щотижня для кожного з наших клієнтів. Запобіжений інцидент це pull request, де:
- ми позначаємо потенційний ризик для продакшну
- інженер пушить один або кілька комітів
- нова оцінка робить висновок, що потенційний ризик усунено
- pull request зливається
Це вже досить значуще число, і ми очікуємо, що воно продовжить зростати. Ми безперервно ітеруємо і проводимо evals, щоб покращити продуктивність та якість нашого агента.