

Como evitamos que código ruim chegue à produção
Explore with AI
Você provavelmente está construindo uma fábrica de software ou alugando uma de algum provedor. Você tem um sistema que te leva de um prompt a uma pull request. Ele cuida de testes, linting, formatação e revisões de código automatizadas.
Mas você ainda não tem uma resposta para a pergunta mais importante: essa mudança está pronta para ir para produção?.
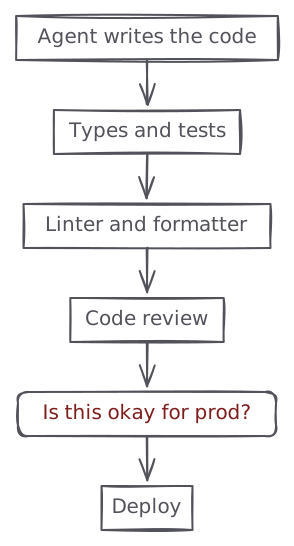
Todas as suas verificações atuais olham para o diff, mas nada na sua fábrica sabe algo sobre o sistema de produção onde esse diff está prestes a pousar. Nada realmente consegue evitar que código ruim chegue à produção.
Construímos essa capacidade dentro do Polylane e este post é sobre os detalhes técnicos de como a implementamos.
Como funciona
A única pergunta que esse sistema deve responder é:
Será que essa mudança, uma vez feito o merge e o deploy, teria um impacto negativo na produção?
Não nos importamos muito com as coisas típicas que um agente de revisão de código verificaria, como estilo, nomenclatura, cobertura de testes, etc. E decidimos responder essa pergunta na etapa da pull request, junto com todos os seus testes existentes.
No final, o Polylane comenta na pull request com uma mensagem simples de “go” / “no-go”, com as evidências da sua investigação.
O fluxo é bem simples:
- Essa pull request está mexendo em arquivos que podem afetar a produção?
- Quais recursos de nuvem são potencialmente afetados?
- Reunir contexto sobre o estado atual da produção para esses recursos
- Avaliar múltiplos modos de falha em potencial que essa mudança pode introduzir
- Prever como a produção pode mudar com essas mudanças implantadas
- Alertar os desenvolvedores sobre os prováveis modos de falha em potencial
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Tudo isso depende do grafo de contexto que construímos continuamente conectando todos os recursos de nuvem nas suas várias contas de nuvem.
Montando o contexto
Nosso grafo de contexto é essencial para fazer isso funcionar, ele constrói um registro de todos os seus recursos de nuvem, todos os seus repositórios, times, etc. Por exemplo, um nó de computação como uma função Lambda é conectado ao banco de dados de onde ele lê e à fila que o dispara. Também adicionamos repositórios ao grafo. Isso é feito olhando para os arquivos de manifesto típicos no repositório, por exemplo arquivos terraform, arquivos Cloudformation ou arquivos Wrangler. Isso permite a conexão entre repositórios e recursos de nuvem.
Quando uma pull request é enviada ao repositório, seguimos os caminhos no grafo de contexto para coletar todos os recursos de nuvem potencialmente afetados pela mudança. Usamos um modelo pequeno para filtrar os recursos, já que pode haver um grande número de recursos implantados a partir do mesmo repositório. Passamos esse contexto junto com o diff, a descrição da PR e os commits da PR para o agente.
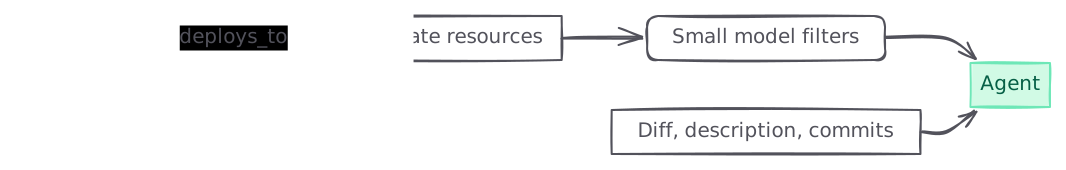
Também passamos o diff por um conjunto de heurísticas determinísticas para guiar rapidamente a atenção do agente para coisas que geralmente têm probabilidade de causar um impacto negativo na produção:
- uma migration que precisa ser aplicada manualmente, ou em uma ordem específica em relação ao deploy
CREATE INDEXsemCONCURRENTLY, ouADD COLUMN ... NOT NULLsem valor padrão, ambos travam a tabela durante a execução- um endpoint sendo removido enquanto a versão atualmente implantada ainda o lê
- código que passa a ler uma variável de ambiente, secret ou binding que nada no diff provisiona
Essas são recomendações, direcionando o agente para prováveis riscos de deploy.
Trajetórias de falha
Com o contexto fornecido acima, o modelo elabora vários modos de falha que o novo diff pode introduzir na produção e investiga cada um deles.
O resultado é um registro de trajetórias de falha. Uma trajetória é uma cadeia causal que vai de um gatilho, passando pelo código alterado, até uma degradação observável em uma métrica específica, e cada elo dessa cadeia carrega uma citação: um arquivo e linha, um template de log com sua contagem, uma leitura de métrica, uma chave de configuração, uma aresta do grafo.
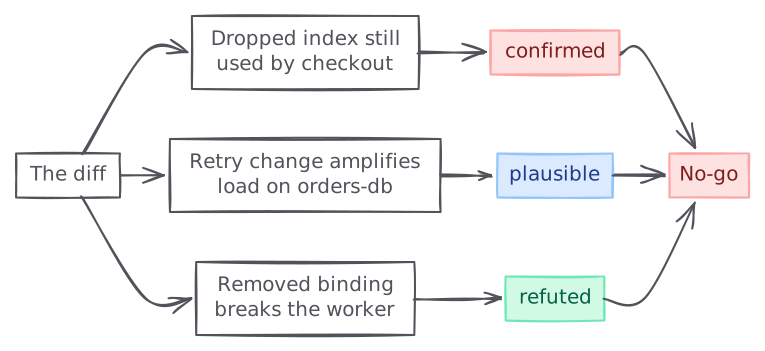
O agente tenta tanto validar quanto invalidar cada trajetória antes de chegar a um veredito. Cada uma termina em um de três estados:
confirmedquando a trajetória foi confirmada em relação à produção.plausiblequando a cadeia é concreta, mas um ou mais elos só puderam ser “presumidos”, sem dados de telemetria para confirmá-los.refutedquando os dados de telemetria de produção forneceram evidências suficientes de que essa trajetória tem baixa probabilidade de acontecer em produção.
Adotamos uma abordagem conservadora e qualquer trajetória confirmed leva a uma avaliação reprovada.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Prevendo o impacto
Damos ao agente uma ferramenta para prever séries temporais com base em dados históricos, injetando possíveis fatores externos.
Digamos que uma trajetória afirme que uma mudança reduz pela metade o timeout em um caminho com retries. Se isso importa ou não depende do tráfego, e tráfego não é realmente um único número, ele tem uma forma. Uma fila parada em 60% de profundidade e que permanece assim está tudo bem. A mesma fila em 60%, mas subindo toda semana, é uma situação diferente, e olhar as métricas da última hora não vai te dizer qual das duas você está vendo.
Então, antes de o agente redigir o veredito de uma trajetória, ele busca a série histórica dos recursos afetados e faz a previsão delas em conjunto. Atualmente, hospedamos nós mesmos o modelo Toto-2.0-22m.
O motivo de usar um modelo multivariado dedicado em vez de mais um prompt é que as séries não são independentes. Taxa de requisições, taxa de erro, latência e profundidade da fila em um mesmo recurso se movem juntas, e prever cada uma isoladamente descarta a correlação que torna a previsão útil. Toda série em uma chamada compartilha o mesmo grupo de atenção.
Essa é a capacidade mais experimental que adicionamos recentemente, e ainda estamos medindo seu impacto. Mas ela já passa no vibes-eval.
A restrição de latência
Rodar a avaliação de impacto em produção no fluxo da pull request significa que ela precisa ser rápida. Ninguém quer uma etapa que adicione 15 minutos ao pipeline de CI. Por exemplo, nos nossos próprios repositórios essa avaliação é uma etapa obrigatória de CI, e se ela for lenta, todo o nosso SDLC fica travado.
Basicamente, temos um orçamento de 2 a 3 minutos para produzir uma avaliação de impacto precisa. Qualquer coisa além disso não é aceitável em um pipeline de CI/CD.
Nosso primeiro protótipo falhava completamente nessa restrição. Nossa mediana era de quase 7 minutos, e era comum ver execuções levarem até 20 minutos.
O objetivo passou a ser descobrir como reduzir o número de passos do modelo para deixar o fluxo inteiro abaixo de 3 minutos. Normalmente rodávamos de 30 a 40 passos sequenciais do modelo, e nos piores cenários, quase 600 passos, cada um consumindo 17 segundos do nosso orçamento, sendo que a grande maioria da saída eram tokens de raciocínio.
Fizemos várias mudanças nas últimas 3 semanas, com impactos variados na performance. Aqui estão as mais significativas.
Definindo um orçamento de passos e comunicando isso ao agente
Introduzimos um orçamento de passos, limitado a 30 passos por turno do agente, e comunicamos claramente ao modelo quantos passos ele já consumiu a cada passo. Colocar a contagem no prompt permite que o modelo planeje em torno disso, o que acaba importando mais do que o número em si.
Iniciando novas revisões em vez de incorporá-las à existente
Uma pull request típica continua recebendo novos commits depois de aberta. No primeiro protótipo, incorporávamos todo o novo diff na mesma thread de revisão como uma mensagem de direcionamento do usuário. Esse direcionamento confundia bastante o modelo e o levava a ler arquivos que já tinha examinado e a executar de novo queries de telemetria que já tinha concluído.
Agora, um novo commit cancela a execução de avaliação anterior e inicia uma thread totalmente nova. Parece contraintuitivo, mas isso acabou reduzindo a latência das revisões completas.
Reaproveitando trabalho anterior
Quando um novo commit chegava na pull request depois que uma revisão já havia sido concluída, costumávamos, de forma ingênua, iniciar uma nova avaliação de impacto do zero.
Introduzimos a capacidade de reaproveitar a avaliação anterior, e disparar uma nova avaliação apenas sobre o diff menor entre os dois commits consecutivos.
Implantamos essas mudanças ao longo de setembro e melhoramos gradualmente a latência, que hoje fica confortavelmente dentro do orçamento.
Isso realmente importa?
Qual é o sentido de queimar todos esses tokens se não vemos resultados significativos? Nossa métrica de sucesso é o número de incidentes que evitamos por semana para cada um dos nossos clientes. Um incidente evitado é uma pull request em que:
- sinalizamos um risco em potencial para a produção
- um engenheiro envia um ou mais commits
- uma nova avaliação conclui que o risco em potencial foi mitigado
- a pull request recebe o merge
Isso já é bastante significativo e esperamos que continue crescendo. Estamos continuamente iterando e rodando evals para melhorar a performance e a qualidade do nosso agente.