

Sådan forhindrer vi, at slop rammer prod
Explore with AI
Du er sandsynligvis enten i gang med at bygge en softwarefabrik eller leje en fra en udbyder. Du har et system, der tager dig fra en prompt til en pull request. Det håndterer tests, linting, formatering og automatiserede kodegennemgange.
Men du har stadig ikke et svar på det vigtigste spørgsmål: er denne ændring okay at sende til prod?.
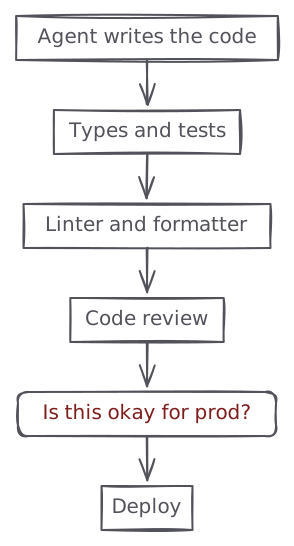
Alle dine nuværende kontroller kigger på diffen, men intet i din fabrik ved noget om det produktionssystem, diffen er ved at lande på. Intet kan reelt forhindre slop i at ramme prod.
Vi har bygget denne funktionalitet ind i Polylane, og dette indlæg handler om de tekniske detaljer om, hvordan vi implementerede det.
Sådan fungerer det
Det ene spørgsmål, dette system skal besvare, er:
Ville denne ændring, når den er merget og deployet, have en negativ indvirkning på produktionen?
Vi går ikke rigtig op i de typiske ting, en code-review-agent ville kontrollere, såsom stil, navngivning, testdækning osv. Og vi besluttede at besvare dette spørgsmål på pull request-stadiet, side om side med alle dine eksisterende tests.
Ultimativt kommenterer Polylane på pull requesten med en simpel “go”/“no-go”-besked med beviserne fra sin undersøgelse.
Flowet er ret enkelt:
- Rører denne pull request filer, der kan påvirke produktionen?
- Hvilke cloudressourcer er potentielt påvirket?
- Indsaml kontekst om produktionens nuværende tilstand for disse ressourcer
- Evaluer flere potentielle fejltilstande, denne ændring kan introducere
- Forudsig, hvordan produktionen kan ændre sig, når disse ændringer er deployet
- Advar udviklere om de sandsynlige potentielle fejltilstande
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Det hele afhænger af den context graph, vi løbende bygger, som forbinder alle cloudressourcerne i dine forskellige cloudkonti.
Sammensætning af konteksten
Vores context graph er afgørende for, at dette virker, den opbygger et register over alle dine cloudressourcer, alle dine repositories, teams osv. En compute-node såsom en Lambda-funktion er for eksempel forbundet til den database, den læser fra, og den kø, der udløser den. Vi tilføjer også repositories til grafen. Dette gøres ved at kigge på de typiske manifestfiler i repositoryet, for eksempel terraform-filer, Cloudformation-filer eller Wrangler-filer. Dette muliggør forbindelsen mellem repositories og cloudressourcer.
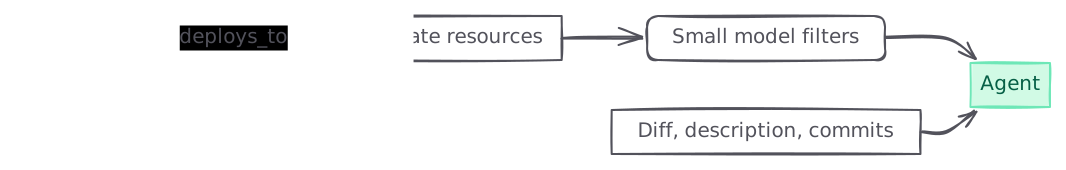
Når en pull request indsendes til repositoryet, følger vi stierne i context graph for at indsamle alle de cloudressourcer, der potentielt er påvirket af ændringen. Vi bruger en lille model til at filtrere ressourcerne igennem, da der kan være et stort antal ressourcer deployet fra det samme repository. Vi sender denne kontekst sammen med diffen, PR-beskrivelsen og commits i PR’en til agenten.
Vi sender også diffen gennem et sæt deterministiske heuristikker for hurtigt at guide agentens opmærksomhed mod ting, der som regel har tendens til at have en negativ indvirkning på produktionen:
- en migration, der skal anvendes manuelt, eller i en bestemt rækkefølge i forhold til deployet
CREATE INDEXudenCONCURRENTLY, ellerADD COLUMN ... NOT NULLuden en standardværdi, hvor begge dele tager en lås på tabellen i hele varigheden- et endpoint, der bliver fjernet, mens den aktuelt deployede version stadig læser det
- kode, der begynder at læse en miljøvariabel, hemmelighed eller binding, som intet i diffen provisionerer
Dette er anbefalinger, der styrer agenten hen mod sandsynlige deploymentrisici.
Fejltrajektorier
Med den kontekst, der er givet ovenfor, kommer modellen frem til forskellige fejltilstande, den nye diff kan introducere i produktionen, og undersøger hver enkelt.
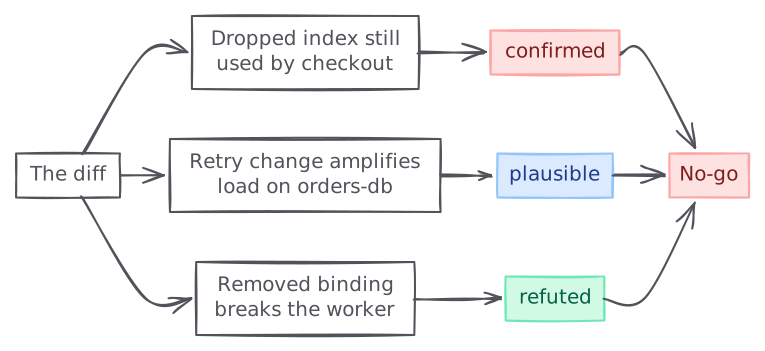
Dens output er en hovedbog med fejltrajektorier. En trajektorie er en enkelt kausal kæde fra en trigger, gennem den ændrede kode, til en observerbar forringelse af en bestemt metrik, og hvert led i den bærer en reference: en fil og linje, en logskabelon med dens antal, en metrikaflæsning, en konfigurationsnøgle, en kant i grafen.
Agenten forsøger både at validere og afkræfte hver trajektorie, før den når frem til en vurdering. Hver ender i en af tre tilstande:
confirmed, når trajektorien er blevet bekræftet mod produktionen.plausible, når kæden er konkret, men et eller flere led kun kunne “gættes” uden telemetridata til at bekræfte det.refuted, når produktionens telemetridata gav tilstrækkeligt bevis til, at denne trajektorie er usandsynlig i produktionen.
Vi anlægger en konservativ tilgang, og enhver confirmed-trajektorie fører til en mislykket vurdering.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Forudsigelse af konsekvensen
Vi giver agenten et værktøj til at forudsige tidsserier baseret på historiske data, hvor potentielle eksterne faktorer injiceres.
Sig, at en trajektorie hævder, at en ændring halverer timeouten på en sti, der forsøger igen. Om det betyder noget afhænger af trafikken, og trafik er ikke rigtig et enkelt tal, den har en form. En kø, der ligger på 60% dybde og bliver der, er fint. Den samme kø på 60%, men stigende hver uge, er en anden situation, og at læse den seneste times metrikker fortæller dig ikke, hvilken af de to du kigger på.
Så før agenten udkaster vurderingen af en trajektorie, henter den de historiske serier for de påvirkede ressourcer og forudsiger dem sammen. Vi selv-hoster i øjeblikket Toto-2.0-22m-modellen.
Grunden til en dedikeret multivariat model frem for endnu en prompt er, at serierne ikke er uafhængige. Request rate, fejlrate, latency og kødybde på én ressource bevæger sig sammen, og at forudsige hver for sig kasserer den korrelation, der gør forudsigelsen værd at have. Hver serie i et kald deler én attention group.
Dette er den mest eksperimentelle funktionalitet, vi for nylig har tilføjet, og vi måler stadig dens effekt. Men den består allerede vibes-evalen.
Latency-begrænsningen
At køre konsekvensanalysen for produktionen i pull request-flowet betyder, at den skal være hurtig. Ingen vil have et trin, der lægger 15 minutter til deres CI-pipeline. På vores egne repositories er denne vurdering for eksempel et påkrævet CI-trin, og hvis det er langsomt, går hele vores SDLC i stå.
Vi har grundlæggende et budget på 2 til 3 minutter til at producere en præcis konsekvensanalyse. Alt derudover er ikke acceptabelt i en CI/CD-pipeline.
Vores første prototype fejlede fuldstændigt denne begrænsning. Vores median lå på næsten 7 minutter, og det var almindeligt at se kørsler tage op til 20 minutter.
Målet blev at finde ud af, hvordan man reducerer antallet af modeltrin for at få hele flowet under 3 minutter. Vi kørte typisk 30 til 40 sekventielle modeltrin, og i værste fald op til næsten 600 trin, hver forbrugende 17 sekunder af vores budget, og langt størstedelen af deres output var reasoning tokens.
Vi har lavet en del ændringer i løbet af de sidste 3 uger, med forskellig indvirkning på performance. Her er de mest betydningsfulde.
Fastsættelse af et trinbudget og kommunikation af det til agenten
Vi introducerede et trinbudget, som er begrænset til 30 trin pr. agent-tur, og vi kommunikerer tydeligt til modellen, hvor mange trin den har brugt ved hvert trin. Ved at sætte antallet ind i prompten kan modellen planlægge ud fra det, hvilket viser sig at betyde mere end selve tallet.
At starte nye gennemgange i stedet for at folde dem ind i den eksisterende
En typisk pull request bliver ved med at få nye commits, efter den er åbnet. I den første prototype foldede vi hele den nye diff ind i den samme gennemgangstråd som en styrende brugerbesked. Denne styring forvirrede modellen betydeligt og førte til, at den læste filer, den allerede havde undersøgt, og genkørte telemetriforespørgsler, den allerede havde gennemført.
Nu annullerer en ny commit den forrige vurderingskørsel og starter en helt ny tråd. Det virker kontraintuitivt, men det bragte i sidste ende latency’en ned for komplette gennemgange.
Genbrug af tidligere arbejde
Når en ny commit lander i pull requesten, efter en gennemgang allerede er fuldført, plejede vi naivt at starte en ny konsekvensanalyse fra bunden.
Vi introducerede muligheden for at genbruge den forrige vurdering og udløse en ny vurdering på den mindre diff mellem de to på hinanden følgende commits.
Vi deployede disse ændringer hen over september og har gradvist forbedret latency’en, og latency’en ligger nu behageligt inden for budgettet.
Betyder dette overhovedet noget?
Hvad er pointen med at brænde alle disse tokens, hvis vi ikke ser nogen meningsfulde resultater? Vores succesmål er antallet af hændelser, vi forhindrer om ugen for hver af vores kunder. En forhindret hændelse er en pull request, hvor:
- vi markerer en potentiel risiko for produktionen
- en engineer pusher en eller flere commits
- en ny vurdering konkluderer, at den potentielle risiko er afhjulpet
- pull requesten bliver merget
Dette er allerede ret betydeligt, og vi forventer, at det bliver ved med at vokse. Vi itererer løbende og kører evals for at forbedre performance og kvaliteten af vores agent.