

Comment on empêche le slop d'atteindre la prod
Explore with AI
Tu es probablement en train de construire une usine logicielle, ou tu en loues une auprès d’un fournisseur. Tu as un système qui t’amène d’un prompt à une pull request. Il gère les tests, le linting, le formatage et les revues de code automatisées.
Mais tu n’as toujours pas de réponse à la question la plus importante : ce changement est-il prêt pour la prod ?.
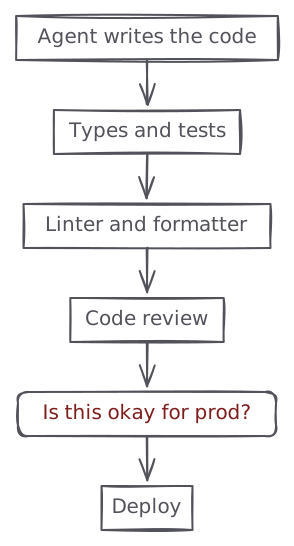
Toutes tes vérifications actuelles regardent le diff, mais rien dans ton usine ne connaît le système de production sur lequel ce diff est sur le point d’atterrir. Rien ne peut vraiment empêcher le slop d’atteindre la prod.
On a construit cette capacité dans Polylane et cet article détaille les aspects techniques de son implémentation.
Comment ça fonctionne
La seule question à laquelle ce système doit répondre est :
Ce changement, une fois fusionné et déployé, aurait-il un impact négatif sur la production ?
On ne s’intéresse pas vraiment aux éléments classiques qu’un agent de revue de code vérifierait, comme le style, le nommage, la couverture de tests, etc. Et on a décidé de répondre à cette question au stade de la pull request, en parallèle de tous tes tests existants.
En fin de compte, Polylane commente la pull request avec un simple message «\u00A0go\u00A0»\u00A0/\u00A0«\u00A0no-go\u00A0» accompagné des preuves de son enquête.
Le flux est plutôt simple :
- Cette pull request touche-t-elle des fichiers qui pourraient affecter la production ?
- Quelles ressources cloud sont potentiellement affectées ?
- Rassembler le contexte sur l’état actuel de la production pour ces ressources
- Évaluer plusieurs modes de défaillance potentiels que ce changement pourrait introduire
- Prévoir comment la production pourrait évoluer une fois ces changements déployés
- Alerter les développeurs des modes de défaillance potentiels probables
Merging this pull request may degrade production (high impact).
Merging this blocks every write to orders while the index builds. migrations/0114_order_search_trgm.sql:3 adds CREATE INDEX … USING gin (search_text gin_trgm_ops) without CONCURRENTLY, and a plain CREATE INDEX takes a full write lock on orders for the whole build. Checkout sustains ~38 writes/s on that table; each one queues behind the lock until the build finishes.
To make this safe: build the index with CREATE INDEX CONCURRENTLY outside the transactional migration.
Tout cela repose sur le context graph qu’on construit en continu et qui connecte toutes les ressources cloud de tes différents comptes cloud.
Assembler le contexte
Notre context graph est essentiel au fonctionnement de tout ça, il construit un registre de toutes tes ressources cloud, de tous tes dépôts, équipes, etc. Par exemple, un nœud de calcul comme une fonction Lambda est connecté à la base de données qu’il lit et à la queue qui le déclenche. On ajoute aussi les dépôts au graphe. Cela se fait en examinant les fichiers manifestes habituels du dépôt, par exemple les fichiers terraform, Cloudformation ou Wrangler. Cela permet d’établir la connexion entre les dépôts et les ressources cloud.
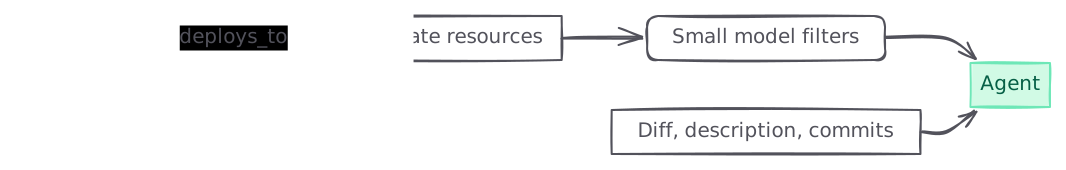
Quand une pull request est soumise au dépôt, on suit les chemins du context graph pour rassembler toutes les ressources cloud potentiellement affectées par le changement. On utilise un petit modèle pour filtrer les ressources, car un même dépôt peut déployer un grand nombre de ressources. On transmet ce contexte à l’agent, avec le diff, la description de la PR et les commits.
On fait aussi passer le diff par un ensemble d’heuristiques déterministes pour orienter rapidement l’attention de l’agent vers les éléments qui ont généralement tendance à avoir un impact négatif sur la production :
- une migration qui doit être appliquée à la main, ou dans un ordre particulier par rapport au deploy
CREATE INDEXsansCONCURRENTLY, ouADD COLUMN ... NOT NULLsans valeur par défaut, qui verrouillent tous les deux la table pendant toute la durée de l’opération- un endpoint retiré alors que la version actuellement déployée le lit encore
- du code qui commence à lire une variable d’environnement, un secret ou un binding que rien dans le diff ne provisionne
Ce sont des recommandations qui orientent l’agent vers les risques de déploiement probables.
Trajectoires de défaillance
Avec le contexte fourni ci-dessus, le modèle imagine différents modes de défaillance que le nouveau diff pourrait introduire en production, puis enquête sur chacun d’eux.
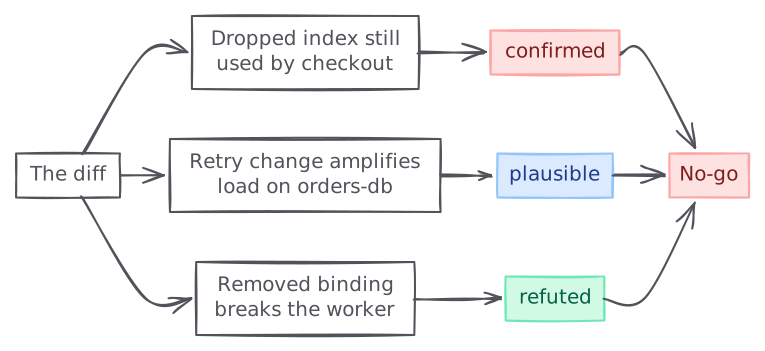
Son résultat est un registre de trajectoires de défaillance. Une trajectoire est une chaîne causale qui va d’un déclencheur, à travers le code modifié, jusqu’à une dégradation observable sur une métrique donnée, et chaque maillon porte une citation : un fichier et une ligne, un template de log avec son compteur, une lecture de métrique, une clé de config, une arête du graphe.
L’agent essaie à la fois de valider et d’invalider chaque trajectoire avant d’arriver à un verdict. Chacune se termine dans un des trois états suivants :
confirmedquand la trajectoire a été confirmée par rapport à la production.plausiblequand la chaîne est concrète mais qu’un ou plusieurs maillons n’ont pu être que «\u00A0devinés\u00A0», sans données de télémétrie pour les confirmer.refutedquand les données de télémétrie de production apportent suffisamment de preuves que cette trajectoire est peu susceptible de se produire en production.
On adopte une approche conservatrice, et toute trajectoire confirmed conduit à une évaluation en échec.
export function deriveTrajectoryVerdict(trajectories: Trajectory[]): "pass" | "fail" {
  return trajectories.some((entry) => entry.status === "confirmed") ? "fail" : "pass";
}
Prévoir l’impact
On donne à l’agent un outil pour prévoir des séries temporelles à partir de données historiques, en injectant d’éventuels facteurs externes.
Disons qu’une trajectoire affirme qu’un changement réduit de moitié le timeout sur un chemin avec retries. Que ça compte ou non dépend du trafic, et le trafic n’est pas vraiment un chiffre unique, il a une forme. Une queue qui reste stable à 60\u00A0% de profondeur, ça va. La même queue à 60\u00A0% mais qui grimpe chaque semaine, c’est une autre situation, et lire la dernière heure de métriques ne te dira pas laquelle des deux tu observes.
Donc avant que l’agent ne rédige le verdict d’une trajectoire, il récupère les séries historiques des ressources affectées et les prévoit ensemble. On self-host actuellement le modèle Toto-2.0-22m.
La raison d’utiliser un modèle multivarié dédié plutôt qu’un prompt supplémentaire, c’est que les séries ne sont pas indépendantes. Le taux de requêtes, le taux d’erreur, la latence et la profondeur de la queue d’une même ressource évoluent ensemble, et les prévoir séparément fait perdre la corrélation qui donne toute sa valeur à la prévision. Chaque série d’un appel partage un même groupe d’attention.
C’est la capacité la plus expérimentale qu’on a ajoutée récemment, et on mesure encore son impact. Mais elle passe déjà le vibes-eval.
La contrainte de latence
Exécuter l’évaluation d’impact en production dans le flux de la pull request implique que ça doit être rapide. Personne ne veut d’une étape qui ajoute 15 minutes à son pipeline CI. Par exemple, sur nos propres dépôts, cette évaluation est une étape de CI obligatoire, si elle est lente, tout notre SDLC s’enlise.
On a essentiellement un budget de 2 à 3 minutes pour produire une évaluation d’impact précise. Au-delà, ce n’est pas acceptable dans un pipeline CI/CD.
Notre premier prototype échouait complètement à respecter cette contrainte. Notre médiane était de près de 7 minutes, et il était courant de voir des runs prendre jusqu’à 20 minutes.
L’objectif est devenu de trouver comment réduire le nombre d’étapes du modèle pour faire passer tout le flux sous les 3 minutes. On exécutait généralement 30 à 40 étapes de modèle séquentielles, et dans les pires scénarios jusqu’à près de 600 étapes, chacune consommant 17 secondes de notre budget, et l’immense majorité de leur résultat était des tokens de raisonnement.
On a apporté pas mal de changements ces 3 dernières semaines, avec des impacts variés sur la performance. Voici les plus significatifs.
Fixer un budget d’étapes et le communiquer à l’agent
On a introduit un budget d’étapes, plafonné à 30 étapes par tour d’agent, et on communique clairement au modèle combien d’étapes il a consommées à chaque étape. Mettre le compteur dans le prompt permet au modèle de s’organiser en conséquence, ce qui s’avère compter plus que le nombre lui-même.
Démarrer de nouvelles revues plutôt que les intégrer à l’existante
Une pull request typique continue de recevoir de nouveaux commits après son ouverture. Dans le premier prototype, on intégrait tout le nouveau diff dans le même thread de revue, sous forme de message utilisateur d’orientation. Cette orientation embrouillait beaucoup le modèle et le poussait à relire des fichiers déjà examinés et à relancer des requêtes de télémétrie déjà effectuées.
Maintenant, un nouveau commit annule le run d’évaluation précédent et démarre un thread tout neuf. Ça peut sembler contre-intuitif, mais ça a finalement réduit la latence des revues complètes.
Réutiliser le travail précédent
Quand un nouveau commit arrive sur la pull request après qu’une revue a déjà été complétée, on avait l’habitude, un peu naïvement, de redémarrer une nouvelle évaluation d’impact depuis zéro.
On a introduit la capacité de réutiliser l’évaluation précédente, et de déclencher une nouvelle évaluation sur le diff plus petit entre les deux commits consécutifs.
On a déployé ces changements tout au long du mois de septembre et amélioré progressivement la latence, qui reste désormais confortablement dans le budget.
Est-ce que ça change vraiment quelque chose ?
À quoi ça sert de brûler tous ces tokens si on ne voit aucun résultat significatif ? Notre métrique de succès est le nombre d’incidents qu’on évite chaque semaine pour chacun de nos clients. Un incident évité est une pull request où :
- on signale un risque potentiel pour la production
- un ingénieur pushe un ou plusieurs commits
- une nouvelle évaluation conclut que le risque potentiel est atténué
- la pull request est fusionnée
C’est déjà assez significatif et on s’attend à ce que ça continue de croître. On itère en continu et on fait tourner des evals pour améliorer la performance et la qualité de notre agent.