

استبدلنا نماذج LLM الخاصة بنا بـ Jev. أصبحت أرخص بنسبة 39%.
Explore with AI
نحن نبني وكيلًا يعمل في المناوبة على مدار الساعة، يتخذ قرارات باستمرار، على سبيل المثال:
- ما مدى خطورة هذه المشكلة؟
- هل ينبغي أن نكون استباقيين في محادثة Slack هذه؟
- هل سبق أن رأينا هذه الحادثة من قبل؟
حتى الأسبوع الماضي، كنا نستخدم نماذج LLM لهذه المهام. حالما حصلنا على الوصول إلى Jev هذا الأسبوع، بدأنا التجربة معه.
ما هو Jev؟
Jev هو نموذج قرار من TypeSafe AI. لا يُنشئ نصًا: بل يجيب عن أسئلة حول بياناتك بقيم مُصنّفة واحتمالات معايَرة. تُروّج TypeSafe له باعتباره “جمل if ذكية”، أي خطوات التصنيف والتوجيه والتقييم حين يكون المنطق المكتوب يدويًا هشًا للغاية، وتذكر زمن استجابة من 70 إلى 500 مللي ثانية لكل استجابة مع رموز إخراج مجانية. وكلاؤنا يتخذون هذه القرارات طوال اليوم، لذا وضعناه في الإنتاج.
كيف يعمل
يتألف الطلب من جزأين: state، وهو النص أو JSON الذي تريد اتخاذ قرار بشأنه، وquestions، وهي الأسئلة التي تريد الإجابة عنها. لكل سؤال أحد ثلاثة أنواع:
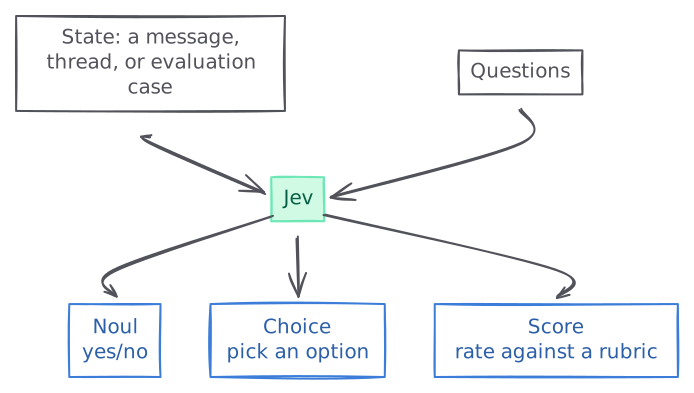
- Noul يُرجع احتمال
yes. - Choice يختار أحد الخيارات المقدَّمة.
- Score يُرجع قيمة مرجّحة بالاحتمال عبر معيار تقييم مرتّب.
حالة الاستخدام 1: التوجيه، أو متى ينبغي للوكيل أن يستجيب؟
وكلاؤنا استباقيون على Slack وGithub. يستجيبون لرسائل Slack أو تعليقات Github إذا كان لديهم رؤية مفيدة يقدّمونها للمستخدم. يحتاج الوكلاء إلى التصرف حين يطلب المستخدم ذلك، من دون المبالغة في الاستجابة لكل حدث. هذه حالة استخدام مثالية لأسئلة Noul الخاصة بـ Jev.
- التعليقات على طلبات pull request التي قدّمها وكلاؤنا: طلب المراجِع إجراء تغيير يوقظ الوكيل. أما تحديث حالة CI أو كلمة “شكرًا” فلا.
- قنوات Slack: يتدخّل الوكيل من دون دعوة فقط حين يستطيع المساعدة بوضوح، مثل سؤال مباشر عن البنية التحتية. ويبقى بعيدًا عن تنسيق البشر فيما بينهم.
- محادثات Slack التي يشارك فيها الوكيل: يجيب عن الرسائل الموجَّهة إليه، ويتجاهل البشر المتحدّثين فيما بينهم، ويغادر حين يطلب منه أحد ذلك.
إليك مثال على طلب Jev لتحديد ما إذا كان ينبغي للوكيل متابعة رسالة Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
شغّلنا Jev لمدة أسبوع تقريبًا وقارنّاه بنموذج LLM الذي كنا نستخدمه سابقًا لهذه المهمة.
P90 latency
Cost per 1,000 calls
أصبح التوجيه أسرع بثلاث مرات عند P90، من 1.5 ثانية إلى أقل من 500 مللي ثانية، وانخفضت التكلفة بمقدار النصف تقريبًا.
حالة الاستخدام 2: التصنيف، أو ماذا تعني الأدلة؟
نُشغّل أيضًا بضع مهام يحتاج فيها الوكيل إلى تصنيف الأشياء إلى فئات مختلفة. على سبيل المثال، بناءً على الأدلة المقدَّمة، هل ينبغي للوكيل أن يبدأ التحقيق في المشكلة، أم يدمجها باعتبارها مرتبطة بمشكلة قائمة، أم أنها تكرار لمشكلة سبق حلّها؟
يحوّل سؤال Jev من نوع Choice تلك الأدلة إلى تصنيف واحد من معايير نحدّدها نحن، وتُقرَّر الخطوة التالية بناءً على هذا التصنيف. يبدو الأمر كما يلي:
نُجري ثلاثة تصنيفات بهذه الطريقة. يستخدم كل منها سؤال Choice بمعايير صريحة، واستبدل كل منها نموذج LLM مختلفًا، لذا قِسنا كلًا منها على حدة.
هل هذه الحوادث مرتبطة؟
حين تُفتَح حادثة جديدة، يقارنها الوكيل بالحوادث القائمة: هل تشترك في سبب جذري واحد، أم أنها مرتبطة، أم مستقلة؟ يعرض هذا المثال التوضيحي مرشحًا واحدًا؛ أما الاستدعاء الفعلي في الإنتاج فيقارن عدة مرشحين بالحادثة الجديدة نفسها.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
بالتحوّل إلى Jev لهذه الحالة، جعلناها أسرع بنحو 8 مرات عند P90، من 2.9 ثانية إلى أقل من 400 مللي ثانية، وأرخص بنسبة 27%.
P90 latency
Cost per 1,000 calls
لماذا أُغلق طلب pull request الذي قدّمناه؟
يقدّم وكلاؤنا طلبات pull request إلى المطوّرين، ومعدّل الدمج هو أحد مقاييس نجاحنا الرئيسية. نحتاج إلى فهم سبب إغلاق طلبات pull request حتى نتمكّن من تحسين المنتج.
حين يُغلق أحد طلبات pull request الخاصة بنا من دون دمج، يقرأ الوكيل المراجعات، والنقاش، والإشارات إلى أعمال أخرى، ثم يختار السبب: كان الإصلاح خاطئًا، أو أصلحه إنسان بطريقة أخرى، أو كانت المشكلة إيجابية كاذبة، أو أصبح الطلب قديمًا، أو كان السلوك مقصودًا.
بالتحوّل إلى Jev لهذه الحالة، حسّنّا زمن الاستجابة ليصبح أسرع بست مرات عند P90، لكن بأرخصية 17% فقط.
P90 latency
Cost per 1,000 calls
ما مدى إلحاح طلب pull request هذا؟
قبل تقديم طلب pull request إلى المطوّرين، يحتاج وكلاؤنا إلى تصنيفه بحيث ترتفع الأمور الأشد خطورة إلى الأعلى. في هذا التصنيف، يقيّم الوكيل المشكلة الأساسية على سلّم يمتد من حرِج إلى معلوماتي. يقيّم الأثر الحالي، لا الخطر الافتراضي.
P90 latency
Cost per 1,000 calls
أدّى التحوّل إلى Jev هنا إلى خفض كبير في التكلفة: أرخص بنسبة 59% من DeepSeek V4.1 Flash، وأسرع بنحو 5 مرات عند P90.
Jev أسرع في كل تصنيف. حيثما حلّ محل GPT-OSS 120B، كان المكسب في الغالب زمن الاستجابة. وحيثما حلّ محل DeepSeek V4.1 Flash، خفّض الفاتورة أيضًا بأكثر من النصف.
حالة الاستخدام 3: الترتيب، أو ما مدى أهمية هذا المورد السحابي؟
للحصول على أفضل ما يقدّمه Polylane، تربط الفرق حساباتها السحابية. ننشئ Context graph لجميع الموارد السحابية، بحيث يستطيع الوكلاء فهم العلاقة بين عُقد الحوسبة وقواعد البيانات والطوابير وغيرها بسرعة.
لدينا فرق على المنصة بحسابات سحابية مزدحمة للغاية، بعشرات الآلاف من العُقد. كل خادم، وبيئة معزولة، وقاعدة بيانات، وطابور هو عقدة في Context graph الخاص بنا. من الضروري ترتيب كل هذه العُقد بحيث يعرف الوكلاء ما هو بالغ الأهمية لتطبيقك، وما هو في الأساس “لا بأس” أن يفشل.
نُسند إلى كل مورد إحدى فئات الأولوية الأربع: حرِجة، أو قياسية، أو منخفضة، أو ضئيلة.
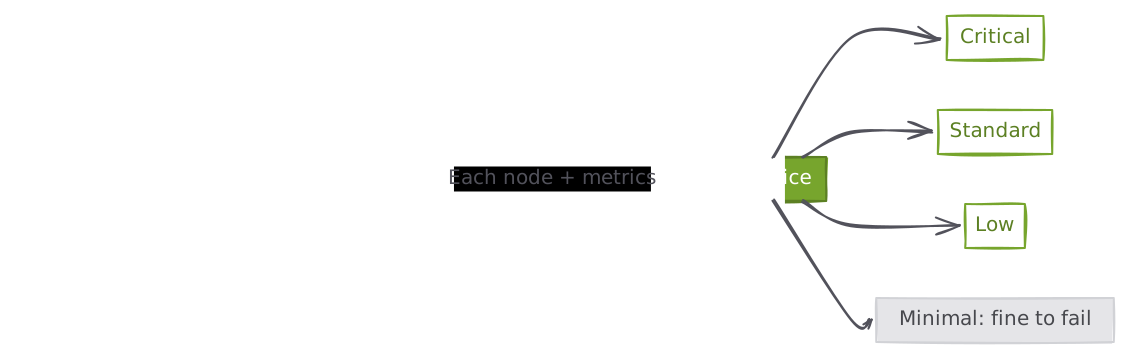
يُقيّم Jev سؤال Choice لكل مورد، بسياق يستند إلى الإعداد، والبيئة، والمقاييس الحديثة، والتبعيات.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
الترتيب هو حيث يتألق Jev: أسرع بأكثر من 10 مرات عند P90، من 5.4 ثانية إلى نصف ثانية تقريبًا، وأرخص بنسبة 34%. وهو أيضًا قرارنا الأعلى حجمًا، لذا فهو يقود معظم الوفورات الإجمالية.
P90 latency
Cost per 1,000 calls
الخلاصة
بشكل عام، حقّق Jev تخفيضات كبيرة إجمالًا في زمن الاستجابة والتكلفة المقدَّرة لكل 1,000 استدعاء:
- تخفيض زمن الاستجابة عند P90: 4,752 مللي ثانية —> 508 مللي ثانية.
- تخفيض التكلفة لكل 1,000 استدعاء: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterعلى مستوى كل نموذج، Jev هو الأسرع والأرخص في آن واحد: أرخص قليلًا من DeepSeek V4.1 Flash، وأقل بكثير من نموذجَي GPT-OSS كليهما.
Swipe to see every point.
أينما يختار وكلاؤنا من مجموعة ثابتة من الإجابات، أصبح Jev الآن الخيار الافتراضي: فهو أسرع وأرخص في كل قرار نقلناه إليه.