

Ми замінили наші LLM на Jev. Це на 39% дешевше.
Explore with AI
Ми створюємо завжди активного чергового агента, який постійно ухвалює рішення, наприклад:
- наскільки серйозна ця проблема?
- чи варто нам проявляти ініціативу в цьому треді Slack?
- чи бачили ми цей інцидент раніше?
До минулого тижня ми використовували для цих завдань LLM. Щойно цього тижня ми отримали доступ до Jev, ми почали з ним експериментувати.
Що таке Jev?
Jev є моделлю ухвалення рішень від TypeSafe AI. Вона не генерує текст: вона відповідає на запитання про ваші дані типізованими значеннями та каліброваними ймовірностями. TypeSafe позиціонує її для «розумних if-виразів»: кроків класифікації, маршрутизації та оцінювання, де написана вручну логіка занадто крихка, і заявляє про затримку 70–500 мс на відповідь з безкоштовними вихідними токенами. Наші агенти ухвалюють ці рішення цілий день, тож ми запустили її в продакшн.
Як це працює
Запит складається з двох частин: state, тобто текст або JSON, про який потрібне рішення, та questions, тобто запитання, на які потрібна відповідь. Кожне запитання має один із трьох типів:
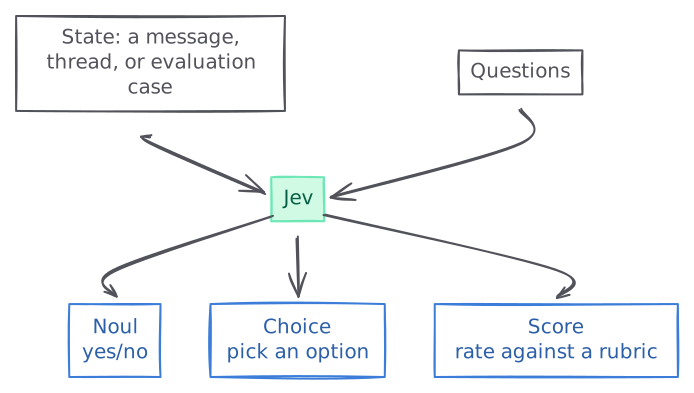
- Noul повертає ймовірність
yes. - Choice вибирає один із наданих варіантів.
- Score повертає значення, зважене за ймовірністю, за впорядкованою шкалою.
Сценарій використання 1: маршрутизація, або коли агент має відповідати?
Наші агенти проявляють ініціативу в Slack та Github. Вони відповідають на повідомлення в Slack або коментарі в Github, якщо мають для користувача значущу інформацію. Агенти мають діяти, коли користувач цього просить, не реагуючи надмірно на кожну подію. Це ідеальний сценарій використання для запитань Noul у Jev.
- Коментарі до pull request, які подали наші агенти: прохання рецензента щось змінити будить агента. Оновлення статусу CI або «дякую» — ні.
- Канали Slack: агент втручається без запрошення лише тоді, коли може явно допомогти, наприклад, коли ставлять пряме питання щодо інфраструктури. Він не втручається, коли люди координуються між собою.
- Треди Slack, у яких є агент: він відповідає на повідомлення, призначені йому, ігнорує розмови людей між собою і виходить, коли його про це просять.
Ось приклад запиту до Jev, який визначає, чи має агент відповісти на повідомлення в Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Ми запускали Jev близько тижня і порівняли результати з LLM, яку раніше використовували для цього завдання.
P90 latency
Cost per 1,000 calls
Маршрутизація стала в 3 рази швидшою за P90: з 1.5 секунди до менш ніж 500 мс, а вартість впала майже вдвічі.
Сценарій використання 2: класифікація, або що означають докази?
Ми також виконуємо кілька завдань, де агенту потрібно класифікувати речі за різними категоріями. Наприклад, на основі наданих доказів: чи має агент почати розслідування проблеми, чи варто об’єднати її з наявною проблемою, чи це дублікат раніше вирішеної проблеми?
Запитання типу Choice у Jev перетворює ці докази на одну мітку з визначених нами критеріїв, і наступний крок вирішується цією міткою. Це виглядає так:
Таким чином ми виконуємо три класифікації. Кожна використовує запитання Choice з явними критеріями, і кожна замінила окрему LLM, тож ми вимірювали їх окремо.
Чи пов’язані ці інциденти?
Коли відкривається новий інцидент, агент порівнює його з наявними інцидентами: чи мають вони спільну першопричину, чи пов’язані вони, чи незалежні? Цей ілюстративний приклад показує одного кандидата; продакшн-виклик порівнює кількох кандидатів з тим самим новим інцидентом.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Перейшовши на Jev для цього сценарію, ми зробили його майже в 8 разів швидшим за P90: з 2.9 секунди до менш ніж 400 мс, і на 27% дешевшим.
P90 latency
Cost per 1,000 calls
Чому цей поданий нами pull request закрили?
Наші агенти подають pull request розробникам, і одна з наших ключових метрик успіху полягає в частці злитих pull request. Нам потрібно розуміти, чому pull request закривають, щоб покращувати продукт.
Коли один із наших pull request закривають без злиття, агент читає рев’ю, обговорення та посилання на іншу роботу, а потім обирає причину: виправлення було неправильним, людина виправила проблему іншим способом, проблема виявилася хибним спрацюванням, pull request застарів, або поведінка була навмисною.
Перейшовши на Jev для цього сценарію, ми покращили затримку до 6 разів швидше за P90, але лише на 17% дешевше.
P90 latency
Cost per 1,000 calls
Наскільки терміновий цей pull request?
Перед тим як подати pull request розробникам, наші агенти мають ранжувати його так, щоб проблеми з вищою серйозністю піднімалися нагору. Для цієї класифікації агент оцінює основну проблему за шкалою від критичної до інформаційної. Він оцінює поточний вплив, а не гіпотетичний ризик.
P90 latency
Cost per 1,000 calls
Перехід на Jev тут суттєво знизив витрати: на 59% дешевше за DeepSeek V4.1 Flash і майже в 5 разів швидше за P90.
Jev швидший у кожній класифікації. Там, де він замінив GPT-OSS 120B, виграш стосується переважно затримки. Там, де він замінив DeepSeek V4.1 Flash, він також скоротив рахунок більш ніж удвічі.
Сценарій використання 3: ранжування, або наскільки важливий цей хмарний ресурс?
Щоб отримати максимум від Polylane, команди підключають свої хмарні облікові записи. Ми створюємо контекстний граф усіх хмарних ресурсів, щоб агенти могли швидко розуміти зв’язки між обчислювальними вузлами, базами даних, чергами тощо.
На платформі є команди з надзвичайно завантаженими хмарними обліковими записами, де десятки тисяч вузлів. Кожен сервер, пісочниця, база даних і черга є вузлом у нашому контекстному графі. Потрібно ранжувати кожен із цих вузлів так, щоб агенти знали, що критично важливо для вашого застосунку, а що, по суті, «нормально» вийде з ладу.
Ми призначаємо кожному ресурсу один із чотирьох рівнів пріоритету: критичний, стандартний, низький або мінімальний.
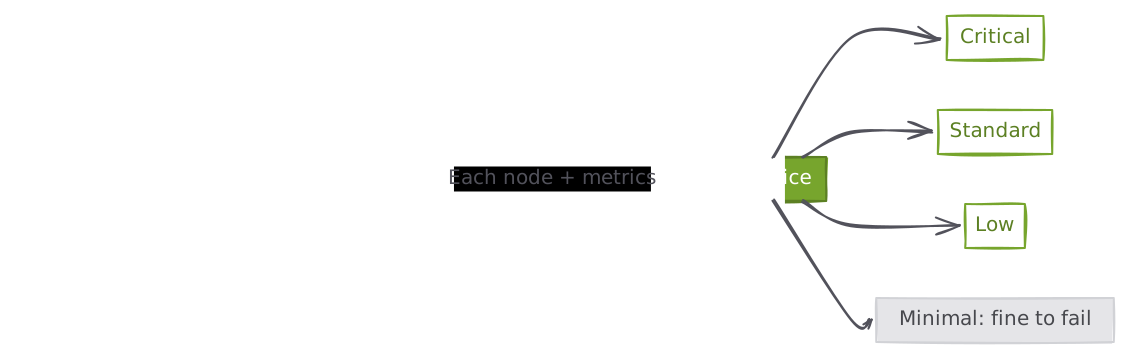
Jev обчислює запитання Choice для кожного ресурсу, використовуючи контекст на основі конфігурації, середовища, останніх метрик і залежностей.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Саме в ранжуванні Jev проявляє себе найкраще: більш ніж у 10 разів швидше за P90, з 5.4 секунди до приблизно половини секунди, і на 34% дешевше. Це також наше рішення з найбільшим обсягом, тож саме воно забезпечує більшу частину загальної економії.
P90 latency
Cost per 1,000 calls
Підсумок
Загалом Jev забезпечив суттєве загальне зниження затримки та орієнтовної вартості на 1000 викликів:
- зниження затримки P90: 4,752 мс —> 508 мс.
- зниження вартості на 1000 викликів: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterУ розрізі моделей Jev водночас і найшвидший, і найдешевший: трохи дешевший за DeepSeek V4.1 Flash і значно нижчий за обидві моделі GPT-OSS.
Swipe to see every point.
Усюди, де наші агенти обирають із фіксованого набору відповідей, тепер за замовчуванням використовується Jev: він швидший і дешевший для кожного рішення, яке ми перенесли.