

우리는 LLM을 Jev로 교체했습니다. 39% 더 저렴합니다.
Explore with AI
우리는 상시 작동하는 온콜 에이전트를 만들고 있으며, 이 에이전트는 끊임없이 다음과 같은 결정을 내립니다.
- 이 이슈는 얼마나 심각한가?
- 이 슬랙 스레드에 먼저 나서야 하는가?
- 이 인시던트를 이전에도 본 적이 있는가?
지난주까지는 이러한 작업에 LLM을 사용해 왔습니다. 이번 주 Jev에 접근할 수 있게 되자마자 실험을 시작했습니다.
Jev란 무엇인가
Jev는 TypeSafe AI의 결정 모델입니다. 텍스트를 생성하는 대신, 타입이 지정된 값과 보정된 확률로 데이터에 대한 질문에 답합니다. TypeSafe는 이를 “스마트 if문”이라고 소개하며, 직접 작성한 로직이 지나치게 취약해지는 분류, 라우팅, 점수 매기기 단계에 쓰라고 제안합니다. 그리고 출력 토큰은 무료이며 응답당 70~500ms가 걸린다고 밝히고 있습니다. 우리의 에이전트는 하루 종일 이런 결정을 내리기 때문에, 이를 프로덕션에 도입했습니다.
작동 방식
요청은 두 부분으로 구성됩니다. 결정을 내리고자 하는 텍스트나 JSON인 state와, 답을 얻고자 하는 questions입니다. 각 질문은 다음 세 가지 유형 중 하나를 갖습니다.
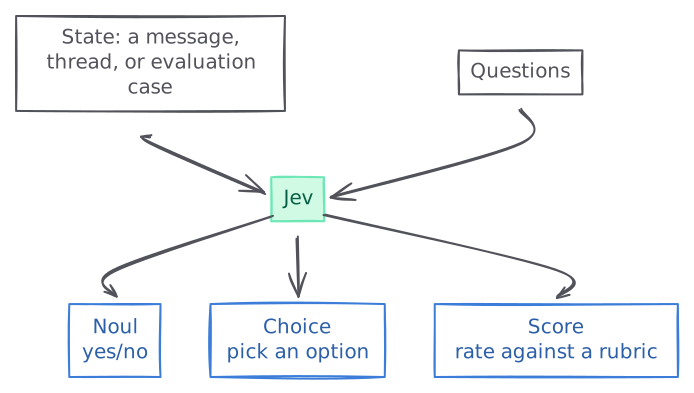
- Noul은
yes일 확률을 반환합니다. - Choice는 제공된 옵션 중 하나를 선택합니다.
- Score는 정렬된 평가 기준에 따라 확률로 가중된 값을 반환합니다.
활용 사례 1: 라우팅, 즉 에이전트는 언제 응답해야 하는가
우리 에이전트는 Slack과 Github에서 먼저 나서서 행동합니다. 사용자에게 제공할 만한 의미 있는 통찰이 있을 때 Slack 메시지나 Github 댓글에 응답합니다. 에이전트는 사용자가 요청할 때 행동해야 하며, 모든 이벤트에 과잉 반응해서는 안 됩니다. 이는 Jev의 Noul 질문에 딱 맞는 활용 사례입니다.
- 에이전트가 제출한 PR에 달린 댓글: 리뷰어가 변경을 요청하면 에이전트가 깨어납니다. CI 상태 업데이트나 “고맙습니다” 같은 댓글에는 반응하지 않습니다.
- Slack 채널: 에이전트는 인프라에 대한 직접적인 질문처럼 명확하게 도움이 될 수 있을 때만 초대받지 않고도 끼어듭니다. 사람들끼리 조율하는 대화에는 관여하지 않습니다.
- 에이전트가 속한 Slack 스레드: 자신에게 향한 메시지에만 답하고, 사람들끼리 나누는 대화는 무시하며, 누군가 나가 달라고 요청하면 나갑니다.
다음은 에이전트가 Slack 메시지에 후속 조치를 해야 하는지 판단하는 Jev 요청의 예시입니다.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
우리는 Jev를 약 일주일간 실행하며 이 작업에 이전에 사용하던 LLM과 비교했습니다.
P90 latency
Cost per 1,000 calls
라우팅은 P90 기준 3배 빨라져 1.5초에서 500ms 미만이 되었고, 비용은 거의 절반으로 줄었습니다.
활용 사례 2: 분류, 즉 증거는 무엇을 의미하는가
우리는 에이전트가 여러 항목을 서로 다른 범주로 분류해야 하는 작업도 몇 가지 실행합니다. 예를 들어, 제공된 증거를 바탕으로 에이전트가 이슈 조사를 시작해야 하는지, 기존 이슈와 관련이 있다고 보고 접어야 하는지, 아니면 이전에 해결된 이슈의 중복인지를 판단합니다.
Jev Choice 질문은 그 증거를 우리가 정의한 기준에 따라 하나의 레이블로 변환하며, 다음 단계는 그 레이블에 따라 결정됩니다. 다음과 같은 형태입니다.
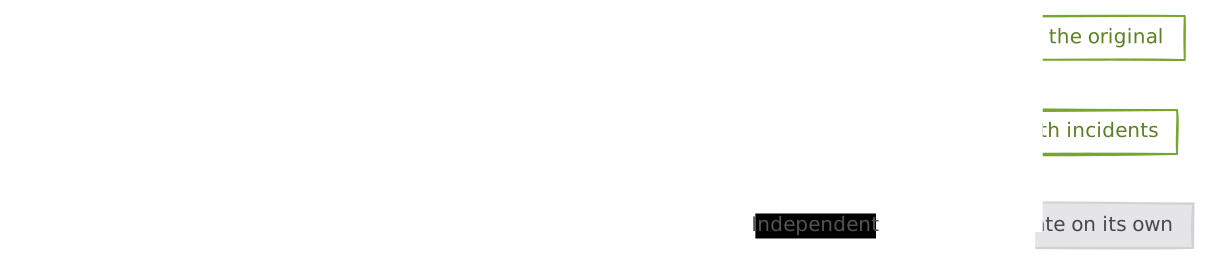
우리는 이러한 방식으로 세 가지 분류를 실행합니다. 각각 명시적인 기준을 가진 Choice 질문을 사용하며, 각각 서로 다른 LLM을 대체했기 때문에 개별적으로 측정했습니다.
이 인시던트들은 서로 관련이 있는가
새로운 인시던트가 발생하면 에이전트는 이를 기존 인시던트와 비교합니다. 근본 원인이 같은지, 관련이 있는지, 아니면 서로 독립적인지를 판단합니다. 이 예시는 후보 하나만 보여주지만, 실제 프로덕션 호출에서는 동일한 새 인시던트에 대해 여러 후보를 비교합니다.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
이 활용 사례에서 Jev로 전환한 결과, P90 기준 거의 8배 빨라져 2.9초에서 400ms 미만이 되었고, 비용은 27% 저렴해졌습니다.
P90 latency
Cost per 1,000 calls
우리가 제출한 이 PR은 왜 닫혔는가
우리 에이전트는 개발자에게 풀 리퀘스트를 제출하며, 병합률은 우리의 핵심 성공 지표 중 하나입니다. 제품을 개선하려면 풀 리퀘스트가 왜 닫히는지 이해해야 합니다.
우리 PR이 병합되지 않은 채 닫히면, 에이전트는 리뷰, 논의, 그리고 다른 작업에 대한 참조를 읽은 뒤 이유를 선택합니다. 수정이 잘못되었는지, 사람이 다른 방식으로 고쳤는지, 이슈가 오탐이었는지, PR이 방치되어 오래되었는지, 아니면 의도된 동작이었는지입니다.
이 활용 사례에서 Jev로 전환한 결과, P90 지연 시간은 6배 빨라졌지만 비용은 17%만 저렴해졌습니다.
P90 latency
Cost per 1,000 calls
이 풀 리퀘스트는 얼마나 시급한가
개발자에게 풀 리퀘스트를 제출하기 전에, 우리 에이전트는 더 심각한 사안이 위로 올라오도록 순위를 매겨야 합니다. 이 분류에서 에이전트는 근본 문제를 critical부터 info까지 등급으로 평가합니다. 가정에 따른 위험이 아니라 현재의 영향을 평가합니다.
P90 latency
Cost per 1,000 calls
여기서 Jev로 전환한 결과 비용이 크게 줄었습니다. DeepSeek V4.1 Flash보다 59% 저렴해졌고, P90 기준 거의 5배 빨라졌습니다.
Jev는 모든 분류 작업에서 더 빠릅니다. GPT-OSS 120B를 대체한 경우에는 이득이 대부분 지연 시간에서 나타납니다. DeepSeek V4.1 Flash를 대체한 경우에는 비용도 절반 이상 줄었습니다.
활용 사례 3: 순위 매기기, 즉 이 클라우드 리소스는 얼마나 중요한가
Polylane을 최대한 활용하려면 팀은 클라우드 계정을 연결합니다. 우리는 모든 클라우드 리소스에 대한 컨텍스트 그래프를 만들어, 에이전트가 컴퓨트 노드, 데이터베이스, 큐 등의 관계를 빠르게 파악할 수 있도록 합니다.
플랫폼에는 노드가 수만 개에 달하는 매우 바쁜 클라우드 계정을 가진 팀도 있습니다. 각 서버, 샌드박스, 데이터베이스, 큐는 우리 컨텍스트 그래프의 노드입니다. 에이전트가 애플리케이션에서 무엇이 중요하고 무엇은 실패해도 “괜찮은지” 알 수 있도록 이러한 노드마다 순위를 매길 필요가 있습니다.
각 리소스에는 Critical, Standard, Low, Minimal 중 하나의 우선순위 티어를 부여합니다.
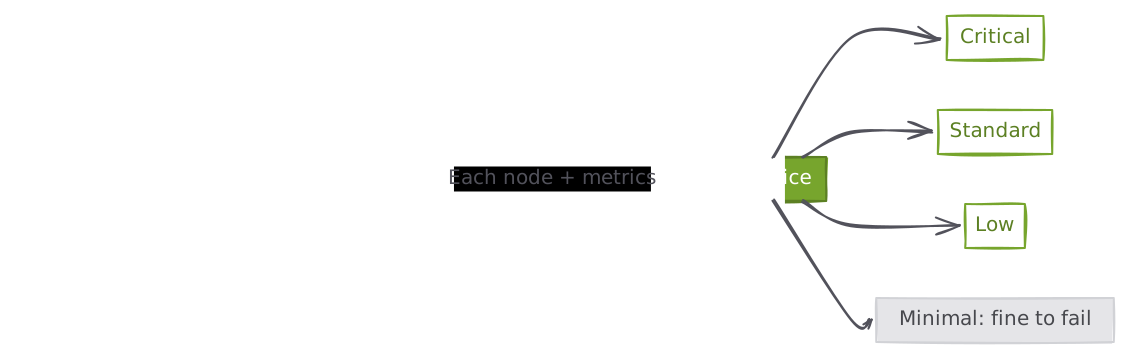
Jev는 구성, 환경, 최근 메트릭, 의존 관계를 바탕으로 한 컨텍스트와 함께 각 리소스에 대해 Choice 질문을 평가합니다.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
순위 매기기는 Jev가 가장 빛을 발하는 영역입니다. P90 기준 10배 넘게 빨라져 5.4초에서 약 0.5초가 되었고, 비용은 34% 저렴해졌습니다. 또한 우리 결정 중 가장 호출량이 많은 작업이라, 전체 절감의 대부분을 차지합니다.
P90 latency
Cost per 1,000 calls
요약
전반적으로 Jev는 호출 1,000건당 지연 시간과 예상 비용을 크게 줄였습니다.
- P90 지연 시간 감소: 4,752 ms —> 508 ms.
- 호출 1,000건당 비용 감소: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is better모델별로 보면 Jev는 가장 빠르면서도 가장 저렴합니다. DeepSeek V4.1 Flash보다 약간 저렴하고, 두 GPT-OSS 모델보다 훨씬 낮습니다.
Swipe to see every point.
에이전트가 정해진 답변 집합 중에서 선택해야 하는 곳이라면, 이제 Jev가 기본값입니다. 우리가 옮긴 모든 결정에서 더 빠르고 더 저렴합니다.