

Vi udskiftede vores LLM'er med Jev. Det er 39% billigere.
Explore with AI
Vi bygger en on-call-agent, der altid er aktiv og konstant træffer beslutninger, for eksempel:
- hvor alvorligt er dette issue?
- bør vi være proaktive på denne Slack-tråd?
- har vi set denne hændelse før?
Indtil for en uge siden har vi brugt LLM’er til disse opgaver. Så snart vi fik adgang til Jev i denne uge, begyndte vi at eksperimentere med den.
Hvad er Jev?
Jev er en beslutningsmodel fra TypeSafe AI. Den genererer ikke tekst: den besvarer spørgsmål om dine data med typede værdier og kalibrerede sandsynligheder. TypeSafe positionerer den til “smarte if-sætninger”, de klassificerings-, routing- og scoringstrin, hvor håndskrevet logik er for skrøbelig, og oplyser 70 til 500 ms pr. svar med gratis outputtokens. Vores agenter træffer disse beslutninger hele dagen, så vi satte den i produktion.
Sådan fungerer det
En request har to dele: state, som er den tekst eller JSON, du vil have en beslutning om, og de questions, du vil have besvaret. Hvert spørgsmål har en af tre typer:
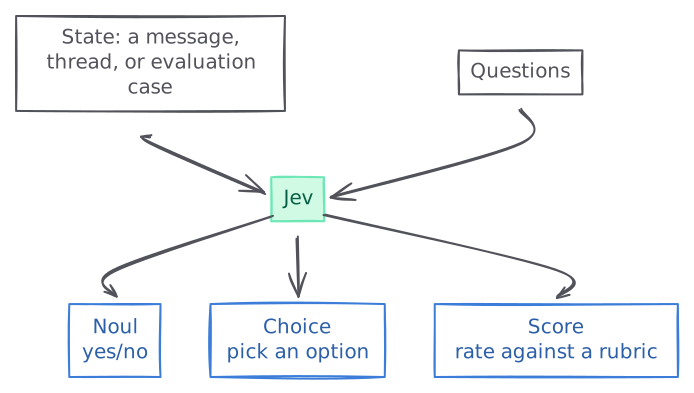
- Noul returnerer sandsynligheden for
yes. - Choice vælger en af de angivne muligheder.
- Score returnerer en sandsynlighedsvægtet værdi på tværs af en ordnet rubrik.
Anvendelse 1: Routing, eller hvornår skal agenten svare?
Vores agenter er proaktive på Slack og Github. De svarer på Slack-beskeder eller Github-kommentarer, hvis de har en meningsfuld indsigt at give brugeren. Agenterne skal handle, når en bruger beder om det, uden at overreagere på hver eneste begivenhed. Det er en perfekt anvendelse for Jevs Noul-spørgsmål.
- Kommentarer på pull requests, vores agenter har indsendt: en reviewer, der beder om en ændring, vækker agenten. En CI-statusopdatering eller et “tak” gør ikke.
- Slack-kanaler: agenten blander sig uopfordret kun, når den tydeligt kan hjælpe, som ved et direkte infrastrukturspørgsmål. Den holder sig ude af mennesker, der koordinerer med hinanden.
- Slack-tråde, agenten er i: den svarer på beskeder, der er rettet til den, ignorerer mennesker, der taler med hinanden, og forlader tråden, når nogen beder den om det.
Her er et eksempel på en Jev-request til at afgøre, om en agent skal følge op på en Slack-besked.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Vi kørte Jev i omkring en uge og sammenlignede med den LLM, vi tidligere brugte til denne opgave.
P90 latency
Cost per 1,000 calls
Routing blev 3x hurtigere ved P90, fra 1.5 sekunder til under 500 ms, og omkostningen faldt med næsten det halve.
Anvendelse 2: Klassificering, eller hvad betyder beviserne?
Vi kører også nogle opgaver, hvor agenten skal klassificere ting i forskellige kategorier. For eksempel: baseret på de givne beviser, skal agenten begynde at undersøge issuet, skal det sammenkædes med et eksisterende issue, eller er det et duplikat af et tidligere løst issue?
Et Jev Choice-spørgsmål omdanner de beviser til én label ud fra kriterier, vi definerer, og næste trin afgøres af labelen. Det ser sådan ud:
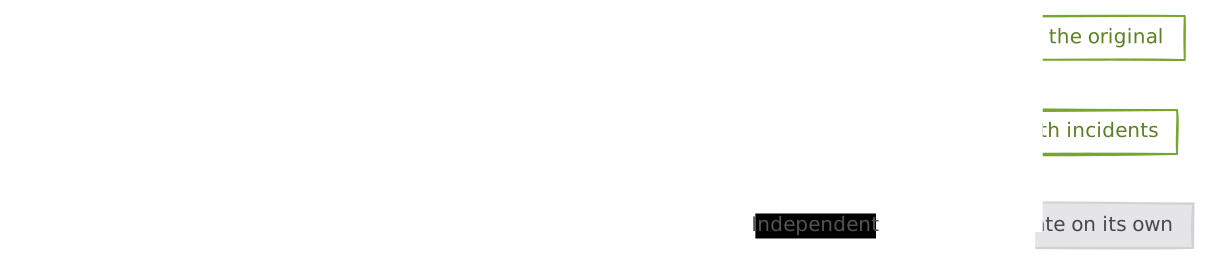
Vi kører tre klassificeringer på denne måde. Hver af dem bruger et Choice-spørgsmål med eksplicitte kriterier, og hver af dem erstattede en anden LLM, så vi målte dem hver for sig.
Er disse hændelser relaterede?
Når en ny hændelse opstår, sammenligner agenten den med eksisterende hændelser: deler de én rodårsag, er de relaterede, eller er de uafhængige? Dette illustrative eksempel viser én kandidat; et produktionskald sammenligner flere mod den samme nye hændelse.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Ved at skifte til Jev til denne anvendelse gjorde vi det næsten 8x hurtigere ved P90, fra 2.9 sekunder til under 400 ms, og 27% billigere.
P90 latency
Cost per 1,000 calls
Hvorfor blev denne pull request, vi indsendte, lukket?
Vores agenter indsender pull requests til udviklere, og en af vores vigtigste succesmålinger er merge rate. Vi er nødt til at forstå, hvorfor pull requests bliver lukket, så vi kan forbedre produktet.
Når en af vores pull requests bliver lukket uden at blive merget, læser agenten gennemgangene, diskussionen og referencer til andet arbejde og vælger derefter årsagen: fixet var forkert, et menneske løste det på en anden måde, issuet var en falsk positiv, pull requesten blev forældet, eller adfærden var tilsigtet.
Ved at skifte til Jev til denne anvendelse forbedrede vi latency til 6x hurtigere ved P90, men kun 17% billigere.
P90 latency
Cost per 1,000 calls
Hvor presserende er denne pull request?
Før agenterne indsender en pull request til udviklere, skal de rangere den, så ting med højere alvorsgrad stiger til tops. Til denne klassificering vurderer agenten det underliggende problem på en skala fra critical til info. Den vurderer den nuværende konsekvens, ikke en hypotetisk risiko.
P90 latency
Cost per 1,000 calls
Ved at skifte til Jev her reducerede vi omkostningen væsentligt: 59% billigere end DeepSeek V4.1 Flash, og næsten 5x hurtigere ved P90.
Jev er hurtigere til alle klassificeringer. Hvor den erstattede GPT-OSS 120B, ligger gevinsten mest i latency. Hvor den erstattede DeepSeek V4.1 Flash, reducerede den også regningen med mere end det halve.
Anvendelse 3: Rangering, eller hvor vigtig er denne cloudressource?
For at få det bedste ud af Polylane forbinder teams deres cloudkonti. Vi opretter en kontekstgraf over alle cloudressourcerne, så agenterne hurtigt kan forstå forholdet mellem compute-noder, databaser, køer osv.
Vi har teams på platformen med ekstremt travle cloudkonti, med titusindvis af noder. Hver server, sandbox, database og kø er en node i vores kontekstgraf. Det er nødvendigt at rangere hver af disse noder, så agenterne ved, hvad der er kritisk for din applikation, og hvad der i bund og grund er “fint” at lade fejle.
Vi tildeler hver ressource en af fire prioritetstiers: Critical, Standard, Low eller Minimal.
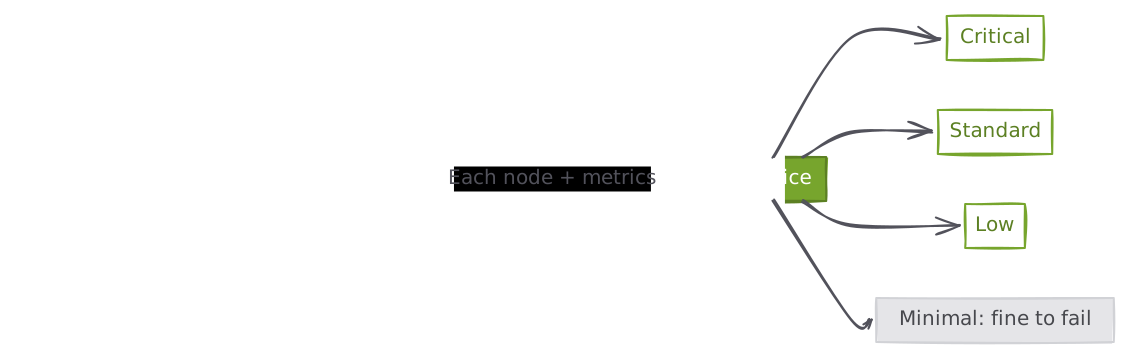
Jev evaluerer et Choice-spørgsmål for hver ressource, med kontekst baseret på konfiguration, miljø, seneste metrikker og afhængigheder.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Rangering er der, hvor Jev virkelig skinner: mere end 10x hurtigere ved P90, fra 5.4 sekunder til omkring et halvt sekund, og 34% billigere. Det er også vores beslutning med det højeste volumen, så den driver størstedelen af de samlede besparelser.
P90 latency
Cost per 1,000 calls
Opsummering
Samlet set leverede Jev betydelige reduktioner i latency og estimerede omkostninger pr. 1,000 kald:
- Reduktion af P90-latency: 4,752 ms —> 508 ms.
- Reduktion af omkostning pr. 1,000 kald: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPr. model er Jev både den hurtigste og den billigste: en anelse billigere end DeepSeek V4.1 Flash, og godt under begge GPT-OSS-modeller.
Swipe to see every point.
Overalt hvor vores agenter vælger fra et fast sæt af svar, er Jev nu standarden: den er hurtigere og billigere på hver eneste beslutning, vi har flyttet.