

Мы заменили LLM на Jev. Это на 39% дешевле.
Explore with AI
Мы создаём постоянно работающего дежурного on-call агента, который непрерывно принимает решения, например:
- насколько серьёзна эта проблема?
- стоит ли проявлять инициативу в этом slack-треде?
- видели ли мы этот инцидент раньше?
До прошлой недели мы использовали для этих задач LLM. Как только на этой неделе мы получили доступ к Jev, мы начали с ним экспериментировать.
Что такое Jev?
Jev — это модель принятия решений от TypeSafe AI. Она не генерирует текст: она отвечает на вопросы о ваших данных типизированными значениями и калиброванными вероятностями. TypeSafe продвигает её для «умных if-выражений» — шагов классификации, маршрутизации и оценки, где написанная вручную логика слишком хрупка, и заявляет 70–500 мс на ответ при бесплатных выходных токенах. Наши агенты принимают такие решения весь день, поэтому мы внедрили её в production.
Как это работает
Запрос состоит из двух частей: state — текст или JSON, о котором нужно принять решение, и questions — вопросы, на которые нужно ответить. У каждого вопроса один из трёх типов:
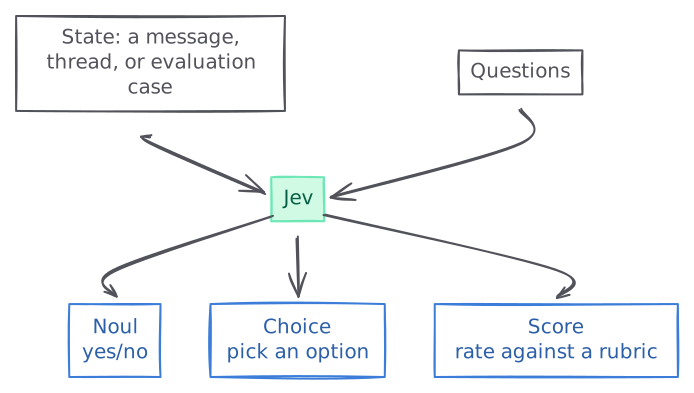
- Noul возвращает вероятность ответа
yes. - Choice выбирает один из предложенных вариантов.
- Score возвращает взвешенное по вероятности значение по упорядоченной шкале.
Сценарий 1: маршрутизация, или когда агенту следует отвечать?
Наши агенты проявляют инициативу в Slack и Github. Они отвечают на сообщения в Slack или комментарии в Github, если у них есть значимая информация для пользователя. Агентам нужно действовать, когда пользователь этого просит, не реагируя чрезмерно на каждое событие. Это идеальный сценарий для вопросов Jev типа Noul.
- Комментарии к PR, отправленным нашими агентами: ревьюер, просящий внести изменение, будит агента. Обновление статуса CI или «спасибо» — нет.
- Каналы Slack: агент вмешивается без приглашения, только если может явно помочь, например при прямом инфраструктурном вопросе. Он не вмешивается, когда люди координируются между собой.
- Slack-треды, в которых участвует агент: он отвечает на сообщения, адресованные ему, игнорирует сообщения людей друг другу и выходит из треда, если его об этом просят.
Вот пример запроса к Jev, чтобы определить, должен ли агент отреагировать на сообщение в Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Мы запускали Jev около недели и сравнили с LLM, который раньше использовали для этой задачи.
P90 latency
Cost per 1,000 calls
Маршрутизация стала в 3 раза быстрее по P90: с 1,5 секунды до менее 500 мс, а стоимость снизилась почти вдвое.
Сценарий 2: классификация, или что означают доказательства?
Мы также выполняем несколько задач, где агенту нужно распределить объекты по разным категориям. Например, на основе предоставленных доказательств: должен ли агент начать расследование проблемы, объединить её с существующей проблемой как связанную, или это дубликат ранее решённой проблемы?
Вопрос Jev типа Choice превращает эти доказательства в одну метку из заданных нами критериев, и следующий шаг определяется этой меткой. Это выглядит так:
Мы выполняем таким образом три классификации. Каждая использует вопрос типа Choice с явными критериями, и каждая заменила отдельную LLM, поэтому мы измеряли их по отдельности.
Связаны ли эти инциденты?
Когда открывается новый инцидент, агент сравнивает его с существующими инцидентами: есть ли у них общая первопричина, они связаны, или независимы? Этот иллюстративный пример показывает одного кандидата, а реальный production-вызов сравнивает несколько кандидатов с одним и тем же новым инцидентом.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Перейдя на Jev для этого сценария, мы ускорили процесс почти в 8 раз по P90: с 2,9 секунды до менее 400 мс, и снизили стоимость на 27%.
P90 latency
Cost per 1,000 calls
Почему этот отправленный нами PR был закрыт?
Наши агенты отправляют pull request’ы разработчикам, и одна из наших ключевых метрик успеха — доля смёрженных PR. Нам нужно понимать, почему pull request’ы закрываются, чтобы улучшать продукт.
Когда один из наших PR закрывается без merge, агент читает ревью, обсуждение и ссылки на другую работу, а затем выбирает причину: исправление было неверным, человек исправил проблему другим способом, проблема оказалась ложным срабатыванием, PR устарел, или поведение было ожидаемым.
Перейдя на Jev для этого сценария, мы ускорили работу в 6 раз по P90, но снизили стоимость только на 17%.
P90 latency
Cost per 1,000 calls
Насколько срочен этот pull request?
Перед отправкой pull request’а разработчикам нашим агентам нужно ранжировать его так, чтобы более серьёзные проблемы поднимались наверх. Для этой классификации агент оценивает основную проблему по шкале от critical до info. Он оценивает текущее воздействие, а не гипотетический риск.
P90 latency
Cost per 1,000 calls
Переход на Jev здесь существенно снизил стоимость: на 59% дешевле, чем DeepSeek V4.1 Flash, и почти в 5 раз быстрее по P90.
Jev быстрее в каждой классификации. Там, где он заменил GPT-OSS 120B, выигрыш в основном в задержке. Там, где он заменил DeepSeek V4.1 Flash, он также снизил счёт более чем вдвое.
Сценарий 3: ранжирование, или насколько важен этот облачный ресурс?
Чтобы получить максимум от Polylane, команды подключают свои облачные аккаунты. Мы строим граф контекста из всех облачных ресурсов, чтобы агенты могли быстро понимать связи между вычислительными узлами, базами данных, очередями и так далее.
У нас есть команды на платформе с крайне загруженными облачными аккаунтами, с десятками тысяч узлов. Каждый сервер, песочница, база данных и очередь — это узел в нашем графе контекста. Необходимо ранжировать каждый из этих узлов так, чтобы агенты понимали, что критично для вашего приложения, а что в целом «нормально» уронить.
Мы присваиваем каждому ресурсу один из четырёх уровней приоритета: Critical, Standard, Low или Minimal.
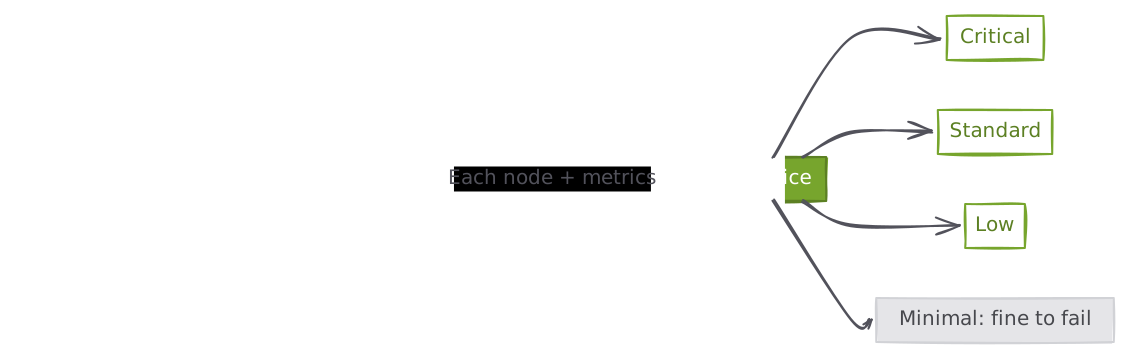
Jev оценивает вопрос типа Choice для каждого ресурса, используя контекст на основе конфигурации, окружения, недавних метрик и зависимостей.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
В ранжировании Jev проявляет себя лучше всего: более чем в 10 раз быстрее по P90, с 5,4 секунды до примерно полусекунды, и на 34% дешевле. Это также решение с самым большим объёмом вызовов, поэтому оно даёт основную часть общей экономии.
P90 latency
Cost per 1,000 calls
Итоги
В целом Jev обеспечил существенное снижение задержки и расчётной стоимости на 1000 вызовов:
- снижение задержки P90: 4752 мс → 508 мс;
- снижение стоимости на 1000 вызовов: $0.76199 → $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterПо каждой модели Jev одновременно самый быстрый и самый дешёвый: немного дешевле DeepSeek V4.1 Flash и значительно ниже обеих моделей GPT-OSS.
Swipe to see every point.
Везде, где наши агенты выбирают из фиксированного набора ответов, Jev теперь используется по умолчанию: он быстрее и дешевле в каждом решении, которое мы перевели на него.