

Vi byttet ut LLM-ene våre med Jev. Det er 39 % billigere.
Explore with AI
Vi bygger en agent som alltid har vakt, og som hele tiden tar avgjørelser, for eksempel:
- hvor alvorlig er dette issuet?
- bør vi være proaktive i denne Slack-tråden?
- har vi sett denne hendelsen før?
Frem til forrige uke har vi brukt LLM-er til disse oppgavene. Så snart vi fikk tilgang til Jev denne uken, begynte vi å eksperimentere med den.
Hva er Jev?
Jev er en beslutningsmodell fra TypeSafe AI. Den genererer ikke tekst: den svarer på spørsmål om dataene dine med typede verdier og kalibrerte sannsynligheter. TypeSafe presenterer den som «smarte if-setninger», stegene for klassifisering, ruting og scoring der håndskrevet logikk blir for skjør, og oppgir 70 til 500 ms per svar med gratis output-tokener. Agentene våre tar slike avgjørelser hele dagen, så vi satte den i produksjon.
Slik fungerer det
En forespørsel har to deler: state, som er teksten eller JSON-en du vil ha en avgjørelse om, og questions, spørsmålene du vil ha svar på. Hvert spørsmål har en av tre typer:
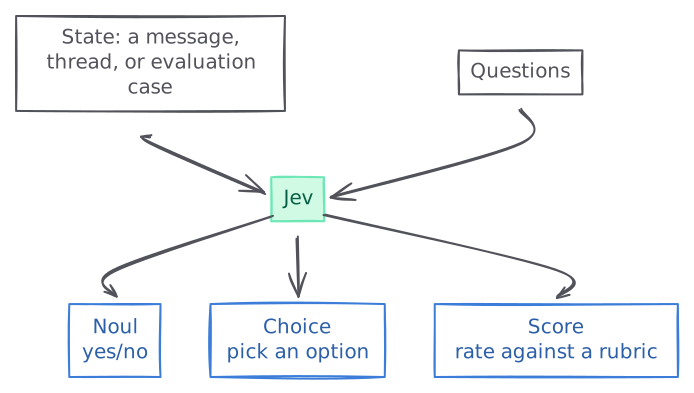
- Noul returnerer sannsynligheten for
yes. - Choice velger ett av de oppgitte alternativene.
- Score returnerer en sannsynlighetsvektet verdi over en ordnet rubrikk.
Bruksområde 1: Ruting, eller når bør agenten svare?
Agentene våre er proaktive på Slack og Github. De svarer på Slack-meldinger eller Github-kommentarer hvis de har en meningsfull innsikt å gi brukeren. Agentene må handle når en bruker ber om det, uten å overreagere på hver eneste hendelse. Dette er et perfekt bruksområde for Jevs Noul-spørsmål.
- Kommentarer på PR-er agentene våre har sendt inn: en reviewer som ber om en endring, vekker agenten. En CI-statusoppdatering eller en «takk» gjør det ikke.
- Slack-kanaler: agenten blander seg inn uinvitert bare når den tydelig kan hjelpe, som ved et direkte infrastrukturspørsmål. Den holder seg unna når mennesker koordinerer med hverandre.
- Slack-tråder agenten er med i: den svarer på meldinger rettet mot den, ignorerer mennesker som snakker med hverandre, og forlater tråden når noen ber den om det.
Her er et eksempel på en Jev-forespørsel for å avgjøre om en agent bør følge opp en Slack-melding.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Vi kjørte Jev i omtrent en uke og sammenlignet med LLM-en vi tidligere brukte til denne oppgaven.
P90 latency
Cost per 1,000 calls
Ruting ble 3x raskere ved P90, fra 1.5 sekunder til under 500 ms, og kostnaden falt med nesten halvparten.
Bruksområde 2: Klassifisering, eller hva betyr bevisene?
Vi kjører også noen oppgaver der agenten må klassifisere ting i ulike kategorier. Basert på bevisene som er gitt, skal for eksempel agenten begynne å undersøke issuet, skal den knytte det til et eksisterende issue som relatert, eller er det et duplikat av et tidligere løst issue?
Et Jev Choice-spørsmål omgjør disse bevisene til én etikett fra kriterier vi definerer, og neste steg avgjøres av etiketten. Det ser slik ut:
Vi kjører tre klassifiseringer på denne måten. Hver av dem bruker et Choice-spørsmål med eksplisitte kriterier, og hver erstattet en annen LLM, så vi målte dem hver for seg.
Er disse hendelsene relatert?
Når en ny hendelse åpnes, sammenligner agenten den med eksisterende hendelser: deler de samme rotårsak, er de relatert, eller er de uavhengige? Dette illustrerende eksempelet viser én kandidat; et produksjonskall sammenligner flere mot samme nye hendelse.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Ved å bytte til Jev for dette bruksområdet gjorde vi det nesten 8x raskere ved P90, fra 2.9 sekunder til under 400 ms, og 27 % billigere.
P90 latency
Cost per 1,000 calls
Hvorfor ble denne PR-en vi sendte inn, lukket?
Agentene våre sender inn pull requests til utviklere, og en av våre viktigste suksessmålinger er sammenslåingsraten. Vi må forstå hvorfor pull requester blir lukket, slik at vi kan forbedre produktet.
Når en av PR-ene våre blir lukket uten å bli slått sammen, leser agenten gjennomgangene, diskusjonen og referanser til annet arbeid, og velger deretter årsaken: fiksen var feil, et menneske fikset det på en annen måte, issuet var en falsk positiv, PR-en ble foreldet, eller atferden var tilsiktet.
Ved å bytte til Jev for dette bruksområdet forbedret vi latensen til 6x raskere ved P90, men bare 17 % billigere.
P90 latency
Cost per 1,000 calls
Hvor presserende er denne pull requesten?
Før agentene våre sender inn en pull request til utviklere, må de rangere den slik at de mest alvorlige tingene havner øverst. For denne klassifiseringen graderer agenten det underliggende problemet på en skala fra kritisk til info. Den graderer nåværende konsekvens, ikke hypotetisk risiko.
P90 latency
Cost per 1,000 calls
Å bytte til Jev her reduserte kostnaden betydelig: 59 % billigere enn DeepSeek V4.1 Flash, og nesten 5x raskere ved P90.
Jev er raskere på hver eneste klassifisering. Der den erstattet GPT-OSS 120B, er gevinsten hovedsakelig latens. Der den erstattet DeepSeek V4.1 Flash, kuttet den også regningen med mer enn halvparten.
Bruksområde 3: Rangering, eller hvor viktig er denne skyressursen?
For å få mest mulig ut av Polylane kobler team til skykontoene sine. Vi lager en kontekstgraf av alle skyressursene, slik at agentene raskt kan forstå forholdet mellom compute-noder, databaser, køer og så videre.
Vi har team på plattformen med ekstremt travle skykontoer, med titusenvis av noder. Hver server, sandkasse, database og kø er en node i kontekstgrafen vår. Det er nødvendig å rangere hver av disse nodene slik at agentene vet hva som er kritisk for applikasjonen din, og hva som i praksis er «greit» å miste.
Vi tildeler hver ressurs ett av fire prioritetsnivåer: Critical, Standard, Low eller Minimal.
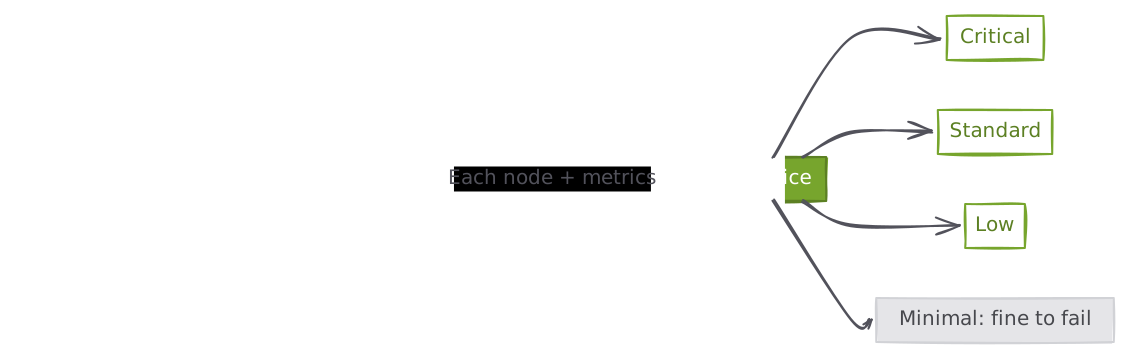
Jev evaluerer et Choice-spørsmål for hver ressurs, med kontekst basert på konfigurasjon, miljø, nylige metrikker og avhengigheter.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Rangering er der Jev virkelig utmerker seg: mer enn 10x raskere ved P90, fra 5.4 sekunder til omtrent et halvt sekund, og 34 % billigere. Det er også avgjørelsen med høyest volum, så den driver mesteparten av de samlede besparelsene.
P90 latency
Cost per 1,000 calls
Oppsummering
Samlet sett ga Jev betydelige reduksjoner i latens og estimert kostnad per 1,000 kall:
- Reduksjon i P90-latens: 4,752 ms —> 508 ms.
- Reduksjon i kostnad per 1,000 kall: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPer modell er Jev både den raskeste og den billigste: litt billigere enn DeepSeek V4.1 Flash, og godt under begge GPT-OSS-modellene.
Swipe to see every point.
Overalt hvor agentene våre velger fra et fast sett med svar, er Jev nå standarden: den er raskere og billigere på hver eneste avgjørelse vi har flyttet.