

LLM'lerimizi Jev ile değiştirdik. Yüzde 39 daha ucuz.
Explore with AI
Sürekli çalışan bir on-call ajanı geliştiriyoruz. Bu ajan durmadan kararlar veriyor, örneğin:
- bu sorun ne kadar ciddi?
- bu Slack thread’inde proaktif olmalı mıyız?
- bu olayı daha önce gördük mü?
Geçen haftaya kadar bu görevler için LLM kullanıyorduk. Bu hafta Jev’e erişim sağlar sağlamaz onunla denemeler yapmaya başladık.
Jev nedir?
Jev, TypeSafe AI’in bir karar modeli. Metin üretmiyor: verilerinle ilgili soruları tipli değerler ve kalibre edilmiş olasılıklarla yanıtlıyor. TypeSafe bunu “akıllı if-ifadeleri” için öneriyor: elle yazılmış mantığın çok kırılgan kaldığı sınıflandırma, yönlendirme ve puanlama adımları için, ve çıktı tokenları ücretsizken yanıt başına 70 ile 500 ms arası süre belirtiyor. Ajanlarımız bu kararları gün boyu veriyor, bu yüzden onu üretime aldık.
Nasıl çalışır
Bir isteğin iki parçası var: hakkında karar almak istediğin metni veya JSON’ı içeren state ve yanıtlanmasını istediğin questions. Her sorunun üç tipten biri var:
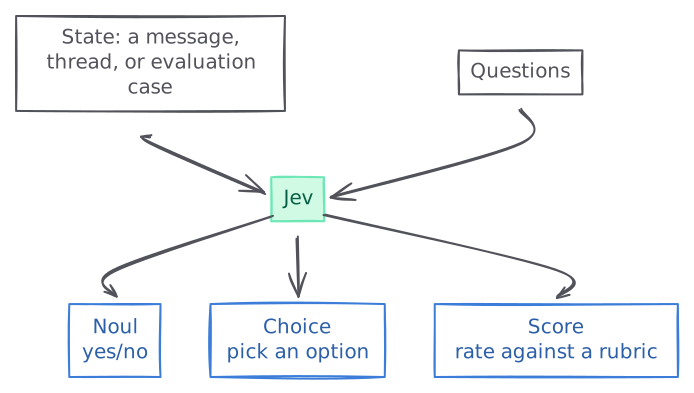
- Noul,
yesolasılığını döndürür. - Choice, sağlanan seçeneklerden birini seçer.
- Score, sıralı bir rubrik üzerinden olasılık ağırlıklı bir değer döndürür.
Kullanım senaryosu 1: Yönlendirme, ya da ajan ne zaman yanıt vermeli?
Ajanlarımız Slack ve Github’da proaktif davranıyor. Kullanıcıya sunacak anlamlı bir bilgileri varsa Slack mesajlarına veya Github yorumlarına yanıt veriyorlar. Ajanların, bir kullanıcı istediğinde harekete geçmesi gerekiyor, ama her olaya aşırı tepki vermemeleri gerekiyor. Bu, Jev’in Noul soruları için birebir uyan bir kullanım senaryosu.
- Ajanlarımızın gönderdiği PR’lardaki yorumlar: bir incelemecinin değişiklik istemesi ajanı uyandırır. Bir CI durum güncellemesi veya bir “teşekkürler” uyandırmaz.
- Slack kanalları: ajan, ancak doğrudan bir altyapı sorusu gibi açıkça yardımcı olabileceği durumlarda davetsiz araya girer. İnsanların birbiriyle koordinasyon kurduğu durumlarda geride durur.
- Ajanın içinde bulunduğu Slack threadleri: kendisine yönelik mesajları yanıtlar, insanların birbiriyle konuşmasını görmezden gelir ve biri istediğinde ayrılır.
Bir ajanın bir Slack mesajını takip edip etmemesi gerektiğini belirlemek için bir Jev isteği örneği aşağıda.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Jev’i yaklaşık bir hafta çalıştırdık ve bu görev için daha önce kullandığımız LLM ile karşılaştırdık.
P90 latency
Cost per 1,000 calls
Yönlendirme P90’da 3 kat hızlandı: 1.5 saniyeden 500 ms’nin altına indi ve maliyet neredeyse yarıya düştü.
Kullanım senaryosu 2: Sınıflandırma, ya da kanıt ne anlama geliyor?
Ajanın şeyleri farklı kovalara sınıflandırması gereken birkaç görev de çalıştırıyoruz. Örneğin, sağlanan kanıtlara dayanarak ajan sorunu incelemeye mi başlamalı, mevcut bir sorunla ilişkili olarak mı ele almalı, yoksa bu daha önce çözülmüş bir sorunun kopyası mı?
Bir Jev Choice sorusu, bu kanıtı bizim tanımladığımız kriterlerden tek bir etikete dönüştürür ve sonraki adım bu etikete göre belirlenir. Şöyle görünür:
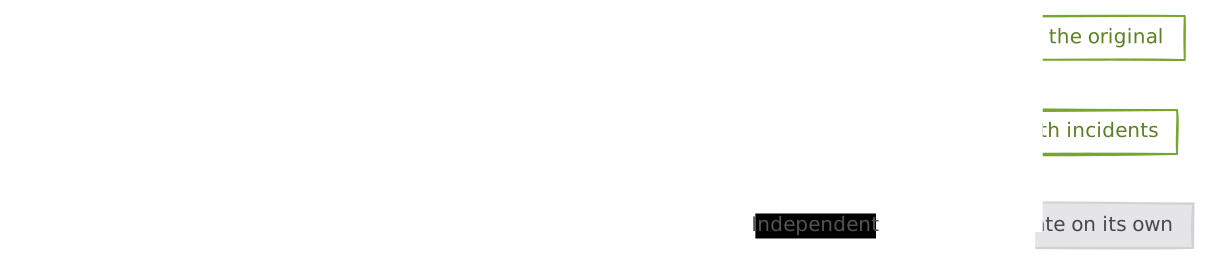
Bu şekilde üç sınıflandırma çalıştırıyoruz. Her biri açık kriterlere sahip bir Choice sorusu kullanıyor ve her biri farklı bir LLM’in yerini aldığı için bunları ayrı ayrı ölçtük.
Bu olaylar birbiriyle ilişkili mi?
Yeni bir olay açıldığında, ajan bunu mevcut olaylarla karşılaştırır: tek bir kök nedeni mi paylaşıyorlar, ilişkililer mi, yoksa bağımsızlar mı? Bu örnek tek bir adayı gösteriyor; üretimdeki bir çağrı aynı yeni olaya karşı birden fazlasını karşılaştırır.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Bu kullanım senaryosu için Jev’e geçerek P90’da neredeyse 8 kat hızlandırdık: 2.9 saniyeden 400 ms’nin altına indi, ve yüzde 27 daha ucuz hale geldi.
P90 latency
Cost per 1,000 calls
Gönderdiğimiz bu PR neden kapatıldı?
Ajanlarımız geliştiricilere pull request gönderiyor ve en önemli başarı metriklerimizden biri birleştirme oranı. Ürünü geliştirebilmek için pull request’lerin neden kapatıldığını anlamamız gerekiyor.
PR’larımızdan biri birleştirilmeden kapatıldığında, ajan incelemeleri, tartışmayı ve diğer çalışmalara yapılan referansları okur, ardından nedeni seçer: düzeltme yanlıştı, bir insan başka bir şekilde düzeltti, sorun yanlış pozitifti, PR’ın süresi doldu, veya davranış zaten amaçlanandı.
Bu kullanım senaryosu için Jev’e geçerek gecikmeyi P90’da 6 kat hızlandırdık, ancak yalnızca yüzde 17 daha ucuz oldu.
P90 latency
Cost per 1,000 calls
Bu pull request ne kadar acil?
Ajanlarımız geliştiricilere bir pull request göndermeden önce, daha ciddi olan şeylerin üste çıkması için onu sıralaması gerekiyor. Bu sınıflandırma için ajan, altta yatan sorunu kritikten bilgi düzeyine kadar uzanan bir merdivende derecelendirir. Varsayımsal riski değil, mevcut etkiyi derecelendirir.
P90 latency
Cost per 1,000 calls
Burada Jev’e geçmek maliyeti önemli ölçüde azalttı: DeepSeek V4.1 Flash’a göre yüzde 59 daha ucuz ve P90’da neredeyse 5 kat daha hızlı.
Jev her sınıflandırmada daha hızlı. GPT-OSS 120B’nin yerini aldığı yerlerde kazanım çoğunlukla gecikmede. DeepSeek V4.1 Flash’ın yerini aldığı yerlerde ise faturayı da yarıdan fazla düşürdü.
Kullanım senaryosu 3: Sıralama, ya da bu bulut kaynağı ne kadar önemli?
Polylane’den en iyi verimi almak için ekipler bulut hesaplarını bağlıyor. Ajanların işlem düğümleri, veritabanları, kuyruklar vb. arasındaki ilişkiyi hızla anlayabilmesi için tüm bulut kaynaklarının bir bağlam grafiğini oluşturuyoruz.
Platformda on binlerce düğümü olan son derece yoğun bulut hesaplarına sahip ekiplerimiz var. Her sunucu, sandbox, veritabanı ve kuyruk, bağlam grafiğimizde bir düğümdür. Ajanların uygulaman için neyin kritik olduğunu ve neyin başarısız olması esasen “sorun değil” olduğunu bilmesi için bu düğümlerin her birini sıralamak gerekiyor.
Her kaynağa dört öncelik katmanından birini atıyoruz: Kritik, Standart, Düşük veya Minimal.
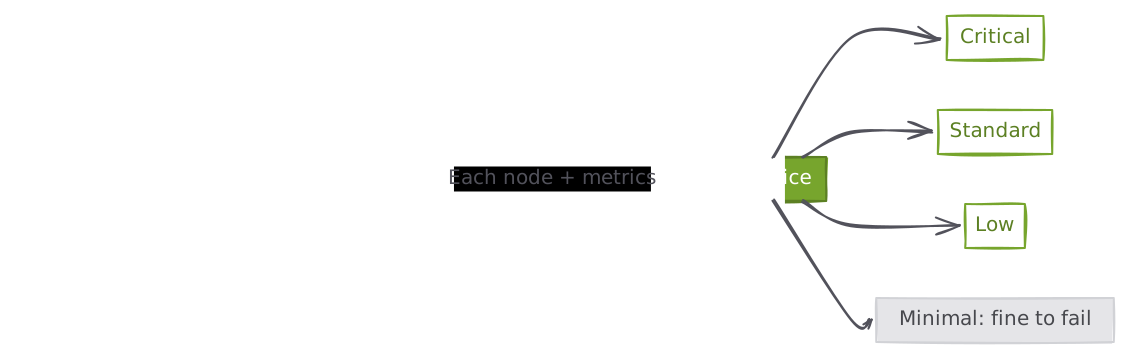
Jev, her kaynak için yapılandırma, ortam, son metrikler ve bağımlılıklara dayalı bağlamla bir Choice sorusu değerlendirir.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Sıralama, Jev’in en parlak olduğu yer: P90’da 10 kattan fazla hızlandı, 5.4 saniyeden yaklaşık yarım saniyeye indi ve yüzde 34 daha ucuz. Aynı zamanda en yüksek hacimli kararımız, bu yüzden genel tasarrufların çoğunu bu sağlıyor.
P90 latency
Cost per 1,000 calls
Özet
Genel olarak Jev, 1.000 çağrı başına gecikme ve tahmini maliyette önemli genel azalmalar sağladı:
- P90 gecikme azalması: 4,752 ms —> 508 ms.
- 1.000 çağrı başına maliyet azalması: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterModele göre Jev hem en hızlısı hem de en ucuzu: DeepSeek V4.1 Flash’tan biraz daha ucuz ve her iki GPT-OSS modelinin de oldukça altında.
Swipe to see every point.
Ajanlarımızın sabit bir cevap kümesinden seçim yaptığı her yerde artık varsayılan Jev: taşıdığımız her kararda hem daha hızlı hem daha ucuz.