

เราเปลี่ยนจาก LLM มาใช้ Jev ต้นทุนถูกลง 39%
Explore with AI
เรากำลังสร้างเอเจนต์ on-call ที่ทำงานตลอดเวลา ซึ่งต้องตัดสินใจอยู่ตลอด เช่น:
- issue นี้รุนแรงแค่ไหน
- เราควร proactive กับเธรด Slack นี้หรือไม่
- เราเคยเจอ incident นี้มาก่อนหรือไม่
จนกระทั่งสัปดาห์ที่แล้ว เรายังใช้ LLM สำหรับงานเหล่านี้อยู่ พอเราได้สิทธิ์เข้าถึง Jev ในสัปดาห์นี้ เราก็เริ่มทดลองใช้งานทันที
Jev คืออะไร
Jev เป็นโมเดลสำหรับการตัดสินใจ (decision model) จาก TypeSafe AI มันไม่ได้สร้างข้อความ แต่ตอบคำถามเกี่ยวกับข้อมูลของคุณด้วยค่าที่มีชนิดกำกับ (typed values) และความน่าจะเป็นที่ผ่านการ calibrate แล้ว TypeSafe นำเสนอมันในฐานะ “if-statement อัจฉริยะ” สำหรับขั้นตอน classify, route และ score ที่ logic แบบเขียนมือเองเปราะบางเกินไป และอ้างว่าใช้เวลา 70 ถึง 500 ms ต่อการตอบสนอง โดยไม่คิดค่า output token เอเจนต์ของเราต้องตัดสินใจแบบนี้ตลอดทั้งวัน เราจึงนำมันไปใช้ใน production
หลักการทำงาน
คำขอหนึ่งครั้งมีสองส่วน: state ซึ่งเป็นข้อความหรือ JSON ที่คุณต้องการให้ตัดสินใจ และ questions ที่คุณต้องการให้ตอบ แต่ละคำถามมีชนิดใดชนิดหนึ่งจากสามแบบ:
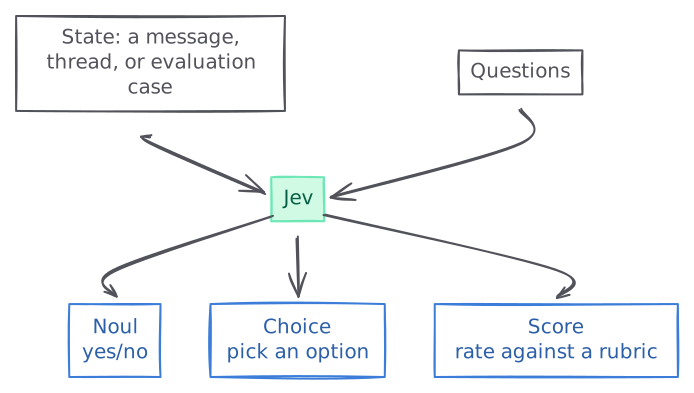
- Noul คืนค่าความน่าจะเป็นของ
yes - Choice เลือกหนึ่งตัวเลือกจากตัวเลือกที่กำหนดไว้
- Score คืนค่าที่ถ่วงน้ำหนักด้วยความน่าจะเป็นตามเกณฑ์ที่จัดลำดับไว้
กรณีใช้งานที่ 1: Routing หรือเอเจนต์ควรตอบเมื่อไหร่
เอเจนต์ของเรา proactive อยู่บน Slack และ Github พวกมันจะตอบข้อความ Slack หรือคอมเมนต์บน Github เมื่อมี insight ที่มีความหมายจะให้กับผู้ใช้ เอเจนต์ต้องลงมือทำเมื่อผู้ใช้ร้องขอ โดยไม่ตอบสนองเกินจำเป็นต่อทุกเหตุการณ์ นี่เป็นกรณีใช้งานที่เหมาะกับคำถามแบบ Noul ของ Jev มาก
- คอมเมนต์บน PR ที่เอเจนต์ของเราส่งไป: เมื่อรีวิวเวอร์ขอให้แก้ไข เอเจนต์จะตื่นขึ้นมาทำงาน ส่วนการอัปเดตสถานะ CI หรือคำว่า “ขอบคุณ” ไม่ทำให้มันตื่น
- ช่อง Slack: เอเจนต์จะเข้ามาโดยไม่ได้รับเชิญก็ต่อเมื่อมันช่วยได้อย่างชัดเจนเท่านั้น เช่น คำถามเกี่ยวกับ infrastructure โดยตรง มันจะไม่ยุ่งเกี่ยวเมื่อมนุษย์กำลังประสานงานกันเอง
- เธรด Slack ที่เอเจนต์อยู่ในนั้น: มันจะตอบข้อความที่ตั้งใจส่งถึงมัน ไม่สนใจเมื่อมนุษย์คุยกันเอง และออกจากเธรดเมื่อมีคนขอให้ออก
นี่คือตัวอย่างคำขอ Jev เพื่อพิจารณาว่าเอเจนต์ควร follow up ข้อความ Slack หรือไม่
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
เราใช้งาน Jev เป็นเวลาประมาณหนึ่งสัปดาห์ และเปรียบเทียบกับ LLM ที่เราเคยใช้สำหรับงานนี้
P90 latency
Cost per 1,000 calls
การทำ routing เร็วขึ้น 3 เท่าที่ P90 จาก 1.5 วินาที เหลือต่ำกว่า 500 ms และต้นทุนลดลงเกือบครึ่ง
กรณีใช้งานที่ 2: Classification หรือหลักฐานนี้หมายความว่าอะไร
เรายังมีงานอีกไม่กี่อย่างที่เอเจนต์ต้อง classify สิ่งต่าง ๆ ออกเป็นกลุ่ม เช่น จากหลักฐานที่มีอยู่ เอเจนต์ควรเริ่มสืบสวน issue นี้เลยไหม ควรถือว่ามันเกี่ยวข้องกับ issue ที่มีอยู่แล้วหรือไม่ หรือมันเป็น duplicate ของ issue ที่เคยแก้ไปแล้ว
คำถามแบบ Choice ของ Jev จะเปลี่ยนหลักฐานนั้นให้กลายเป็นป้ายกำกับหนึ่งอันจากเกณฑ์ที่เรากำหนด แล้วขั้นตอนถัดไปก็จะถูกตัดสินใจตามป้ายกำกับนั้น มีลักษณะดังนี้:
เรารัน classification สามแบบด้วยวิธีนี้ แต่ละแบบใช้คำถาม Choice ที่มีเกณฑ์ชัดเจน และแต่ละแบบมาแทนที่ LLM คนละตัว เราจึงวัดผลแยกกัน
incident เหล่านี้เกี่ยวข้องกันหรือไม่
เมื่อ incident ใหม่เปิดขึ้น เอเจนต์จะเปรียบเทียบกับ incident ที่มีอยู่: มันมีสาเหตุที่แท้จริงร่วมกันหรือไม่ เกี่ยวข้องกันหรือไม่ หรือเป็นอิสระจากกัน ตัวอย่างนี้แสดงผู้สมัครเพียงหนึ่งราย ส่วนการเรียกจริงใน production จะเปรียบเทียบหลายรายการกับ incident ใหม่รายการเดียวกัน
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
การเปลี่ยนมาใช้ Jev สำหรับกรณีใช้งานนี้ ทำให้เร็วขึ้นเกือบ 8 เท่าที่ P90 จาก 2.9 วินาที เหลือต่ำกว่า 400 ms และถูกลง 27%
P90 latency
Cost per 1,000 calls
ทำไม PR ที่เราส่งไปถึงถูกปิด
เอเจนต์ของเราส่ง pull request ให้นักพัฒนา และหนึ่งใน metric ความสำเร็จหลักของเราคืออัตราการ merge เราจำเป็นต้องเข้าใจว่าทำไม pull request ถึงถูกปิด เพื่อที่เราจะได้ปรับปรุงผลิตภัณฑ์
เมื่อ PR ของเราถูกปิดโดยไม่ได้ merge เอเจนต์จะอ่านรีวิว การพูดคุย และการอ้างอิงถึงงานอื่น ๆ แล้วเลือกเหตุผล: การแก้ไขผิด มนุษย์แก้ไขด้วยวิธีอื่น issue เป็น false positive PR ค้างจนล้าสมัย หรือพฤติกรรมนั้นเป็นไปตามที่ตั้งใจอยู่แล้ว
การเปลี่ยนมาใช้ Jev สำหรับกรณีใช้งานนี้ ทำให้ latency เร็วขึ้น 6 เท่าที่ P90 แต่ถูกลงเพียง 17%
P90 latency
Cost per 1,000 calls
pull request นี้เร่งด่วนแค่ไหน
ก่อนส่ง pull request ให้นักพัฒนา เอเจนต์ของเราต้องจัดอันดับมัน เพื่อให้สิ่งที่มีความรุนแรงสูงกว่าขึ้นไปอยู่บนสุด สำหรับ classification นี้ เอเจนต์จะให้คะแนนปัญหาที่แท้จริงตามลำดับขั้นตั้งแต่ critical ไปจนถึง info โดยให้คะแนนตามผลกระทบที่เกิดขึ้นจริง ไม่ใช่ความเสี่ยงที่เป็นแค่สมมติฐาน
P90 latency
Cost per 1,000 calls
การเปลี่ยนมาใช้ Jev ในจุดนี้ลดต้นทุนลงอย่างมาก: ถูกลง 59% เมื่อเทียบกับ DeepSeek V4.1 Flash และเร็วขึ้นเกือบ 5 เท่าที่ P90
Jev เร็วกว่าในทุก classification ในจุดที่มันแทนที่ GPT-OSS 120B ส่วนใหญ่ประโยชน์ที่ได้คือ latency ในจุดที่มันแทนที่ DeepSeek V4.1 Flash มันยังลดค่าใช้จ่ายลงกว่าครึ่งด้วย
กรณีใช้งานที่ 3: Ranking หรือทรัพยากรคลาวด์นี้สำคัญแค่ไหน
เพื่อให้ได้ประโยชน์สูงสุดจาก Polylane ทีมต่าง ๆ จะเชื่อมต่อบัญชีคลาวด์ของตัวเอง เราสร้าง context graph ของทรัพยากรคลาวด์ทั้งหมด เพื่อให้เอเจนต์เข้าใจความสัมพันธ์ระหว่าง compute node ฐานข้อมูล คิว และอื่น ๆ ได้อย่างรวดเร็ว
เรามีทีมบนแพลตฟอร์มที่มีบัญชีคลาวด์ที่ใช้งานหนักมาก มีโหนดนับหมื่น เซิร์ฟเวอร์ sandbox ฐานข้อมูล และคิวแต่ละตัวคือโหนดหนึ่งใน context graph ของเรา จำเป็นต้องจัดอันดับโหนดเหล่านี้แต่ละตัว เพื่อให้เอเจนต์รู้ว่าอะไรสำคัญต่อแอปพลิเคชันของคุณ และอะไร “พังได้ไม่เป็นไร” โดยพื้นฐาน
เรากำหนดระดับความสำคัญให้ทรัพยากรแต่ละตัวหนึ่งใน 4 ระดับ: Critical, Standard, Low หรือ Minimal
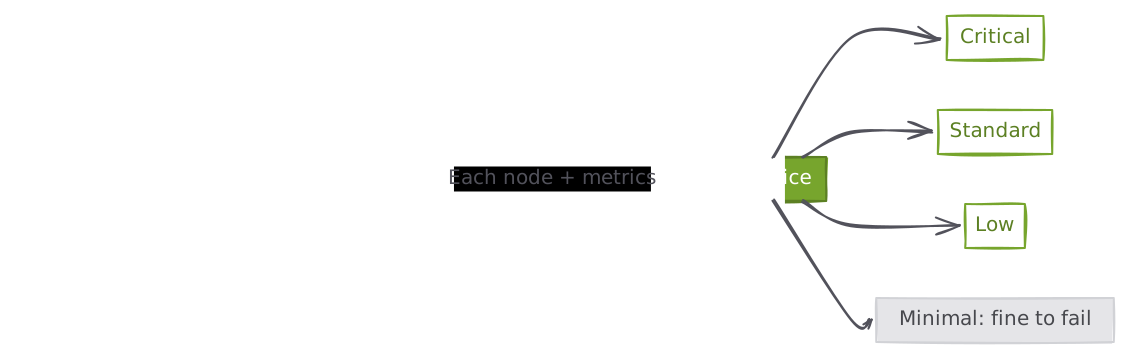
Jev ประเมินคำถามแบบ Choice สำหรับทรัพยากรแต่ละตัว โดยอาศัย context จาก configuration, environment, metric ล่าสุด และ dependency ต่าง ๆ
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Ranking คือจุดที่ Jev โดดเด่นที่สุด: เร็วขึ้นกว่า 10 เท่าที่ P90 จาก 5.4 วินาที เหลือประมาณครึ่งวินาที และถูกลง 34% นี่ยังเป็นการตัดสินใจที่มีปริมาณสูงสุดของเรา จึงเป็นตัวขับเคลื่อนการประหยัดโดยรวมส่วนใหญ่
P90 latency
Cost per 1,000 calls
สรุป
โดยรวมแล้ว Jev ลด latency และต้นทุนโดยประมาณต่อการเรียก 1,000 ครั้งลงอย่างมาก:
- ลด latency ที่ P90: 4,752 ms —> 508 ms
- ลดต้นทุนต่อการเรียก 1,000 ครั้ง: $0.76199 —> $0.46369
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterเมื่อดูแยกตามโมเดล Jev เป็นทั้งตัวที่เร็วที่สุดและถูกที่สุด: ถูกกว่า DeepSeek V4.1 Flash เล็กน้อย และต่ำกว่าโมเดล GPT-OSS ทั้งสองตัวมาก
Swipe to see every point.
ไม่ว่าจะเป็นจุดไหนที่เอเจนต์ของเราต้องเลือกจากชุดคำตอบที่กำหนดไว้ล่วงหน้า ตอนนี้ Jev กลายเป็นตัวเลือกเริ่มต้น: มันเร็วกว่าและถูกกว่าในทุกการตัดสินใจที่เราย้ายมาใช้